


Données d’entraînement vs recherche en direct dans l’IA
Comprenez la différence entre les données d'entraînement de l'IA et la recherche en direct. Découvrez comment les limites de connaissance, le RAG et la récupéra...
16 min de lecture
J’essaie de construire une stratégie de contenu IA cohérente mais je reste bloqué sur cette question fondamentale :
La confusion principale :
Certains outils IA utilisent des “données d’entraînement” - des informations apprises lors de l’entraînement du modèle, figées dans le temps.
D’autres utilisent la “recherche en direct” ou RAG (génération augmentée par récupération) - récupérant des infos fraîches du web en temps réel.
Mes questions :
Situation actuelle :
Nous publions du contenu optimisé pour la “citabilité IA” mais je ne sais pas du tout s’il est récupéré via les données d’entraînement (permanent mais en retard) ou via la recherche en direct (immédiat mais volatile).
Aidez-moi à comprendre la différence pour que je ne sois plus dans le flou.
Laissez-moi expliquer cela d’un point de vue technique.
Données d’entraînement :
Recherche en direct (RAG) :
Répartition des plateformes :
| Plateforme | Approche principale | Remarques |
|---|---|---|
| ChatGPT (de base) | Données d’entraînement | Limite ~avril 2024 |
| ChatGPT Search | Recherche en direct (Bing) | Lorsque recherche activée |
| Perplexity | Recherche en direct | Toujours récupérée |
| Aperçus IA Google | Recherche en direct | Utilise l’index Google |
| Claude (de base) | Données d’entraînement | Limite ~mars 2025 |
| Claude (avec recherche) | Hybride | Données + direct |
L’idée clé :
Ce ne sont pas des stratégies mutuellement exclusives. Le contenu qui construit l’autorité pour les données d’entraînement a aussi tendance à bien fonctionner en recherche en direct. Les approches d’optimisation se recoupent fortement.
Oui, potentiellement – mais avec des réserves :
Comment les données d’entraînement sont sélectionnées :
Les entreprises d’IA ne scrappent pas tout. Elles sélectionnent généralement parmi :
Le cercle vertueux :
Si votre contenu fonctionne bien en recherche en direct (cité, engageant, backlinks), cela envoie des signaux qui peuvent influencer la sélection des données d’entraînement pour les futurs modèles.
Réalité des délais :
Conséquence stratégique :
Optimisez d’abord pour la recherche en direct car :
L’inclusion dans les données d’entraînement est une conséquence à long terme d’une bonne optimisation recherche en direct, pas une stratégie distincte à poursuivre.
Voici le cadre d’optimisation pratique que j’utilise avec mes clients :
Stratégie double :
Piste 1 : Optimisation recherche en direct (prioritaire)
C’est là que vous verrez des résultats à court terme.
Piste 2 : Influence sur les données d’entraînement (en continu)
Ceci construit votre positionnement sur le long terme.
Conseil de répartition budgétaire :
Pourquoi privilégier la recherche en direct :
L’aspect volatilité est crucial et souvent négligé :
Stabilité des données d’entraînement :
Une fois votre marque intégrée dans les données d’entraînement, cette représentation est STABLE jusqu’à la prochaine version du modèle. Si ChatGPT a appris que vous êtes “le leader de l’emballage durable”, il continuera à dire cela pendant des mois/années.
Volatilité de la recherche en direct :
Des études montrent que 40 à 60 % des domaines cités changent en un mois dans la recherche IA en direct. Vous pouvez être cité massivement une semaine et disparaître la suivante à cause d’un changement d’algorithme.
Exemple réel :
Les citations Reddit dans ChatGPT Search sont passées de ~60 % à ~10 % en quelques semaines suite à un seul ajustement d’algorithme. Les sites dépendant de Reddit pour leur visibilité IA ont été frappés du jour au lendemain.
Conséquence stratégique :
Ce que cela implique pour la stratégie :
Vous avez besoin des deux. Recherche en direct pour la visibilité immédiate. Signaux données d’entraînement pour la stabilité à long terme.
Ne mettez pas tous vos œufs dans le même panier.
Voici comment nous avons mis en pratique cette distinction :
Types de contenus créés pour chaque cas :
Pour la recherche en direct (RAG) - Impact immédiat :
Pour les données d’entraînement - Autorité long terme :
Le recoupement :
Les deux bénéficient de :
Workflow opérationnel :
Perspective de mesure pour suivre les deux :
Suivi des citations recherche en direct :
C’est relativement simple :
Suivi de l’influence des données d’entraînement :
Beaucoup plus difficile. Vous cherchez des signaux indirects :
L’écart de mesure :
Recherche en direct : Vous voyez exactement quand et pourquoi vous êtes cité. Données d’entraînement : Vous ne pouvez qu’inférer via des tests.
Recommandation :
Mettez en place un suivi continu de la recherche en direct (rapports hebdo). Réalisez des audits trimestriels pour l’influence sur les données d’entraînement (tests manuels).
Focalisez l’optimisation sur la recherche en direct, mais surveillez les indicateurs données d’entraînement pour comprendre le positionnement long terme de la marque.
La différence de temporalité compte plus qu’on ne le pense :
Délais pour la recherche en direct :
Délais pour les données d’entraînement :
Conséquence pratique :
Si vous voulez de la visibilité IA dans les 6 prochains mois, les données d’entraînement sont hors sujet. Le train est déjà parti pour les modèles actuels.
Si vous bâtissez une stratégie sur 3-5 ans, les deux comptent.
Ma recommandation :
Ne gaspillez pas de ressources pour influencer les données d’entraînement si vous voulez des résultats cette année.
Voici le cadre que je partage avec mes clients grands comptes :
Le modèle à double influence :
                    ┌─────────────────────┐
                    │   Votre contenu     │
                    └──────────┬──────────┘
                               │
            ┌──────────────────┴──────────────────┐
            │                                     │
    ┌───────▼───────┐                     ┌───────▼───────┐
    │ Recherche     │                     │ Données       │
    │ en direct     │                     │ d'entraînement│
    │ (RAG)         │                     │               │
    ├───────────────┤                     ├───────────────┤
    │ Immédiat      │                     │ Modèles futurs│
    │ Volatil       │                     │ Stable        │
    │ Mesurable     │                     │ Inféré        │
    │ SEO+Structure │                     │ Autorité+RP   │
    └───────┬───────┘                     └───────┬───────┘
            │                                     │
            └──────────────────┬──────────────────┘
                               │
                    ┌──────────▼──────────┐
                    │  Visibilité IA      │
                    └─────────────────────┘
L’idée clé :
Ce n’est pas l’un ou l’autre – ce sont deux chemins parallèles vers le même but.
Une bonne stratégie de contenu sert les deux. L’accent tactique dépend de vos ressources et de votre calendrier.
Ce fil était exactement ce dont j’avais besoin. J’ai maintenant un cadre clair.
Ma synthèse :
1. Données d’entraînement vs Recherche en direct - Principales différences :
2. Réalité des plateformes :
3. Priorité d’optimisation :
4. Contenus efficaces pour les deux :
5. Approche de mesure :
Ce que je mets en place :
La confusion venait de croire que c’étaient des stratégies concurrentes. Ce sont des chemins parallèles qui se renforcent l’un l’autre.
Get personalized help from our team. We'll respond within 24 hours.
Suivez si votre contenu est cité à partir des données d'entraînement ou des résultats de recherche en direct. Surveillez la visibilité sur ChatGPT, Perplexity, les Aperçus IA de Google et Claude.
Comprenez la différence entre les données d'entraînement de l'IA et la recherche en direct. Découvrez comment les limites de connaissance, le RAG et la récupéra...
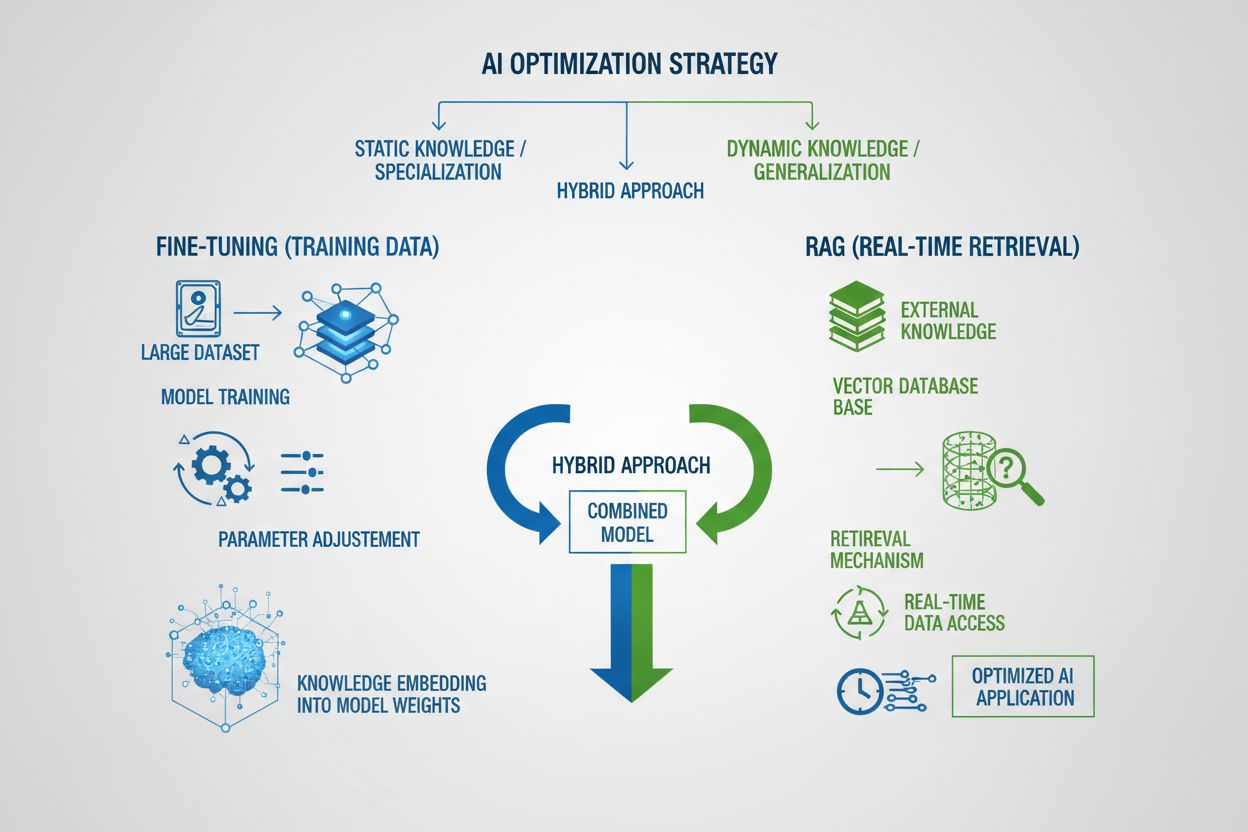
Comparez l'optimisation des données d'entraînement et les stratégies de récupération en temps réel pour l'IA.
Discussion communautaire sur la façon dont les moteurs de recherche IA indexent et découvrent le contenu. Des experts techniques expliquent les différences entr...