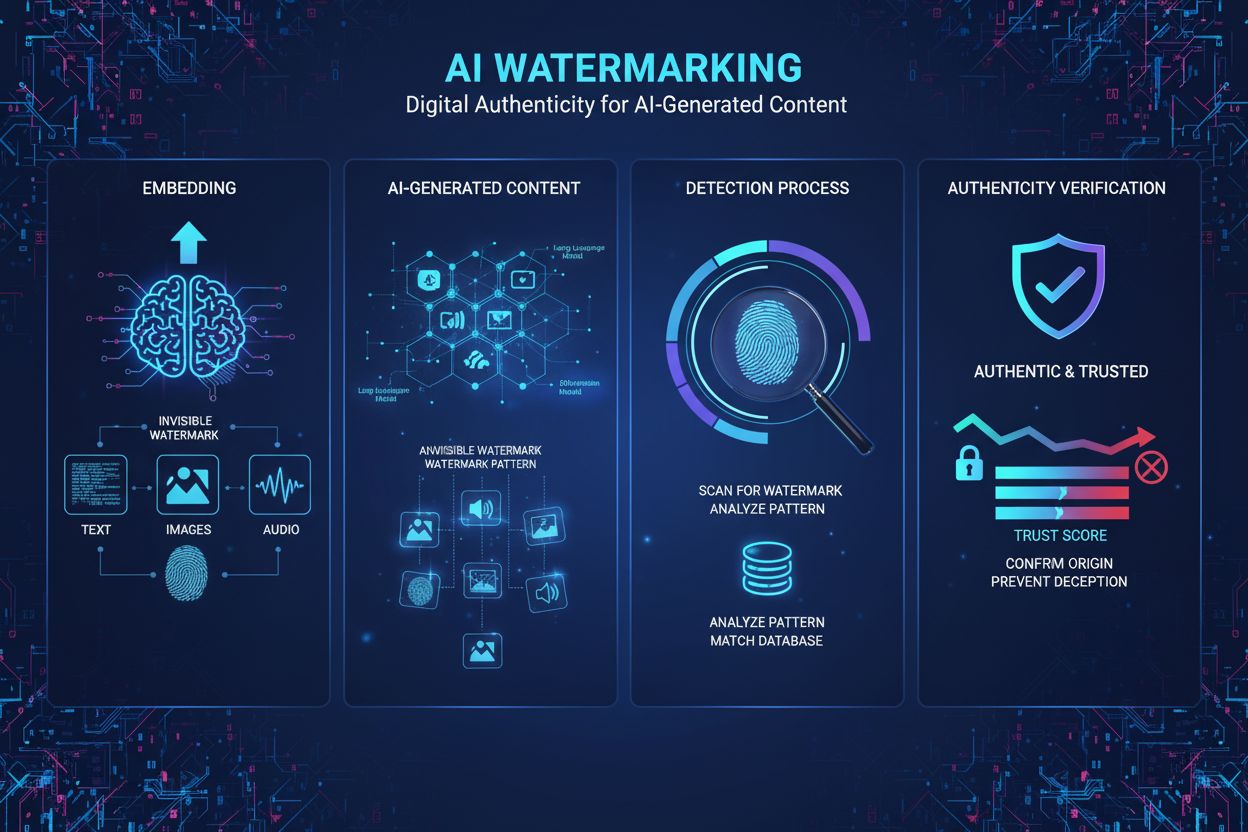
AIテキストウォーターマークとは、生成されたテキストに意図的に埋め込まれるシグナルです。発信者にとって有用な問いは具体的です。すなわち、自分たちが管理する生成システムの出力を、後から認識できるかどうかです。
SynthID Textはこの問いに答えるためのものです。任意の記事がAIによって書かれたかどうかを判定するものではありません。その検出器は、設定された統計的パターンを検査するものであり、検査が失敗してもテキストの出所は不明のままです。 SynthIDのリファレンスリポジトリには、ウォーターマークの生成と検出の両方が説明されています。
本ガイドでは、ローカルのPythonサンプルを順に確認したうえで、より難しいケースを取り上げます。複数のウォーターマーク、新しいウォーターマークによる書き直し、そして元の鍵が不明な場合のテキスト検査です。
テキストウォーターマークが実際に変えるもの
言語モデルは、次に来る可能性のあるトークンに確率を割り当てます。トークンは単語、単語の一部、あるいは句読点を表すことがあります。生成的ウォーターマークは、次のトークンの選ばれ方を変えます。その結果として得られる選択には、検出器が後から測定できる証拠が含まれます。
SynthIDはトーナメントサンプリングと呼ばれる処理を使います。候補トークンは、擬似乱数のスコア関数のもとで競い合います。スコアは、直近のトークン文脈とウォーターマークの鍵によって決まります。この選択を複数のレイヤーにわたって繰り返すことで、測定可能な統計的パターンを持つトークンが優遇されます。検出器は、完成したテキストからこれらのスコアを再構成します。元の言語モデルを実行する必要はありません。 SynthIDの研究論文もご覧ください。
1. 次に来る可能性のあるトークンを予測する
言語モデルが、その語彙に対する確率分布を生成します。2. 設定されたウォーターマークを適用する
鍵付きのスコア関数が、生成中のトークン選択に影響を与えます。3. 通常のテキストとして公開する
統計的シグナルは、選択されたトークンの並びに乗って運ばれます。4. 再構成してスコアを付ける
検出器は、互換性のあるトークン化と対応する設定を用いて、そのシグナルを探します。長い文章ほど、一般に多くの証拠が得られます。予測しやすい出力では、ウォーターマークに使える代替トークンの候補が少なくなります。レイヤーを増やすことは助けになりますが、論文によれば、レイヤーがトークン選択における利用可能な変動を消費していくにつれて、効果は逓減します。
統計的ウォーターマークと隠し文字は別物
検出器を選ぶ前に、見つけたいシグナルが何であるかを明確にしてください。
| 手法 | シグナルを運ぶもの | 何を検査すべきか |
|---|---|---|
| SynthID Text | 生成中に行われた統計的なトークン選択 | 対応するウォーターマーク設定のもとでの証拠 |
| 隠し文字マーカー | 文字列に挿入された特定の文字 | その文字の並びと、文書化されたエンコーディング |
| ドキュメントのメタデータ | 文書やコンテナに付与されたフィールド | メタデータ、その出所、および署名の有無 |
| AI文章分類器 | サンプルテキストから学習したパターン | 想定読者における汎化性能と偽陽性 |
UnicodeスキャナーはSynthID検出器の代わりにはなりません。珍しい文字が見つかったからといって、AIによる著作が証明されるわけでもありません。AmICitedの無料ツールの 紹介記事では、文字ベースのウォーターマークシグナルとその限界を扱っています。以下の実験は統計的ウォーターマークに関するものです。
Pythonでウォーターマーク入りのテキストを生成する
Googleのリポジトリは研究用のリファレンスであり、そのモデルサブクラスを本番環境で使わないよう明記しています。同リポジトリは、Hugging Face Transformersにおける実装を参照しています。また、平均値、重み付き平均値、学習済みベイズ検出という手法も提供しています。 リポジトリの利用上の注意
以下の例では、Python 3.13、Transformers 4.57.1、PyTorch 2.8.0を使用します。これらは再現可能なサンプルのバージョンであり、最新リリースであることを主張するものではありません。CPUで動作し、初回利用時に公開モデルdistilbert/distilgpt2をダウンロードします。この小さなモデルは実験を手軽にするためのもので、その文章品質が現在のアシスタントを代表するものではありません。
独立した環境を作成します:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
本ガイドのPythonブロックを、順番どおりにwatermark_demo.pyへ保存してください。まずは生成から始めます:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# 公開デモ用の鍵。本番の非公開マークとしてこれらを使わないこと。
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # 続きの部分だけを保持する。与えたプロンプトはウォーターマークされていない。
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
生成には、互換性のあるサンプリングパイプラインを公開している必要があります。ホスト型APIから受け取った完成済みの応答をこの設定に渡しても、後からマークを付けることはできません。別のモデルで新しいバージョンを生成する必要があります。
本番環境では、一意のランダムな鍵を作成し、その設定を非公開に保ってください。トークナイザーのリビジョン、モデルのリビジョン、設定のバージョン、および対応する検出器を保持します。鍵をローテーションすると新しい設定が作られるため、古い出力も引き続き認識する必要がある場合は、以前の検出設定を保持してください。 Googleの実装ガイド
ウォーターマーク検出が証拠を計算する方法
検出は、候補テキストをトークン化し、対象となる各トークンウィンドウとウォーターマークの各レイヤーについてスコアを再構成することから始まります。ここで用いる実装では、これらの二値スコアはg値と呼ばれます。反復された文脈と、系列終端トークン以降の位置を除外したうえで、それらを平均します。続きの最初の4トークンだけでは、5トークンの完全なウィンドウを形成できません。
次の関数は、 Transformersのスコアリングとマスキングのメソッドを使用します。パディングされていない1つの系列を受け取り、生の平均値を返します。これは著者確率ではありません。
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # ブールインデックスにより、レイヤーの次元は保持される。
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
トークンIDを直接検査する方法は、生成をテキストのシリアライズから切り離します。2つ目の検査は、公開後に検出器がたどる経路を試します。実際の公開およびテキスト抽出のパイプラインは入力を変化させる可能性があるため、それを使って評価してください。
**スコアが0.60であることは、そのテキストをAIが書いた確率が60%であることを意味しません。**この関数には、較正された判定しきい値がありません。短い文章では、偶然に高いスコアが出ることがあります。証拠が不十分な場合は、判断不能な結果として報告してください。
有用な検出器を作るには、代表的な人間のテキスト、ウォーターマークなしのモデル出力、ウォーターマークありの出力を集めてください。較正用データは最終評価用データとは分けて保持します。許容できる偽陽性率に対するしきい値を選び、ホールドアウトしたサンプルで検出率を評価し、結果を言語、長さ、コンテンツ種別ごとに分解します。マークあり/なしの1組だけでは、サンプルが動作することしか確認できません。
学習済みの代替手段として、Hugging Faceはベイズ検出器と 検出器の学習ワークフローを提供しています。無関係な鍵で学習された検出器は、あなたの検出器の代替にはなりません。ランダムに初期化されたチェックポイントやデモ用チェックポイントでは、検出精度は確立できません。

AI可視性のトレンドを逃さない
AIでの言及、ブランドモニタリング、最適化戦略に関する最新情報をお届けします。
鍵なしで任意のSynthIDウォーターマークを検出できますか?
公開されている検出手法には、対応する設定が必要です。互換性のあるトークン化も必要です。あるプロバイダーがSynthIDアルゴリズムを使っていると分かっても、その設定が手に入るわけではなく、公開リポジトリはあらゆるプロバイダーの出力を検出できる検出器ではありません。
Googleは、非公開の検出器、APIを通じて公開される検出器、一般に配布される検出器について説明しています。プロバイダーは、非公開設定を開示することなく検証手段を提供することができます。 検出と検証可能性
自社のシステムであれば、既知の設定のレジストリを検査できます。次の例を追加すると、正しい鍵と無関係なデモ用の鍵を比較できます:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
組み立てたファイルはpython watermark_demo.pyで実行します。この比較は、既知の2つの設定に対する証拠を生成します。任意の未知の鍵を発見することはできず、どちらのスコアも意図的に「検出」とはラベル付けしていません。
多数の設定を検査することは、多数の統計的検定を行うことでもあります。各検定が偽陽性を許容するのであれば、いずれかの陽性を採用すると全体の偽陽性率が上がる可能性があります。探索手順全体を較正してください。個々の検定が妥当なp値を与える場合、保守的な選択肢は、許容する偽陽性の総量を検定の数で割ることです。その計算を生のmean_gスコアに直接適用しないでください。
既知のどの設定にも一致しない場合、適切な結果は「対応するウォーターマークは検出されませんでした」です。可能性としては依然、人間による執筆、ウォーターマークなしのAI出力、未知のウォーターマーク、シグナルが弱すぎる編集済みの文章などが残ります。
同じテキストに複数のSynthIDウォーターマークを入れられますか?
検討すべき設計は2つあります。
1つの設定内の複数レイヤー
SynthIDはもともと鍵のリストをサポートしています。例では、30個の鍵が1つの設定済みウォーターマーク内に30個のレイヤーを作ります。検出器はそれらの証拠を統合します。これらの鍵が自動的に、個別に帰属できる30人の著者や組織を表すわけではありません。 ウォーターマークの設定
独立して検出できるプラットフォーム用と顧客用のマーク
同じ文章を、プラットフォーム全体の検出器と、顧客ごとの別の検出器の両方で認識させたいとします。レイヤーのグループをそれらの用途に割り当てることは実験的な設計上の選択肢であり、ライブラリが文書化した保証ではありません。
2つの鍵リストを単純に連結しても、元の2つの検出器がどちらも機能し続けることは示せません。各検出器は、統合された生成プロセス上で、レイヤー順序における位置も含めて評価する必要があります。各マークの検出率、他の顧客とのクロスマッチ、編集後の挙動を測定してください。これは実験を要するエンジニアリング上の提案であり、SynthIDが独立した複数所有者の帰属を標準で提供するという主張ではありません。
中央のサービスが顧客を識別するだけでよい場合、より単純な設計は、顧客ごとに1つの設定を持ち、内部レジストリで管理する方法です。その設計でもレジストリ全体での較正が必要です。また、顧客の設定を検索せずに確認できる、プラットフォーム全体の別個のマークは提供されません。
既存のウォーターマークを置き換えられますか?
SynthIDは、テキスト内にwatermark_idのようなフィールドを保存しません。上書きすべきメタデータ値は存在しません。元のシグナルはトークンの選択全体に分散しています。
2つ目のウォーターマーク付き生成器を使って文章を書き直すと、新しい生成プロセスが独自のシグナルを導入します。以前のシグナルへの影響は、結果として得られるトークンの並びによって決まります。Googleによれば、軽微な編集では検出可能性が保たれることがある一方、徹底的な書き直しや翻訳は信頼度を大幅に下げる可能性があります。 文書化された変換の限界
したがって、2つ目のウォーターマークは1つ目の消去を保証しません。両方のシグナルが検出可能なまま残ることもあれば、片方または両方が検出しきい値を下回ることもあります。これは統合されたワークフローに関する推論であり、引用したドキュメントがあらゆるウォーターマークの組み合わせについて残存率を示しているわけではありません。
1つ目の設定が不明な場合、実務上の限界が生じます。自社の検出器で自社のマークは評価できますが、元のマークが消えたことは確認できません。それには、元の対応する検出器へのアクセスが必要です。否定的な結果であっても、その検出器が設定のもとで十分な証拠を見つけられなかったという意味であり、すべての痕跡が除去された証明ではありません。
重複するウォーターマークを検査する方法
マークが共存する、あるいは一方が他方を置き換えると主張する前に、テストマトリクスを使ってください。以下の項目は、実施すべき実験を説明するものであり、測定結果ではありません。
| サンプル群 | 検出器A | 検出器B | 比較で確認できること |
|---|---|---|---|
| 人間のテキストとウォーターマークなしのAIテキスト | 実行 | 実行 | ベースラインの偽陽性 |
| Aのみで生成したテキスト | 実行 | 実行 | Aの検出と、偶発的なBの一致 |
| Bのみで生成したテキスト | 実行 | 実行 | Bの検出と、偶発的なAの一致 |
| 実験的な統合設定で生成したテキスト | 実行 | 実行 | 意図した各マークが検出可能かどうか |
| Bで書き直したAのテキスト | 実行 | 実行 | 書き直し後のAの残存とBの検出 |
| 各群の短い抜粋と編集版 | 実行 | 実行 | 公開ワークフローへの感度 |
ホールドアウトしたプロンプトを使い、使用可能なテキスト長、サンプル数、検出器のバージョン、しきい値、偽陽性率を報告してください。報告した率には不確実性も含めます。鍵、トークン化、モデルのバージョン、生成設定を変更したときは、評価を繰り返してください。そうした確認が揃うまでは、共存や置き換えは未検証として扱ってください。
発信者とAI可視性にとっての意味
ウォーターマーク検出と AI引用モニタリングは、異なる問いに答えます。ウォーターマーク検査は、ある文章が特定の生成設定の証拠を持つかどうかを問います。引用モニタリングは、どの情報源がAIの回答に現れるかを確認します。
ウォーターマークが無いことを人間による執筆の証明として提示したり、ウォーターマークが検出されたことを特定のウェブサイトが引用された証明として提示したりしないでください。公開ワークフローでは、統計的検出器とあわせて生成記録と編集上の帰属情報を保持してください。それぞれが、他方にはない証拠を提供します。
 LinkedIn