


商品レコメンデーションエンジン
商品レコメンデーションエンジンとは、顧客の行動、購入履歴、製品間の関係性を分析し、関連商品、よく一緒に購入されるセット、またはパーソナライズされたおすすめなど、買い物客に関連性の高いアイテムを提案するシステムです。通常、協調フィルタリング、コンテンツベースマッチング、またはその両方を組み合わせたハイブリッド手法を活用します。レコメンデーションエンジンは、Eコマースブランドが平均注文額やリピート購入行動を向上させるための最も直接的な手段の一つです。
商品レコメンデーションエンジンの定義
商品レコメンデーションエンジンとは、顧客の行動、購入履歴、製品間の関係性を分析し、ショッピングジャーニーの重要なポイント(商品ページ、カート内、ホームページ、購入後のメールなど)で買い物客に関連性の高い商品提案を行うソフトウェアシステムです。すべての顧客に同じ汎用的な商品セットを表示するのではなく、レコメンデーションエンジンはデータのパターン(類似顧客が購入したもの、頻繁に一緒に購入される製品、特定の買い物客が過去に閲覧または購入したものなど)に基づいて表示内容を調整します。レコメンデーションエンジンは、シンプルなルールベースのシステム(手動で設定された「こちらもよく購入されています」ペア)から、新しいトランザクションデータが入ってくるたびに継続的に更新される高度な機械学習モデルまで多岐にわたります。基礎となる手法に関わらず、目標は同じです。買い物客が次に欲しくなるであろう商品を、最も行動に移しやすいタイミングで提示することです。
商品レコメンデーションエンジンの仕組み
ほとんどのレコメンデーションエンジンは、以下のアプローチの1つまたは組み合わせに依存しています。
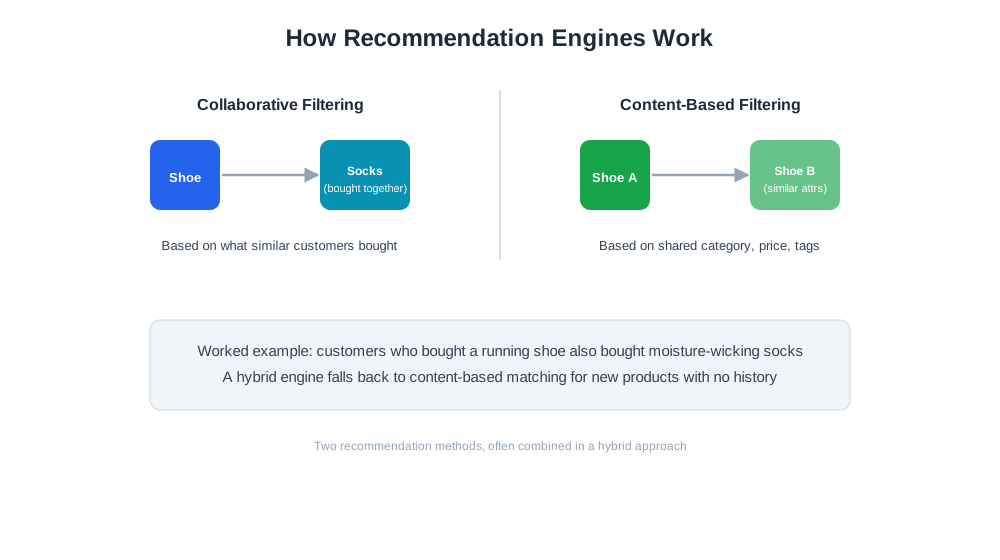
協調フィルタリングは、多くの顧客の行動パターンを分析し、類似した購入履歴や閲覧履歴を持つ顧客が購入したものに基づいて商品を推薦します。製品Aを購入した顧客が頻繁に製品Bも購入している場合、エンジンは製品Aを購入したばかりの新規顧客に製品Bを推薦します。製品の実際の属性について何も知らなくても可能です。
コンテンツベースフィルタリングは、共有属性(カテゴリ、素材、価格帯、ブランド、タグなど)に基づいて商品を推薦し、顧客が過去に閲覧または購入したアイテムとカタログ内の類似商品をマッチングします。このアプローチは、取引履歴が少ない新製品に対して効果的です。なぜなら、レコメンデーションを行うために他の顧客の行動に依存しないからです。
ハイブリッドアプローチは両方の手法を組み合わせ、十分な行動データがある場合は協調フィルタリングを使用し、行動パターンがまだ現れていない新製品や小規模カタログではコンテンツベースマッチングにフォールバックします。
具体例:顧客が特定のランニングシューズのモデルを購入したとします。協調フィルタリングエンジンは、そのシューズを購入した顧客の大部分が同じ注文内またはその直後に特定ブランドの吸湿発散性ソックスも購入していることに気づき、ソックスを「よく一緒に購入されている」提案として表示します。一方、コンテンツベースエンジンは独立して、同じカテゴリと価格帯の別のランニングシューズを共有属性に基づいて推薦するかもしれません。これは、チェックアウトの準備ができている顧客ではなく、まだ選択肢を比較している顧客に役立ちます。
Eコマースブランドにとって商品レコメンデーションエンジンが重要な理由
レコメンデーションエンジンは、EC事業者が平均注文額を増やすための最も直接的な手段の一つです。チェックアウト時や商品ページでの関連性の高いクロスセルやバンドル提案は、一般的なブラウジング体験では完全に逃していたであろう追加収益を生み出します。また、長期的にはリピート購入行動も促進します。購入後のメールやサイト内通知でのパーソナライズされた再注文リマインダーや関連商品の提案は、顧客が戻ってくるのを待つだけではなく、購入と購入の間もブランドとの関連性を維持します。直接的な収益効果に加えて、レコメンデーションエンジンは大規模なカタログ内で関連商品を見つけるために必要な労力を減らすことで、全体的なショッピング体験を向上させます。これは、製品数が増加し、手動でのブラウジングが現実的でなくなるにつれて、ますます重要になっています。
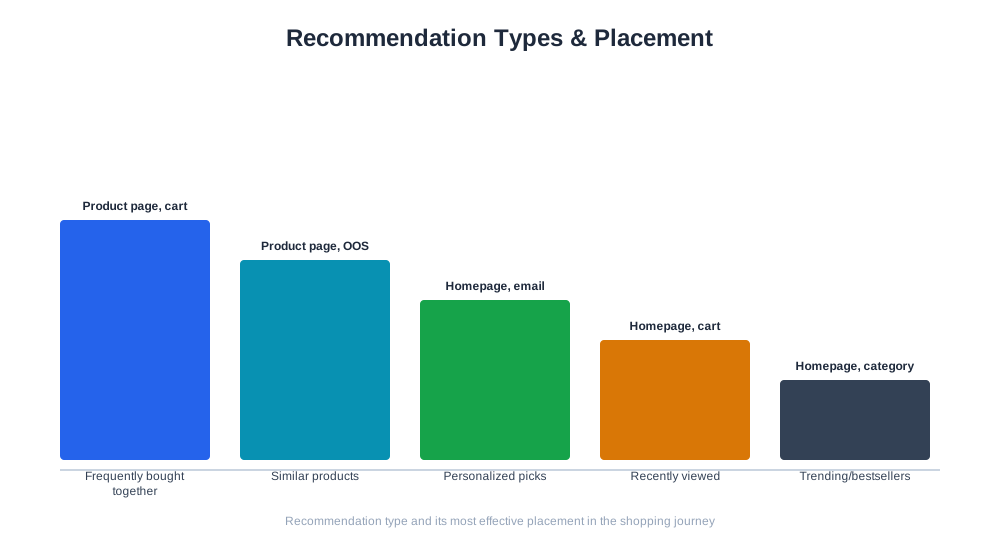
| レコメンデーションタイプ | 手法 | 最適な配置場所 |
|---|---|---|
| よく一緒に購入される | トランザクションデータの協調フィルタリング | 商品ページ、カート |
| 類似商品 | 属性のコンテンツベースマッチング | 商品ページ、在庫切れページ |
| パーソナライズおすすめ | 個別顧客の行動履歴 | ホームページ、メール |
| 最近閲覧した商品 | セッションベースの閲覧履歴 | ホームページ、カートリマインダー |
| トレンド / ベストセラー | 集計販売速度 | ホームページ、カテゴリページ |
商品レコメンデーションエンジンとAI主導のコマース
ChatGPT Shopping、Perplexity Shopping、Amazon RufusなどのAIショッピングアシスタントは、事実上の外部レコメンデーションレイヤーとして機能し、買い物客が小売業者の自社サイトに到達する前から商品提案を表示しています。これにより、サイト内レコメンデーションエンジンに求められる基準が引き上げられています。買い物客がAIアシスタントから得られるものと少なくとも同等の関連性とパーソナライゼーションを実現できなければ、小売業者はクロスセルやアップセルの機会をAIサーフェスが代わりに推奨するものに奪われるリスクがあります。AmICitedのeshop_get_product_affinityツールは、実際のトランザクションデータを分析し、どの製品が実際に一緒に購入されているか、順序立てて閲覧されているか、または重複する顧客セグメントによって購入されているかを明らかにします。これにより、EC事業者はどの製品がうまく組み合わさるかを手動で推測するのではなく、データに基づいたレコメンデーションロジックの基盤を得ることができます。このような実証されたアフィニティデータは、EC事業者が製品フィードと構造化データを実際の購入パターンと一致させるのにも役立ちます。これは、AIショッピングサーフェスがEC事業者のカタログから製品関係データを直接取り込むことが増えているため、重要です。

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
商品レコメンデーションエンジンのベストプラクティス
- レコメンデーションロジックは、どの製品がうまく組み合わさるべきかという前提ではなく、実際の取引データに基づく
- 意思決定に最も影響を与えやすいタイミング(商品ページ、カート、購入後)にレコメンデーションを配置する
- 1つのフォーマットがどこでも機能すると思い込まず、異なるレコメンデーションタイプ(よく一緒に購入される vs. パーソナライズおすすめ)をテストする
- 製品アフィニティと顧客行動は季節性やカタログの変更によって変化するため、レコメンデーションデータを定期的に更新する
- パターンに適合するという理由だけで在庫切れや低マージンの製品を推薦しない。関連性の低い提案はレコメンデーション機能への信頼を損なう
- 効果は、上昇があったと仮定するのではなく、コンバージョン率と平均注文額に関する管理されたA/Bテストを通じて測定する
商品レコメンデーションエンジンのよくある間違い
レコメンデーションエンジンを、それを支えるのに十分な取引データがないまま立ち上げること。 協調フィルタリングは信頼できるパターンを見つけるために十分な量の購入履歴を必要とします。小規模なカタログや低トラフィックのストアでは、データが少なすぎる機械学習モデルよりも、シンプルで手動キュレーションされたペアリングの方が価値が高いことがよくあります。関連性ではなく人気だけで商品を推薦すること。 顧客が実際に見ているものに関わらず、すべての顧客に同じベストセラーを表示することは、パーソナライゼーションの目的を無効にし、実際に関連性の高い行動ベースの提案よりもパフォーマンスが低下する傾向があります。古いデータにレコメンデーションを任せること。 前のシーズンや大規模なカタログ変更前のデータでトレーニングされたエンジンは、関連性のない製品や販売終了した製品を表示し続ける可能性があり、これはレコメンデーションがない状態よりも早く機能への信頼を損なうことになります。1ページにレコメンデーションブロックを詰め込みすぎること。 1ページに複数のレコメンデーションカルーセルを積み重ねると、買い物客を圧倒し、個々の提案の効果を薄めてしまいます。適切に配置された少数の明確に関連性の高いレコメンデーションの方が、一般的にごちゃごちゃしたページよりも優れたパフォーマンスを発揮します。レコメンデーションのパフォーマンスをサイト全体のコンバージョンと分けて測定しないこと。 A/Bテストを通じてレコメンデーション配置に起因する具体的な上昇効果を切り離さなければ、その価値を過大評価したり、レコメンデーションブロックのパフォーマンスが低下して調整や削除が必要になったことに気づかないリスクがあります。