


SKU
SKU (Stock Keeping Unit) to unikalny alfanumeryczny kod, który sprzedawca przypisuje konkretnemu wariantowi produktu, aby śledzić go w magazynie, sprzedaży i realizacji zamówień. W przeciwieństwie do kodu UPC czy kodu kreskowego, SKU jest wewnętrznym oznaczeniem firmy i może kodować atrybuty takie jak rozmiar, kolor czy lokalizacja w magazynie. Każda odrębna, zbywalna odmiana produktu otrzymuje własny SKU.
Definicja SKU
SKU (Stock Keeping Unit) to unikalny identyfikator tworzony przez firmę w celu śledzenia konkretnej, zbywalnej wersji produktu w systemach magazynowych, zamówień i sprzedaży. Jeśli bluza występuje w trzech kolorach i czterech rozmiarach, to dwanaście SKU, ponieważ każda kombinacja musi być liczona, wyceniana i zamawiana niezależnie. SKU to nie to samo co nazwa produktu ani oferta — jeden produkt może mieć wiele SKU, po jednym dla każdego wariantu, który klient może faktycznie wybrać i kupić. SKU są wewnętrzne dla firmy, która je tworzy, co odróżnia je od UPC i EAN, które są standaryzowanymi kodami nadawanymi przez zewnętrzny organ (GS1) i współdzielonymi przez wszystkich sprzedawców danego przedmiotu. Sprzedawca może zatem stworzyć własny SKU dla produktu, który kupuje hurtowo, nakładając wewnętrzny kod na kod kreskowy producenta, aby jego własny magazyn i systemy raportowania mogły go spójnie śledzić.
Jak zbudowane są kody SKU
Nie ma uniwersalnego standardu formatu SKU, co jest zarówno zaletą, jak i częstym źródłem chaosu. Większość sprzedawców tworzy krótki ciąg alfanumeryczny, który koduje atrybuty istotne dla magazynu i raportowania: kategoria, linia produktowa, kolor i rozmiar to typowe elementy składowe. Typowy wzór wygląda jak TSH-CREW-BLK-L dla czarnej koszulki typu crew-neck w rozmiarze L lub MUG-CER-12OZ dla ceramicznego kubka o pojemności 12 uncji. Dobry projekt SKU zwykle kieruje się kilkoma zasadami: utrzymuj kody o spójnej długości, aby łatwo było je skanować wzrokowo i sortować w arkuszu kalkulacyjnym, unikaj spacji i znaków specjalnych, które mogą zakłócić import CSV lub slugi URL, i spraw, aby kod był na tyle czytelny, że pracownik magazynu rozpozna produkt na podstawie samego kodu, bez konieczności sprawdzania w systemie. Niektóre firmy zamiast tego używają sekwencyjnych numerycznych SKU (10001, 10002…) generowanych automatycznie przez platformę, zamieniając czytelność na gwarantowaną unikalność. Każde podejście działa, o ile jest stosowane konsekwentnie — problemem jest zwykle niekonsekwencja: jedna linia produktów kodowana ręcznie, inna generowana automatycznie, bez wspólnej logiki między nimi.

Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Dlaczego śledzenie na poziomie SKU ma znaczenie w e-commerce
Szczegółowość SKU umożliwia w ogóle zarządzanie zapasami. Zagregowane stany magazynowe na poziomie „produktu" ukrywają fakt, że jeden wariant jest wyprzedany, a inny jest nadmiernie magazynowany — sklep może wyświetlać „Koszulka: w magazynie", podczas gdy rozmiar, który faktycznie się sprzedaje, oczekuje na dostawę od dwóch tygodni. Śledzenie na poziomie SKU leży też u podstaw obliczania punktów ponownego zamówienia, ponieważ rozmiar M i rozmiar XL tej samej koszulki sprzedają się w różnym tempie i wymagają różnych progów zamówienia. Poza magazynem, SKU jest naturalnym kluczem łączenia do analizy marży: gdy SKU ma przypisany koszt nabycia (koszt jednostkowy, fracht, opakowanie), każda pozycja zamówienia może zostać powiązana z rzeczywistym kosztem, a przychód i rentowność mogą być raportowane na tym samym poziomie szczegółowości, którego magazyn używa do zarządzania zapasami. Bez danych kosztowych na poziomie SKU raportowanie rentowności musi opierać się na średnich na poziomie zamówienia, które zacierają różnicę między produktami o wysokiej marży a tymi przynoszącymi straty, ukrywając, które SKU warto promować.
SKU a UPC a ID produktu
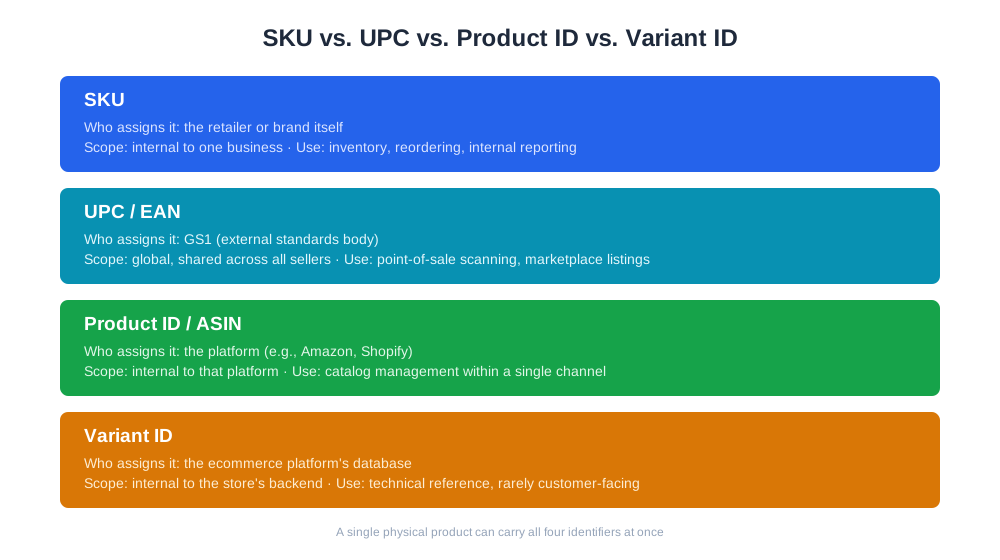
| Identyfikator | Kto nadaje | Zakres | Typowe zastosowanie |
|---|---|---|---|
| SKU | Sam sprzedawca lub marka | Wewnętrzny dla jednej firmy | Magazyn, zamawianie, raportowanie wewnętrzne |
| UPC / EAN | GS1 (zewnętrzny organ normalizacyjny) | Globalny, współdzielony przez wszystkich sprzedawców | Skanowanie w punktach sprzedaży, listingi na marketplace’ach |
| Product ID / ASIN | Platforma (np. Amazon, Shopify) | Wewnętrzny dla danej platformy | Zarządzanie katalogiem w obrębie jednego kanału |
| Variant ID | Baza danych platformy e-commerce | Wewnętrzny dla backendu sklepu | Odniesienie techniczne, rzadko widoczny dla klienta |
Jeden fizyczny produkt może mieć jednocześnie wszystkie cztery: nadany przez producenta UPC, nadany przez sprzedawcę SKU, nadany przez marketplace ASIN i nadany przez platformę identyfikator wariantu. Sprzedawcy wielokanałowi zwykle potrzebują tabeli mapowania, która uzgadnia te identyfikatory, aby sprzedaż na Amazonie i sprzedaż przez sklep Shopify spływały do tego samego bazowego SKU do celów raportowania.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Dane SKU a handel oparty na AI
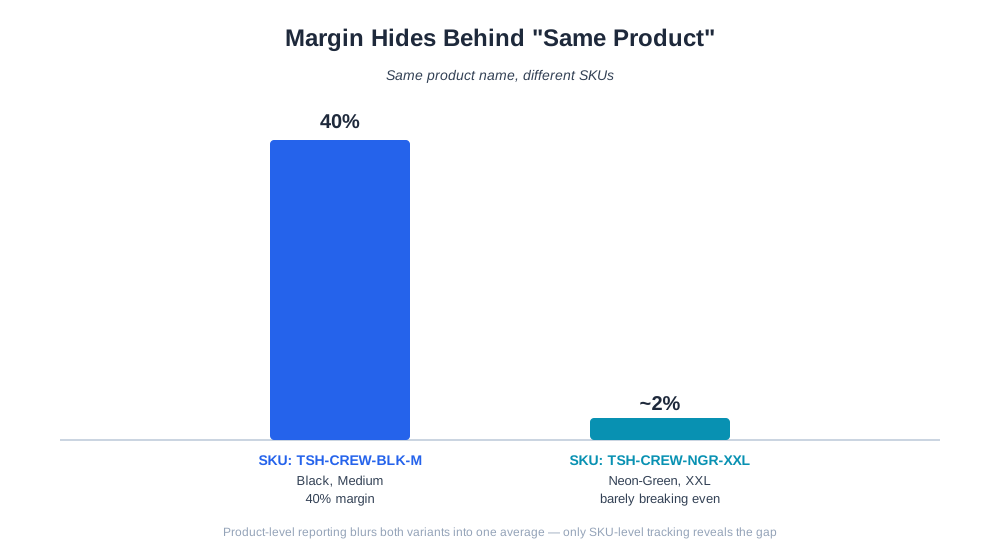
Ponieważ zakupy coraz częściej odbywają się za pośrednictwem asystentów AI, takich jak ChatGPT Shopping, Perplexity Shopping i Amazon Rufus, kanały danych produktowych — strukturalne informacje, które mówią tym systemom, co jest w magazynie, w jakiej cenie i w jakim wariancie — zależą od czystych danych na poziomie SKU. Asystent AI rekomendujący „średni w niebieskim" potrzebuje, aby źródło danych rozpoznało to jako konkretny SKU z rzeczywistym stanem i ceną, a nie ogólną ofertę produktową. Nieczyste lub zduplikowane SKU to częsty powód odrzucania lub błędnego przedstawiania kanałów produktowych na tych platformach. Po stronie analitycznej narzędzia takie jak raporty eshop_get_products i eshop_list_product_costs AmICited działają na poziomie szczegółowości SKU właśnie dlatego, że na tym poziomie faktycznie udzielane są odpowiedzi na pytania o rentowność — „który wariant tego produktu warto nadal magazynować" to pytanie na poziomie SKU, a nie nazwy produktu. Raportowanie przychodu i marży według SKU, a nie według tytułu produktu, pozwala sprzedawcy zobaczyć, że czarny rozmiar M sprzedaje się z 40% marżą, podczas gdy neonowo-zielony XXL, mimo że jest „tym samym produktem", ledwo wychodzi na zero.
Najlepsze praktyki zarządzania SKU
- Ustal jeden kanoniczny SKU na wariant przed wystawieniem w wielu kanałach i odwzoruj każdy identyfikator specyficzny dla kanału z powrotem na niego
- Utrzymuj kody SKU krótkie, o spójnej długości i pozbawione spacji oraz znaków specjalnych
- Przypisz koszt nabycia do każdego SKU, nie tylko cenę detaliczną, aby marża mogła być obliczana automatycznie
- Unikaj ponownego użycia wycofanego SKU dla nowego, niezwiązanego produktu — raportowanie historyczne będzie mylić oba
- Regularnie audytuj pod kątem duplikatów lub prawie duplikatów SKU (częsty skutek ręcznych edycji w arkuszach kalkulacyjnych)
- Uwzględniaj SKU w każdym eksporcie — zamówieniach, zwrotach i arkuszach kosztów — aby zestawy danych zawsze można było połączyć
Częste błędy związane z SKU
Częstym problemem jest traktowanie „produktu" i „SKU" jako wymiennych w raportowaniu, co daje stany magazynowe i marże wyglądające dobrze w agregacie, ale ukrywające słabo radzący sobie wariant pod dobrze radzącym. Rozwiązaniem jest upewnienie się, że każdy raport — sprzedaż, stany, koszty — jest generowany na poziomie SKU i dopiero na poziom produktu agregowany jako wygoda wyświetlania, a nie jako podstawowa kalkulacja. Innym częstym problemem jest dryf SKU między kanałami sprzedaży: sprzedawca tworzy jeden schemat SKU w systemie POS, inny jest generowany automatycznie przez platformę e-commerce, a trzeci format pojawia się w ofercie na marketplace, nie pozostawiając wiarygodnego sposobu na uzgodnienie całkowitej sprzedaży dla danego wariantu bez ręcznego dopasowywania. Standardowym rozwiązaniem jest centralnie utrzymywana tabela mapowania, najlepiej w platformie raportującej, a nie tworzona ad hoc w arkuszu kalkulacyjnym za każdym razem. Trzecim błędem jest ponowne używanie SKU po wycofaniu produktu i zastąpieniu go nowym — nowa formuła lub przeprojektowanie z użyciem starego SKU zaciemnia historyczne dane trendów, sprawiając, że wygląda to, jakby ten sam produkt nagle zmienił wyniki, zamiast pokazać czysty podział przed/po. Wreszcie, wielu mniejszych sprzedawców pomija przypisanie rzeczywistego kosztu nabycia do każdego SKU, domyślnie używając płaskiej szacowanej marży dla całego katalogu; to sprawia, że raportowanie rentowności na poziomie SKU jest technicznie możliwe, ale praktycznie mylące, ponieważ nie może ujawnić rzeczywistego rozrzutu między najlepszymi i najgorszymi wariantami.