


Marketing mix modeling (MMM) är en statistisk metod som uppskattar hur mycket varje marknadsföringskanal har bidragit till försäljningen, med hjälp av veckototaler för utgifter och resultat i stället för att spåra enskilda användare. Den besvarar den budgetfråga som plattformarnas instrumentpaneler inte kan: om du flyttar pengar från en kanal till en annan, vad händer sannolikt med den totala försäljningen?
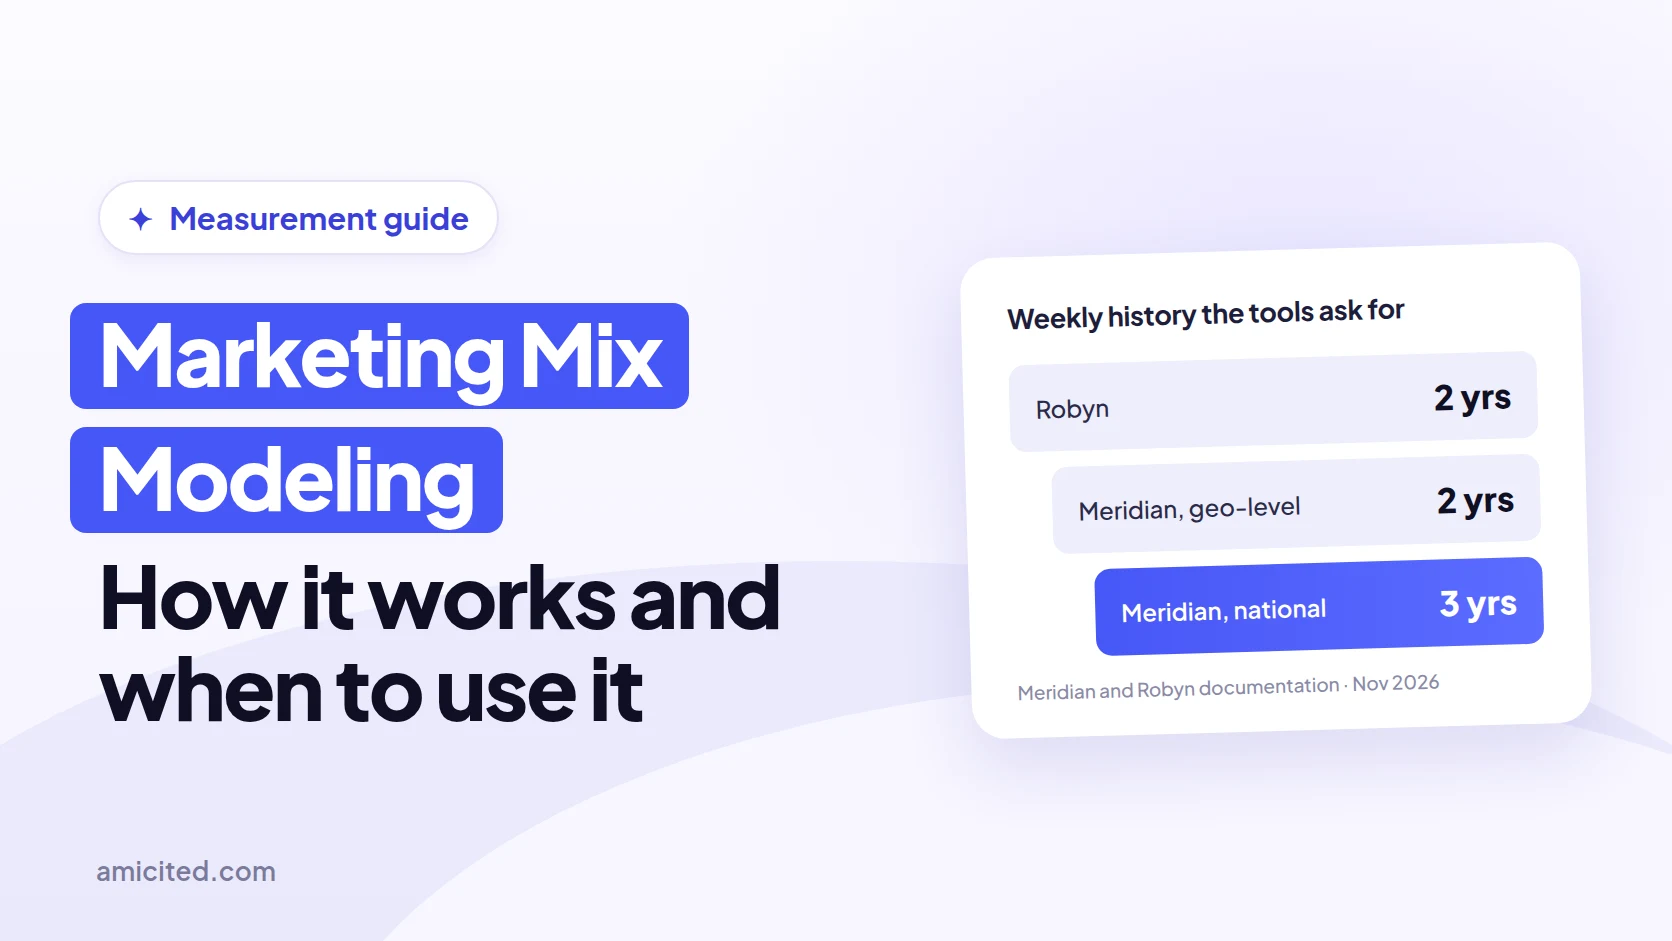
Haken är data. Googles Meridian-dokumentation ber om minst två års veckodata för en modell på geografinivå och tre år för en nationell. Metas Robyn-guide ber om minst två års veckodata. Många e-handelsvarumärken har inte så mycket ren historik, så den här guiden tar också upp vad du gör med mindre.
Nedan: hur MMM fungerar, hur det jämförs med multi-touch attribution och inkrementalitetstester och hur du läser resultaten, samt en fråga som få MMM-guider ställer: höjer eller sänker betald sökning din organiska trafik?
Viktiga slutsatser
- Marketing mix modeling uppskattar varje kanals bidrag utifrån veckototaler för utgifter och utfall. Den behöver inga cookies eller spårning på användarnivå, så sekretessförändringar bryter inte den.
- Googles Meridian ber om minst 2 års veckodata på geografinivå och 3 år på nationell nivå, enligt dess dataguide. Metas Robyn ber om 2 års veckodata och ungefär 10 observationer per variabel.
- Tre års veckodata är bara 156 datapunkter. I Meridians eget exempel är det ungefär 15 per parameter för en modell med 10 parametrar, tillräckligt för “riktningsgivande information”.
- Multi-touch attribution fördelar äran mellan spårade klick. Inkrementalitetstester jämför en grupp som såg annonser med en som inte gjorde det. MMM är den som täcker alla kanaler på en gång.
- Meridian, Robyn och PyMC-Marketing tar alla emot resultat från lyfttest för att kalibrera modellen, vilket är det vanliga sättet att kombinera MMM med experiment.
- Budgetbeslut bör följa marginell ROI, avkastningen på nästa utgiftsenhet, inte genomsnittlig ROI. Meridians dokumentation säger att en mycket lägre mROI än ROI signalerar mättnad.
Vad marketing mix modeling är
Marketing mix modeling är en regressionsliknande modell som förklarar ett affärsutfall, till exempel veckointäkt, som summan av en baslinje plus effekten av varje marknadsföringskanal. Eftersom den arbetar med aggregerade veckototaler kan den inkludera kanaler som ingen pixel ser, som TV, poddar eller print, och den påverkas inte av förlorade cookies eller samtyckesbanners.
Resultatet är en skattning av hur mycket varje kanal tillförde, hur effektiv den var och hur utfallet skulle förändras vid olika utgiftsnivåer. Det gör MMM till ett planeringsverktyg för fördelning av marknadsföringsbudget, inte ett rapporteringsverktyg för gårdagens kampanjer.
Media mix modeling är samma metod tillämpad enbart på betald media. Marketing mix modeling kan i strikt mening också omfatta pris, kampanjer och distribution. De flesta använder de två namnen synonymt, och båda förkortas MMM.
Så fungerar MMM
En MMM anpassar en ekvation till din veckohistorik: utfallet är lika med baslinjen, plus säsong och andra kontroller, plus en transformerad effekt för varje kanal. Transformationerna är det som gör den till mer än en vanlig regression: de modellerar att annonser fortsätter verka efter veckan de kördes och att varje extra utgiftsenhet ger mindre än den förra.
Byggstenarna:
| Komponent | Vad den fångar | Exempel |
|---|---|---|
| Baslinje | Försäljning du skulle få utan marknadsföring: varumärke, mun till mun, återkommande köpare | En butik som säljer 300 ordrar i veckan även när alla annonser pausas |
| Säsong och kontroller | Årliga cykler, helgdagar, kampanjer, prisändringar | Black Friday, en sommarsvacka, en rea på 20 % i hela butiken |
| Adstock (eftereffekt) | Annonser påverkar försäljningen i veckor efter att de körts | En videokampanj vars effekt avtar under de följande 3–4 veckorna |
| Mättnad (avtagande avkastning) | Varje extra utgiftsenhet tillför mindre än den förra | Att fördubbla Meta-utgifterna ger 40 % mer försäljning, inte 100 % |
| Priors och trovärdighetsintervall | Vad modellen antar innan den ser data, och hur säker den är efteråt | “Sök-ROI ligger mellan 1,8 och 3,1, med 90 % sannolikhet” |
Exemplen i tabellen är illustrativa, inte data från en verklig butik.
Googles Meridian modellerar till exempel eftereffekt med en adstock-funktion och mättnad med en Hill-kurva, vars form avgör om avkastningen avtar gradvis eller följer en S-kurva.
Bayesiansk MMM i klartext
En bayesiansk MMM börjar med en prior, ett angivet intervall av rimliga värden för varje kanals effekt, och uppdaterar den med din data. Resultatet är en fördelning, sammanfattad som ett trovärdighetsintervall: “med 90 % sannolikhet ligger den här kanalens ROI mellan X och Y.” Meridians dokumentation beskriver priors som utgångspunkter: om datan starkt motsäger en prior justerar modellen sig.
Det praktiska värdet är ärlighet om osäkerhet. Ett brett intervall säger att datan inte kan skilja den kanalens effekt från allt annat. Det är mer användbart än ett enda självsäkert tal som visar sig vara brus.
Hur mycket data du behöver
Räkna med två till tre års veckodata. Googles Meridian ber om minst två år på geografinivå och tre år på nationell nivå, eller tre år om du bara har månadsdata. Robyn ber om minst två års veckodata och ungefär en variabel per tio observationer. Mindre data ger bredare intervall och större vikt på modellens antaganden.
Varför så mycket? Två skäl:
- Säsongsvariation upprepas en gång om året. Med 52 veckor ser modellen varje helgdag en gång och kan inte avgöra om försäljningen steg på grund av Black Friday eller för att du höjde utgifterna den veckan. Två eller tre cykler låter den skilja de två åt.
- Varje kanal lägger till parametrar. Varje kanal behöver minst en effektstorlek, en eftereffektstakt och en mättnadsform. Meridians dokumentation går igenom en nationell modell med 10 parametrar och 156 veckodatapunkter, ungefär 15 datapunkter per parameter, och kallar det tillräckligt för att “glean some directional information” (få viss riktningsgivande information).
Samma sida säger att vägledningen är “rough and directional” (grov och riktningsgivande), och att den mest exakta kontrollen är att anpassa modellen och titta på trovärdighetsintervallens bredd.
Variation i utgifter spelar lika stor roll som historikens längd. Om en kanal hade samma utgift varje vecka i två år har modellen inget att lära sig av. Meridians dokumentation noterar att otillräcklig variation i mediautgifter skadar nationella modeller.
Vad du gör med mindre än tre års data
De flesta e-handelsvarumärken har ett till två års användbar data, ofta mindre efter en spårningsändring eller ett plattformsbyte. Du kan ändå modellera, om du justerar vad du förväntar dig av den:
- Fyll på äldre utgifter i efterhand. Annonsplattformar och fakturor har ofta mer historik än ditt analysverktyg. Lägg in den som kostnader i stället för att börja från dagen du anslöt.
- Slå ihop små kanaler. Meridians dataguide råder dig att kombinera kanaler med låga utgifter med andra för att undvika instabila ROI-skattningar. Färre, större kanaler ger varje skattning mer data.
- Använd data på geografinivå om du har den. Geografimodeller delar information mellan regioner, så samma veckor ger fler datapunkter per effekt, enligt Meridians guide.
- Kalibrera med ett lyfttest. Ett välgenomfört experiment på din största kanal ger modellen en mycket snävare prior än dess standardvärden.
- Variera utgifterna med avsikt. Planerade stegändringar eller korta pauser i en kanal skapar den variation modellen behöver.
- Läs resultatet som vägledande. Med ett år eller mindre är årlig säsongsvariation delvis en gissning. Använd modellen för att rangordna kanaler och upptäcka mättnad, inte för att lova ett intäktstal.

Håll dig uppdaterad om trender inom AI-synlighet
Få de senaste insikterna om AI-omnämnanden, varumärkesövervakning och optimeringsstrategier.
MMM jämfört med attribution och inkrementalitet
Marketing mix modeling, multi-touch attribution och inkrementalitetstester besvarar tre olika frågor. MMM uppskattar vad varje kanal bidrog med till den totala försäljningen över tid. Multi-touch attribution fördelar äran för varje spårad konvertering mellan de kontaktpunkter den såg. Inkrementalitetstester mäter om en aktivitet orsakade extra försäljning genom att jämföra exponerade och oexponerade grupper.
| Marketing mix modeling | Multi-touch attribution | Inkrementalitetstester | |
|---|---|---|---|
| Fråga | Vad bidrog varje kanal med, och vart bör nästa budgetenhet gå? | Vilka spårade kontaktpunkter fanns på vägen till varje konvertering? | Orsakade den här kampanjen försäljning som inte hade skett ändå? |
| Data | Veckovisa utgifter, visningar och utfallstotaler, 2–3 år | Klick, visningar och konverteringar på användarnivå | En testgrupp och en kontrollgrupp, under testet |
| Cookies och integritet | Behövs inte; endast aggregerad data | Beror på cookies, pixlar och samtycke | Användarbaserade tester bygger på annonsplattformens identitet; geotester använder bara regioner |
| Snabbhet | Långsam att sätta upp; veckovis eller månadsvis uppdatering | Nästan i realtid | Veckor per test |
| Kostnad | Öppen källkod är gratis men kräver kompetens; hostade verktyg tar betalt | Ofta inbyggt i analys- och annonsverktyg | Undanhållna annonser eller holdout-regioner, plus uppsättningstid |
| Detaljnivå | Kanal eller kampanjgrupp | Kampanj, annons, sökord | En kanal, kampanj eller region i taget |
| Bäst för | Budgetfördelning mellan kanaler, offlinemedia | Daglig kampanjoptimering | Bevisa kausalitet, kalibrera modeller |
| Största svaghet | Observationsskattning; kräver lång, varierad historik | Äran är inte kausalitet; missar ospårade och offline-kontaktpunkter | Snävt: besvarar en fråga per test |
Multi-touch attribution och modeller med en kontaktpunkt som last-click-attribution räknar konverteringar de kan se. Annonsplattformar räknar sina egna, och därför stämmer Metas siffror sällan med din butiks. Vår rapport Meta Attribution Reality lägger de två sida vid sida. Ingen av dessa bevisar att en annons orsakade en försäljning.
Inkrementalitetstester är experimentet som kan det. Google beskriver sitt Conversion Lift som ett sätt att dela upp din målgrupp i personer som ser dina annonser och personer som inte gör det och mäta skillnaden. Google noterar att verktyget inte är tillgängligt för alla Google Ads-konton. En geo-holdout fungerar likadant med regioner: välj matchade regioner, pausa eller ändra utgifterna i några och jämför försäljningen mot resten. Till skillnad från ett A/B-test på en webbplats, som jämför två versioner av en sida, jämför ett lyfttest annonser mot inga annonser.
Så fungerar de tillsammans
Standardupplägget använder MMM för budgetfördelningen, attribution för daglig optimering inom en kanal och lyfttest för att kontrollera och kalibrera modellen. Kalibrering innebär att ett experiments resultat blir prior för den kanalen, så att modellen utgår från uppmätta belägg i stället för ett generiskt antagande. Alla tre stora MMM-verktyg med öppen källkod stöder det.
- Meridian definierar kalibrering som
“using experiment results and other domain knowledge to set channel-specific priors” (att använda experimentresultat och annan domänkunskap för att sätta kanalspecifika priors), och har en
CalibrationBuildersom gör om inkrementalitetsexperiment till ROI-priors. - Robyn “strongly recommend[s]” (rekommenderar starkt) experimentresultat som facit för kalibrering, accepterar dem bara som punktskattningar och avråder från studier med låg tillförlitlighet, enligt dess analytikerguide.
- PyMC-Marketing listar kalibrering med lyfttest som en kärnfunktion.
En praktisk cykel: anpassa modellen, hitta kanalen med det bredaste intervallet eller den största budgeten, kör ett lyfttest på den, mata tillbaka resultatet och anpassa om. Varje test snävar in modellen där det spelar störst roll.
Så läser du MMM-resultat
Läs fyra utdata i den här ordningen: bidrag (hur mycket av utfallet varje kanal förklarar), ROI (genomsnittlig avkastning på allt som lagts ut), marginell ROI (avkastning på nästa utgiftsenhet) och responskurvor (hur avkastningen förändras när utgifterna stiger). Basera budgetförflyttningar på marginell ROI och kurvorna, och kontrollera trovärdighetsintervallet innan du agerar på ett enskilt tal.
- Bidrag är den andel av utfallet som modellen tillskriver varje kanal, där baslinjen vanligen är den största delen.
- ROI är inkrementellt utfall dividerat med utgifter. Om utfallet är intäkt är ROI intäkt, inte vinst. Till exempel går en kanal med ROI 2 vid 40 % bruttomarginal med förlust när produktkostnaderna räknas in. Vårt inlägg om break-even-ROAS, sann ROAS, MER och POAS går igenom marginalräkningen.
- Marginell ROI (mROI) är avkastningen på nästa enhet över nuvarande utgifter. Meridians dokumentation säger att när mROI är mycket lägre än ROI börjar kanalen mättas.
- Responskurvor visar det modellerade utfallet vid olika utgiftsnivåer för en kanal, med de andra konstanta. Meridian varnar för att punkter långt över eller under historiska utgifter är extrapoleringar.
Exempel: en modell ger Google Ads sökning utan varumärke en ROI på 3,0 och en mROI på 1,2, och Meta prospecting en ROI på 2,0 och en mROI på 1,9. Sökning har det bättre genomsnittet, men nästa 1 000 gör mer nytta på Meta. Det är nästa-krona-frågan, och därför leder rangordning av kanaler efter genomsnittlig ROI eller plattforms-ROAS till fel budgetfördelning.
Ändrar betald sökning den organiska trafiken?
De flesta MMM:er behandlar organisk sökning som en baslinje eller en kontroll och ignorerar en av de vanligaste budgetfrågorna: när du bjuder på en term, förlorar du organiska klick du ändå hade fått, eller lyfter annonserna din organiska synlighet? En marketing mix-modell kan uppskatta detta genom att göra organiska klick eller sessioner till utfallet och betalda kanaler till indata.
Svaret skiljer sig mellan konton och sökordstyper, och effekten kan gå åt båda hållen. Annonser på varumärkessökning kan ta klick som ditt första organiska resultat hade fått. Annonser utan varumärke kan öka medvetenheten som senare syns som organiska varumärkessökningar. Vi går igenom belägg och hur du testar det i ökar Google Ads den organiska trafiken?.
Två indata gör det mätbart: veckovis organisk trafik från Search Console, Bing Webmaster Tools eller GA4, och utgifter för betald sökning uppdelade efter kampanjtyp. En modell för betalt till organiskt ger en skattning med tecken: positivt betyder att annonserna tillför organiska klick, negativt betyder att de tar dem.
Vanliga MMM-misstag
De vanligaste misstagen kommer av att mata modellen med ofullständig data eller att läsa dess resultat som säkert. En modell kan inte skilja åt kanaler som alltid rör sig tillsammans, kan inte lära sig säsonger den sett en gång och behandlar saknade utgifter som noll utgifter. Kontrollera indata innan du litar på utdata.
- Saknade utgifter räknade som noll. Om en import missar tre månaders Meta-utgifter ser modellen tre månaders försäljning utan Meta och drar slutsatsen att Meta gjorde lite.
- Kanaler som alltid rör sig tillsammans. Om sök- och sociala budgetar stiger och sjunker i takt kan ingen modell skilja deras effekter. Variera en oberoende.
- För många små kanaler. Tolv kanaler med små budgetar ger tolv breda intervall. Gruppera dem.
- Att ignorera kampanjer och prisändringar. En reavecka som krediteras det som råkade köras den veckan blåser upp den kanalen.
- Att läsa ROI som vinst. Intäkts-ROI ignorerar marginaler, frakt och returer.
- Att agera på punktskattningar. Om en kanals intervall spänner över förlust och vinst är det ärliga utlåtandet “oklart”, inte en budgetförflyttning.
- Att aldrig validera. Utan ett lyfttest eller en holdout-prognoskontroll kan du inte skilja en bra modell från en självsäker.
Vem som bör använda MMM
Marketing mix modeling lönar sig när du spenderar betydande belopp på tre eller fler kanaler, dina utgifter har förändrats över tid och du har minst två års veckodata. Det är mindre användbart för ett varumärke med en eller två kanaler, platta budgetar eller mindre än sex månaders historik: där har modellen för lite att skilja åt.
Bra användningsfall:
- E-handelsvarumärken som annonserar i sök, sociala medier och minst en kanal till, som ChatGPT-annonser, LinkedIn, affiliates eller offlinemedia.
- Team vars plattformsrapporterade konverteringar summerar till mer än butikens verkliga ordrar.
- Varumärken som tappade synlighet i attributionen efter ändringar av samtycke och cookies.
- Alla som undrar om annonser på det egna varumärkesnamnet är värda det.
Dåliga användningsfall:
- En butik som lägger nästan allt på en plattform. Ett lyfttest på den plattformen besvarar mer.
- Varumärken med mindre än sex månaders historik, eller ett nyligen genomfört plattformsbyte som bröt spårningen.
- Team som vill ha svar på kampanj- eller annonsnivå dagligen. Det är attributionens jobb.
Vilken ska du välja?
Välj metod utifrån det beslut du fattar. Använd MMM för att fördela en budget mellan kanaler, attribution för att optimera inom en kanal dag för dag och ett inkrementalitetstest när du behöver bevis för att en kanal eller kampanj driver försäljning. De flesta varumärken som annonserar i flera kanaler slutar med att använda alla tre, var och en för sin fråga.
| Din situation | Börja med | Lägg till senare |
|---|---|---|
| Fördela nästa kvartals budget mellan 3+ kanaler | MMM | Lyfttest på den största kanalen |
| Optimera bud, målgrupper eller kreativ den här veckan | Attribution och plattformsdata | MMM för fördelningen mellan kanaler |
| Bevisa att en kanal orsakar försäljning innan du skalar upp | Inkrementalitetstest | MMM kalibrerad med resultatet |
| Mindre än ett års data, 2+ kanaler | Lyfttest, plus MMM läst som vägledande | Standard-MMM när du når 2–3 år |
| Annonsering i offlinemedia (TV, print, poddar) | MMM | Geo-holdout-test |
| Bud på ditt eget varumärkesnamn | MMM för betalt till organiskt eller ett varumärkespaustest | Genomgång av sökordsgap |
MMM-verktyg: öppen källkod och hostade
MMM-verktyg delas in i två grupper: gratis bibliotek med öppen källkod som du kör själv och hostade produkter som kör en modell åt dig. De tre stora alternativen med öppen källkod är Googles Meridian, Metas Robyn och PyMC-Marketing. De är gratis men kräver Python eller R, dataförberedelse och modellkontroller. Hostade verktyg byter en avgift mot uppsättning, kopplingar och ett användargränssnitt.
| Verktyg | Typ | Vad dess egen webbplats säger (per november 2026) |
|---|---|---|
| Google Meridian | Öppen källkod, Python | Bayesiansk MMM med stöd för geografinivå; släppt för alla den 29 januari 2025; en kodfri Scenario Planner följde i februari 2026 |
| Meta Robyn | Öppen källkod, R (Python-API i beta) | “Experimental” MMM-paket från Meta Marketing Science; ridge-regression med evolutionär hyperparametersökning; MIT-licens |
| PyMC-Marketing | Öppen källkod, Python | Bayesiansk MMM med adstock, mättnad, kalibrering med lyfttest och budgetoptimering; Apache 2.0 |
| Recast | Hostad | Proprietär bayesiansk MMM med GeoLift-experiment; inget offentligt pris |
| Cassandra | Hostad | MMM och inkrementalitetstester, inget datateam behövs; 30 dagars gratis provperiod |
| MarSci | Hostad | Kör Meridian eller Robyn på din data; kräver minst 1 000 € om dagen i marknadsföringsutgifter |
| MMM Pilot | Hostad | Kör Robyn utan kod; Starter-abonnemang 50 $/månad |
| AmICited | Hostad (vår produkt) | Kör Meridian; försäljningsmodeller och modeller för betalt till organiskt; abonnemangen Premium och Enterprise |
För en jämförelse sida vid sida av de två stora motorerna med öppen källkod, se Google Meridian vs Robyn.
MMM i AmICited
AmICited är vår produkt. Dess Media Marketing Mix (MMM) kör en bayesiansk modell på Google Meridian åt dig, utan kod. Du väljer ett utfall, till exempel butiksintäkt från Shopify eller WooCommerce, GA4-köp eller valfri GA4-konvertering, och kanaler från fem anslutna annonsplattformar plus egna kostnader för allt annat.
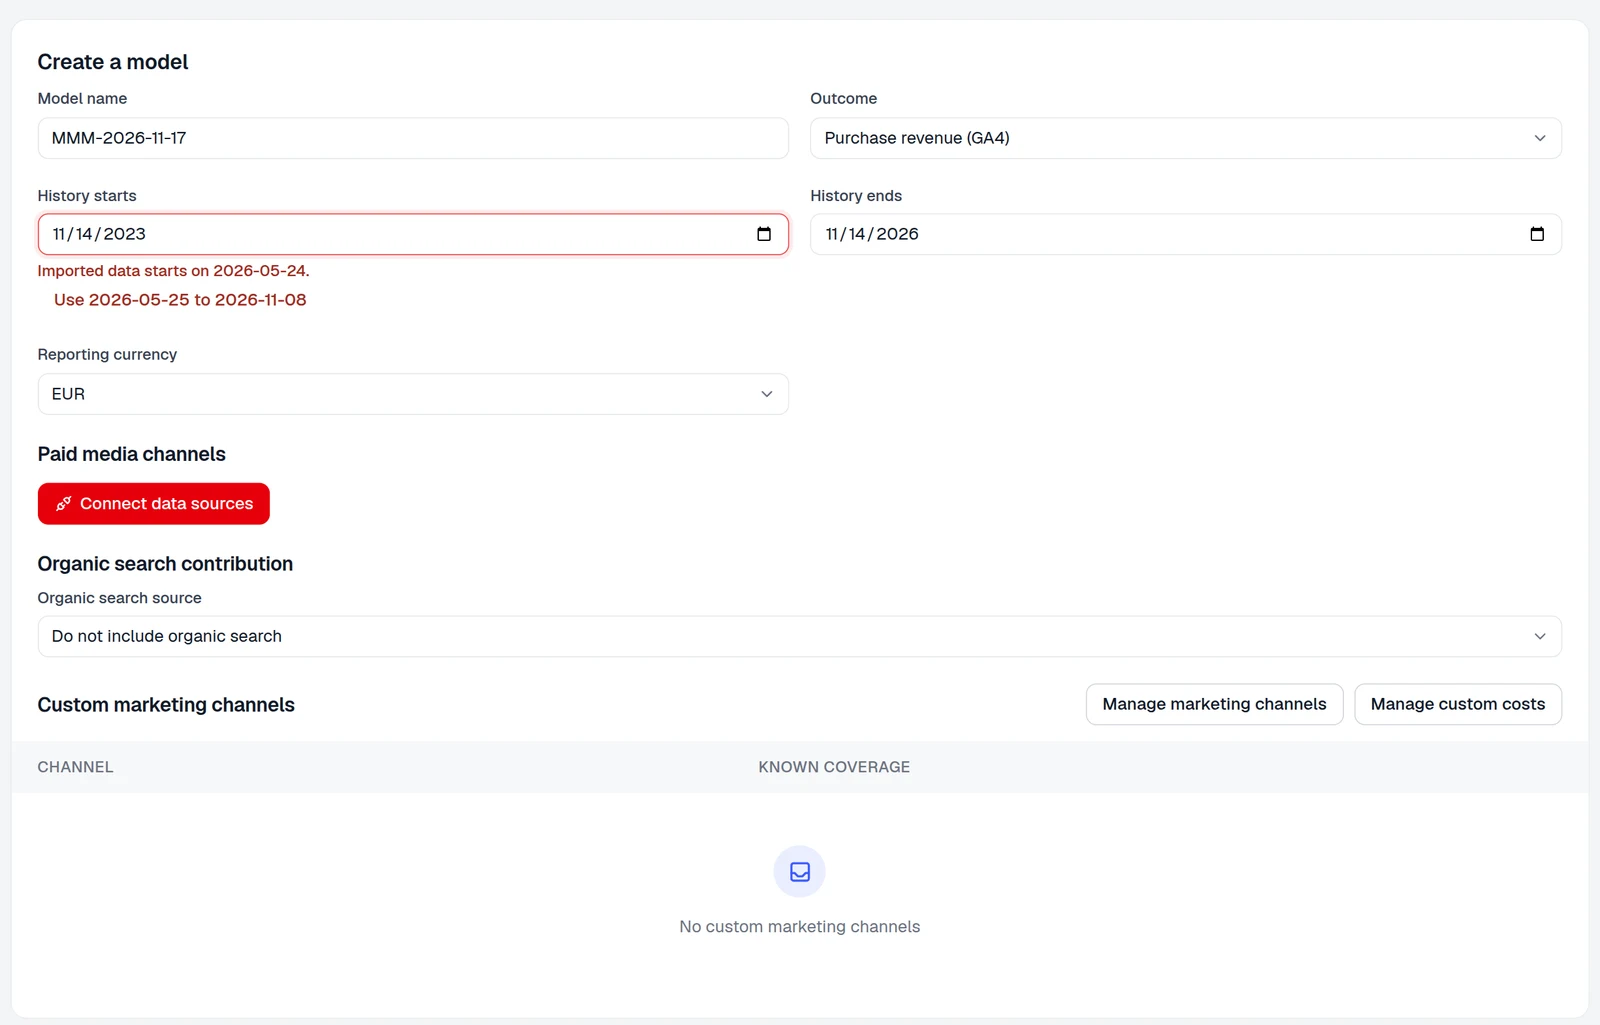
Det den tillför jämfört med att köra Meridian själv är uppsättningen och modellen för betalt till organiskt: ställ in utfallet på organisk trafik från Search Console, Bing eller GA4 så uppskattar den hur betald sökning förändrar organiska klick över tid. Utdata inkluderar bidrag med 90 % trovärdighetsintervall, responskurvor från noll till tre gånger nuvarande utgifter, var nästa 1 000 gör mest nytta och en bästa fördelning av nuvarande budget.
Begränsningarna är verkliga. Den finns bara i abonnemangen Premium och Enterprise, med en avgift för modellpaketet. En standardmodell behöver 164 kompletta veckor. Med 24 eller fler körs den i ett läge med begränsad historik vars rekommendationer märks som endast vägledande. ROI är intäkt, inte vinst. Och som all MMM skattar den utifrån historik. Den ersätter inte ett lyfttest.
Vad du gör nu
- Lista dina kanaler och din historik. Räkna veckorna med komplett utgifts- och utfallsdata för varje kanal. Under två år innebär vägledande resultat.
- Åtgärda indata först. Fyll utgiftsluckor, markera kampanjer och prisändringar och kontrollera att din butiksintäkt och din intäktsattribution stämmer överens om totalerna.
- Jämför plattformarnas påståenden med verkliga ordrar. Använd Meta Attribution Reality eller din egen butiksexport för att se hur mycket plattformssiffrorna avviker.
- Anpassa en första modell. Kör Meridian, Robyn eller PyMC-Marketing själv, eller ett hostat verktyg som vår Media Marketing Mix.
- Agera på mROI och intervall. Flytta budget bara där den marginella avkastningen tydligt är högre och intervallet inte spänner över noll.
- Testa det största vadet. Kör ett lyfttest eller en geo-holdout på din största kanal och kalibrera modellen med det.
- Kontrollera betalt mot organiskt. Gå igenom sökord du betalar för utan en organisk sida i Paid-Proven Gaps, och modellera om betald sökning lyfter eller ersätter organiska klick.
Slutsatsen
Marketing mix modeling är den enda av de tre huvudsakliga mätmetoderna som täcker alla kanaler på en gång utan att spåra användare. Den kräver två till tre års veckodata, varierade utgifter och ärliga indata, och den ger skattningar med intervall, inte fakta. Använd den för att fördela budgeten, använd lyfttest för att kontrollera den och läs avkastningen på nästa krona i stället för genomsnittet.
 LinkedIn