


SKU
SKU(库存量单位)是零售商为特定产品变体分配的唯一字母数字代码,用于在库存、销售和履约过程中进行跟踪。与 UPC 或条形码不同,SKU 是商家内部使用的编码,可以包含尺寸、颜色或仓库位置等属性。每种可销售的产品变体都有自己独立的 SKU。
SKU 的定义
SKU(库存量单位) 是企业创建的唯一标识符,用于在库存、订购和销售系统中跟踪特定的可销售产品版本。如果一款连帽衫有三种颜色和四种尺寸,那就有十二个 SKU,因为每种组合都需要独立计数、定价和再订购。SKU 不同于产品名称或商品列表——一款产品可以有许多 SKU,每个客户可以实际选择和购买的变体对应一个 SKU。SKU 是创建它的商家内部使用的编码,这使其区别于 UPC 和 EAN——后者是由外部机构(GS1)分配并在所有销售该产品的零售商之间共享的标准化代码。因此,零售商可以为其批发采购的产品创建自己的 SKU,在制造商的条形码之上叠加一个内部代码,以便自己的仓库和报告系统能够一致地跟踪该产品。
SKU 代码的结构
SKU 格式没有统一的标准,这既是其优势,也是常见的混乱来源。大多数商家会构建一个简短的字母数字字符串,编码对仓库和报告目的有意义的属性:类别、产品线、颜色和尺寸是常见的构建模块。一个典型的模式是 TSH-CREW-BLK-L,代表一件黑色大码圆领 T 恤,或者 MUG-CER-12OZ,代表一个 12 盎司的陶瓷杯。良好的 SKU 设计往往遵循几条规则:保持代码长度一致,便于视觉扫描和在电子表格中排序;避免使用可能破坏 CSV 导入或 URL 短横线的空格和特殊字符;使代码足够清晰易读,仓库拣货员不用查询就能直接从代码中识别出产品。有些企业转而使用平台自动生成的顺序数字 SKU(10001、10002…),用可读性换取绝对的唯一性。只要应用一致,任何一种方法都可行——失败模式通常是不一致性:一条产品线手工编码,另一条自动生成,两者之间没有任何共同逻辑。
为什么 SKU 级别的跟踪对电商很重要
SKU 的细粒度是库存管理得以实现的基础。在"产品"级别的汇总库存数量掩盖了一个变体已售罄而另一个变体库存过剩的事实——一家店铺可能显示"T 恤:有货",而实际畅销的尺寸已经缺货两周了。SKU 级别的跟踪也是再订购点计算的基础,因为同一件衬衫的中码和大码销售速度不同,需要不同的再订购触发点。除了库存之外,SKU 还是利润率分析的自然连接键:一旦某个 SKU 附加了落地成本(单位成本、进货运费、包装),每一笔订单明细项都可以追溯到真实成本,收入和盈利能力可以按照仓库管理库存的相同粒度进行报告。如果没有 SKU 级别的成本数据,盈利能力报告就只能退回到订单级别的平均值,这会模糊高利润和亏损产品之间的界限,掩盖哪些 SKU 实际上值得推广。
SKU vs. UPC vs. 产品 ID
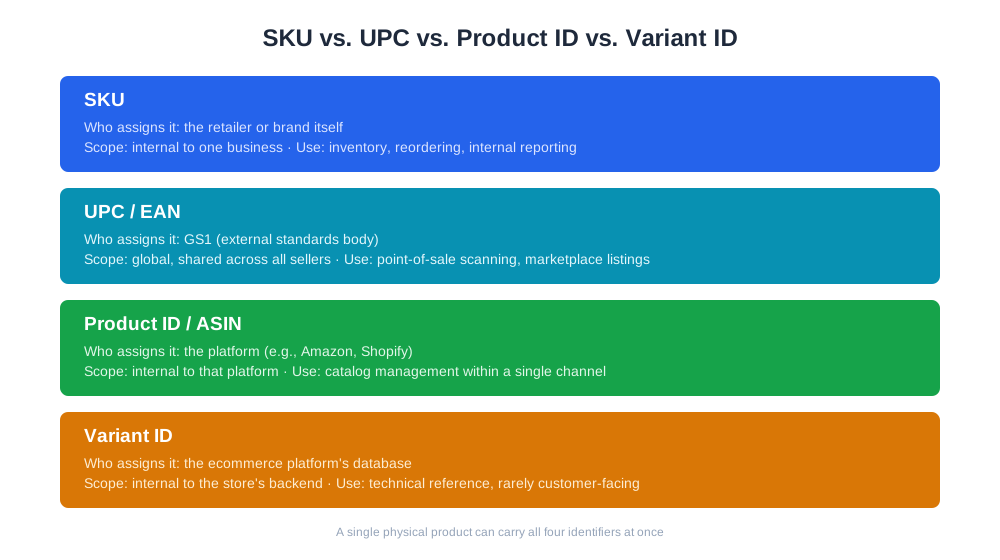
| 标识符 | 由谁分配 | 范围 | 典型用途 |
|---|---|---|---|
| SKU | 零售商或品牌自身 | 单一商家内部 | 库存、再订购、内部报告 |
| UPC / EAN | GS1(外部标准机构) | 全球范围,所有卖家共享 | 收银台扫描、市场平台列表 |
| 产品 ID / ASIN | 平台(如 Amazon、Shopify) | 该平台内部 | 单一渠道内的目录管理 |
| 变体 ID | 电商平台的数据库 | 店铺后台内部 | 技术参考,很少面向客户 |
同一件实体产品可以同时拥有这四种标识符:制造商分配的 UPC、零售商分配的 SKU、市场平台分配的 ASIN 以及平台分配的变体 ID。多渠道卖家通常需要一个映射表来协调这些标识符,以便在 Amazon 上的一笔销售和通过 Shopify 店铺前端的一笔销售都能汇总到同一个底层 SKU 进行报告。

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
SKU 数据与 AI 驱动的电商
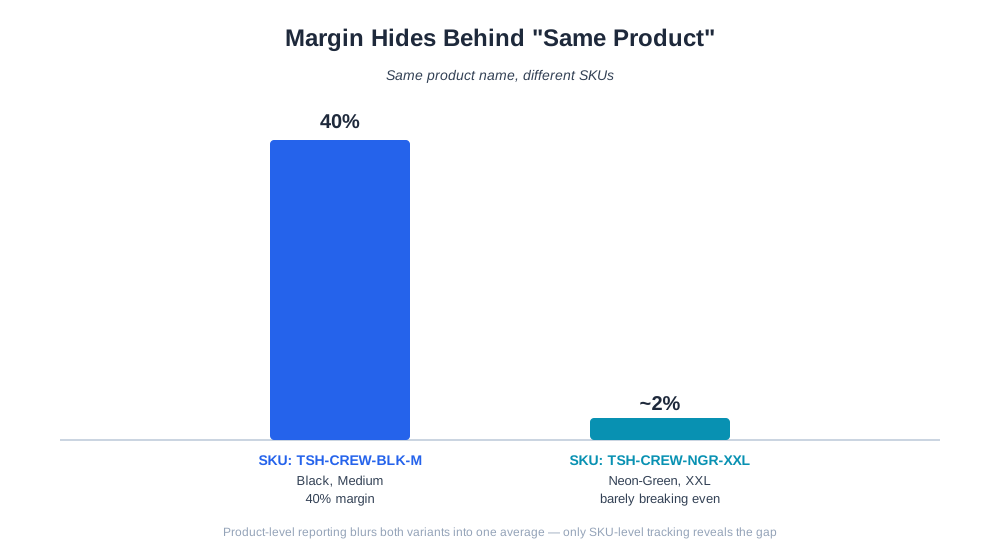
随着购物越来越多地通过 ChatGPT Shopping、Perplexity Shopping 和 Amazon 的 Rufus 等 AI 助手进行,产品数据源——告知这些系统库存、价格和变体信息的结构化数据——依赖于底层清晰的 SKU 级别数据。AI 购物助手推荐"蓝色的中号"时,需要底层数据源将其解析为具有真实库存和价格的实际 SKU,而不是通用的产品列表。混乱或重复的 SKU 是产品数据源在这些渠道中被拒绝或被错误呈现的常见原因。在分析方面,像 AmICited 的 eshop_get_products 和 eshop_list_product_costs 报告这样的工具之所以按照 SKU 粒度工作,正是因为在这个级别上盈利能力问题才能得到真正回答——“这款产品的哪个变体我应该继续进货"是一个 SKU 级别的问题,而不是产品名称级别的问题。按 SKU(而非产品标题)报告收入和利润率,让商家能够看到黑色中码以 40% 的利润率销售,而荧光绿 XXL 码尽管是"同一产品”,却几乎不赚钱。
SKU 管理的最佳实践
- 在跨多个渠道上架之前,为每个变体建立一个规范的 SKU,并将每个渠道特定的 ID 映射回它
- 保持 SKU 代码简短、长度一致,且不含空格或特殊字符
- 为每个 SKU 附加落地成本而不仅仅是零售价格,以便自动计算利润率
- 避免将已停用的 SKU 重新用于新的、不相关的产品——历史报告会混淆两者
- 定期审计是否存在重复或近似重复的 SKU(通常是手动编辑电子表格的结果)
- 在每次导出——订单、退货和成本表——中都包含 SKU,以便数据集始终可以关联在一起
常见的 SKU 错误
一个常见的问题是在报告中将"产品"和"SKU"视为可互换,这样产生的库存数量和利润率数据在总体上看没问题,但却用一个表现良好的变体掩盖了另一个表现不佳的变体。解决办法是确保每份报告——销售、库存、成本——都在 SKU 级别生成,只有在显示时为了方便才汇总到产品级别,而不是作为底层计算。另一个常见的问题是跨销售渠道的 SKU 漂移:商家在其 POS 系统中创建了一套 SKU 方案,电商平台自动生成了另一套,而市场平台列表上出现了第三种格式,导致没有可靠的方法来核对某个变体的总销售额,除非手动匹配。标准的解决方案是集中维护一个映射表,理想情况下放在执行报告的平台上,而不是每次在电子表格中临时重建。第三个错误是在产品停产和替换时重复使用 SKU——给予旧 SKU 的新配方或重新设计会混淆历史趋势数据,使其看起来像是同一款产品突然改变了性能,而不是显示清晰的前后对比。最后,许多较小的商家跳过为每个 SKU 附加真实落地成本的步骤,而是默认在整个目录中使用一个统一的估计利润率;这使得 SKU 级别的盈利能力报告技术上可行但实际上具有误导性,因为它无法揭示表现最佳和最差变体之间的真实差距。