


Analisi del Sentimento
L'analisi del sentimento utilizza l'IA e la NLP per rilevare il tono emotivo nei dati testuali. Scopri come funziona, le sue applicazioni nel monitoraggio del m...
12 min di lettura
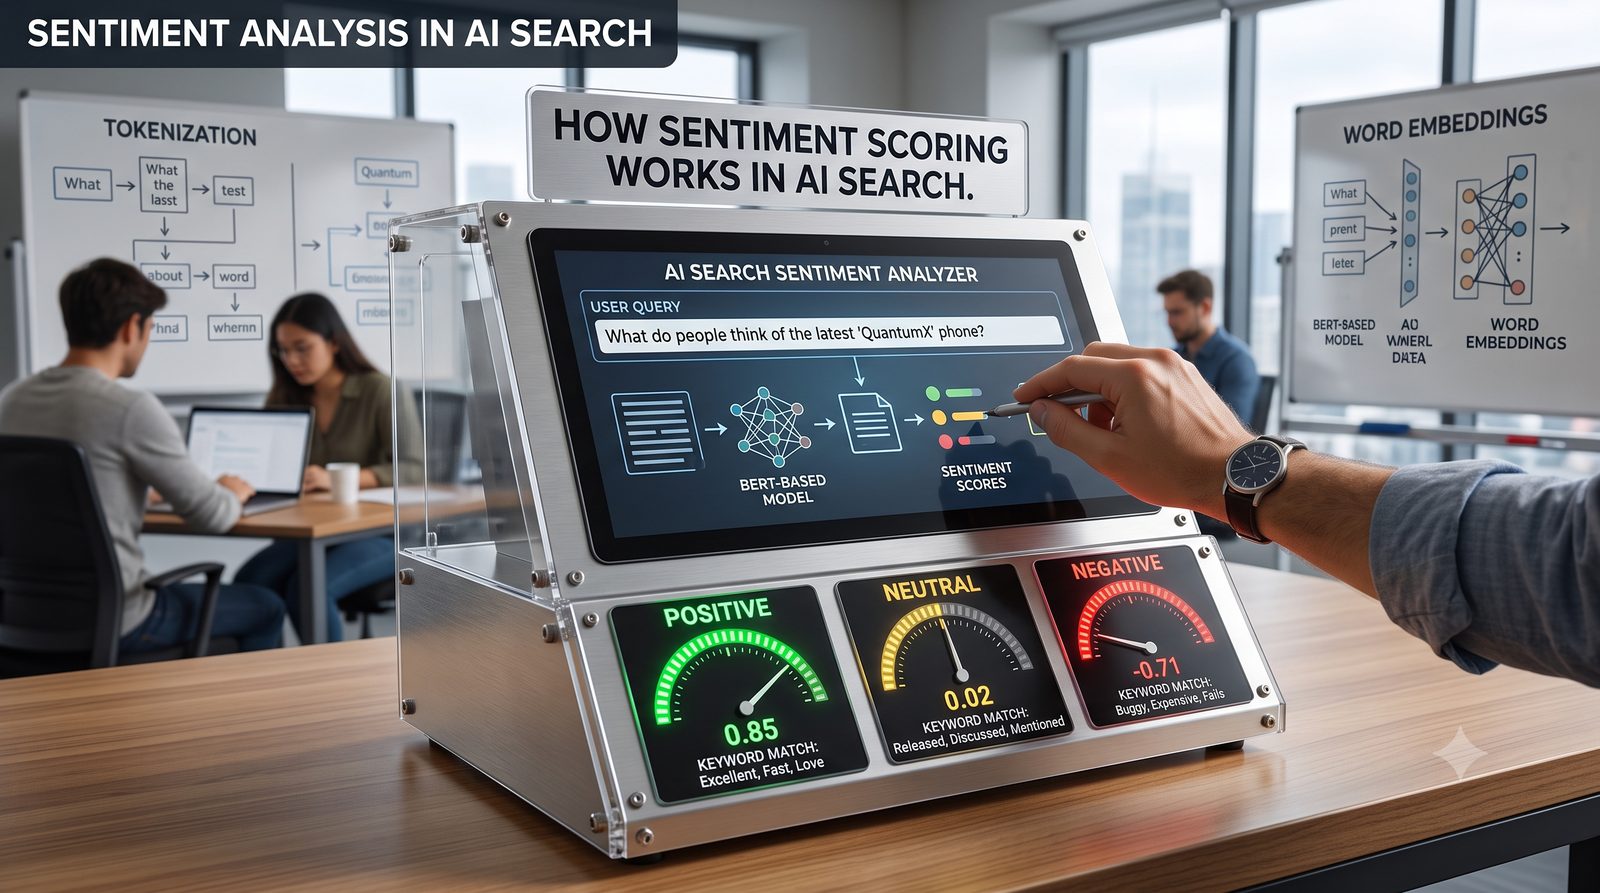
Un’analisi tecnica di come funzionano gli algoritmi di sentiment scoring: il processo in quattro fasi, i tre metodi di scoring, la scala da -1 a +1 e dove la matematica siinceppa.
Quando chiedi a ChatGPT, Perplexity o Gemini informazioni sulla tua categoria di prodotto, questi motori AI non decidono solo se menzionare il tuo brand. Decidono come posizionare il tuo brand nella risposta. Un concorrente viene descritto come “la soluzione leader con funzionalità robuste”, mentre un altro viene presentato come “un’alternativa da prendere in considerazione”. Questa differenza è determinata dal sentiment scoring: il processo algoritmico che trasforma una frase in un valore positivo, negativo o neutro.
Questa guida è un’analisi approfondita della metodologia. Presuppone che tu sappia già cos’è il sentiment AI del brand e perché è importante — qui apriamo il cofano e osserviamo esattamente come un modello passa dal testo grezzo a un numero.
Il sentiment scoring è il processo di analisi del testo e di assegnazione di un valore numerico o categorico che ne rappresenta il tono emotivo. L’obiettivo è classificare se un contenuto esprime un sentiment positivo, negativo o neutro riguardo a un argomento, prodotto, brand o idea.
Alla base, il sentiment scoring risponde a una domanda semplice: Questo testo è favorevole, sfavorevole o neutro?
Le tre categorie di sentiment sono:
Il sentiment scoring viene applicato a un’ampia gamma di fonti di dati: recensioni dei clienti, post sui social media, risposte e riepiloghi generati dall’AI, articoli di notizie, ticket di supporto e descrizioni di prodotti.
L’output del sentiment scoring è tipicamente un’etichetta di sentiment (positivo/negativo/neutro) associata a un punteggio di confidenza (0–1 o –1 a +1) che indica quanto il modello è certo di quella classificazione.
La sentiment analysis tradizionale si concentra sulla comprensione del feedback generato dagli esseri umani: analisi delle recensioni dei clienti, monitoraggio delle conversazioni sui social media o elaborazione delle risposte ai sondaggi. L’input è testo scritto da persone e l’obiettivo è valutare ciò che hanno detto — un obiettivo di scoring fondamentalmente diverso da quello che segue.
Il sentiment scoring nella ricerca AI valuta un input completamente diverso: come i modelli AI stessi descrivono il tuo brand o prodotto nelle risposte generate. Quando Perplexity genera una risposta a “Qual è il miglior software CRM?”, il sentiment scoring misura se quella risposta parla favorevolmente o criticamente di ciascuna opzione CRM menzionata — il testo valutato è generato dalla macchina, non scritto da un umano.
Meccanicamente, la matematica di classificazione è la stessa indipendentemente dal fatto che il testo di partenza provenga da una persona o da un modello. Ciò che cambia è il pipeline di input: il sentiment scoring per la ricerca AI deve prima estrarre la frase o il periodo che si riferisce al tuo brand da una risposta generata più lunga, quindi valutare quell’estratto secondo gli stessi criteri di qualità dei contenuti e tono che uno scorer applicherebbe a qualsiasi altro testo.

Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Comprendere il meccanismo del sentiment scoring è fondamentale per capire perché è efficace e dove incontra i suoi limiti. Il processo prevede quattro fasi principali: acquisizione del testo, estrazione delle caratteristiche, classificazione e aggregazione.
Il primo passo consiste nel raccogliere il testo grezzo e prepararlo per l’analisi. Può trattarsi di una recensione cliente, una risposta generata dall’AI, un post sui social media o un articolo di notizie.
Il testo grezzo è disordinato. Contiene incongruenze nelle maiuscole, punteggiatura e caratteri speciali, parole di riempimento che non portano significato e variazioni della stessa parola (es. “correndo,” “corre,” “corso”). La pre-elaborazione pulisce e normalizza questo testo in modo che il modello di sentiment possa analizzarlo efficacemente.
Il pipeline di pre-elaborazione include tipicamente:
Esempio: La recensione “Questo prodotto è assolutamente fantastico!” viene pre-elaborata come:
Ora il testo è in una forma standardizzata che il modello di sentiment può elaborare.
Dopo la pre-elaborazione, il testo deve essere convertito in un formato numerico comprensibile dai modelli di machine learning e deep learning. Questo si chiama estrazione delle caratteristiche: trasformare il testo in vettori numerici (array di numeri).
Esistono diversi metodi di estrazione delle caratteristiche, ciascuno con i propri compromessi:
Bag of Words (BoW) e TF-IDF:
Word Embeddings (Word2Vec, GloVe):
Embedding Contestuali (BERT, RoBERTa, GPT):
Esempio: La frase “Questo prodotto è assolutamente fantastico!” potrebbe essere rappresentata come:
Con il testo rappresentato come caratteristiche numeriche, il modello di sentiment lo classifica in una delle tre categorie di sentiment e produce un punteggio. Questo passaggio dipende dall’approccio utilizzato — consulta il confronto completo dei tre approcci di seguito.
L’output è tipicamente un’etichetta di sentiment e un punteggio di confidenza. Ad esempio:
Alcuni sistemi restituiscono un punteggio continuo su una scala (es. –1 a +1, dove –1 = molto negativo, 0 = neutro, +1 = molto positivo):
I punteggi di sentiment individuali vengono raramente analizzati in isolamento. Vengono invece aggregati per comprendere pattern più ampi.
Metodi di aggregazione:
L’analisi delle tendenze monitora come il punteggio aggregato cambia nel tempo:
| Mese | NSS | Interpretazione |
|---|---|---|
| 1 | +45 | Per lo più positivo |
| 2 | +38 | Ancora positivo, ma in calo |
| 3 | +22 | Positivo ma indebolito |
Matematicamente, questo declino è un campanello d’allarme indipendentemente dal motivo — il livello di aggregazione non sa né gli interessa se la causa sia una crisi di PR o un aggiornamento dei dati di training. Si limita a segnalare la tendenza.
Il sentiment scoring può essere implementato in tre modi fondamentalmente diversi, ciascuno con distinti compromessi tra velocità, accuratezza, interpretabilità e costo.
Come funziona: Il sentiment scoring basato su lessico utilizza dizionari predefiniti di parole etichettate come positive, negative o neutre. L’algoritmo scansiona il testo alla ricerca di queste parole e assegna il sentiment in base alle corrispondenze, valutando anche intensificatori (es. “molto,” “assolutamente”) e negazioni (es. “non,” “no”).
Esempio di scoring:
Pro: Veloce e leggero (nessun machine learning richiesto), interpretabile e trasparente (puoi vedere perché ha assegnato un punteggio), nessun dato di training necessario, funziona bene per sentiment semplici e diretti.
Contro: Perde contesto e sfumature (“Adoro come questo prodotto non funzioni” è sarcasmo, ma il lessico vede “amore”). Non gestisce il linguaggio specifico del dominio — nelle categorie economiche, “economico” è positivo; nel lusso, è negativo. Fatica con frasi complesse dal sentiment misto e richiede manutenzione manuale del dizionario.
Ideale per: Analisi rapida del sentiment di testi semplici dove la velocità è più importante dell’accuratezza perfetta.
Come funziona: I modelli di machine learning vengono addestrati su esempi etichettati di testo (positivo, negativo, neutro) e imparano a riconoscere pattern che indicano il sentiment. Gli algoritmi comuni includono Naïve Bayes (probabilistico, assume indipendenza delle parole), Support Vector Machines (trova i confini decisionali ottimali tra le classi di sentiment) e Regressione Logistica (prevede la probabilità di ciascuna classe).
Il processo di addestramento: raccogli migliaia di esempi etichettati, estrai le caratteristiche (TF-IDF o word embedding), addestra il modello ad apprendere la relazione tra caratteristiche ed etichette, poi testa su dati non visti per valutare l’accuratezza. Una volta addestrato, il modello classifica nuovo testo mai visto prima.
Pro: Migliore consapevolezza del contesto rispetto ai metodi basati su lessico, apprende automaticamente i pattern (nessuna manutenzione manuale del dizionario), tipicamente 80–90% di accuratezza sui dataset di benchmark, può essere ottimizzato per domini specifici.
Contro: Richiede dati di training etichettati (costosi da creare), meno interpretabile dei metodi basati su regole, può perpetuare distorsioni presenti nei dati di training, le prestazioni degradano su testi fuori dominio.
Ideale per: Sistemi di produzione dove l’accuratezza è importante e sono disponibili dati di training etichettati.
Come funziona: I modelli di deep learning utilizzano reti neurali per apprendere pattern complessi e non lineari nel testo. L’approccio più potente attuale utilizza i transformer, un’architettura neurale che eccelle nella comprensione del linguaggio — i modelli più popolari includono BERT, RoBERTa e classificatori basati su GPT.
Questi modelli comprendono il contesto (la stessa parola significa cose diverse in frasi diverse), le dipendenze a lungo raggio, il significato semantico e — aspetto critico — il sarcasmo e le sfumature. BERT può distinguere “Questo prodotto è fantastico!” (positivo) da “Adoro come questo prodotto non funzioni.” (sarcastico negativo) da “Il prodotto è blu e il servizio clienti è terribile.” (misto, sentiment basato sugli aspetti).
Pro: Accuratezza allo stato dell’arte (94–96% sui dataset di benchmark), comprende sfumature e sarcasmo, modelli pre-addestrati disponibili (nessuna necessità di addestrare da zero), funziona in più lingue e domini.
Contro: Costoso dal punto di vista computazionale (richiede GPU/TPU), inferenza più lenta rispetto ai modelli basati su regole o ML semplici, meno interpretabile (“scatola nera”), può ancora commettere errori sui casi limite.
Ideale per: Applicazioni ad alto rischio dove l’accuratezza è critica e le risorse computazionali sono disponibili — è ciò su cui si basa oggi la maggior parte del sentiment scoring per la ricerca AI e il monitoraggio della reputazione del brand.
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
I punteggi di sentiment vengono rappresentati su scale diverse a seconda del sistema. Comprendere queste scale è importante per interpretare i risultati.
| Scala | Intervallo | Interpretazione |
|---|---|---|
| Punteggio di Polarità | –1 a +1 | –1 = molto negativo; 0 = neutro; +1 = molto positivo |
| Punteggio di Probabilità | 0 a 1 | 0 = molto negativo; 0.5 = neutro; 1 = molto positivo |
| Punteggio di Confidenza | 0 a 1 | Confidenza nella classificazione (0 = incerto; 1 = certo) |
| Percentuale | 0% a 100% | Percentuale di sentiment positivo (0% = tutto negativo; 100% = tutto positivo) |
Interpretazioni di esempio: +0.85 = forte positivo; +0.45 = debolmente positivo o tendente al neutro; 0.02 = quasi neutro; –0.60 = moderatamente negativo; –0.95 = molto fortemente negativo.
Lo scoring categorico assegna un’etichetta discreta (Positivo/Negativo/Neutro) — semplice e interpretabile ma perde le sfumature. Lo scoring continuo assegna un valore numerico su una scala, consentendo una gradazione fine, più utile per l’analisi delle tendenze e l’aggregazione. L’approccio ibrido (il più utile nella pratica) assegna sia un’etichetta che un punteggio di confidenza, ad es.: “Il prodotto è ok.” → Etichetta: Neutro, Confidenza: 0.72. Un punteggio di confidenza basso (es. 0.55) segnala un sentiment ambiguo o misto che potrebbe richiedere una revisione umana.
Oltre al semplice positivo/negativo, i sistemi avanzati integrano il rilevamento delle emozioni (gioia, rabbia, frustrazione, delusione), il sentiment basato sugli aspetti (valutazione di aspetti specifici separatamente — “Le funzionalità sono eccellenti, ma il prezzo è troppo alto” produce funzionalità = +0.85, prezzo = –0.70, complessivo = misto) e lo scoring dell’intensità (quanto è forte il sentiment: “Mi piace” vs. “Mi piace molto”). Lo scoring basato sugli aspetti in particolare è più actionable di un singolo punteggio complessivo perché indica cosa sta guidando il numero, non solo il suo segno.
Il sentiment scoring è sempre più integrato nel modo in cui i motori di ricerca AI valutano e classificano le fonti. Meccanicamente, funziona in tre passaggi:
Il sentiment non agisce da solo nel ranking. Si combina con E-E-A-T (Esperienza, Competenza, Autorevolezza, Affidabilità), freschezza, metriche di engagement e autorevolezza tematica per formare un quadro di ranking completo. Una versione semplificata della formula combinata è:
Punteggio di Ranking Finale = (Sentiment × 0.20) + (E-E-A-T × 0.30) + (Freschezza × 0.15) + (Engagement × 0.20) + (Autorevolezza × 0.15)
L’implicazione pratica di questa formula: un sentiment elevato da fonti a bassa autorevolezza si classifica comunque più in basso rispetto a un punteggio di sentiment più basso da fonti autorevoli con credenziali solide, e una fonte altamente autorevole con sentiment negativo potrebbe comunque classificarsi ma con cautele allegate. La ponderazione è anche il motivo per cui il sentiment scoring determina quanto favorevolmente una fonte viene presentata più di quanto determini da solo se viene citata — il modello deve decidere quanto favorevolmente presentare ciascuna fonte candidata, non solo se includerla.
Per rendere la matematica concreta, ecco come viene calcolato un Net Sentiment Score a partire dai conteggi grezzi delle menzioni. Supponiamo che un’azienda di software valuti come tre piattaforme CRM concorrenti vengono descritte in 100 risposte di ChatGPT alla domanda “Qual è il miglior CRM per le piccole imprese?”:
| CRM | Positivo | Neutro | Negativo | NSS = (Pos − Neg) / Totale × 100 |
|---|---|---|---|---|
| CRM A | 45 | 30 | 10 | (45−10)/85 × 100 = +41 |
| CRM B | 25 | 50 | 15 | (25−15)/90 × 100 = +11 |
| CRM C | 35 | 40 | 20 | (35−20)/95 × 100 = +16 |
Nota che l’NSS esclude la categoria neutra dal denominatore per convenzione in alcune implementazioni, e la include in altre — questo è esattamente il tipo di dettaglio metodologico che rende due numeri NSS provenienti da strumenti diversi non confrontabili a meno che non si conosca la formula sottostante. Il volume più elevato di menzioni positive e il volume inferiore di menzioni negative del CRM A spingono il suo punteggio ben al di sopra degli altri due, il che si tradurrebbe nel linguaggio di risposta di ChatGPT (“la soluzione leader” vs. “un’alternativa da prendere in considerazione”).
Il sentiment scoring è potente, ma non è perfetto. Cinque limiti si manifestano in tutti e tre i metodi, in misura decrescente ma mai nulla:
Tre considerazioni determinano quale dei tre metodi (lessico, ML, deep learning) sia quello giusto per un dato sistema: velocità (elaborazione in tempo reale vs. batch), requisiti di accuratezza (piacevole da avere vs. critico per il business) e risorse disponibili (un lessico non ne richiede nessuna; il deep learning necessita di capacità GPU/TPU e, idealmente, dati di ottimizzazione specifici del dominio).
Qualunque sia il metodo scelto, la coerenza nel tempo è ciò che rende validi i confronti di tendenza. Cambiare modelli, strumenti o prompt a metà analisi rompe la comparabilità dei numeri prima/dopo — “il sentiment è migliorato di 20 punti” è privo di significato se il metodo di misurazione è cambiato insieme ad esso. Questo è un vincolo puramente matematico, non una raccomandazione di processo: un NSS calcolato con il metodo A e un NSS calcolato con il metodo B non sono la stessa unità, anche se condividono la stessa scala.
Il sentiment scoring è anche un segnale, non una verità assoluta. Il ciclo di validazione standard consiste nel campionare un insieme di esempi valutati, far classificare lo stesso insieme da un essere umano in modo indipendente e misurare la concordanza. Se la concordanza è inferiore a circa l'85%, è probabile che il modello o la sua fase di estrazione delle caratteristiche debbano essere rivisti per quel dominio specifico.
Il sentiment scoring è un meccanismo fondamentale nel modo in cui i motori di ricerca AI, gli algoritmi di ricerca tradizionali e i sistemi di analisi dei contenuti valutano e classificano le informazioni. Capire come funziona — dalla pre-elaborazione del testo all’estrazione delle caratteristiche, alla classificazione, all’aggregazione — spiega perché due strumenti diversi possono riportare numeri diversi per le stesse menzioni del brand e perché un’etichetta di sentiment grezza è meno utile del punteggio, della confidenza e della metodologia che ci sono dietro.
I tre metodi principali (basato su lessico, machine learning e deep learning) bilanciano velocità, costo e interpretabilità con l’accuratezza. Le sfide — sarcasmo, linguaggio specifico del dominio, negazioni, sentiment misto e distorsione del modello — si applicano a tutti e tre, in misura decrescente ma mai nulla.
Se stai cercando il quadro generale sul perché il sentiment AI sia importante per la visibilità di un brand nella ricerca AI, inizia con cos’è il sentiment AI del brand e perché è importante . Se vuoi mettere in pratica questa metodologia con un processo di monitoraggio concreto, consulta la guida passo passo al monitoraggio del sentiment . E se stai valutando se valutare il sentiment manualmente, acquistare una piattaforma o costruire il tuo pipeline, consulta come scegliere uno strumento di monitoraggio del sentiment AI .
Arshia è AI Workflow Engineer presso FlowHunt. Con una formazione in informatica e una passione per l'IA, è specializzato nella creazione di flussi di lavoro efficienti che integrano strumenti di IA nelle attività quotidiane, migliorando produttività e creatività.
Am I Cited applica il sentiment scoring a ogni menzione del tuo brand in ChatGPT, Perplexity e Google AI Overviews, fornendoti non solo il testo grezzo ma anche l'etichetta e il punteggio.
L'analisi del sentimento utilizza l'IA e la NLP per rilevare il tono emotivo nei dati testuali. Scopri come funziona, le sue applicazioni nel monitoraggio del m...
Scopri come il sentimento negativo influisce sulle citazioni AI e sulla reputazione del brand nella ricerca generativa. Comprendi il drift del sentimento, le an...
Scopri cos'è il Differenziale di Sentimento AI e perché è importante per la reputazione del brand. Scopri come misurare e monitorare la differenza tra il sentim...
Consenso Cookie
Usiamo i cookie per migliorare la tua esperienza di navigazione e analizzare il nostro traffico. See our privacy policy.