


Amazon Rufus
Lär dig om Amazon Rufus, AI-shoppingassistenten som svarar på produktfrågor, jämför artiklar och ger personliga rekommendationer. Upptäck hur den fungerar och f...
3 min läsning
Förstå vad Amazon Rufus egentligen är, hur dess RAG-baserade arkitektur fungerar och hur den skiljer sig från Amazons traditionella A9-sökning. En mekanik-först-förklaring för säljare och marknadsförare.
Amazon Rufus är en AI-shoppingassistent som låter kunder ställa naturliga frågor om produkter och få konversationsbaserade svar istället för en rankad resultatsida. Sedan lanseringen har över 250 miljoner kunder använt Rufus, och den driver nu cirka 13,7 % av Amazons sökningar, med månatliga aktiva användare upp 149 % och interaktioner som ökat 210 % år över år. Kunder som använder Rufus är 60 % mer benägna att göra ett köp än de som enbart förlitar sig på den vanliga sökrutan. Den här guiden är en mekanik-först-förklaring: vad Rufus egentligen är, hur den är uppbyggd och hur den skiljer sig från den sökordsbaserade sökning som Amazon har drivit i två decennier. Om du är säljare och letar efter en steg-för-steg-checklista istället — vad du faktiskt ska ändra i en listning och i vilken ordning — hoppa vidare till den taktiska sektionen nedan.
Rufus körs på Retrieval-Augmented Generation (RAG): istället för att svara enbart från vad en språkmodell memorerade under träning, hämtar den aktuell, specifik produktinformation — listningar, recensioner, frågor och svar, A+-innehåll — och matar in det i en modell för att generera sitt svar. Detta retrieversteg är vad som låter Rufus svara på frågor om produkter och attribut som inte fanns när dess underliggande modell senast tränades. Amazon byggde Rufus på Amazon Bedrock, och kombinerar Claude Sonnet, Amazon Nova och proprietära Amazon-modeller, som körs genom en kontinuerlig batch- och strömningsarkitektur som håller svarstiderna låga även under hög trafik. AI-assistenten inkorporerar också en realtidsåterkopplingsslinga, så dess utdata förändras när den observerar vilka rekommendationer kunder faktiskt engagerar sig i. Inget av detta ändrar vad en säljare skickar till Amazon — listningsfälten är desamma som alltid har funnits — men det ändrar hur den informationen används: istället för att indexeras och rankas, hämtas den och syntetiseras till ett konversationssvar.
| Aspekt | A9 (Traditionell sökning) | Rufus AI-assistent |
|---|---|---|
| Frågetyp | Sökordsbaserad | Konversationsbaserad, naturligt språk |
| Datakällor | Titlar, punkter, backend-sökord | Beskrivningar, recensioner, frågor och svar, A+-innehåll, köphistorik |
| Svarsformat | Rankad lista med produktlistningar | Konversationssvar med motivering |
| Personalisering | Begränsad till surfhistorik | Shoppingminne över köp, surfning, recensioner |
| Kontextförståelse | Ordagrann sökordsmatchning | Semantisk förståelse av avsikt |
| Inlärning | Statisk rankningsalgoritm | Kontinuerlig realtidsåterkoppling |
A9 och Rufus är inte konkurrerande system — de är kompletterande lager som Amazon kör sida vid sida. A9 hanterar fortfarande merparten av söktrafiken: den avgör vad som visas när en kund skriver sökord i sökrutan, och väger signaler som sökordsrelevans, konverteringsgrad och pris. Rufus hanterar konversationslagret ovanpå det: frågor, jämförelser och rekommendationer som inte passar snyggt in i en enskild sökordsfråga. För närvarande involverar färre än 3 av 100 Amazonsköp Rufus, så A9 är fortfarande den dominerande upptäcktsmekanismen för tillfället — men de två systemen drar från samma underliggande produktdata, vilket är anledningen till att förbättring av listningskvalitet tenderar att hjälpa båda samtidigt snarare än att tvinga fram en avvägning mellan dem.
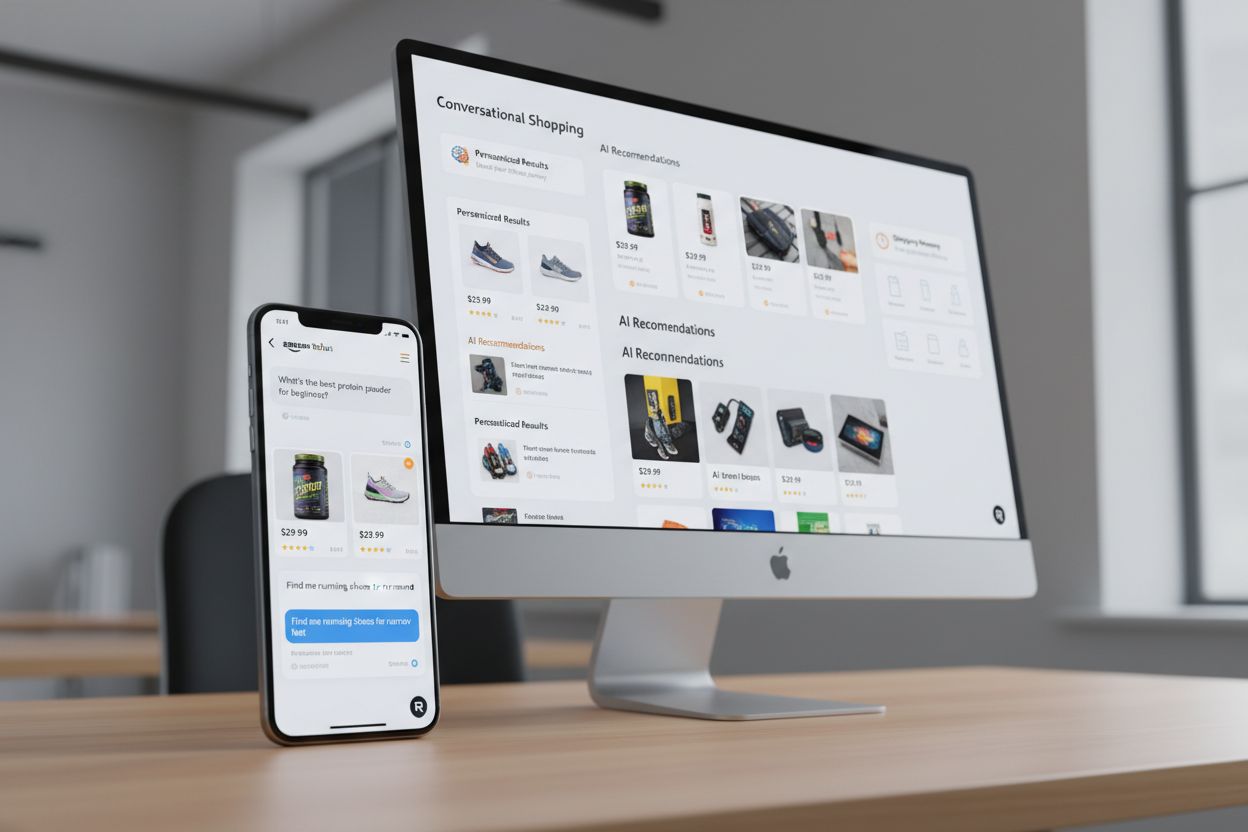
Det tydligaste beviset på detta skifte finns i själva frågebeteendet. Där en kund tidigare sökte efter “proteinpulver” frågar de nu Rufus något i stil med “vad är det bästa proteinpulvret för nybörjare på budget som vill undvika artificiella sötningsmedel?” Det är inte ett sökord med modifierare — det är en sammansatt fråga med ett implicit budgetbegränsning, en erfarenhetsnivå och ett ingrediensundantag, allt i en mening. A9:s rankningsmodell byggdes för att matcha sökord, inte för att tolka sammansatt avsikt, vilket är precis det gap som Rufus är designad för att fylla. Eftersom Rufus resonerar över naturligt språk snarare än att tokenisera en söksträng, kan den visa en produkt som aldrig bokstavligen innehåller frasen “proteinpulver för nybörjare” någonstans i sin listning, så länge de underliggande attributen matchar vad kunden beskrev. Detta är den strukturella anledningen till att produktinnehållets djup nu spelar större roll än enbart sökordsplacering, en distinktion som den taktiska sektionen nedan omvandlar till konkreta listningsförändringar.

Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Rufus retrieverlager hämtar från fem kategorier av listningsdata: produktbeskrivningen och punkterna, A+-innehåll, kundrecensioner, frågor-och-svar-sektionen och produktbilder. Var och en bidrar olika. Produktbeskrivningar och punkter levererar basfakta. A+-innehåll levererar narrativ och livsstilskontext som rena specifikationer inte kan. Recensioner och frågor och svar levererar de delar som ingen säljare skriver — verkligt kundspråk om hållbarhet, passform och gränsfall — vilket är precis den typ av information som AI-assistenten är bäst på att hämta, eftersom den inte skrevs för att vara söknoptimerad från början. Produktbilder bearbetas för både komposition och inbäddad text, så ett diagram, en storleksguide eller en textruta inbäddad i en bild är läsbar för Rufus på samma sätt som den är läsbar för en shoppare. Ingen av dessa källor fungerar isolerat: Rufus förtroende för en rekommendation tenderar att följa hur konsekvent dessa fem källor överensstämmer med varandra, vilket är anledningen till att motsägelser mellan dina punkter och dina recensioner är mer kostsamma under Rufus än de någonsin var under A9:s sökordsmatchning.
Införandet av shoppingminne representerar ett paradigmskifte i hur Rufus personaliserar rekommendationer, och går bortom sessionsbaserad personalisering till en beständig förståelse av varje kunds shoppingprofil. Rufus kommer nu ihåg köphistorik, surfmönster, recensioner som kunder har lämnat, sökhistorik och övergivna varukorgsartiklar, vilket skapar en rik kontextuell grund för varje rekommendation. Detta innebär att en kund som tidigare har köpt premiumträningsutrustning och lämnat detaljerade recensioner om hållbarhet kommer att få andra produktrekommendationer än en budgetmedveten kund som surfar i samma kategori. En produkt som nära matchar en kunds tidigare köp och angivna preferenser kommer att få förmånlig synlighet i Rufus rekommendationer, även om en konkurrerande produkt har ett högre totalbetyg. Detta personaliseringslager sträcker sig över Amazons tjänster — Rufus kan hämta data från Prime Video-visningshistorik, Alexa-interaktioner och andra beröringspunkter i Amazons ekosystem för att informera rekommendationer. Praktiskt innebär detta att produktdata inte kan rikta in sig på en individuell kunds minnesprofil direkt; det enda verktyg en säljare har är att göra den underliggande listningen detaljerad och konsekvent nog att Rufus kan göra självsäkra matchningar över ett brett spektrum av kundprofiler.
Eftersom Rufus inte exponerar en dedikerad trafikkälla i Seller Central, finns det ingen instrumentpanel som isolerar “Rufus-drivna försäljningar” på samma sätt som för sponsrade annonser. Vad som är observerbart är indirekt: hur dina produkter dyker upp när du frågar Rufus direkt, och hur mätvärden som konverteringsgrad och långsvans-sökordsrankning rör sig efter att du ändrar ditt listningsinnehåll — den konkreta checklistan för att spåra det täcks nedan. Strategiskt är det värt att hålla Rufus i proportion: vid mindre än 3 % av Amazons köp idag är den additiv för en säljares synlighet, inte en ersättning för A9-optimering, sponsrade placeringar eller trafik utifrån. De säljare som är bäst positionerade när Rufus växer är de som behandlar den som ytterligare en konsument av samma högkvalitativa produktdata som de redan behöver underhålla överallt annars.
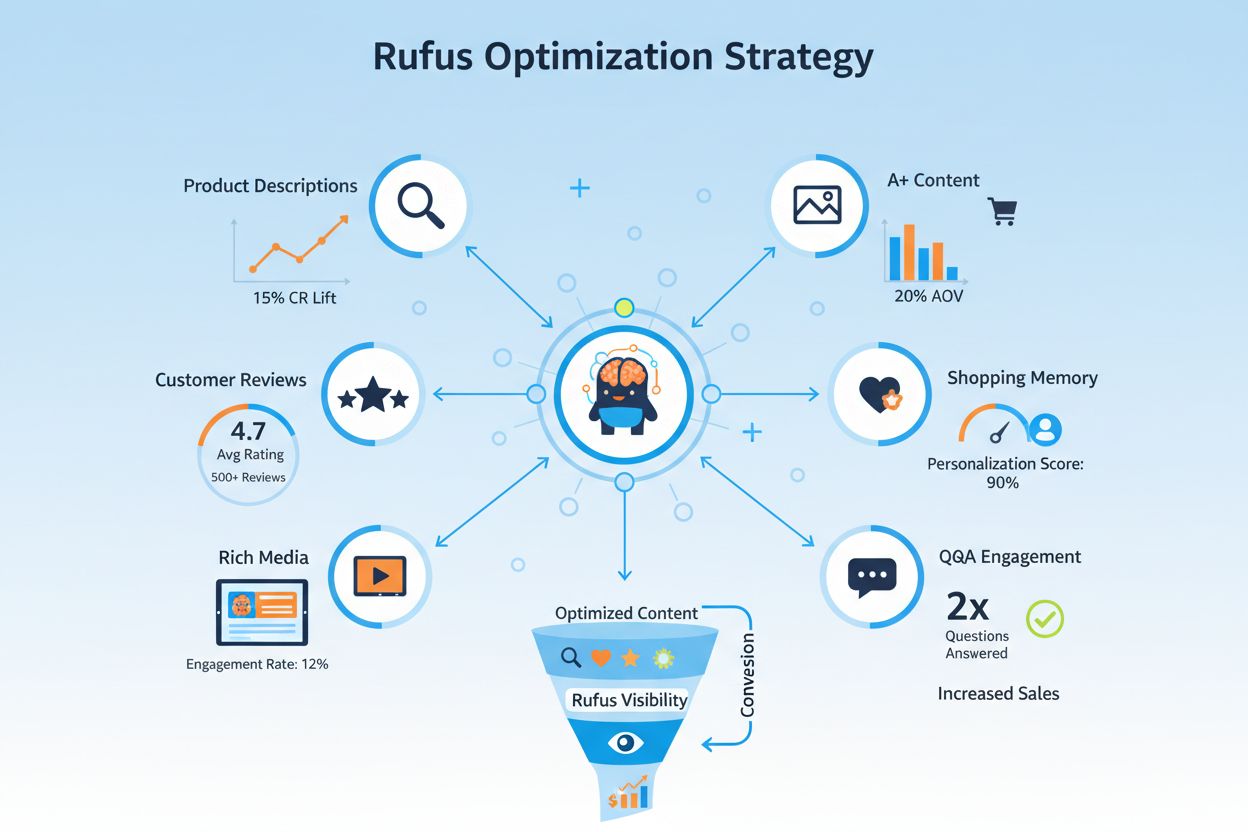
Rufus är inte en ny algoritm att reverse-engineera — det är en ny konsument av samma listningsinnehåll som säljare redan kontrollerar: bilder, beskrivningar, frågor och svar, recensioner och sökord. Det här är de fem konkreta förändringarna som gör skillnad, ungefär i den ordning de är värda att ta sig an.
1. Optimera produktbilder med strategiska textöverlägg. Rufus visuella bearbetning extraherar text, identifierar nyckelfunktioner och bedömer kvalitet från bildkomposition, inte bara vad produkten ser ut som. Se till att primärbilden är tydlig, välbelyst och visar produkten från dess mest representativa vinkel, eftersom detta ofta är bilden Rufus väger tyngst. Textöverlägg som anger specifikationer, mått eller certifieringar (en köksapparat märkt “Energy Star Certified”, till exempel) ger Rufus konkreta fakta att citera när den rekommenderar produkten, och livsstilsbilder som visar produkten i användning hjälper den att förstå verkliga tillämpningar.
2. Skapa kontextrika produktbeskrivningar. Eftersom Rufus använder naturlig språkförståelse snarare än sökordsmatchning, fungerar en beskrivning som berättar en verklig historia om vad produkten gör, vem den är för och varför den är värd att välja bättre än en funktionslista. Använd specifika detaljer om material, mått och prestanda istället för vaga påståenden som “hållbar konstruktion”, strukturera texten med underrubriker så att Rufus kan tolka den, och täck användningsområden som inte är omedelbart uppenbara.
3. Utnyttja FAQ- och frågor-och-svar-sektionerna. Rufus bryter aktivt dessa sektioner för att svara på kundfrågor, så att proaktivt skriva omfattande FAQ:er kring kompatibilitet, användning, underhåll och felsökning, och att svara snabbt på verkliga kundfrågor, formar direkt vad Rufus säger om din produkt. Naturligt, konversationsbaserat språk i dina svar hjälper Rufus att känna igen relevans för liknande framtida frågor.
4. Uppmuntra fotograferade kundrecensioner. Rufus väger recensionsinnehåll, betyg och särskilt recensionsbilder när den bedömer kvalitet och nöjdhet. En uppföljning efter köp som ber kunder dela bilder på produkten i användning, kombinerat med snabba, professionella svar på recensioner, bygger den typ av visuella och textuella bevis som Rufus behandlar som en stark förtroendesignal.
5. Förfina din sökordsstrategi kring avsikt, inte exakt matchning. Rufus semantiska förståelse känner igen synonymer och relaterade fraser, så undersök de frågor kunder faktiskt ställer om din kategori (“bästa hörlurar för löpning” tillsammans med “trådlösa hörlurar”) och arbeta in det språket naturligt i din titel, dina punkter och din beskrivning.
Ordningen spelar roll om du arbetar igenom en katalog med begränsad tid. Börja med bilder och beskrivningar, eftersom dessa är indata som Rufus läser i nästan varje fråga och fel här (en suddig primärbild, en tunn beskrivning) begränsar allt annat från att fungera. Ta dig an frågor-och-svar-sektionen härnäst, eftersom befintliga luckor aktivt kostar dig synlighet varje gång en kund frågar Rufus en fråga som din listning inte svarar på. Recensioner kommer på tredje plats, eftersom fotograferade recensioner tar längre tid att samla på sig och ju tidigare du börjar uppmuntra dem, desto snabbare ackumuleras den datan. Sökordsförfining är ett rimligt sista steg, eftersom det fungerar bäst när innehållet det läggs ovanpå redan är starkt. Vad denna sekvens medvetet utelämnar är att försöka reverse-engineera Rufus shoppingminne och personaliseringssystem direkt: det är en verklig del av hur Rufus rankar produkter för enskilda kunder, men ingen enskild listningsuppdatering kan rikta in sig på det — ju mer komplett och internt konsekvent din produktdata är över de fem förändringarna ovan, desto fler scenarier kan personaliseringslagret matcha din produkt till.
Amazon exponerar inte en dedikerad “Rufus-trafik”-metrik, så att mäta påverkan innebär att titta på indirekta indikatorer: ovanliga trafikmönster, förändringar i konverteringsgrad, kundfeedback som nämner Rufus eller en AI-rekommendation vid namn, och rörelse i din sökrankning för långsvans-, konversationsbaserade sökord. Sätt baslinjemätvärden (nuvarande konverteringsgrad, genomsnittligt ordervärde, trafikkällor) innan du gör ändringar, och följ dem sedan noggrant efteråt. UTM-parametrar på eventuella kampanjlänkar du kör kan hjälpa till att separera Rufus-relaterade vinster från annan trafik, och A/B-testning av olika beskrivningar, bilder eller FAQ-innehåll kan klargöra vilka specifika ändringar som driver resultat.
Vanliga misstag värda att undvika: sökordsfyllnad som låter onaturlig (Rufus semantiska förståelse tenderar att bestraffa detta), vag eller ofullständig produktinformation, en försummad frågor-och-svar-sektion, recensioner utan bilder eller detaljer, och motsägelsefull information över din titel, dina punkter och din beskrivning, eftersom inkonsekvens minskar Rufus förtroende för att rekommendera en listning alls.
Utöver att svara på produktfrågor har Rufus lanserat en uppsättning konsumentinriktade funktioner som utökar vad shoppingminne och retriever kan göra för personen på andra sidan konversationen.
Prisspårning, aviseringar och autoköp. Rufus visar 30- och 90-dagars prishistorik för en produkt så att shoppare kan avgöra om ett nuvarande pris faktiskt är ett fynd, och låter dem ställa in en prisavisering för en målprispunkt. För Prime-medlemmar går autoköp ett steg längre och slutför automatiskt köpet när en artikel når målpriset, med hjälp av shopparens standardbetalningsmetod och leveransadress, med ett 24-timmars fönster för att avbryta. Amazon rapporterar att kunder som använder autoköp sparar i genomsnitt 20 % per köp, och autoköpsförfrågningar förblir aktiva i sex månader eller tills de avbryts.
Visuell sökning och handskrivna listor. Shoppare kan ladda upp ett foto och be Rufus hitta liknande produkter eller lösa ett problem från det — till exempel ett foto av en fläckig matta i kombination med “hur tar jag bort denna kaffefläck?” får Rufus att analysera tyget och rekommendera relevanta rengöringsprodukter. På iOS kan Rufus också läsa en handskriven shopping- eller semesterlista från ett foto och lägga till artiklarna direkt i varukorgen, med Android-stöd på väg.
Från kollaborativ filtrering till generativ AI. Dessa funktioner sitter ovanpå ett genuint skifte i hur Amazons rekommendationsteknik fungerar. I ungefär två decennier var Amazons kärnrekommendationsmotor artikel-till-artikel kollaborativ filtrering: den analyserade köpskorrelationer mellan produkter snarare än likheter mellan kunder, och rekommenderade artiklar som andra shoppare med liknande köphistorik hade köpt tillsammans. Det tillvägagångssättet skalade bra men kämpade med nya produkter, nya kunder och den rena beräkningskostnaden av att jämföra miljontals kundrelationer. Rufus representerar en rörelse bort från den retrieverbaserade logiken mot ett generativt tillvägagångssätt: istället för “hitta produkter som liknar vad du köpte”, utgår den från “förstå vad du försöker åstadkomma och rekommendera den bästa lösningen”, vilket är vad som låter den hantera flerdelade frågor, förklara sitt resonemang och göra rimliga rekommendationer även för produkter med få eller inga recensioner ännu.
Amazon har levererat mer än 50 tekniska uppgraderingar och nya funktioner till Rufus sedan lanseringen, och banan pekar mot att assistenten tar över mer av det jämförelse- och beslutsstöd som kunder för närvarande gör själva — prisjämförelser, hållbarhetsinformation och jämförelser av flera produkter bland dem. Agentiska förmågor expanderar också: Rufus blir allt mer kapabel att ta autonoma åtgärder som att lägga till artiklar i en varukorg eller ställa in återkommande köp, inte bara föreslå dem. Amazon är inte ensamt i denna riktning heller; Walmart, Google, Perplexity och andra återförsäljare bygger sina egna konversationsbaserade shoppingassistenter, vilket tyder på att detta är en branschövergripande förändring snarare än en Amazon-specifik funktion. Realtidsåterkopplingsintegration innebär att Rufus bedömning av vilka produkter som ska visas kommer att fortsätta förändras när den observerar fler kundinteraktioner, vilket också är anledningen till att förbli synlig i Rufus inte är ett engångsprojekt: en listning som tillfredsställer Rufus idag kan behöva nytt innehåll om sex månader när modellens förväntningar utvecklas. Den praktiska implikationen för säljare är inte att jaga varje uppdatering — det är att hålla den underliggande produktdatan djup och internt konsekvent, eftersom det är råmaterialet som Rufus kommer att fortsätta hämta från oavsett hur dess retriever- och rankningslogik förändras under ytan.
Yasha är en talangfull mjukvaruutvecklare specialiserad på Python, Java och maskininlärning. Yasha skriver tekniska artiklar om AI, prompt engineering och chatbotutveckling.
Att förstå hur Rufus fungerar är första steget. Spåra hur dina produkter faktiskt citeras och rekommenderas av Amazon Rufus och andra AI-shoppingassistenter med AmICited.
Lär dig om Amazon Rufus, AI-shoppingassistenten som svarar på produktfrågor, jämför artiklar och ger personliga rekommendationer. Upptäck hur den fungerar och f...
Cookie-samtycke
Vi använder cookies för att förbättra din surfupplevelse och analysera vår trafik. See our privacy policy.