Narzędzie może obsługiwać prompty w języku japońskim, nie wykonując swojego zapytania do AI z Japonii. Fińska firma może zbierać odpowiedzi we Francji. Platforma może mieć niemieckiego operatora, a jednocześnie nie oferować niemieckiej bazy słów kluczowych. Te fakty są rutynowo sprowadzane do jednego pola „obsługiwane kraje”, co czyni międzynarodowe porównania GEO niewiarygodnymi.
Dla wielojęzycznego nabywcy geografia ma cztery odrębne warstwy: kraj operatora, rynek bazy danych, fizyczna lokalizacja wykonania zapytania AI oraz język. Ten artykuł porównuje AmICited, Peec, Superlines, Waikay, LLMrefs, LLM Pulse, Citadex i miruAI przez pryzmat tych warstw.
Ustalenia pochodzą z publicznych stron dostawców sprawdzonych 18 października 2026 roku. Opisują udokumentowane możliwości, a nie kontrolowany test produktu. Niezweryfikowane pokrycie jest traktowane jako nieznane, a nie jako nieistniejące.
Dlaczego sam język to nie lokalizacja
Przetłumaczenie „best accounting software” na japoński zmienia tekst, ale nie gwarantuje japońskich doświadczeń użytkownika. Model może otrzymać sygnał o lokalizacji, korzystać z regionalnego interfejsu, sięgać do lokalnych źródeł lub personalizować odpowiedź na podstawie historii konta. Waluta, dostępność, regulacje i znajomość marki mogą zmienić rekomendację.
Odwrotnie, fizyczne wykonanie zapytania z danego rynku nie wystarczy, jeśli prompt jest niezgrabnym tłumaczeniem. Zestaw promptów potrzebuje natywnej intencji wyszukiwania, lokalnych nazw kategorii i realistycznych ograniczeń. Dlatego wielojęzyczne GEO wymaga zarówno kontroli technicznych, jak i ludzkiej wiedzy o rynku.
Próbkowanie dodaje kolejną komplikację. Odpowiedzi AI różnią się między uruchomieniami. Porównania krajów oparte na jednej odpowiedzi na przetłumaczony prompt mogą zamienić losowość w strategiczną opowieść. Pytaj dostawców, jak często uruchamiane są prompty, czy powtarzają próbki, z jakiego interfejsu lub API korzystają oraz czy surowe odpowiedzi pozostają dostępne.
Europejskie platformy z międzynarodowymi ambicjami
AmICited jest obsługiwany przez praską firmę AiMingle, z powiązanymi lokalizacjami grupy na Słowacji i w Stanach Zjednoczonych, zgodnie z jej stroną o firmie. Jego workflow łączy monitorowanie promptów i cytowań z funkcjami analizy konkurencji, wyszukiwania, agentów, treści i raportowania połączonego. Dostępność rynków i silników zależy od planu, więc właściwym testem jest macierz rynek-język-silnik dla zamierzonej subskrypcji. Adres operatora nie czyni wyników z natury czeskimi ani słowackimi.
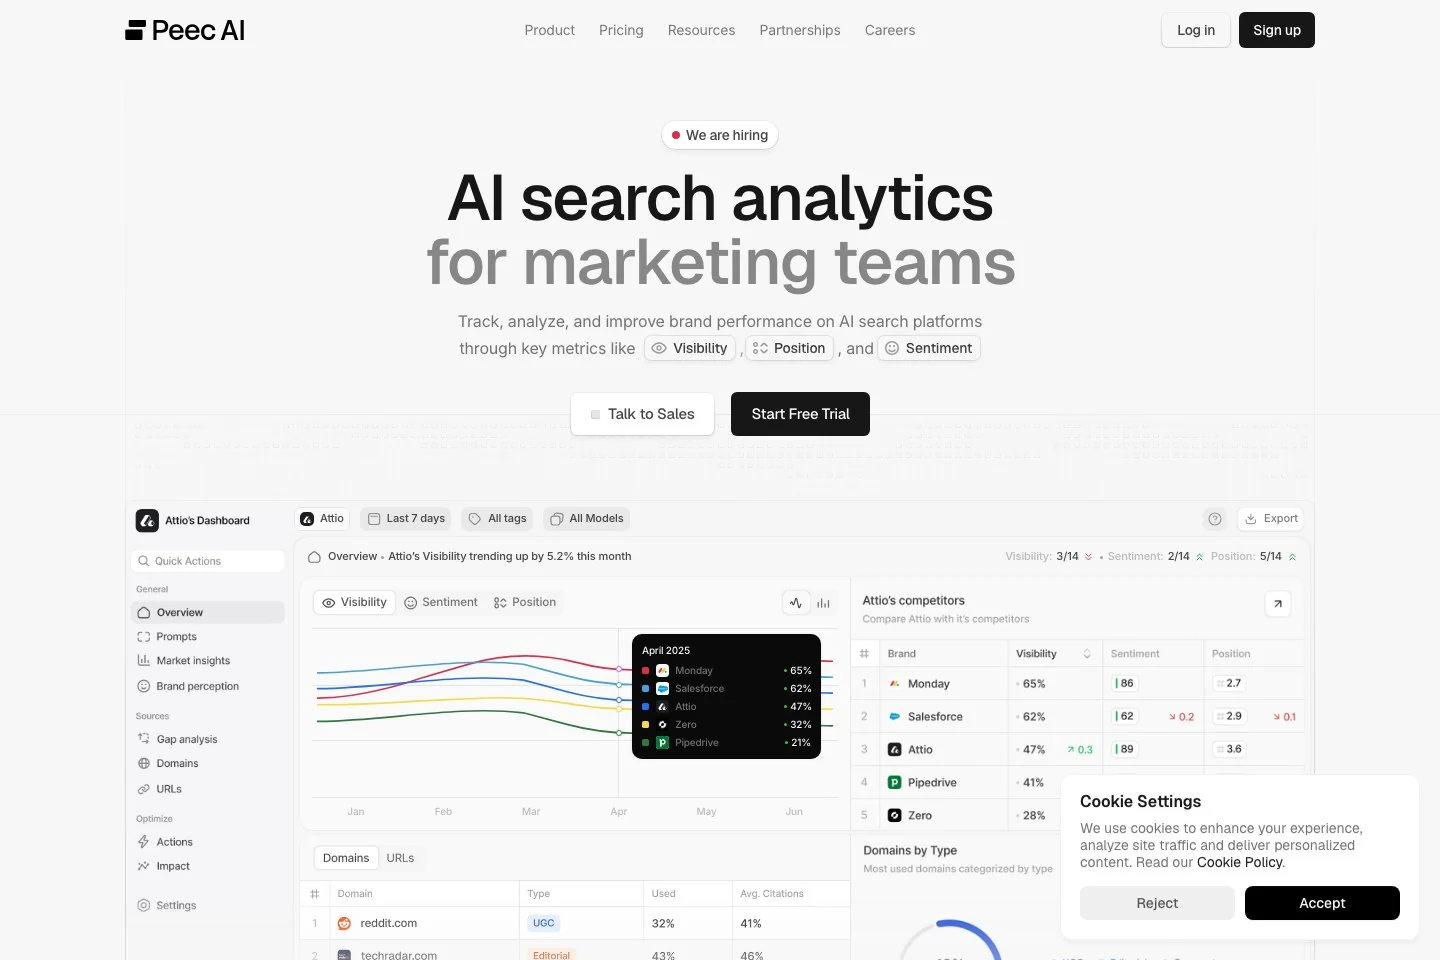
Peec jest obsługiwany przez Peec AI GmbH w Berlinie, co potwierdza jego nota prawna. Jego materiały cenowe opisują dostęp do wielu krajów w wybranych planach obok projektów, promptów, aktywnych modeli i codziennych odświeżeń. Peec jest naturalnym kandydatem dla międzynarodowych zespołów szukających dedykowanego interfejsu analitycznego, ale nabywcy powinni zweryfikować dokładną kontrolę krajów i metodę zbierania danych, zamiast wnioskować o pokryciu na podstawie „wielu krajów”.
Superlines prowadzi fińska Grew Oy. Jej opis platformy dokumentuje benchmarki dla poszczególnych rynków w różnych regionach i językach i mówi, że zbiera dane z konsumenckich interfejsów wyszukiwania AI. Promuje także dostęp przez API i MCP. To czyni go szczególnie interesującym, gdy metodologia i dane muszą trafić do procesów korporacyjnych. Twierdzenie to należy jednak zweryfikować dla każdego docelowego silnika i rynku, ponieważ zachowanie interfejsów się różni.
LLM Pulse ma hiszpański adres operatora w Barcelonie, udokumentowany w jego regulaminie. Jego publiczna platforma obejmuje śledzenie promptów, źródła cytowań, sentyment, lokalne firmy, zakupy, reputację, treści, adnotacje, raportowanie white-label i liczne modele AI. Szerokość jest przydatna dla agencji i zespołów międzydziałowych; dział zakupów powinien zapytać, które mechanizmy lokalizacji stosują się konsekwentnie do każdego modułu i silnika.
Lokalizacja operatora ma znaczenie dla umów, ochrony danych, godzin wsparcia, a czasem hostingu. Nie dowodzi jednak pochodzenia próbkowanej odpowiedzi. Europejskie podmioty prawne mogą oferować zbieranie danych globalnie, a dostawcy spoza Europy mogą obsługiwać języki europejskie. Traktuj te kwestie jako osobne wiersze w arkuszu wymagań.

Gotowy, by monitorować swoją widoczność w AI?
Śledź, jak chatboty AI wspominają Twoją markę w ChatGPT, Perplexity i innych platformach.
Narzędzia, które organizują międzynarodowe śledzenie inaczej
Waikay pozycjonuje się wokół optymalizacji wyszukiwania w AI i śledzenia promptów. Należy do wielojęzycznej listy kandydatów, gdy zespoły chcą skupionego widoku promptów i obecności marki bez wdrażania szerokiego pakietu SEO. Samo publiczne pozycjonowanie nie ustala lokalizacji wykonania dla każdego rynku, więc poproś o pokaz na żywo z dwoma promptami, których odpowiedzi w przewidywalny sposób zmieniają się między krajami.
LLMrefs przyjmuje podejście zorientowane najpierw na słowa kluczowe. Jego strona platformy mówi, że słowa kluczowe rozwijają się w konwersacyjne prompty, i dokumentuje targetowanie geograficzne w ponad 20 krajach i ponad 10 językach. Może to ograniczyć ręczne utrzymywanie promptów dla zespołów SEO przenoszących istniejące zestawy słów kluczowych. Zmienia to także obiekt pomiaru: nabywcy powinni sprawdzić generowane prompty i ich wagę, zanim porównają wynik LLMrefs z ręcznie opracowanym monitorem promptów.
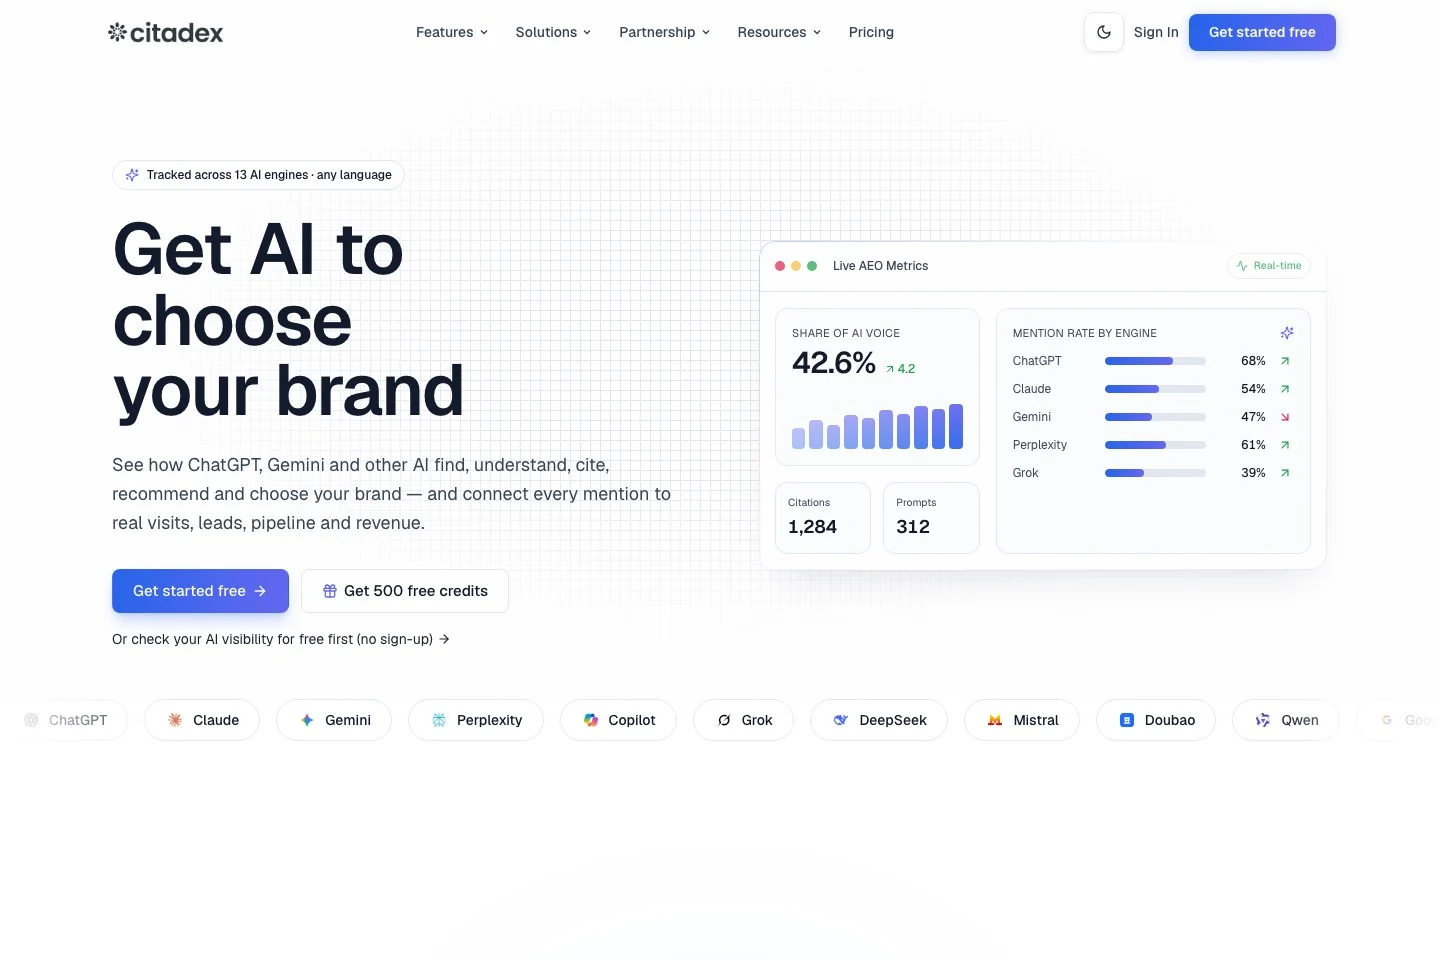
Citadex w sposób jawny modeluje rynki. Jego dokumentacja wielu rynków mówi, że rynek rozdziela region, prompty, skany i widoczność, dzieląc wspólną bazę wiedzy. To użyteczna architektura dla marek, które wiedzą, że jedna globalna średnia ukrywa istotne różnice. Publiczna pomoc i nowsze materiały ofertowe nie były w pełni spójne w analizowanych materiałach, więc aktualne ograniczenia silników, limity i ceny wymagają bezpośredniego potwierdzenia.
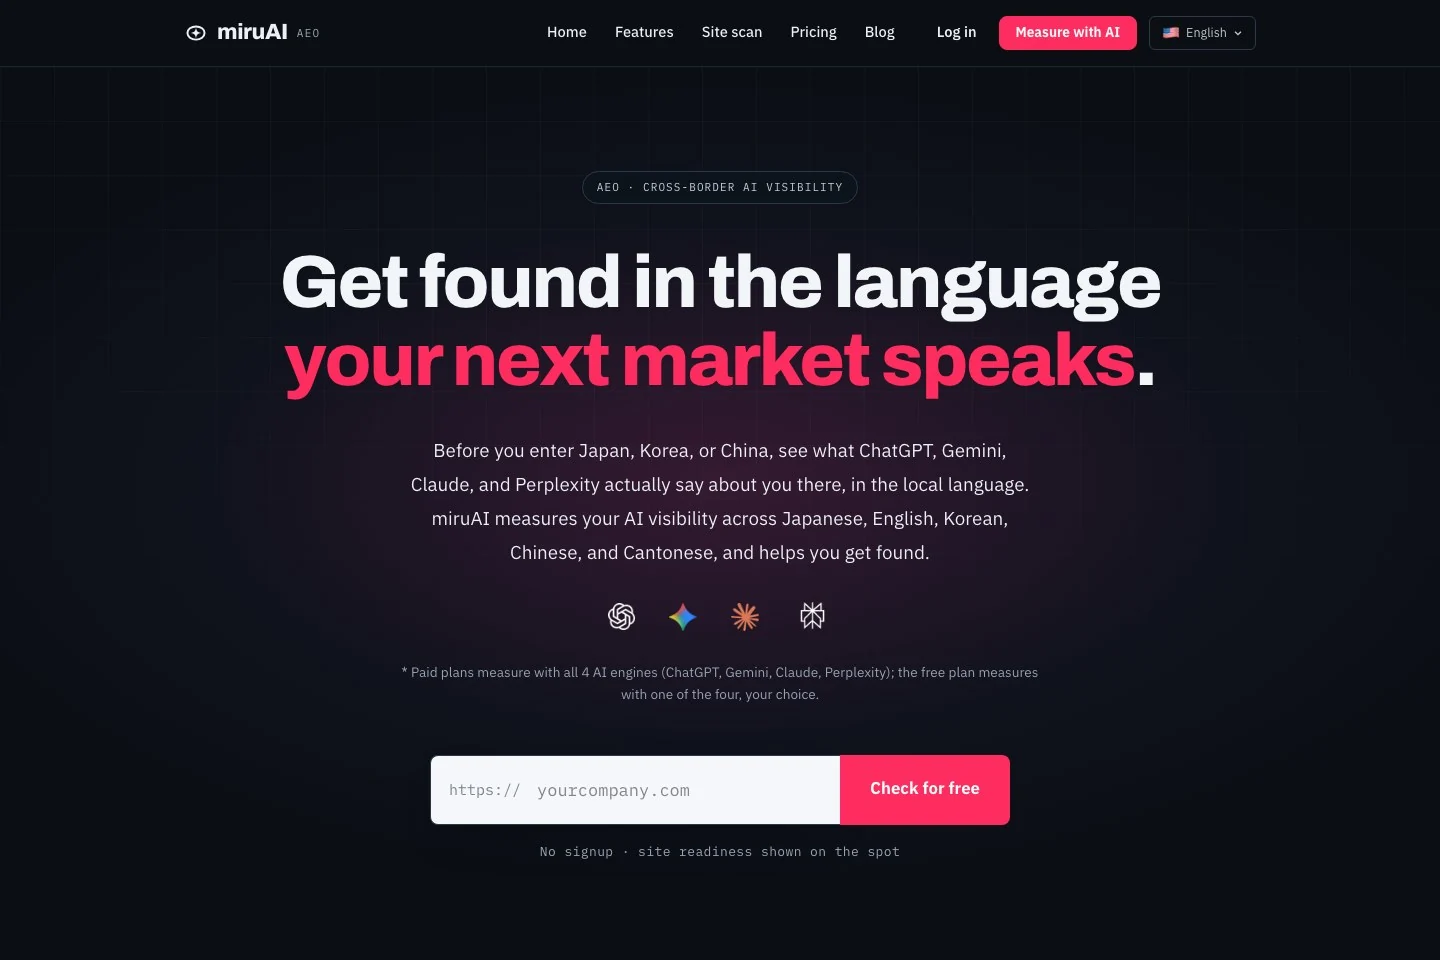
miruAI jest zbudowany wokół widoczności transgranicznej w języku japońskim, angielskim, koreańskim, chińskim i kantońskim. Jego strona dokumentuje ChatGPT, Gemini, Claude i Perplexity jako silniki do wyboru. Jego jednostka cenowa jest szczególnie pouczająca: pytanie to prompt pomnożony przez język, podczas gdy wybrane silniki nie mnożą tej liczby pytań.
Strona z cennikiem miruAI wyraźnie oznacza płatną cenę Solo wynoszącą 9800 jenów miesięcznie oraz inne płatne plany jako planowane szacunki, które nie są ostateczne; płatne plany są w przygotowaniu. Darmowy plan jest dostępną podstawą do oceny. Obsługa tekstu chińskiego lub japońskiego nie może być przedstawiana jako dowód, że zapytania są fizycznie wykonywane w Chinach lub Japonii.
Gdzie AmICited pasuje w międzynarodowym stacku
Pozycja AmICited to platforma od monitorowania do działania, a nie dedykowana baza danych do lokalizacji. Łączy dowody z promptów i cytowań z szerszą pracą badawczą i wykonawczą, a nabywcy muszą zweryfikować dokładny język, silnik, harmonogram i kontrolę rynków, których potrzebują. Centralny zespół ds. wzrostu powinien sprawdzić, czy to wspólne środowisko usuwa przekazywanie zadań w jego rzeczywistym procesie.
LLMrefs może być bardziej naturalny, gdy istniejące słowa kluczowe SEO mają napędzać automatyczne rozszerzanie promptów. Abstrakcja rynków w Citadex jest atrakcyjna, gdy regiony muszą pozostać analitycznie odseparowane. miruAI jest nietypowo wyraźny w kwestii kombinacji języków Azji Wschodniej, choć jego plany komercyjne pozostają zapowiedziane. Superlines czyni zbieranie danych z rzeczywistych interfejsów centralnym elementem swojej oferty. Peec oferuje skupiony kształt analityki znany dedykowanym zespołom GEO. LLM Pulse oferuje szeroki zestaw funkcji do reputacji, treści i pracy agencji. Waikay to szczuplejszy kandydat do śledzenia promptów.
To są wyjściowe hipotezy do pilotażu, a nie ostateczne rankingi. Żaden z analizowanych publicznych materiałów nie uzasadnia uniwersalnego zwycięzcy na każdym rynku i w każdym silniku.
Bądź na bieżąco z trendami widoczności w AI
Otrzymuj najnowsze analizy dotyczące wzmianek w AI, monitoringu marki i strategii optymalizacji.
Obronne wielojęzyczne pilotażowe wdrożenie
Wybierz trzy rynki o różnych rodzajach ryzyka: rynek macierzysty, rynek ekspansji o wysokiej wartości oraz jeden, w którym język lub dostępność platform zmieniają się istotnie. Zatrudnij natywnego marketera w każdym z nich. Zacznij od tych samych zadań nabywcy, a następnie zlokalizuj intencję, zamiast tłumaczyć słowo w słowo.
Uwzględnij odkrywanie kategorii, porównania, lokalne ograniczenia, sprawdzanie faktów o marce i pytania transakcyjne. Zapisuj surową odpowiedź, cytowane źródła, silnik, interfejs lub API, stan konta, gdy jest znany, lokalizację, język, znacznik czasu i numer powtórzenia. Sprawdź, czy źródła są lokalnie autorytatywne, a nie tylko w odpowiednim języku.
Uruchamiaj zestaw wielokrotnie przed jakąkolwiek interwencją. Następnie zmień jedną grupę danych wejściowych — treść strony, dane strukturalne, feed produktowy, encję lokalizacji lub źródło zewnętrzne — i opisz ją. Wynikowy wzorzec może wesprzeć kierunkowy wniosek. Nadal nie należy go przedstawiać jako dowodu, że jedna zmiana spowodowała każdą różnicę w niedeterministycznym modelu.
Na koniec znormalizuj koszt według rzeczywistego obciążenia. „Prompt” może oznaczać jedno zapisane pytanie, parę prompt-język, słowo kluczowe rozszerzone do wielu pytań lub wiele odpowiedzi silników. Nasze porównanie modeli cenowych wyjaśnia te mianowniki. Porównanie narzędzi czeskich i słowackich dodaje kontekst regionalny, a pełna mapa rynku SEO/GEO pokazuje, gdzie te platformy lokują się wśród pakietów, specjalistów i narzędzi e-commerce.
Międzynarodowe GEO staje się użyteczne, gdy każdy punkt danych zachowuje kontekst rynkowy. Utrzymuj operatora, bazę danych, wykonanie i język osobno, a dashboard będzie prowadził decyzje, zamiast je spłaszczać.
 LinkedIn