


Hur innehållslicensavtal påverkar ditt varumärkes synlighet i AI-sökresultat
Förstå hur AI-innehållslicensavtal med OpenAI, Google och Perplexity avgör om ditt varumärke visas i AI-genererade svar och sökresultat.
9 min läsning
Yelp licensierar nu recensioner, betyg och foton direkt till OpenAI för ChatGPTs lokala rekommendationer. Här är vad avtalet avslöjar om hur AI-plattformar hämtar varumärkesdata och vad det betyder för din strategi för AI-synlighet.
Den 23 juli 2026 bekräftade Axios vad Yelp först hade avslöjat under sin resultatrapport för Q4 2025: Yelp licensierar sina recensioner, stjärnbetyg, företagsfoton och allmänna företagsinformation till OpenAI. ChatGPT visar nu denna data direkt i lokala rekommendationssvar, inklusive tillgång till Yelps Request a Quote-funktion för hem- och lokaltjänster. Yelps varumärke och länkar åtföljer innehållet, även om OpenAI styr hur det presenteras i chattgränssnittet.
Yelps vd Jeremy Stoppelman beskrev flytten rakt på sak: företaget “ser värde i att distribuera sitt innehåll utanför sina egna plattformar när det gynnar konsumenter.” Ekonomiska villkor avslöjades inte, och avtalet är inte exklusivt — Yelp är fritt att ingå samma typ av överenskommelse med vilken annan AI-plattform som helst.
ChatGPTs svaghet med lokala sökningar har varit en öppen hemlighet sedan det lanserades. En stor språkmodell tränad på en ögonblicksbild av internet har inget tillförlitligt sätt att veta vilken rörmokare som har öppet just nu, vilken restaurang som har ett ledigt bord ikväll, eller vilken entreprenör som faktiskt dyker upp i tid — eftersom den informationen förändras varje timme och finns i strukturerade recensionsdatabaser, inte i allmän webbtext.
Yelps dataset löser det problemet på ett sätt som OpenAIs egna crawlers inte enkelt kan replikera: det är aktuellt, strukturerat och redan organiserat kring exakt den typ av sökning som ChatGPT kämpar med. Istället för att spendera år på att bygga en motsvarande lokal dataset, köpte (eller snarare, licensierade) OpenAI sig förbi luckan.
Yelp-avtalet sätter också strålkastarljuset på något som AI-synlighetsdata har visat ett tag: AI-plattformar citerar inte varumärken i närheten av samma takt.
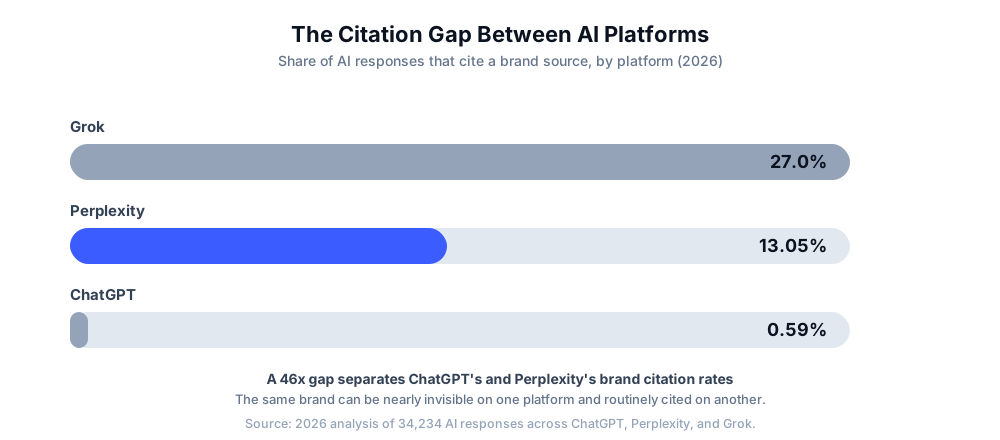
En analys från 2026 av 34 234 AI-svar visade att ChatGPT citerade en varumärkeskälla i endast 0,59 % av svaren, jämfört med 13,05 % för Perplexity och 27,0 % för Grok — en ungefär 46x skillnad mellan den lägsta och högsta plattformen. Separat visade en analys av över 680 miljoner citeringar i ChatGPT, Google AI Overviews, Perplexity, Gemini och Claude att endast 11 % av domäner citeras av både ChatGPT och Perplexity, vilket innebär att en domän som presterar väl på en plattform ofta har nästan ingen överlappning med vad som citeras på en annan.
Det sammanhanget spelar roll här: en plattform som citerar varumärken så sällan som ChatGPT har ett uppenbart incitament att licensiera en dataset som Yelps, där citeringen (Yelp självt) är inbyggd i datakällan snarare än något som modellen måste besluta att visa på egen hand.

Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Den viktigaste detaljen i Yelp-OpenAI-avtalet är inte datan — det är icke-exklusiviteten. Yelp väljer inte sida; det omvandlar sin dataset till en licensierbar produkt för alla AI-plattformar som är villiga att betala för den. Det är ett betydelsefullt skifte från den antagonistiska relation som dataägare historiskt har haft med AI-företag (Yelp har självt stämt Google över lokala sökmetoder), och det sätter ett prejudikat som andra recensionsplattformar, kataloger och vertikala dataägare sannolikt kommer att följa noga.
Om detta blir ett mönster kan vi förvänta oss en marknad för strukturerad företags- och recensionsdata som öppnas upp över flera AI-plattformar samtidigt, inte ett enda vinnare-tar-allt-avtal. Det är bra för konsumenter och för OpenAI, men det gör väldigt lite för ett varumärke som inte är det som licensieras. Att finnas i Yelps dataset hjälper dig bara om din Yelp-närvaro är tillräckligt stark för att recensioner faktiskt ska forma rekommendationen — aktuell recensionsvolym, korrekta kategorier och responsivt engagemang påverkar alla huruvida ett AI-system behandlar din lista som en trovärdig källa.
Avtal som detta sker mot en bakgrund där AI-upptäcktsplattformar rör sig längre isär, inte konvergerar mot en dominerande yta.
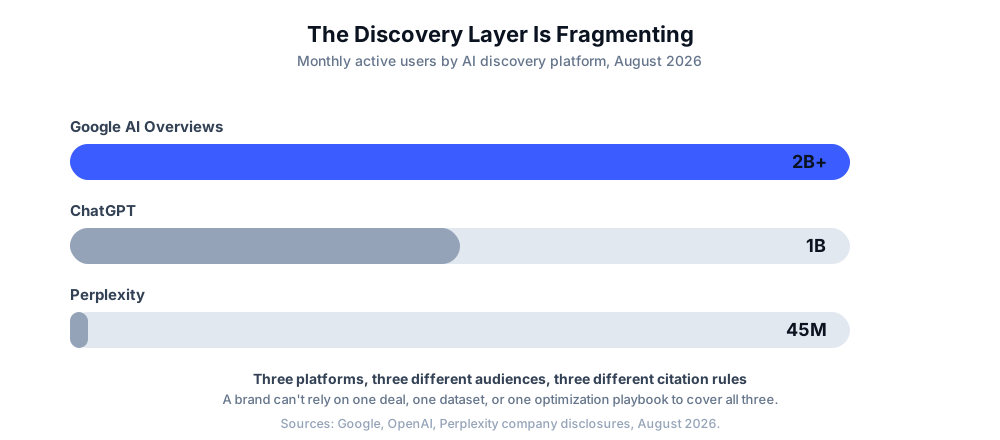
Google AI Overviews når nu över 2 miljarder månatliga användare över ungefär hälften av alla sökningar. ChatGPT har passerat 1 miljard månatliga aktiva användare. Perplexity, trots en mycket mindre räckvidd på omkring 45 miljoner månatliga användare, har vuxit sin årliga intäkt till över 750 miljoner dollar och rapporteras ha Nvidia i samtal om investeringar till en värdering över 30 miljarder dollar — signaler på att plattformens inflytande överträffar dess råa användarantal. Var och en av dessa plattformar hämtar, rankar och citerar information olika, vilket är precis anledningen till att ett enskilt dataavtal som Yelps bara flyttar nålen på en av dem.
De flesta företag kommer aldrig att få samtalet från OpenAI som Yelp fick. Det realistiska svaret är att kontrollera de inputvärden som får ett varumärke att se ut som Yelps dataset för ett AI-system — aktuellt, strukturerat och verifierbart — på varje yta som en AI-plattform faktiskt kan hämta från:
Yelp-OpenAI-avtalet är en förhandsvisning av hur AI-plattformar kommer fortsätta att täppa till sina dataluckor — inte genom att bli bättre på att crawla den öppna webben, utan genom att betala för direkt tillgång till de strukturerade dataset som redan besvarar de sökningar de är svaga på. Om andra recensionsplattformar, kataloger och dataägare följer Yelps icke-exklusiva modell, kommer de varumärken som gynnas att vara de vars underliggande data (recensioner, strukturerad markup, företagsinformation) redan var ren nog att färdas väl innan något licensavtal gjorde den synlig i stor skala.
Det är den verkliga slutsatsen: oavsett om din data någonsin blir licensierad eller inte, är sättet att synas i ChatGPTs nästa lokala rekommendation detsamma som det alltid har varit — bara svårare att ignorera nu när en riktig plattform har visat exakt vad den är villig att betala för.
Arshia är AI Workflow Engineer på FlowHunt. Med en bakgrund inom datavetenskap och en passion för AI specialiserar han sig på att skapa effektiva arbetsflöden som integrerar AI-verktyg i vardagliga uppgifter och ökar produktiviteten och kreativiteten.
AmICited spårar hur ChatGPT, Perplexity, Gemini och Google AI Overviews nämner och citerar ditt varumärke, så att du vet var du står även när du inte är den som licensierar datan.
Förstå hur AI-innehållslicensavtal med OpenAI, Google och Perplexity avgör om ditt varumärke visas i AI-genererade svar och sökresultat.
Lär dig hur du får ditt lokala företag rekommenderat av AI-sökmotorer som ChatGPT, Perplexity och Google Gemini. Upptäck beprövade strategier för att optimera f...
Lär dig beprövade strategier för att uppmuntra kundrecensioner och öka ditt varumärkes synlighet i AI-sökresultat. Upptäck hur recensioner påverkar AI-genererad...
Cookie-samtycke
Vi använder cookies för att förbättra din surfupplevelse och analysera vår trafik. See our privacy policy.