Testare i Formati dei Contenuti per le Citazioni IA: Come Progettare un Esperimento Valido
Un framework pratico per l’A/B testing dei formati di contenuti per le citazioni IA: variazioni di controllo e test, calcoli della dimensione del campione, protezione dalle variabili confondenti e per quanto tempo eseguirlo prima di fidarsi dei risultati.
Perché Testare i Formati è Meglio che Copiare le Best Practice
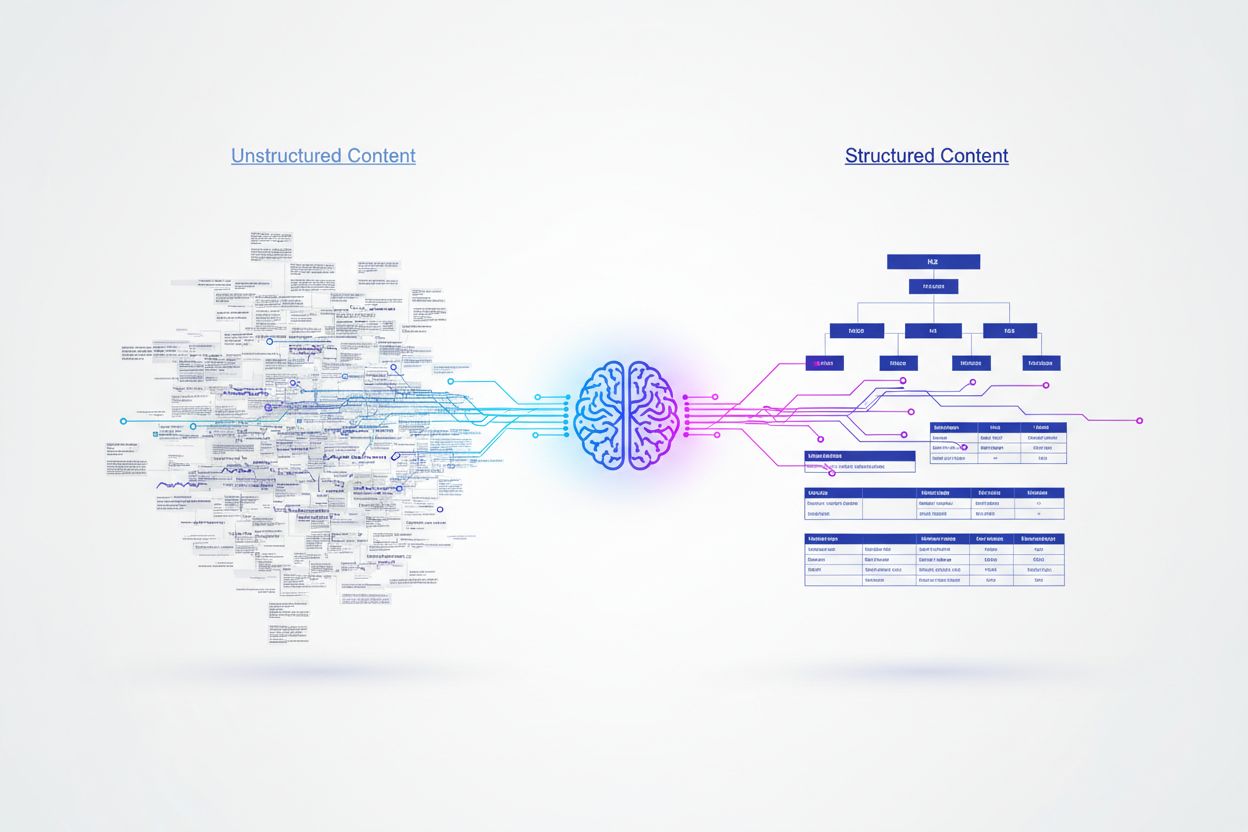
I sistemi di intelligenza artificiale elaborano i contenuti in modo fondamentalmente diverso rispetto ai lettori umani, basandosi su segnali strutturati per comprendere il significato ed estrarre informazioni. Mentre gli esseri umani possono orientarsi tra formati creativi o testi densi, i modelli IA richiedono gerarchie organizzative chiare e marcatori semantici per analizzare e comprendere efficacemente il valore del contenuto. Questo è un pattern reale e misurabile — ma è una media su tutto il web, non una garanzia per la tua specifica nicchia, audience o combinazione di piattaforme. Se vuoi sapere quali formati di contenuti vincono davvero
su scala internet, abbiamo già eseguito quell’analisi su oltre 768.000 citazioni. Questo articolo riguarda qualcosa di diverso: come progettare il tuo test per sapere cosa funziona per i tuoi contenuti, invece di presumere che i benchmark aggregati si applichino a te.
Due cose rendono i test utili piuttosto che opzionali. Primo, i contenuti strutturati con gerarchie di titoli adeguate raggiungono tassi di citazione del 156% superiori rispetto alle alternative non strutturate nei dati aggregati — ma l’entità di questo incremento varia enormemente in base al tipo di contenuto e alla piattaforma, e l’unico modo per conoscere il proprio incremento è misurarlo. Secondo, l’implementazione del markup schema mostra tassi di citazione del 340% superiori rispetto a contenuti identici senza dati strutturati, eppure gran parte di quella varianza dipende da come il markup è stato implementato, non solo dal fatto che esista. Comprendere queste differenze specifiche per piattaforma
— ChatGPT, Google AI Overviews e Perplexity pesano tutti le fonti in modo diverso — è anche parte del motivo per cui una decisione unica sul formato raramente regge: un formato che vince su una piattaforma può essere in ritardo su un’altra, quindi il design del tuo test deve specificare quali piattaforme IA
stai ottimizzando prima di iniziare.
Impostare un Test A/B Valido
Il test A/B fornisce la metodologia più affidabile per determinare quali formati di contenuti generano i tassi di citazione IA più elevati per i tuoi contenuti e il tuo pubblico specifici. Invece di affidarti a best practice generali, gli esperimenti controllati ti permettono di misurare l’impatto reale di un cambio di formato piuttosto che assumerlo. Il processo richiede un’attenta pianificazione per isolare le variabili e garantire la validità statistica, ma le intuizioni ottenute giustificano l’investimento.
Segui questo framework sistematico:
Definisci obiettivi e metriche chiari - Stabilisci obiettivi specifici come il miglioramento del tasso di citazione, l’aumento del punteggio di visibilità o il tasso di inclusione nelle risposte, con target misurabili
Crea varianti di controllo e test - Sviluppa due versioni distinte del tuo contenuto (una nel formato attuale, una nel formato di test) mantenendo tutti gli altri elementi identici
Assegnazione casuale - Se stai testando su più pagine o argomenti invece che su una singola pagina, assegna i contenuti alle varianti in modo casuale piuttosto che per convenienza, così i gruppi non differiscono in modi che potrebbero distorcere i risultati
Garantisci una dimensione del campione adeguata - Raccogli punti dati sufficienti per raggiungere la significatività statistica, in genere richiedendo 100+ citazioni o interazioni per variazione
Monitora le prestazioni continuamente - Tieni traccia delle metriche in tempo reale per identificare anomalie, problemi di qualità dei dati o pattern comportamentali inaspettati
Analizza i risultati con rigore statistico - Calcola intervalli di confidenza e valori p per confermare che le differenze osservate non siano dovute al caso
La variante di controllo dovrebbe rappresentare il tuo attuale approccio invariato; la variante di test dovrebbe differire esattamente in una dimensione — il formato stesso. Tutto il resto — argomento, targeting delle parole chiave, tempistica di pubblicazione, collegamenti interni, numero di parole — deve rimanere costante, perché qualsiasi di questi può influenzare indipendentemente il tuo tasso di citazione e offuscare la tua conclusione sul cambiamento di formato.
Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Non tutte le metriche dicono la stessa cosa su un cambio di formato, quindi scegli la tua metrica primaria prima di lanciare il test invece di cercare qualunque cosa si sia mossa dopo. Il tasso di citazione — quanto spesso le piattaforme IA fanno riferimento ai tuoi contenuti come fonte — è la misura più diretta delle prestazioni del formato. Il tasso di acquisizione dei featured snippet indica contenuti che i sistemi IA trovano particolarmente utili per risposte dirette. Le apparizioni nei knowledge panel segnalano che i sistemi IA riconoscono il tuo brand come un’entità autorevole. Il tasso di risposta dei motori generativi misura quanto spesso i sistemi IA fanno riferimento ai tuoi contenuti quando rispondono a query correlate, indipendentemente dal fatto che li citino come link.
Scegli una metrica primaria legata all’obiettivo del tuo test e tieni traccia di due o tre metriche secondarie per contesto. Un formato che migliora il tasso di citazione ma riduce l’acquisizione dei featured snippet è un risultato diverso da uno che migliora entrambi, e devi sapere quale compromesso stai realmente facendo prima di distribuire una variante vincente su tutto il sito.
Calcolare la Dimensione del Campione e la Significatività Statistica
La significatività statistica richiede un’attenta attenzione alla dimensione del campione e alla durata del test. Nelle applicazioni IA con dati sparsi o distribuzioni a coda lunga, raccogliere osservazioni sufficienti rapidamente può essere impegnativo, quindi pianifica la dimensione del campione prima di impegnarti in una finestra di test piuttosto che dopo.
Dimensioni del campione insufficienti sono l’errore più comune nei test sui formati — testare con troppo poche citazioni o interazioni produce risultati che sembrano significativi ma in realtà riflettono una variazione casuale. Come base di partenza, raccogli almeno 100 citazioni per variazione prima di trarre conclusioni e usa un calcolatore di significatività statistica per determinare la dimensione esatta del campione necessaria per il tuo livello di confidenza e la dimensione dell’effetto attesa. Campioni più grandi producono risultati più affidabili ma richiedono periodi di test più lunghi, quindi c’è un vero compromesso tra confidenza statistica e velocità di iterazione. Una volta che hai i tuoi dati, calcola intervalli di confidenza e valori p invece di valutare a occhio la differenza tra le varianti — un divario del 10% che non è statisticamente significativo è rumore, non un risultato.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Implementare il Markup Schema Senza Rovinare il Test
Se il tuo test sul formato include una variante con markup schema, la qualità dell’implementazione diventa parte dell’esperimento stesso — sbagliala e stai testando “schema rotto vs. nessuno schema”, non “schema vs. nessuno schema”. Il markup schema
fornisce un contesto esplicito che rimuove l’ambiguità dall’interpretazione del contenuto: quando un motore IA incontra un markup valido, comprende immediatamente le relazioni tra entità, i tipi di contenuto e l’importanza gerarchica senza affidarsi esclusivamente all’elaborazione del linguaggio naturale.
I tipi di schema più rilevanti dipendono dal tuo contenuto: schema Article
per post di blog, schema FAQ per sezioni di domande e risposte, schema HowTo per contenuti didattici e schema Organization per il riconoscimento del brand. Il formato JSON-LD supera specificamente altri formati di dati strutturati perché i motori IA possono analizzarlo indipendentemente dal contenuto HTML, consentendo un’estrazione più pulita.
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "Qual è il miglior formato di contenuto per le citazioni IA?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Il formato migliore dipende dalla tua piattaforma e dal tuo pubblico — consulta la nostra analisi dei dati di oltre 768.000 citazioni per la risposta aggregata, poi testala sui tuoi contenuti."
      }
    }
  ]
}
Prima che il tuo test vada in produzione, convalida ogni variante di markup con il Rich Results Test di Google o gli strumenti di validazione di Schema.org. Questo passaggio non è opzionale: un markup schema non valido
può danneggiare attivamente le possibilità di citazione invece di migliorarle, il che significa che una variante di test mal implementata può produrre un falso negativo per un formato che altrimenti avrebbe vinto.
Evitare Variabili Confondenti e Distorsioni
Le variabili confondenti sono la più grande minaccia per un test valido — introducono distorsioni quando più fattori cambiano simultaneamente, rendendo impossibile determinare quale cambiamento abbia effettivamente causato una differenza osservata. Mantieni tutti gli elementi identici tranne il formato oggetto del test: stesse parole chiave, stessa lunghezza, stessa struttura ovunque tranne che nella variabile sotto test, stessa tempistica di pubblicazione.
La distorsione temporale si verifica quando si testa durante periodi atipici — festività, eventi di cronaca importanti, cambiamenti negli algoritmi della piattaforma — che distorcono i risultati indipendentemente dal tuo cambio di formato. Esegui i test durante periodi normali e tieni conto della variazione stagionale testando per almeno 2-4 settimane invece di pochi giorni. La distorsione di selezione emerge quando i tuoi gruppi di test e controllo differiscono in modi che influenzano i risultati ancora prima che il test inizi; l’assegnazione casuale dei contenuti alle varianti è il modo per prevenirlo. Interpretare la correlazione come causalità completa l’elenco — quando un fattore esterno coincide casualmente con il tuo periodo di test, è tentante attribuire al cambio di formato un risultato che non ha causato. Considera sempre spiegazioni alternative per i cambiamenti osservati e convalida un risultato attraverso un secondo ciclo di test prima di renderlo permanente.
Per Quanto Tempo Eseguire il Test
La maggior parte degli esperti consiglia di eseguire i test per almeno 2-4 settimane. Questa finestra tiene conto della variazione temporale — effetti del giorno della settimana, picchi di traffico a breve termine, anomalie momentanee degli algoritmi — e ti dà il tempo di accumulare le 100+ citazioni per variazione necessarie per la confidenza statistica. Terminare un test in anticipo perché una variante sembra in vantaggio dopo tre giorni è uno dei modi più rapidi per lanciare un falso vincitore: i vantaggi iniziali spesso regrediscono quando arrivano più dati.
Se la combinazione di contenuto e piattaforma produce citazioni lentamente, estendi la finestra invece di ridurre il requisito di dimensione del campione. Un test più lungo e adeguatamente potenziato è meglio di uno più breve che tecnicamente “ha finito” ma non ha mai raggiunto la significatività statistica.
Dall’Esperimento al Lancio: Esempi di Test Reali
Questi esempi mostrano il framework sopra applicato dall’inizio alla fine. Un’azienda tecnologica che testava articoli di confronto prodotti
li ha convertiti dal formato paragrafo a tabelle di confronto strutturate
e ha misurato un aumento del 52% nelle citazioni IA entro 60 giorni. Fondamentalmente, hanno mantenuto identiche la lunghezza dei contenuti e l’ottimizzazione delle parole chiave tra le varianti, isolando il cambiamento di formato come unica variabile
— la versione da manuale di un test pulito.
Un’azienda di servizi finanziari ha eseguito una variante a minor sforzo: ha aggiunto lo schema FAQ alle sezioni esistenti di domande e risposte senza riscrivere alcun contenuto, poi ha misurato un aumento del 34% nelle apparizioni dei featured snippet e un aumento del 28% nelle citazioni IA entro 45 giorni. Poiché il contenuto sottostante non è cambiato, hanno potuto attribuire l’intero incremento al markup stesso. Un’azienda SaaS è andata oltre, eseguendo test multivariati su tre formati simultaneamente — elenchi, tabelle e paragrafi tradizionali — per contenuti identici sulle loro caratteristiche di prodotto. Quel test ha richiesto una dimensione del campione maggiore e una randomizzazione più attenta rispetto a un semplice test A/B a due varianti, ma ha permesso di misurare i compromessi (gli elenchi hanno vinto sul volume di citazioni, le tabelle sulla precisione di analisi) che un singolo test A/B non avrebbe potuto rivelare.
Il Futuro dei Test sui Formati: Sperimentazione Adattiva
Il panorama dei test sui formati dei contenuti continua ad evolversi man mano che i sistemi IA diventano più sofisticati. Gli algoritmi multi-armed bandit rappresentano un progresso significativo rispetto al tradizionale test A/B a durata fissa, allocando dinamicamente il traffico a diverse varianti in base alle prestazioni in tempo reale invece di attendere la conclusione di un periodo di test predeterminato. Questo approccio riduce il tempo necessario per identificare una variante vincente e migliora le prestazioni durante il periodo di test stesso, non solo dopo.
La sperimentazione adattiva basata sull’apprendimento per rinforzo consente ai sistemi di test di apprendere e adattarsi continuamente da esperimenti in corso in tempo reale invece che attraverso cicli di test discreti. L’automazione basata sull’IA nei test A/B utilizza l’IA stessa per automatizzare la progettazione degli esperimenti, l’analisi dei risultati e le raccomandazioni di ottimizzazione, permettendo ai team di testare più varianti simultaneamente senza un aumento proporzionale della complessità. Le organizzazioni che costruiscono oggi una disciplina di test manuale rigorosa — gruppi di controllo puliti, dimensioni del campione adeguate, confronti senza variabili confondenti — saranno quelle posizionate per adottare efficacemente questi metodi adattivi, perché i fondamenti statistici non cambiano; cambia solo la velocità di iterazione. Per il playbook più ampio in cui questi test sui singoli formati confluiscono, consulta la nostra guida passo passo per aumentare la visibilità nella ricerca IA
dall’inizio alla fine.
Domande frequenti
La maggior parte degli esperti consiglia di eseguire i test per almeno 2-4 settimane per tenere conto delle variazioni temporali e garantire risultati affidabili. Questa durata ti consente di raccogliere punti dati sufficienti (tipicamente 100+ citazioni per variazione) e di tenere conto delle variazioni stagionali o dei cambiamenti degli algoritmi della piattaforma che potrebbero distorcere i risultati.
Sì, puoi condurre test multivariati su più formati contemporaneamente, ma ciò richiede un'attenta pianificazione per evitare complessità nell'interpretazione dei risultati. Inizia con semplici test A/B confrontando due formati, poi passa ai test multivariati una volta comprese le basi e quando disponi di risorse statistiche adeguate.
In genere servono almeno 100 citazioni o interazioni per variazione per raggiungere la significatività statistica. Usa calcolatori statistici per determinare la dimensione esatta del campione necessaria per il tuo specifico livello di confidenza e dimensione dell'effetto. Campioni più grandi forniscono risultati più affidabili ma richiedono periodi di test più lunghi.
Inizia identificando il tipo di schema più pertinente per il tuo contenuto (Article, FAQ, HowTo, ecc.), poi usa il formato JSON-LD per implementarlo. Convalida il tuo markup utilizzando il Rich Results Test di Google o gli strumenti di validazione di Schema.org prima che il test vada in produzione. Un markup schema non valido introduce una variabile confondente che può far sembrare fallito un formato in realtà valido.
Modificare più di una variabile alla volta. Se cambi il formato e aggiorni anche le parole chiave, la lunghezza o la data di pubblicazione, non puoi più isolare quale cambiamento ha causato il risultato. Mantieni ogni elemento identico tra le variazioni, tranne il singolo elemento del formato oggetto del test.
Qualsiasi cosa che cambi insieme al formato e che potrebbe influenzare indipendentemente le citazioni: tempistica di pubblicazione, targeting delle parole chiave, lunghezza del contenuto, collegamenti interni, o persino un aggiornamento dell'algoritmo della piattaforma che avviene a metà test. L'assegnazione casuale e l'identità degli elementi non legati al formato sono il modo per escluderli.
Monitora i miglioramenti del tasso di citazione, i tassi di acquisizione dei featured snippet, le apparizioni nei knowledge panel e i tassi di risposta dei motori generativi. Stabilisci metriche di base prima del test, poi monitora le prestazioni settimanalmente per identificare le tendenze. Un test riuscito mostra tipicamente un miglioramento del 20%+ nella metrica primaria entro 4-8 settimane — quel miglioramento nella visibilità è il segnale che stai cercando.
Viktor Zeman è comproprietario di QualityUnit. Anche dopo 20 anni alla guida dell'azienda, rimane principalmente un ingegnere del software, specializzato in IA, SEO programmatica e sviluppo backend. Ha contribuito a numerosi progetti, tra cui LiveAgent, PostAffiliatePro, FlowHunt, UrlsLab e molti altri.
Viktor Zeman
CEO, AI Engineer
Traccia i Tuoi Test sui Formati con AmICited
Esegui un A/B test pulito e osserva i dati delle citazioni arrivare. AmICited monitora come ChatGPT, Google AI Overviews e Perplexity citano ogni variazione, così puoi misurare i risultati invece di indovinare.
Quali formati di contenuto vengono effettivamente citati dall'IA? Testare diversi approcci
Discussione della comunità su quali formati di contenuto performano meglio nella ricerca IA. Risultati reali dei test e strategie per contenuti ottimizzati per ...
I tavoli e i contenuti strutturati aiutano davvero con le citazioni AI? Lo sto testando personalmente
Discussione della comunità su come tabelle e formattazione strutturata migliorino i tassi di citazione AI. Risultati reali di test da marketer che sperimentano ...
Come Creare Contenuti Comparativi Ottimizzati per l’IA per ChatGPT, Perplexity & Google AI
Scopri come creare contenuti comparativi ottimizzati per le citazioni dell’IA. Utilizza tabelle strutturate, schema markup e formattazione densa di fatti per es...
14 min di lettura
Consenso Cookie Usiamo i cookie per migliorare la tua esperienza di navigazione e analizzare il nostro traffico. See our privacy policy.
Questi cookie sono necessari per il funzionamento del sito web e non possono essere disabilitati.
Cookie Analitici
Questi cookie ci aiutano a capire come i visitatori interagiscono con il nostro sito web.
Cookie di Marketing
Questi cookie vengono utilizzati per misurare l'efficacia delle nostre campagne pubblicitarie e per supportare pubblicità pertinente su piattaforme di terze parti.
Cookie Funzionali
Questi cookie vengono utilizzati per ricordare le tue preferenze e migliorare la tua esperienza.