Tester les formats de contenu pour les citations IA : comment concevoir une expérience valide
Un cadre pratique pour les tests A/B des formats de contenu pour les citations IA : variations témoin et test, calcul de la taille de l’échantillon, protection contre les facteurs de confusion, et durée de test avant de pouvoir se fier aux résultats.
Pourquoi les tests de format surpassent la copie des bonnes pratiques
Les systèmes d’intelligence artificielle traitent le contenu de manière fondamentalement différente des lecteurs humains, en s’appuyant sur des signaux structurés pour comprendre le sens et extraire les informations. Alors que les humains peuvent naviguer à travers un formatage créatif ou une prose dense, les modèles d’IA nécessitent des hiérarchies organisationnelles claires et des marqueurs sémantiques pour analyser et comprendre efficacement la valeur du contenu. C’est un modèle réel et mesurable — mais c’est une moyenne sur l’ensemble du web, pas une garantie pour votre niche, votre audience ou votre combinaison de plateformes spécifiques. Si vous voulez savoir quels formats de contenu gagnent réellement
à l’échelle d’Internet, nous avons déjà mené cette analyse sur plus de 768 000 citations. Cet article traite de quelque chose de différent : comment concevoir votre propre test pour savoir ce qui fonctionne pour votre contenu, plutôt que de supposer que les références agrégées s’appliquent à vous.
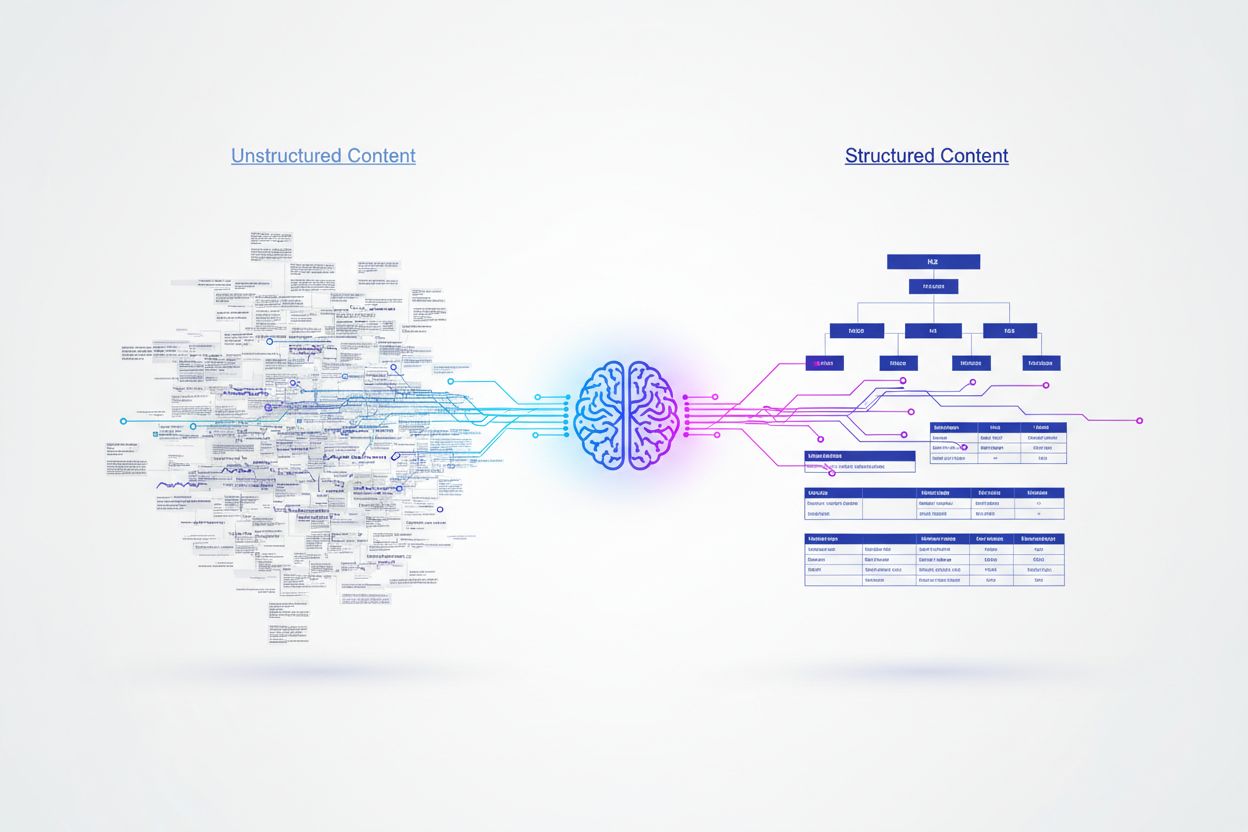
Deux éléments rendent les tests utiles plutôt qu’optionnels. Premièrement, le contenu structuré avec des hiérarchies de titres appropriées atteint des taux de citation 156% plus élevés que les alternatives non structurées dans les données agrégées — mais l’ampleur de cette augmentation varie énormément selon le type de contenu et la plateforme, et la seule façon de connaître votre propre augmentation est de la mesurer. Deuxièmement, l’implémentation d’un balisage schema montre des taux de citation 340% plus élevés que le contenu identique sans données structurées, mais une grande partie de cette variance dépend de comment le balisage a été implémenté, pas seulement de son existence. Comprendre ces spécificités propres aux plateformes
— ChatGPT, Google AI Overviews et Perplexity pondèrent tous les sources différemment — fait également partie des raisons pour lesquelles une décision de format unique fonctionne rarement : un format qui gagne sur une plateforme peut être à la traîne sur une autre, donc la conception de votre test doit préciser quelles plateformes d’IA
vous optimisez avant de commencer.
Mise en place d’un test A/B valide
Le test A/B fournit la méthodologie la plus fiable pour déterminer quels formats de contenu génèrent les taux de citation IA les plus élevés pour votre contenu et votre audience spécifiques. Plutôt que de se fier à des bonnes pratiques générales, les expériences contrôlées vous permettent de mesurer l’impact réel d’un changement de format plutôt que de le supposer. Le processus nécessite une planification minutieuse pour isoler les variables et garantir la validité statistique, mais les informations obtenues justifient l’investissement.
Suivez ce cadre systématique :
Définissez des objectifs et des indicateurs clairs — Établissez des objectifs spécifiques tels que l’amélioration du taux de citation, l’augmentation du score de visibilité ou le taux d’inclusion dans les réponses, avec des cibles mesurables
Créez des variations témoin et test — Développez deux versions distinctes de votre contenu (une dans le format actuel, une dans le format testé) tout en gardant tous les autres éléments identiques
Randomisez l’attribution — Lorsque vous testez sur plusieurs pages ou sujets plutôt qu’une seule page, attribuez le contenu aux variations de manière aléatoire plutôt que par commodité, afin que les groupes ne diffèrent pas d’une manière qui pourrait biaiser les résultats
Assurez une taille d’échantillon adéquate — Recueillez suffisamment de points de données pour atteindre une signification statistique, nécessitant généralement 100+ citations ou interactions par variation
Surveillez les performances en continu — Suivez les indicateurs en temps réel pour identifier les anomalies, les problèmes de qualité des données ou les comportements inattendus
Analysez les résultats avec rigueur statistique — Calculez les intervalles de confiance et les valeurs p pour confirmer que les différences observées ne sont pas dues au hasard
La variation témoin doit représenter votre approche actuelle et inchangée ; la variation test doit différer sur exactement une dimension — le format lui-même. Tout le reste — sujet, ciblage des mots-clés, moment de publication, maillage interne, nombre de mots — doit rester constant, car n’importe lequel de ces éléments peut indépendamment modifier votre taux de citation et brouiller votre conclusion concernant le changement de format.
Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Tous les indicateurs ne vous disent pas la même chose à propos d’un changement de format, alors choisissez votre indicateur principal avant de lancer le test plutôt que de chercher ce qui a bougé après coup. Le taux de citation — la fréquence à laquelle les plateformes d’IA référencent votre contenu comme source — est la mesure la plus directe de la performance du format. Le taux de capture d’extraits optimisés indique un contenu que les systèmes d’IA trouvent particulièrement utile pour les réponses directes. Les apparitions dans les panneaux de connaissances signalent que les systèmes d’IA reconnaissent votre marque comme une entité faisant autorité. Le taux de réponse des moteurs génératifs mesure la fréquence à laquelle les systèmes d’IA référencent votre contenu lorsqu’ils répondent à des requêtes connexes, indépendamment du fait qu’ils le citent comme lien.
Choisissez un indicateur principal lié à l’objectif de votre test, et suivez deux ou trois indicateurs secondaires pour le contexte. Un format qui améliore le taux de citation mais fait chuter la capture d’extraits optimisés est un résultat différent de celui qui améliore les deux, et vous voulez savoir quel compromis vous faites réellement avant de déployer une variation gagnante sur l’ensemble du site.
Calcul de la taille de l’échantillon et de la signification statistique
La signification statistique nécessite une attention particulière à la taille de l’échantillon et à la durée du test. Dans les applications d’IA avec des données éparses ou des distributions à longue traîne, il peut être difficile de recueillir rapidement suffisamment d’observations, alors planifiez votre taille d’échantillon avant de vous engager dans une fenêtre de test plutôt qu’après.
Des tailles d’échantillon insuffisantes sont l’erreur la plus courante dans les tests de format — tester avec trop peu de citations ou d’interactions produit des résultats qui semblent significatifs mais qui reflètent en réalité des variations aléatoires. En règle générale, recueillez au moins 100 citations par variation avant de tirer des conclusions, et utilisez un calculateur de signification statistique pour déterminer la taille d’échantillon exacte nécessaire pour votre niveau de confiance et la taille d’effet attendue. Des échantillons plus grands produisent des résultats plus fiables mais nécessitent des périodes de test plus longues, il existe donc un véritable compromis entre la confiance statistique et la rapidité d’itération. Une fois vos données obtenues, calculez les intervalles de confiance et les valeurs p plutôt que d’estimer la différence entre les variations à vue d’œil — un écart de 10% qui n’est pas statistiquement significatif est du bruit, pas un résultat.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Implémenter un balisage schema sans casser votre test
Si votre test de format inclut une variation de balisage schema, la qualité de l’implémentation fait partie de l’expérience elle-même — si vous vous trompez, vous testez « schéma cassé vs. pas de schéma », pas « schéma vs. pas de schéma ». Le balisage Schema
fournit un contexte explicite qui élimine l’ambiguïté dans l’interprétation du contenu : lorsqu’un moteur d’IA rencontre un balisage valide, il comprend immédiatement les relations entre les entités, les types de contenu et l’importance hiérarchique sans se fier uniquement au traitement du langage naturel.
Les types de schéma les plus pertinents dépendent de votre contenu : schéma Article
pour les articles de blog, schéma FAQ pour les sections de questions-réponses, schéma HowTo pour le contenu instructif, et schéma Organization pour la reconnaissance de la marque. Le format JSON-LD surpasse spécifiquement les autres formats de données structurées car les moteurs d’IA peuvent l’analyser indépendamment du contenu HTML, permettant une extraction plus propre.
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "What is the best content format for AI citations?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "The best format depends on your platform and audience — see our data analysis of 768,000+ citations for the aggregate answer, then test it against your own content."
      }
    }
  ]
}
Avant le lancement de votre test, validez chaque variation de balisage avec le test des résultats enrichis de Google ou les outils de validation de Schema.org. Cette étape n’est pas optionnelle : un schéma invalide
peut activement nuire aux chances de citation plutôt que de les améliorer, ce qui signifie qu’une variation de test mal implémentée peut produire un faux négatif pour un format qui aurait autrement gagné.
Éviter les variables confusionnelles et les biais
Les variables confusionnelles constituent la plus grande menace pour un test valide — elles introduisent un biais lorsque plusieurs facteurs changent simultanément, rendant impossible la détermination du changement qui a réellement causé une différence observée. Gardez tous les éléments identiques à l’exception du format testé : mêmes mots-clés, même longueur, même structure partout sauf la variable testée, même moment de publication.
Le biais temporel survient lorsque les tests sont effectués pendant des périodes atypiques — jours fériés, événements médiatiques majeurs, changements d’algorithme de plateforme — qui faussent les résultats indépendamment de votre changement de format. Effectuez les tests pendant des périodes normales et tenez compte des variations saisonnières en testant pendant au moins 2 à 4 semaines plutôt que quelques jours. Le biais de sélection apparaît lorsque vos groupes test et témoin diffèrent d’une manière qui affecte les résultats avant même le début du test ; l’attribution aléatoire du contenu aux variations est ce qui permet de l’éviter. L’interprétation erronée de la corrélation comme causalité complète la liste — lorsqu’un facteur externe coïncide par hasard avec votre période de test, il est tentant d’attribuer au changement de format un résultat qu’il n’a pas causé. Envisagez toujours des explications alternatives pour les changements observés, et validez un résultat par un second cycle de test avant de le rendre permanent.
Combien de temps mener votre test
La plupart des experts recommandent de mener les tests pendant au moins 2 à 4 semaines. Cette fenêtre tient compte des variations temporelles — effets de jour de semaine, pics de trafic à court terme, bizarreries momentanées d’algorithme — et vous donne le temps d’accumuler les 100+ citations par variation nécessaires à la confiance statistique. Arrêter un test prématurément parce qu’une variation semble en tête après trois jours est l’un des moyens les plus rapides de déployer un faux gagnant : les avances précoces régressent fréquemment lorsque davantage de données arrivent.
Si votre combinaison de contenu et de plateforme produit des citations lentement, prolongez la fenêtre plutôt que de réduire votre exigence de taille d’échantillon. Un test plus long et correctement dimensionné est préférable à un test plus court qui a techniquement « terminé » mais n’a jamais atteint une signification statistique.
De l’expérience au déploiement : exemples concrets de tests
Ces exemples montrent le cadre ci-dessus appliqué de bout en bout. Une entreprise technologique testant des articles de comparaison de produits
les a convertis du format paragraphe en tableaux de comparaison structurés
et a mesuré une augmentation de 52% des citations IA en 60 jours. Crucialement, ils ont maintenu la longueur du contenu et l’optimisation des mots-clés identiques entre les variations, isolant le changement de format comme seule variable
— la version classique d’un test propre.
Une entreprise de services financiers a mené une variante moins coûteuse : elle a ajouté un schéma FAQ aux sections de questions-réponses existantes sans réécrire aucun contenu, puis a mesuré une augmentation de 34% des apparitions dans les extraits optimisés et une augmentation de 28% des citations IA en 45 jours. Comme le contenu sous-jacent n’a pas changé, ils ont pu attribuer l’intégralité de la progression au balisage lui-même. Une entreprise SaaS est allée plus loin, en menant des tests multivariés sur trois formats simultanément — listes, tableaux et paragraphes traditionnels — pour un contenu identique sur leurs fonctionnalités produit. Ce test a nécessité une taille d’échantillon plus grande et une randomisation plus minutieuse qu’un simple test A/B à deux variantes, mais il leur a permis de mesurer les compromis (les listes ont gagné en volume de citations, les tableaux ont gagné en précision d’analyse) qu’un seul test A/B n’aurait pas pu révéler.
L’avenir des tests de format : l’expérimentation adaptative
Le paysage des tests de format de contenu continue d’évoluer à mesure que les systèmes d’IA deviennent plus sophistiqués. Les algorithmes à bandits manchots représentent une avancée significative par rapport aux tests A/B traditionnels à durée fixe, en ajustant dynamiquement l’allocation du trafic vers différentes variations en fonction des performances en temps réel plutôt que d’attendre la fin d’une période de test prédéterminée. Cette approche réduit le temps nécessaire pour identifier une variante gagnante et améliore les performances pendant la période de test elle-même, plutôt que seulement après.
L’expérimentation adaptative alimentée par l’apprentissage par renforcement permet aux systèmes de test d’apprendre et de s’ajuster en continu à partir d’expériences en cours en temps réel plutôt que par des cycles de test discrets. L’automatisation pilotée par l’IA dans les tests A/B utilise l’IA elle-même pour automatiser la conception des expériences, l’analyse des résultats et les recommandations d’optimisation, permettant aux équipes de tester davantage de variations simultanément sans augmentation proportionnelle de la complexité. Les organisations qui construisent aujourd’hui une discipline de test manuel rigoureuse — groupes témoins propres, tailles d’échantillon adéquates, comparaisons sans facteurs de confusion — seront celles qui seront positionnées pour adopter efficacement ces méthodes adaptatives, car les fondamentaux statistiques ne changent pas ; seule la vitesse d’itération change. Pour le guide plus large dans lequel s’inscrivent ces tests de format individuels, consultez notre guide étape par étape pour augmenter la visibilité dans la recherche IA
de bout en bout.
Questions fréquemment posées
La plupart des experts recommandent de mener les tests pendant au moins 2 à 4 semaines pour tenir compte des variations temporelles et garantir des résultats fiables. Cette durée vous permet de recueillir suffisamment de points de données (généralement 100+ citations par variation) et de prendre en compte les variations saisonnières ou les changements d'algorithme de plateforme qui pourraient fausser les résultats.
Oui, vous pouvez effectuer des tests multivariés sur plusieurs formats simultanément, mais cela nécessite une planification minutieuse pour éviter la complexité dans l'interprétation des résultats. Commencez par des tests A/B simples comparant deux formats, puis passez aux tests multivariés une fois que vous maîtrisez les bases et disposez de ressources statistiques adéquates.
Vous avez généralement besoin d'au moins 100 citations ou interactions par variation pour atteindre une signification statistique. Utilisez des calculateurs statistiques pour déterminer la taille d'échantillon exacte nécessaire pour votre niveau de confiance et la taille d'effet souhaitée. Des échantillons plus grands fournissent des résultats plus fiables mais nécessitent des périodes de test plus longues.
Commencez par identifier le type de schéma le plus pertinent pour votre contenu (Article, FAQ, HowTo, etc.), puis utilisez le format JSON-LD pour l'implémenter. Validez votre balisage à l'aide du test des résultats enrichis de Google ou des outils de validation de Schema.org avant le lancement de votre test. Un balisage schema invalide introduit un facteur de confusion qui peut faire échouer un format pourtant bon.
Modifier plus d'une variable à la fois. Si vous changez le format et que vous mettez également à jour les mots-clés, la longueur ou la date de publication, vous ne pouvez plus isoler quel changement a causé le résultat. Gardez chaque élément identique entre les variations, à l'exception du seul élément de format testé.
Tout ce qui change parallèlement à votre format et pourrait affecter indépendamment les citations : le moment de publication, le ciblage des mots-clés, la longueur du contenu, le maillage interne, ou même une mise à jour d'algorithme de plateforme survenant en cours de test. L'attribution aléatoire et l'identité des éléments hors format sont ce qui permet de les exclure.
Suivez les améliorations du taux de citation, les taux de capture des extraits optimisés, les apparitions dans les panneaux de connaissances et les taux de réponse des moteurs génératifs. Établissez des indicateurs de référence avant de tester, puis surveillez les performances chaque semaine pour identifier les tendances. Un test réussi montre généralement une amélioration de 20%+ de votre indicateur principal en 4 à 8 semaines — cette amélioration de visibilité est le signal que vous testez.
Viktor Zeman est copropriétaire de QualityUnit. Même après 20 ans à la tête de l'entreprise, il reste avant tout ingénieur logiciel, spécialisé en IA, en SEO programmatique et en développement backend. Il a contribué à de nombreux projets, dont LiveAgent, PostAffiliatePro, FlowHunt, UrlsLab et bien d'autres.
Viktor Zeman
CEO, AI Engineer
Suivez vos tests de format avec AmICited
Réalisez un test A/B propre et regardez les données de citations affluer. AmICited surveille la façon dont ChatGPT, Google AI Overviews et Perplexity citent chaque variation, afin que vous puissiez mesurer les résultats plutôt que de deviner.
Quels formats de contenu sont réellement cités par l’IA ? Test de différentes approches
Discussion communautaire sur les formats de contenu qui performent le mieux dans la recherche IA. Résultats de tests réels et stratégies pour un contenu optimis...
Les tableaux et le contenu structuré aident-ils vraiment les citations par l’IA ? Test par moi-même
Discussion communautaire sur l’impact des tableaux et du formatage structuré sur le taux de citation par l’IA. Résultats réels de tests menés par des marketeurs...
Découvrez ce que signifie un format analysable par l’IA et comment structurer votre contenu avec des titres clairs, des paragraphes courts et des listes à puces...
17 min de lecture
Consentement aux Cookies Nous utilisons des cookies pour améliorer votre expérience de navigation et analyser notre trafic. See our privacy policy.
Ces cookies sont nécessaires pour le fonctionnement du site web et ne peuvent pas être désactivés.
Cookies d'Analyse
Ces cookies nous aident à comprendre comment les visiteurs interagissent avec notre site web.
Cookies Marketing
Ces cookies sont utilisés pour mesurer l'efficacité de nos campagnes publicitaires et pour soutenir une publicité pertinente sur des plateformes tierces.
Cookies Fonctionnels
Ces cookies sont utilisés pour mémoriser vos préférences et améliorer votre expérience.