


Ideale contentlengte voor AI-zoeken
Doet het aantal woorden ertoe voor AI-citaties? Discussie over contentlengte, en hoe AmICited toont welke van je pagina's worden geciteerd.
8 min lezen
Discussion
Content Strategy
+2
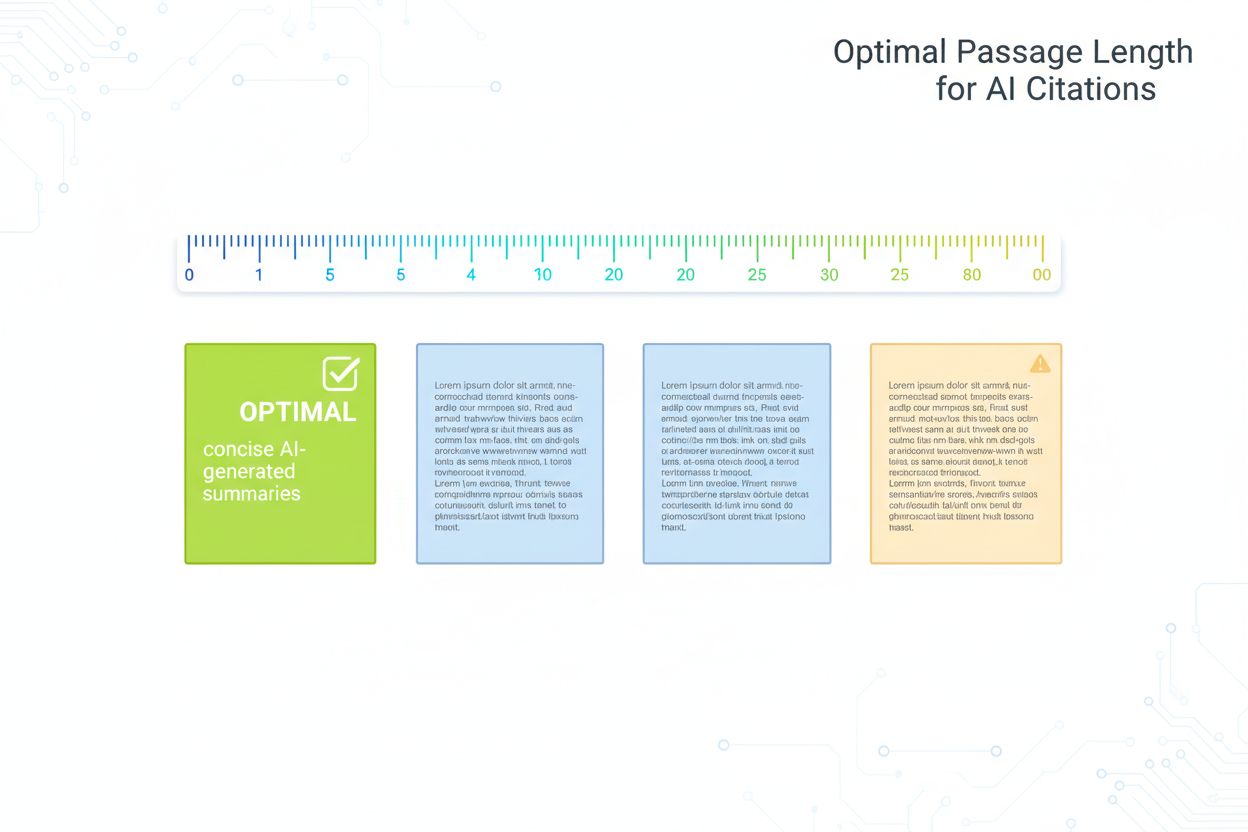
Data-onderbouwde woord-aantal-doelen voor AI-citaties per inhoudstype — FAQ, how-to, vergelijking en onderzoekscontent — plus antwoordnugget-opmaak, schema-opmaak en voor/na-voorbeelden.
Hoe lang moet een passage zijn om geciteerd te worden? Deze gids beantwoordt dat met cijfers: woord-aantal-doelen per inhoudstype, onderbouwd met citatiedata in plaats van giswerk. Het veronderstelt dat u al weet wat een ‘chunk’ is en ongeveer 0,75 woorden per token — voor de mechaniek van hoe chunking-algoritmen bepalen waar die grenzen vallen, zie onze begeleidende gids over hoe AI-content-chunking werkt. Hier ligt de focus volledig op welke lengte u moet schrijven en waarom.
Onderzoek toont consistent aan dat 53% van de content die door AI-systemen wordt geciteerd onder de 1.000 woorden valt, wat de aanname weerlegt dat langere, uitputtende content meer citaties oplevert. Deze voorkeur voor kortere content volgt uit hoe AI-modellen relevantie en extraheerbaarheid beoordelen — beknopte passages zijn eenvoudiger te parsen, contextualiseren en accuraat te citeren. Belangrijk is dat onderzoek een vrijwel nulcorrelatie tussen woordenaantal en citatiepositie aantoont: langere content scoort niet hoger in AI-citaties. Content onder de 350 woorden belandt vaker in de top drie citatieposities, wat suggereert dat beknoptheid gecombineerd met relevantie — niet diepgang omwille van de diepgang — een passage citatie-waardig maakt.
| Inhoudstype | Optimale lengte | Tokenaantal | Gebruiksscenario |
|---|---|---|---|
| Antwoordnugget | 40-80 woorden | 50-100 tokens | Directe Q&A-antwoorden |
| Featured Snippet | 75-150 woorden | 100-200 tokens | Snelle antwoorden |
| Passage Chunk | 256-512 tokens | 256-512 tokens | Semantische zoekresultaten |
| Onderwerphub | 1.000-2.000 woorden | 1.300-2.600 tokens | Uitgebreide dekking |
| Lange-content | 2.000+ woorden | 2.600+ tokens | Diepgaande analyses, gidsen |
Lengte beïnvloedt ook de citatiekwaliteit, niet alleen de frequentie. Correct geproportioneerde passages stellen AI-systemen in staat u met meer specificiteit en vertrouwen te citeren — vaak als direct citaat in plaats van een brede parafrase. Onderzoek naar passage-gebaseerde retrievale vond dat goed geproportioneerde passages 4,2x meer kans hebben op citaties met directe naamsvermelding en een bronlink, en aparte analyse van AI Overviews (die nu in ongeveer 13% van de zoekopdrachten verschijnen) toonde dat correct geproportioneerde content in 8,7% van de AI Overview-resultaten verschijnt, vergeleken met 2,1% voor slecht geproportioneerde content. Duizend vage citaties zijn minder waard dan honderd specifieke, toegeschreven citaties die daadwerkelijk verkeer genereren.
Verschillende inhoudstypen vragen om verschillende woord-aantal-doelen — en verschillende mate van contentdiepgang — dus het matchen van content aan het juiste type presteert consistent beter dan een enkel algemeen doel.
Content die deze typespecifieke doelen volgt, ziet ongeveer 3,2x meer citaties dan content die één enkel woord-aantal-doel voor elk formaat gebruikt.

Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Een antwoordnugget is een beknopte, zelfstandige samenvatting — doorgaans 40-80 woorden — die direct reageert op een specifieke vraag. Nuggets zijn het formaat dat AI-systemen het meest betrouwbaar extraheren voor citatie, omdat ze een compleet antwoord leveren zonder omringende ruis. Plaatsing is net zo belangrijk als lengte: positioneer de nugget direct na de kop of onderwerpintroductie, vóór ondersteunende details, zodat een AI-systeem eerst het antwoord tegenkomt. Hier ziet u hoe een goed gestructureerde nugget er in de praktijk uitziet:
Vraag: "Hoe lang moet webcontent zijn voor AI-citaties?"
Antwoordnugget: "Onderzoek toont aan dat 53% van AI-geciteerde content onder de 1.000 woorden valt, met optimale passages variërend van 75-150 woorden voor directe antwoorden en 256-512 tokens voor semantische chunks. Content onder de 350 woorden scoort doorgaans in de hoogste citatieposities, wat suggereert dat beknoptheid gecombineerd met relevantie de kans op AI-citatie maximaliseert."
Deze nugget is compleet, specifiek en direct bruikbaar — precies wat een AI-systeem zoekt wanneer het een citatie moet genereren in plaats van een parafrase.
JSON-LD schema-opmaak geeft AI-systemen expliciete instructies over de structuur van uw content, wat de citatiekans meetbaar verbetert. De meest impactvolle typen voor AI-optimalisatie zijn FAQ-schema voor vraag-en-antwoordcontent en HowTo-schema voor procedurele content — FAQ-schema weerspiegelt in het bijzonder hoe AI-systemen informatie al verwerken, namelijk als discrete vraag-antwoordparen. Pagina’s die de juiste schema-opmaak implementeren, hebben 3x meer kans om geciteerd te worden door AI-systemen dan ongemarkeerde content, omdat de opmaak dubbelzinnigheid over wat het antwoord vormt wegneemt.
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "@id": "https://example.com/faq#q1",
      "name": "Wat is de optimale passage-lengte voor AI-citaties?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Onderzoek toont aan dat 53% van AI-geciteerde content onder de 1.000 woorden valt, met optimale passages variërend van 75-150 woorden voor directe antwoorden en 256-512 tokens voor semantische chunks."
      }
    }
  ]
}
Het implementeren van schema-opmaak zet ongestructureerde tekst om in machineleesbare informatie, waarmee exact wordt gesignaleerd waar een antwoord zich bevindt en hoe het is georganiseerd — het koppelen van een correct geproportioneerde passage aan schema-opmaak versterkt beide effecten. Dit is precies hoe uitgevers dit op schaal in de praktijk brengen, in plaats van passages te herformatteren en structuur aan giswerk over te laten.
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
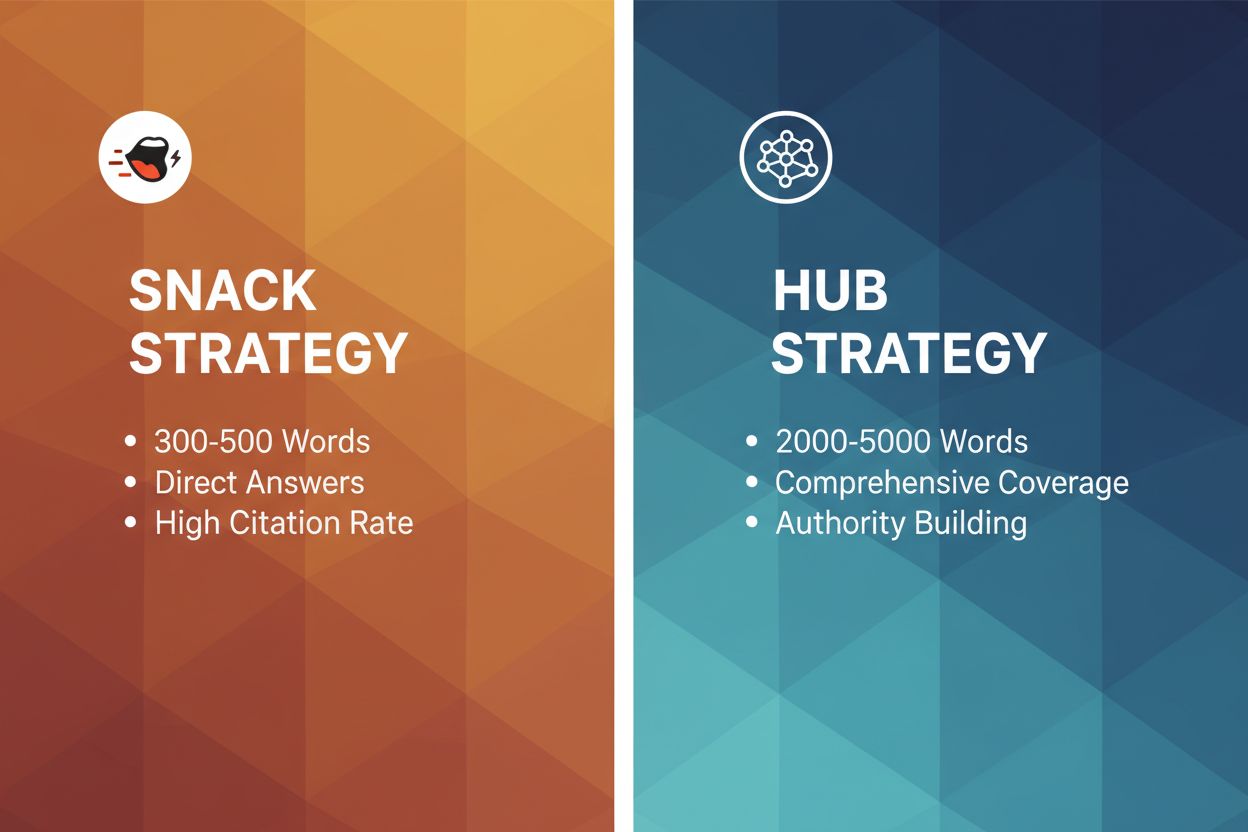
De ‘Snackstrategie’ optimaliseert voor korte, gerichte content (75-350 woorden) die een specifieke vraag direct beantwoordt. Ze blinkt uit bij eenvoudige, rechttoe-rechtaan vragen omdat ze past bij het antwoordnugget-formaat dat AI-systemen van nature extraheren. De ‘Hubstrategie’ creëert uitgebreide, lange-content (2.000+ woorden) die een complex onderwerp diepgaand verkent — waarmee thematische autoriteit wordt opgebouwd, meerdere gerelateerde vragen worden ondervangen en context wordt geboden voor meer genuanceerde vragen. Deze strategieën sluiten elkaar niet uit: de meest effectieve aanpak creëert gerichte snackcontent voor specifieke vragen en ontwikkelt vervolgens hubcontent die naar die snacks linkt en deze intern uitbreidt. Deze hybride aanpak vangt zowel directe AI-citaties (via snacks) als uitgebreide thematische autoriteit (via hubs). Zoekintentie bepaalt waarop te leunen: eenvoudige, feitelijke vragen vragen om snacks, complexe of verkennende onderwerpen vragen om hubs, en de meeste contentbibliotheken hebben beide nodig.
Lengtedoelen worden pas bruikbaar als u ze toegepast ziet. Neem een typische ‘voor’-passage — een alinea van 340 woorden die opent met bedrijfsachtergrond, door drie niet-gerelateerde punten gaat en het daadwerkelijke antwoord pas in zin zes geeft. Een AI-systeem dat die passage scant, moet moeite doen om iets citeerbaars te extraheren en zal eerder breed parafraseren dan direct citeren.
De ’na’-versie past bovenstaande doelen toe: een antwoordnugget van 68 woorden leidt met het directe antwoord, gevolgd door een ondersteunende passage van 150 woorden die slechts één idee uitbreidt, opgemaakt met FAQ-schema zodat de vraag-antwoordgrens expliciet is. Niets in de na-versie is langer dan nodig voor zijn rol — de nugget beantwoordt de vraag, de ondersteunende passage voegt context toe, en geen van beide probeert het werk van de ander te doen. Dat is de praktische versie van ‘beknoptheid gecombineerd met relevantie’: elke passage is precies zo lang als zijn functie vereist, niet langer.
Het volgen van passageprestaties betekent het monitoren van de metrics die daadwerkelijk citatiesucces aangeven. Citatieaandeel meet hoe vaak uw content verschijnt in AI-gegenereerde antwoorden; citatiepositie volgt of uw passages als eerste, tweede of later verschijnen tussen geciteerde bronnen. Tools zoals SEMrush, Ahrefs en gespecialiseerde AI-monitoringplatforms volgen nu direct AI Overview-verschijningen en citaties. Voer vervolgens A/B-testen uit: maak meerdere versies van een passage met verschillende lengtes of verschillende schema-implementaties en monitor welke versie over 30-60 dagen meer citaties genereert. Metrics die het volgen waard zijn:
Regelmatige monitoring onthult welke lengtes en formaten resoneren met AI-systemen voor uw specifieke content, zodat doelen kunnen worden verfijnd in plaats van voor altijd als vaste regel te worden toegepast.
Verschillende structuurfouten ondermijnen routinematig anderszins goed geproportioneerde content. Het antwoord begraven diep in een passage dwingt een AI-systeem om door irrelevante context te zoeken voordat het iets citeerbaars vindt — zet altijd de belangrijkste informatie voorop. Overmatige kruisverwijzingen creëren afhankelijkheid van andere secties, waardoor een passage moeilijk zelfstandig te extraheren en citeren is. Vage, niet-specifieke taal mist de precisie die AI-systemen nodig hebben voor zelfverzekerde citatie — gebruik concrete cijfers en duidelijke uitspraken in plaats van algemeenheden. Slechte sectiegrenzen laten een passage meerdere onderwerpen of onvolledige gedachten beslaan, waardoor er geen enkele AI-ophaalbare eenheid bestaat. Het overslaan van schema-opmaak verspeelt de hierboven beschreven citatiekansverbeteringen voor content die er anderszins voor in aanmerking zou komen. Een handvol kleinere fouten stapelt zich hierbij op: inconsistente terminologie tussen passages, meerdere vragen in één passage mengen, verouderde informatie laten staan, en een passage overladen met promotionele taal die de citatiewaarde vermindert. Het corrigeren van de structuurfouten — antwoorden begraven, slechte grenzen en ontbrekende schema — heeft de grootste enkele impact op citatiepercentages, vóór verdere lengteverfijning.
Yasha is een getalenteerde softwareontwikkelaar gespecialiseerd in Python, Java en machine learning. Yasha schrijft technische artikelen over AI, prompt engineering en chatbotontwikkeling.
AmICited.com laat exact zien welke passage-lengtes ChatGPT, Perplexity en Google AI Overviews uit uw content citeren, zodat u deze woord-aantal-doelen kunt valideren met uw eigen data.
Doet het aantal woorden ertoe voor AI-citaties? Discussie over contentlengte, en hoe AmICited toont welke van je pagina's worden geciteerd.
Discussie in de community over de optimale lengte en diepte van content voor AI-citaties. Echte data over wat werkt om geciteerd te worden door ChatGPT, Perplex...
Discussie in de community over de ideale contentlengte voor AI-zichtbaarheid. Echte ervaringen van contentmakers die uitgebreide en beknopte content testen voor...
Cookie Toestemming
We gebruiken cookies om uw browse-ervaring te verbeteren en ons verkeer te analyseren. See our privacy policy.