


Lungimea ideală a conținutului pentru căutarea AI
Contează numărul de cuvinte pentru citările AI? Discuție despre lungimea conținutului și cum arată AmICited ce pagini ale voastre sunt citate.
9 min citire
Discussion
Content Strategy
+2
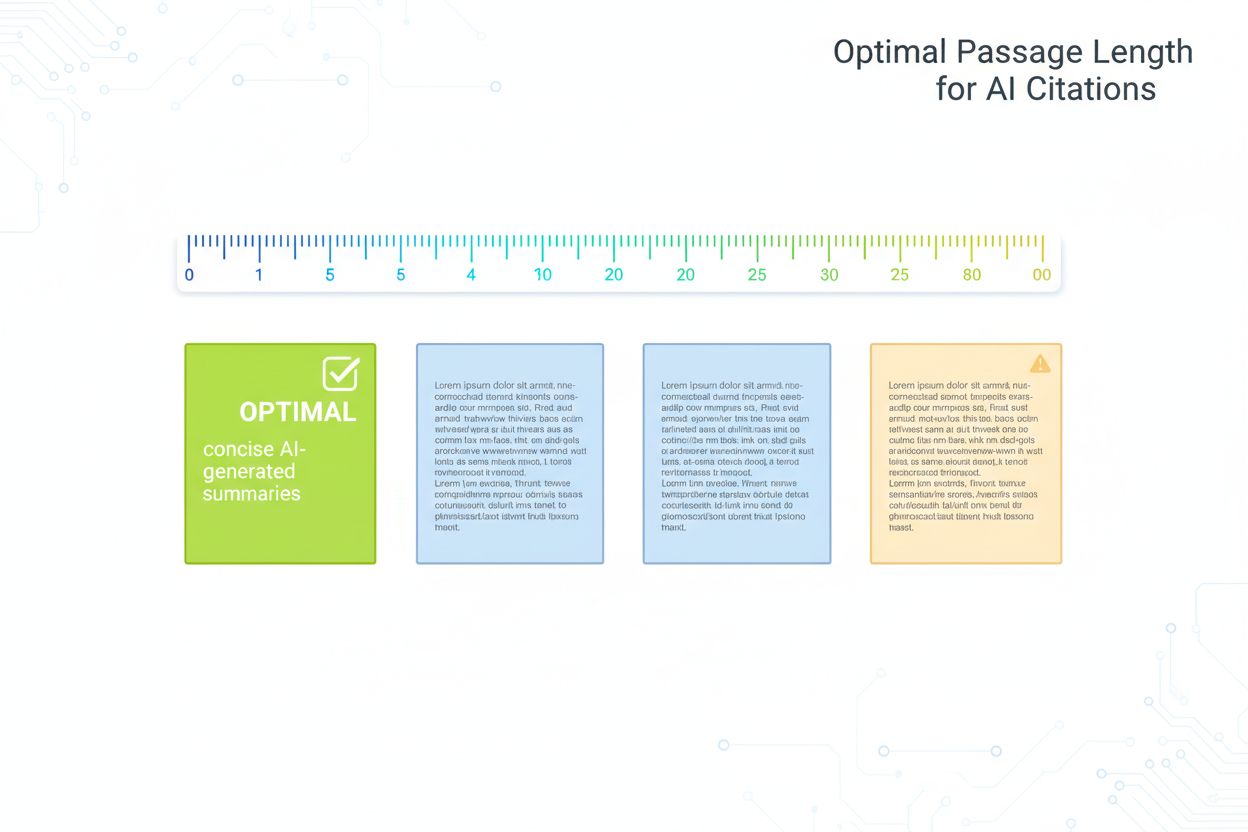
Ținte de număr de cuvinte bazate pe date pentru citări AI în funcție de tipul de conținut — FAQ, ghid, comparație și conținut de cercetare — plus formatarea nugget-urilor de răspuns, schema markup și exemple înainte/după.
Cât de lung trebuie să fie un pasaj pentru a fi citat? Acest ghid răspunde cu cifre: ținte de număr de cuvinte în funcție de tipul de conținut, susținute de date reale de citare, nu de presupuneri. Presupune că știi deja ce este un „chunk" și aproximativ 0,75 cuvinte per token — pentru mecanismele prin care algoritmii de chunking decid unde cad aceste limite, vezi ghidul nostru însoțitor despre cum funcționează chunking-ul conținutului AI. Aici, accentul este exclusiv pe ce lungime să scrii și de ce.
Cercetările arată constant că 53% din conținutul citat de sistemele AI are sub 1.000 de cuvinte, contestând presupunerea că un conținut mai lung și mai exhaustiv atrage mai multe citări. Această preferință pentru conținut mai scurt derivă din modul în care modelele AI evaluează relevanța și ușurința de extragere — pasajele concise sunt mai ușor de analizat, contextualizat și citat cu precizie. În mod critic, studiile arată o corelație aproape de zero între numărul de cuvinte și poziția de citare: conținutul mai lung nu se clasează mai sus în citările AI. Conținutul sub 350 de cuvinte tinde să ocupe primele trei poziții de citare mai frecvent, sugerând că brevilocvența combinată cu relevanța — nu profunzimea de dragul profunzimii — este ceea ce face un pasaj demn de citat.
| Tip Conținut | Lungime Optimă | Număr Tokeni | Caz de Utilizare |
|---|---|---|---|
| Nugget de Răspuns | 40-80 cuvinte | 50-100 tokeni | Răspunsuri directe Q&A |
| Featured Snippet | 75-150 cuvinte | 100-200 tokeni | Răspunsuri rapide |
| Chunk de Pasaj | 256-512 tokeni | 256-512 tokeni | Rezultate căutare semantică |
| Hub Tematic | 1.000-2.000 cuvinte | 1.300-2.600 tokeni | Acoperire cuprinzătoare |
| Conținut de Lungă Durată | 2.000+ cuvinte | 2.600+ tokeni | Analize aprofundate, ghiduri |
Lungimea afectează și calitatea citării, nu doar frecvența. Pasajele dimensionate corespunzător permit sistemelor AI să te citeze cu mai multă specificitate și încredere — adesea ca un citat direct, nu ca o parafrazare amplă. Cercetările privind regăsirea bazată pe pasaje au descoperit că pasajele bine dimensionate au de 4,2 ori mai multe șanse să primească citări care includ atribuire directă și un link către sursă, iar o analiză separată a AI Overviews (care apar acum în aproximativ 13% dintre căutări) a constatat că conținutul dimensionat corect apare în 8,7% dintre rezultatele AI Overviews, comparativ cu 2,1% pentru conținutul dimensionat necorespunzător. O mie de citări vagi valorează mai puțin decât o sută de citări specifice, atribuite, care generează trafic real.
Diferite tipuri de conținut necesită ținte diferite de număr de cuvinte — și grade diferite de profunzime a conținutului — astfel încât potrivirea conținutului cu tipul său oferă rezultate constant mai bune decât o singură țintă universală.
Conținutul care corespunde acestor ținte specifice tipului primește de aproximativ 3,2 ori mai multe citări decât conținutul care folosește o singură țintă de număr de cuvinte pentru fiecare format.

Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Un nugget de răspuns este un rezumat concis și autonom — de obicei 40-80 de cuvinte — care răspunde direct la o întrebare specifică. Nugget-urile sunt formatul pe care sistemele AI îl extrag cel mai fiabil pentru citare, deoarece oferă un răspuns complet fără zgomot înconjurător. Plasamentul contează la fel de mult ca lungimea: poziționează nugget-ul imediat după titlu sau introducerea subiectului, înainte de orice detaliu de suport, astfel încât sistemul AI să întâlnească mai întâi răspunsul. Iată cum arată un nugget bine structurat în practică:
Întrebare: „Cât de lung trebuie să fie conținutul web pentru citări AI?"
Nugget de Răspuns: „Cercetările arată că 53% din conținutul citat de AI are sub 1.000 de cuvinte, cu pasaje optime între 75-150 de cuvinte pentru răspunsuri directe și 256-512 tokeni pentru chunk-uri semantice. Conținutul sub 350 de cuvinte tinde să se claseze în primele poziții de citare, sugerând că brevilocvența combinată cu relevanța maximizează probabilitatea de citare AI."
Acest nugget este complet, specific și imediat utilizabil — exact ceea ce caută un sistem AI atunci când trebuie să genereze o citare, nu o parafrazare.
Schema markup JSON-LD oferă sistemelor AI instrucțiuni explicite despre structura conținutului tău, ceea ce îmbunătățește măsurabil probabilitatea de citare. Cele mai impactante tipuri pentru optimizarea AI sunt schema FAQ pentru conținutul de tip întrebare-răspuns și schema HowTo pentru conținut procedural — schema FAQ în special oglindește modul în care sistemele AI procesează deja informațiile, ca perechi distincte întrebare-răspuns. Paginile care implementează schema markup adecvată au de 3 ori mai multe șanse să fie citate de sistemele AI decât conținutul nemarcat, deoarece marcajul elimină ambiguitatea cu privire la ceea ce constituie răspunsul.
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "@id": "https://example.com/faq#q1",
      "name": "Care este lungimea optimă a pasajului pentru citări AI?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Cercetările arată că 53% din conținutul citat de AI are sub 1.000 de cuvinte, cu pasaje optime între 75-150 de cuvinte pentru răspunsuri directe și 256-512 tokeni pentru chunk-uri semantice."
      }
    }
  ]
}
Implementarea schema markup transformă textul nestructurat în informații care pot fi citite de mașină, semnalând exact unde există un răspuns și cum este organizat — împerecherea unui pasaj dimensionat corespunzător cu schema markup amplifică ambele efecte. Exact așa pun editorii acest lucru în practică la scară largă, mai degrabă decât să redimensioneze pasajele și să lase structura la voia întâmplării.
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
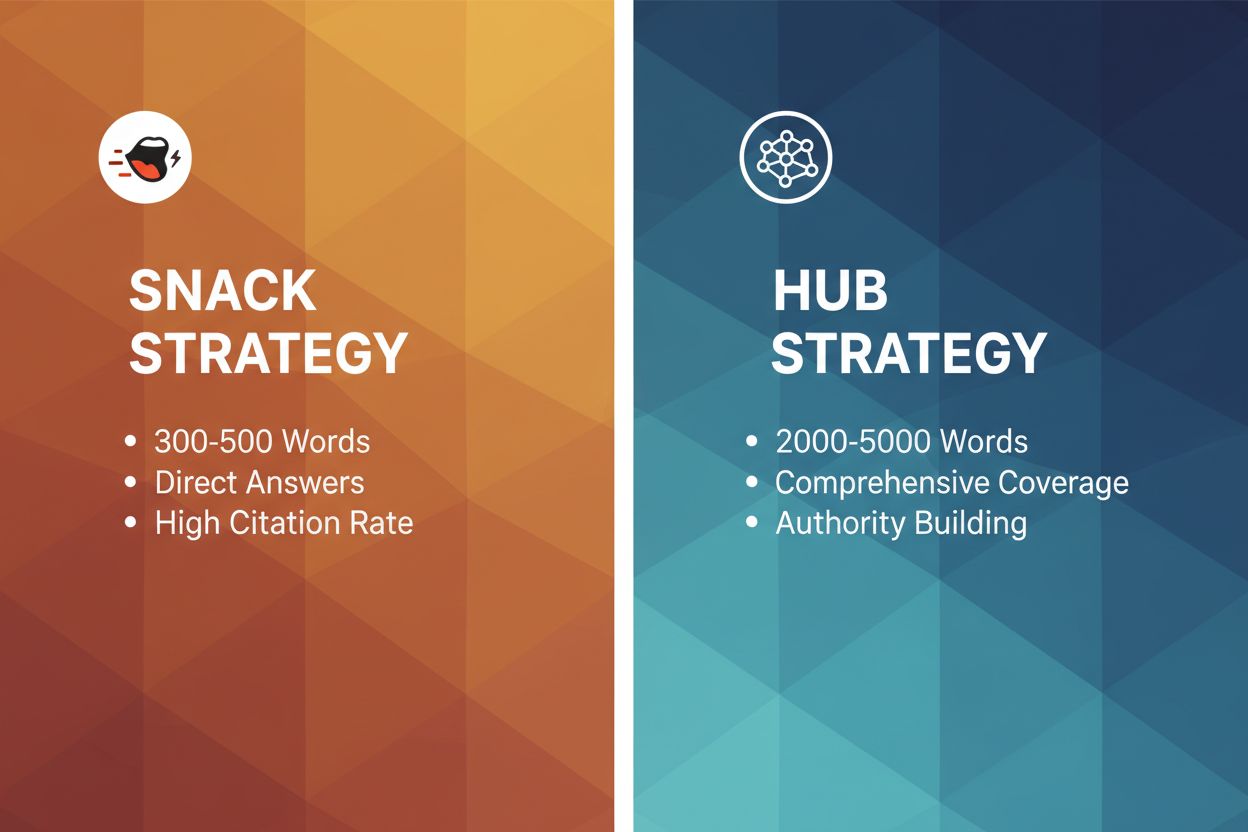
„Strategia Snack" optimizează pentru conținut scurt și focusat (75-350 de cuvinte) care răspunde direct la o întrebare specifică. Excelă la întrebări simple și directe, deoarece se potrivește formatului de nugget de răspuns pe care sistemele AI îl extrag în mod natural. „Strategia Hub" creează conținut cuprinzător de lungă durată (2.000+ cuvinte) care explorează un subiect complex în profunzime — stabilind autoritate tematică, captând întrebări multiple conexe și oferind context pentru întrebări mai nuanțate. Aceste strategii nu se exclud reciproc: cea mai eficientă abordare creează conținut snack focusat pentru întrebări specifice, apoi dezvoltă conținut hub care se leagă de și extinde acele snack-uri intern. Această abordare hibridă capturează atât citări AI directe (prin snack-uri), cât și autoritate tematică cuprinzătoare (prin hub-uri). Intenția interogării decide pe care să te bazezi: întrebările simple, factuale favorizează snack-urile, subiectele complexe sau exploratorii favorizează hub-urile, iar majoritatea bibliotecilor de conținut au nevoie de ambele.
Țintele de lungime sunt utile doar atunci când le vezi aplicate. Să luăm un pasaj tipic „înainte" — un paragraf de 340 de cuvinte care începe cu istoricul companiei, trece prin trei puncte fără legătură și îngroapă răspunsul real în fraza a șasea. Un sistem AI care scanează acest pasaj trebuie să depună efort pentru a extrage ceva citabil și este mai probabil să parafrazeze pe larg decât să citeze direct.
Versiunea „după" aplică țintele de mai sus: un nugget de răspuns de 68 de cuvinte conduce cu răspunsul direct, urmat de un pasaj de suport de 150 de cuvinte care dezvoltă o singură idee, formatat cu schema FAQ astfel încât granița întrebare-răspuns să fie explicită. Nimic în versiunea „după" nu este mai lung decât necesită rolul său — nugget-ul răspunde la întrebare, pasajul de suport adaugă context și niciunul nu încearcă să facă treaba celuilalt. Aceasta este versiunea practică a „brevilocvenței combinate cu relevanța": fiecare pasaj este exact atât de lung cât îi cere funcția, nici mai mult.
Urmărirea performanței pasajelor înseamnă monitorizarea metricilor care indică cu adevărat succesul citării. Cota de citare măsoară cât de des apare conținutul tău în răspunsurile generate de AI; poziția de citare urmărește dacă pasajele tale apar pe primul, al doilea loc sau mai târziu printre sursele citate. Instrumente precum SEMrush, Ahrefs și platforme specializate de monitorizare AI urmăresc acum direct aparițiile și citările în AI Overviews. De acolo, testează A/B: creează versiuni multiple ale unui pasaj la lungimi diferite sau cu implementări diferite de schema și monitorizează ce versiune generează mai multe citări pe parcursul a 30-60 de zile. Metrici care merită urmărite:
Monitorizarea regulată relevă ce lungimi și formate rezonează cu sistemele AI pentru conținutul tău specific, astfel încât țintele să poată fi rafinate, nu aplicate ca o regulă fixă pentru totdeauna.
Mai multe greșeli structurale subminează frecvent conținutul altfel bine dimensionat. Îngroparea răspunsului adânc într-un pasaj obligă un sistem AI să caute prin context irelevant înainte de a găsi ceva citabil — pune cele mai importante informații pe primul loc, întotdeauna. Referințele încrucișate excesive creează dependență de alte secțiuni, făcând un pasaj greu de extras și citat independent. Limbajul vag, nespecific nu are precizia de care sistemele AI au nevoie pentru o citare încrezătoare — folosește numere concrete și enunțuri clare în loc de generalități. Limitele slabe ale secțiunilor lasă un pasaj să se întindă pe mai multe subiecte sau gânduri incomplete, astfel încât nu există nicio unitate regăsibilă de AI. Omisiunea schema markup renunță la câștigurile de probabilitate de citare descrise mai sus pentru conținutul care s-ar califica altfel. Câteva greșeli mai mici se cumulează: terminologie inconsistentă între pasaje, amestecarea mai multor întrebări într-un singur pasaj, lăsarea informațiilor depășite la locul lor și supraîncărcarea unui pasaj cu limbaj promoțional care reduce valoarea sa de citare. Corectarea greșelilor structurale — îngroparea răspunsurilor, limitele slabe și schema lipsă — are cel mai mare impact unic asupra ratelor de citare, înaintea oricărei ajustări suplimentare a lungimii.
Yasha este un dezvoltator software talentat, specializat în Python, Java și învățare automată. Yasha scrie articole tehnice despre IA, ingineria prompturilor și dezvoltarea de chatboți.
AmICited.com îți arată exact ce lungimi de pasaje sunt citate de ChatGPT, Perplexity și Google AI Overviews din conținutul tău, astfel încât să poți valida aceste ținte de număr de cuvinte pe baza propriilor date.
Contează numărul de cuvinte pentru citările AI? Discuție despre lungimea conținutului și cum arată AmICited ce pagini ale voastre sunt citate.
Discuție în comunitate despre lungimea și adâncimea optimă a conținutului pentru citările AI. Date reale despre ce funcționează pentru a fi citat de ChatGPT, Pe...
Află adâncimea optimă a conținutului, structura și nivelul de detaliu necesar pentru a fi citat de ChatGPT, Perplexity și Google AI. Descoperă ce face ca un con...
Consimțământ Cookie
Folosim cookie-uri pentru a vă îmbunătăți experiența de navigare și a analiza traficul nostru. See our privacy policy.