


产品亲和力
产品亲和力衡量哪些产品倾向于被一起购买、按顺序购买或由同一类型客户购买,揭示商品目录中物品之间的隐藏关系。它用于驱动交叉销售、捆绑销售和推荐策略,这些策略基于实际购买模式而非猜测。
产品亲和力的定义
产品亲和力描述了基于客户实际购买方式的产品间可衡量关系——哪些商品出现在同一订单中、客户首次购买后接下来会买什么,以及哪些产品往往受到同一客户群体的青睐。与基于直觉的销售决策(“这些看起来应该搭配在一起”)不同,产品亲和力源自真实的交易数据,这意味着它经常能发现销售员无法预料的配对——手机壳和屏幕保护膜可能是显而易见的组合,但亲和力数据可能揭示出相当比例的手机壳购买者三周后还会购买某个特定品牌的咖啡。产品亲和力是现代电商中大多数交叉销售推荐、“经常一起购买"组件、捆绑设计以及购买后邮件流程的基础。
产品亲和力如何计算
产品亲和力通常通过三种源自市场购物篮分析的统计指标来衡量:
- 支持度 —— 两个产品一起出现的频率,占所有订单的百分比。
- 置信度 —— 给定客户购买了产品A,他们也购买产品B的概率。
- 提升度 —— 这种共同购买比两个产品各自独立购买时的预期可能性高出多少倍。提升度分数为1表示无关联;任何显著高于1的值表示真正的亲和力。
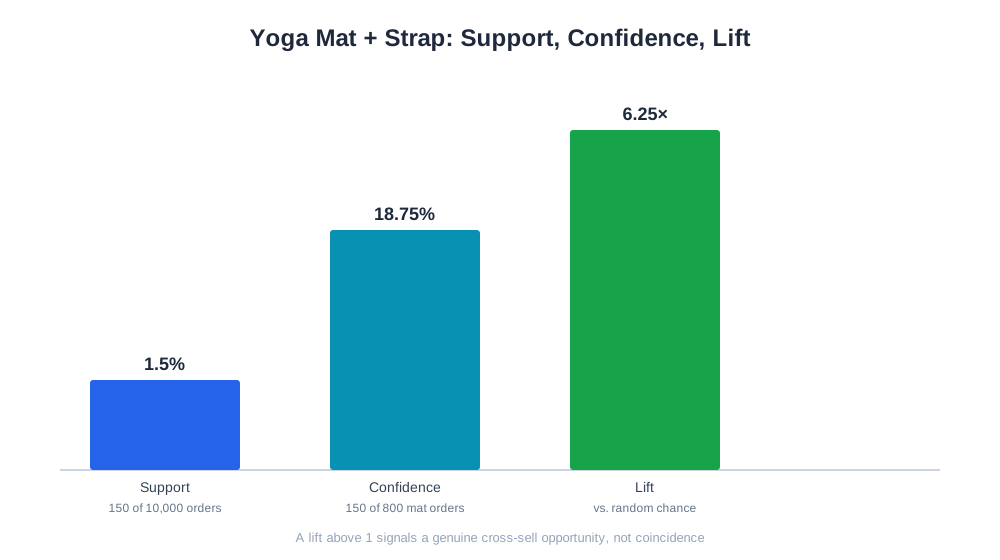
一个示例:某店铺在一个季度内销售了10,000个订单。产品A(瑜伽垫)出现在其中800个订单中。产品B(垫子绑带)总共出现在300个订单中,其中150个订单也包含瑜伽垫。
- A+B配对的支持度 = 150 / 10,000 = 1.5%
- 置信度(A → B)= 150 / 800 = 18.75%
- 独立情况下的预期共同购买率 = (800/10,000) × (300/10,000) = 0.24%
- 提升度 = 18.75% ÷ (300/10,000 × 100) ≈ 6.25倍
提升度为6.25是一个强烈信号:购买瑜伽垫的客户购买绑带的可能性比平均水平高出六倍以上,使其成为瑜伽垫产品页面和购买后邮件中的明显交叉销售候选。
为什么产品亲和力对电商品牌很重要
产品亲和力将交叉销售从猜测游戏转变为数据驱动的策略。商家无需手动决定在"你可能也喜欢"版块中展示哪些产品,而是让实际购买模式驱动这些推荐——这通常能产生比基于直觉的销售更高的附加率,因为这些配对反映了真实的客户行为,而非假设的逻辑。
亲和力数据还能改进捆绑设计。基于两个高亲和力产品(如上述瑜伽垫和绑带)构建的捆绑包的转化效果,与基于两个仅在品类上相似但实际订单中很少同时出现的产品构建的捆绑包截然不同。而且,由于亲和力可以与客户价值数据叠加,商家可以优先推广来自最有价值客户群体的配对,而不是对所有高提升度配对一视同仁。
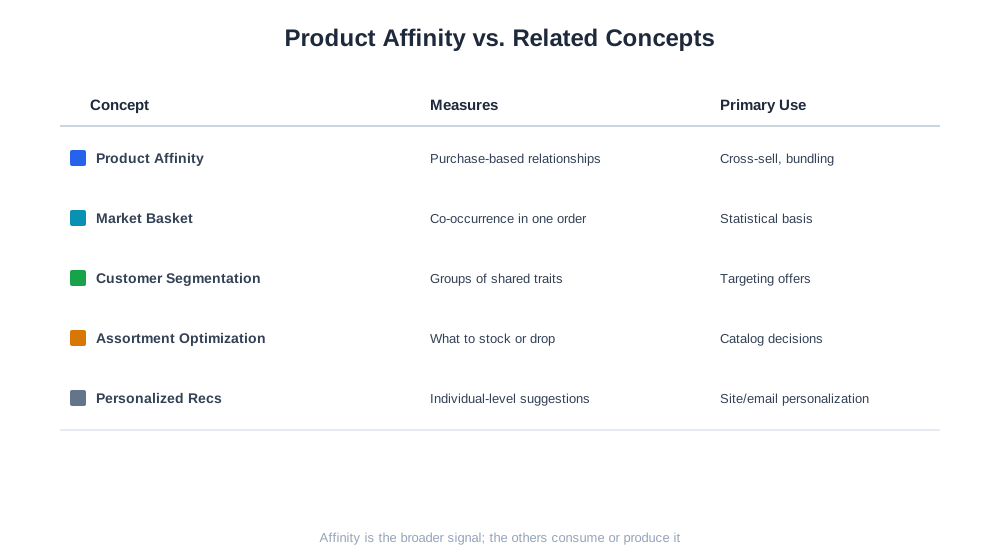
产品亲和力与相关概念对比
| 概念 | 衡量内容 | 主要用途 |
|---|---|---|
| 产品亲和力 | 基于购买行为的产品间关系 | 交叉销售、捆绑销售、推荐 |
| 市场购物篮分析 | 单笔交易中的共同出现 | 亲和力的统计基础 |
| 客户细分 | 按共享特征划分的客户群体 | 定位哪些客户看到哪些优惠 |
| 品类优化 | 应库存或停售哪些产品 | 商品目录和库存决策 |
| 个性化推荐 | 个体层面的产品建议 | 网站和邮件个性化 |

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
产品亲和力与AI驱动型电商
随着像 ChatGPT Shopping 和 Perplexity Shopping 这样的AI购物助手越来越多地回答"X配什么好"或代表客户生成多产品购物清单,拥有干净、结构良好的亲和力数据变得更加有价值——这实际上是这些助手试图从产品描述和评论中推断出的相同信号,只不过商家已经从第一手订单历史中拥有这些数据。将准确的"经常一起购买"和捆绑数据输入产品信息流,能为AI购物工具提供更有力的依据,使其推荐自家目录中的互补商品,而非替换为竞争对手的产品。
AmICited 的 eshop_get_product_affinity 工具正是围绕这一概念构建的——对于任何给定产品,它能展示购买该产品的客户的终生价值以及他们倾向于与该产品一起或之后购买的具体产品,为商家提供直接的、数据支持的答案来解决"这里应该交叉销售什么”,而无需自行构建底层的购物篮分析。
使用产品亲和力的最佳实践
- 使用提升度而非仅看共同出现次数来判断亲和力强度——如果两个产品同时出现频率高仅仅是因为它们都是畅销品,这不一定代表真正的亲和力。
- 定期刷新亲和力计算,因为新品发布、季节性变化和停产商品都会改变底层的购买模式。
- 将亲和力与客户价值数据结合,使交叉销售工作优先关注来自高价值客户群体的配对。
- 在完全替换现有的"经常一起购买"逻辑之前,先测试亲和力驱动的推荐效果——有时基于品类分类的启发式方法对于新产品仍能优于数据样本较少的亲和力模型。
- 将亲和力洞察应用于产品页面之外:购买后邮件序列和捆绑设计与网站推荐组件同样受益。
常见的产品亲和力误区
将品类相似性与真实亲和力混为一谈。 同一品类中的两个产品不一定会一起销售——事实上,同一品类内的竞争性产品通常呈现负亲和力,因为客户会选择其中一个而非两者。亲和力应基于实际共同购买数据来衡量,而非根据目录结构进行假设。
依赖过少的订单历史数据。 仅有少量订单的新上市产品可能因样本量过小的噪声而显示误导性强或弱的亲和力。品类级别的亲和力是更可靠的备选方案,直到积累足够的SKU级别数据。
忽视提升度而只看原始共同出现次数。 两个畅销品会频繁一起出现,仅仅是因为它们都被大量购买,而非存在有意义的关系。提升度通过与独立购买情况下的预期共同出现率进行比较来纠正这一问题。
目录变更后从不更新亲和力模型。 停产商品、新变体和季节性商品会改变亲和力格局,过时的模型会继续推荐不再有意义的配对,或遗漏已经出现的新配对。
对所有客户群体统一应用亲和力。 在首次购买者中表现强烈的配对可能对重复购买的高价值客户不成立,后者通常有不同的购买模式。感知客户细分的亲和力比单一混合模型能产生更相关的推荐。