


产品推荐引擎
产品推荐引擎是一种系统,它通过分析客户行为、购买历史和产品之间的关系,向购物者推荐相关商品,例如关联产品、经常一起购买的组合或个性化推荐。它通常依赖于协同过滤、基于内容的匹配或两者混合的技术。推荐引擎是电商品牌提高平均订单价值和重复购买行为最直接的手段之一。
产品推荐引擎的定义
产品推荐引擎是一种软件系统,它通过分析客户行为、购买历史以及产品之间的关系,在购物旅程的关键节点(产品页面、购物车、首页或购买后邮件)向购物者呈现相关产品建议。推荐引擎不是向每位客户展示相同的通用产品集,而是根据数据中的模式(相似客户购买了什么、哪些产品经常一起购买、或者某位购物者之前浏览或购买了什么)来定制展示内容。推荐引擎从简单的基于规则的系统(手动配置的"客户也购买了"搭配)到复杂的机器学习模型(随新交易数据的到来持续更新)不等。无论采用何种底层方法,目标都是一致的:在购物者最可能采取行动的时机,向他们展示最可能需要的产品。
产品推荐引擎的工作原理
大多数推荐引擎依赖以下一种或多种方法:
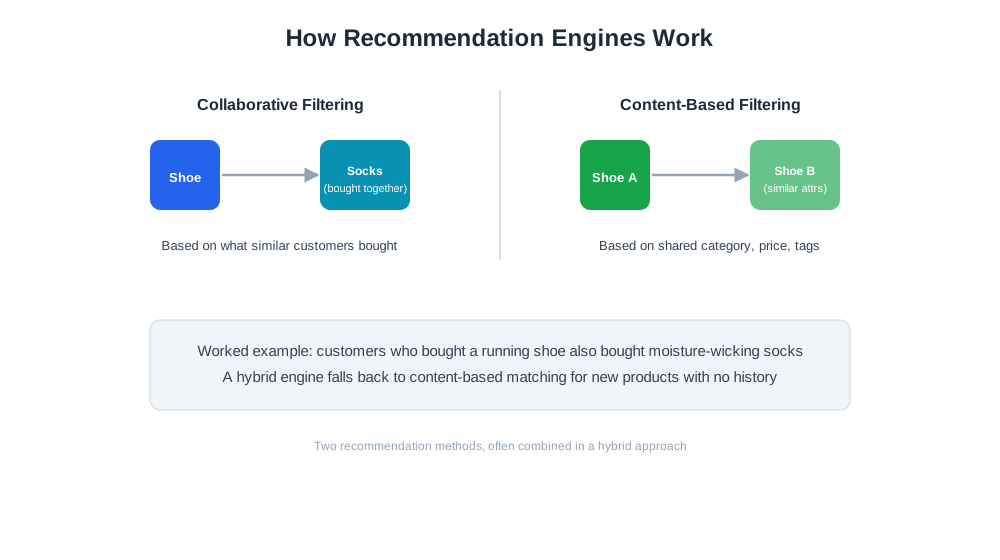
协同过滤分析众多客户行为中的模式,根据具有相似购买或浏览历史的客户所购买的产品来进行推荐。如果购买产品A的客户经常也购买产品B,那么引擎就会向刚购买了产品A的新客户推荐产品B,即使对产品的实际属性一无所知。
基于内容的过滤根据共享属性(类别、材质、价格区间、品牌或标签)推荐产品,将客户之前浏览或购买的商品与目录中相似的产品进行匹配。这种方法适用于几乎没有交易历史的新产品,因为它不依赖其他客户的行为来做出推荐。
混合方法结合了两种方式,在有足够行为数据的地方使用协同过滤,在行为模式尚未形成的新产品或小型商品目录中则退而使用基于内容的匹配。
实际案例:一位客户购买了一款特定型号的跑鞋。协同过滤引擎发现,购买该鞋的客户中有很大比例在同一订单中或之后不久也购买了某个特定品牌的吸湿排汗袜,因此引擎将袜子作为"经常一起购买"的建议呈现。而基于内容的引擎独立运作时,可能会根据共享属性在相同类别和价格区间内推荐另一双不同的跑鞋,这对于仍在比较选项而非准备结账的客户非常有用。
为什么产品推荐引擎对电商品牌至关重要
推荐引擎是商家提高平均订单价值最直接的手段之一,因为在结账或产品页面上的相关交叉销售或捆绑建议能够转化为增量收入,而这些收入在普通的浏览体验中会被完全错过。从长期来看,它们还能支持重复购买行为:购买后邮件或站内通知中的个性化补货提醒和相关产品建议,能在客户两次购买之间保持品牌的相关性,而不必完全依赖客户记得主动回来。除了直接的收入影响,推荐引擎还能改善整体购物体验,减少客户在大型商品目录中寻找相关产品所需付出的精力。随着产品数量不断增加、手动浏览对客户越来越不实用,这一点也日益重要。
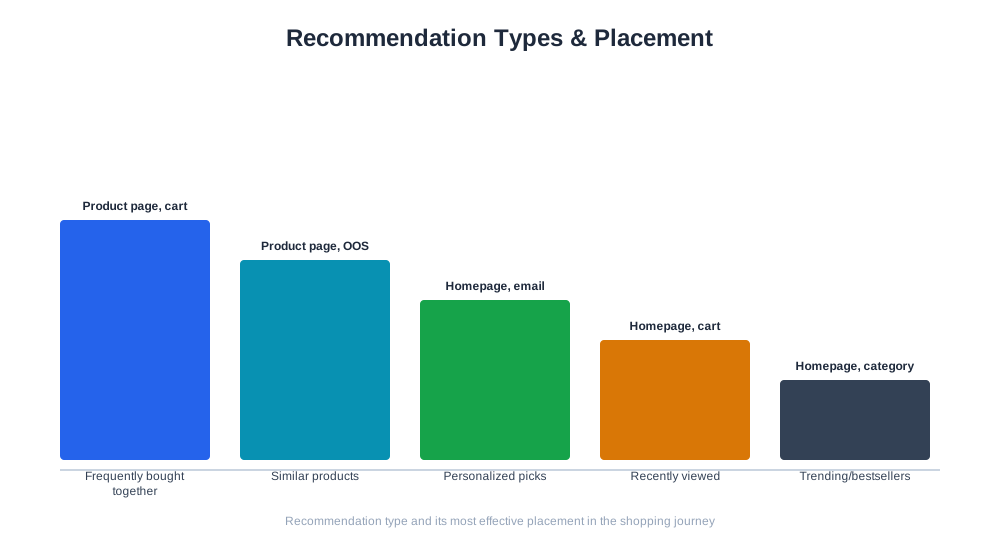
| 推荐类型 | 方法 | 最佳放置位置 |
|---|---|---|
| 经常一起购买 | 基于交易数据的协同过滤 | 产品页面、购物车 |
| 相似产品 | 基于属性的内容匹配 | 产品页面、缺货页面 |
| 个性化推荐 | 个体客户行为历史 | 首页、邮件 |
| 最近浏览 | 基于会话的浏览历史 | 首页、购物车提醒 |
| 热门/畅销品 | 聚合销售速度 | 首页、分类页面 |
产品推荐引擎与AI驱动型电商
AI购物助手(如ChatGPT Shopping、Perplexity Shopping和Amazon Rufus)实际上充当了外部推荐层的角色,在购物者到达零售商自家网站之前就向他们呈现产品建议。这提高了站内推荐引擎的标准:它必须至少与AI助手给出的推荐同等相关和个性化,否则零售商就有可能将交叉销售和追加销售的机会拱手让给AI界面推荐的其他产品。AmICited的 eshop_get_product_affinity 工具分析真实的交易数据,揭示哪些产品确实被一起购买、按顺序浏览或被重叠的客户群体购买,为商家提供基于数据的推荐逻辑基础,而非依赖人工猜测哪些产品搭配合理。这种基于真实数据的亲和度分析还能帮助商家确保其产品源数据和结构化信息与实际购买模式一致,这一点随着AI购物界面越来越多地直接从商家目录中摄取产品关系数据而变得愈发重要。

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
产品推荐引擎的最佳实践
- 基于真实交易数据建立推荐逻辑,而非凭假设判断哪些产品应该搭配
- 在推荐最有可能影响决策的时刻放置推荐:产品页面、购物车和购买后环节
- 测试不同类型的推荐(经常一起购买 vs. 个性化推荐),而非假定一种格式适用于所有场景
- 定期更新推荐数据,因为产品亲和度和客户行为会随着季节性和目录变化而改变
- 避免仅仅因为符合某种模式就推荐缺货或低利润产品,因为不相关的推荐会削弱用户对推荐功能的信任
- 通过受控的A/B测试衡量对转化率和平均订单价值的影响,而非仅凭假设认为产生了提升效果
常见的产品推荐引擎错误
在没有足够交易数据支撑的情况下推出推荐引擎。 协同过滤需要有意义的购买历史数据量才能找到可靠模式;商品目录小或流量低的店铺从简单的、手动策划的搭配中获得的收益往往比使用数据不足的机器学习模型更大。完全按热度而非相关性推荐产品。 无论客户在看什么,都向所有人展示相同的畅销品,这违背了个性化的目的,而且效果通常不如真正相关、基于行为的推荐。让过时数据驱动推荐。 使用上一季或重大目录变更前的数据训练的引擎可能会持续推荐不相关或已停售的产品,这对推荐功能信任度的损害比完全不提供推荐更大。一个页面堆砌过多推荐模块。 在单个页面上堆叠多个推荐轮播会让购物者不知所措,并稀释任何一个推荐的冲击力;数量较少但位置恰当、相关性明确的推荐通常优于内容杂乱的页面。不单独衡量推荐效果与整体网站转化效果。 如果不通过A/B测试来隔离推荐位带来的具体提升,很容易高估其价值,或者未能及时发现某个推荐模块已停止发挥作用而需要调优或移除。