


Produktrekommendationsmotor
En produktrekommendationsmotor är ett system som analyserar kundbeteende, köphistorik och produktrelationer för att föreslå relevanta artiklar till shoppare, såsom relaterade produkter, ofta köpta tillsammans-paket eller personliga val. Den bygger vanligtvis på tekniker som kollaborativ filtrering, innehållsbaserad matchning eller en hybrid av båda. Rekommendationsmotorer är ett av de mest direkta verktygen e-handelsvarumärken har för att öka genomsnittligt ordervärde och återkommande köpbeteende.
Definition av produktrekommendationsmotor
En produktrekommendationsmotor är ett mjukvarusystem som analyserar kundbeteende, köphistorik och produktrelationer för att visa relevanta produktförslag för shoppare vid viktiga tillfällen i deras resa – på produktsidor, i kundvagnen, på hemsidan eller i e-postmeddelanden efter köp. Istället för att visa varje kund samma generiska uppsättning produkter, skräddarsyr en rekommendationsmotor vad som visas baserat på mönster i datan: vad liknande kunder har köpt, vilka produkter som ofta köps tillsammans, eller vad en specifik shoppare tidigare har tittat på eller köpt. Rekommendationsmotorer sträcker sig från enkla regelbaserade system (manuellt konfigurerade “kunder köpte även”-par) till sofistikerade maskininlärningsmodeller som kontinuerligt uppdateras i takt med att nya transaktionsdata kommer in. Oavsett underliggande metod är målet detsamma: visa den produkt en shoppare med störst sannolikhet vill ha härnäst, i det ögonblick de är mest benägna att agera på det.
Så här fungerar produktrekommendationsmotorer
De flesta rekommendationsmotorer bygger på en eller en kombination av följande metoder:
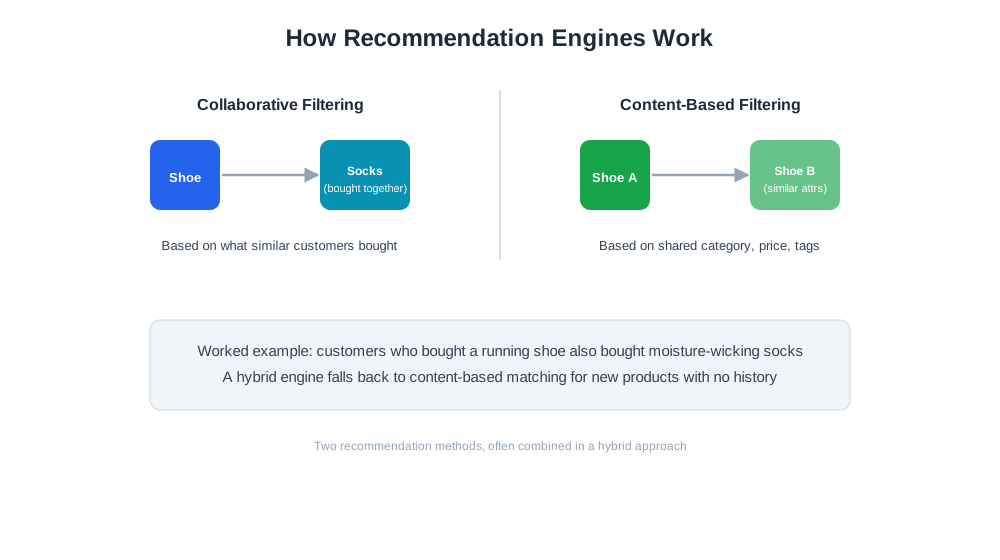
Kollaborativ filtrering tittar på mönster i många kunders beteende och rekommenderar produkter baserat på vad kunder med liknande köp- eller surfhistorik har köpt. Om kunder som köpte Produkt A ofta även köpte Produkt B, kommer motorn att rekommendera B till en ny kund som precis köpt A, även utan att veta något om produkternas faktiska attribut.
Innehållsbaserad filtrering rekommenderar produkter baserat på gemensamma attribut – kategori, material, prisklass, varumärke eller taggar – och matchar en kunds tidigare visade eller köpta artiklar mot liknande produkter i katalogen. Denna metod fungerar bra för nya produkter med lite transaktionshistorik, eftersom den inte förlitar sig på andra kunders beteende för att göra en rekommendation.
Hybridmetoder kombinerar båda metoderna, med kollaborativ filtrering där det finns tillräckligt med beteendedata och innehållsbaserad matchning som fallback för nyare produkter eller mindre kataloger där beteendemönster ännu inte har uppstått.
Praktiskt exempel: en kund köper en specifik modell av löparskor. En kollaborativ filtreringsmotor noterar att en stor andel kunder som köpt den skon även köpte ett särskilt märke av fuktavledande strumpor inom samma order eller strax därefter, så den visar strumporna som ett “ofta köpta tillsammans”-förslag. En innehållsbaserad motor, som arbetar oberoende, kan separat rekommendera ett annat par löparskor i samma kategori och prisklass baserat på gemensamma attribut – användbart för kunder som fortfarande jämför alternativ snarare än är redo att betala.
Varför produktrekommendationsmotorer är viktiga för e-handelsvarumärken
Rekommendationsmotorer är ett av de mest direkta verktygen en handlare har för att öka genomsnittligt ordervärde, eftersom ett relevant korsförsäljnings- eller paketförslag vid kassan eller på en produktsida omvandlar inkrementella intäkter som en generisk surfupplevelse helt skulle ha missat. De stödjer också återkommande köpbeteende över längre tid: personliga påminnelser om återbeställning och relaterade produktförslag i e-postmeddelanden efter köp eller notiser på webbplatsen håller ett varumärke relevant för kunden mellan köpen, istället för att helt förlita sig på att kunden själv kommer ihåg att komma tillbaka. Utöver den direkta intäktspåverkan förbättrar rekommendationsmotorer den övergripande shoppingupplevelsen genom att minska ansträngningen som krävs för att hitta relevanta produkter i en stor katalog, vilket blir allt viktigare i takt med att produktantalet växer och manuellt bläddrande blir mindre praktiskt för kunderna.
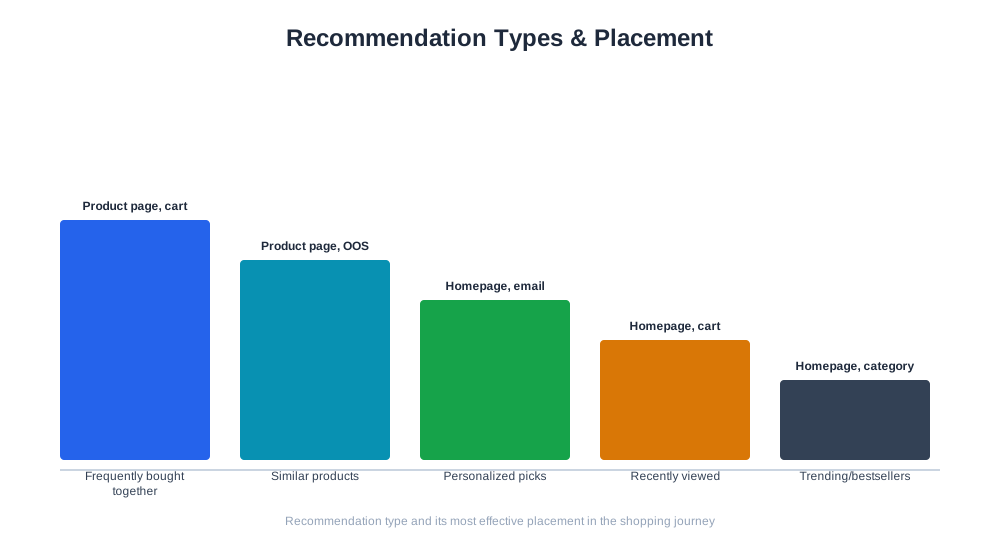
| Rekommendationstyp | Metod | Bästa placering |
|---|---|---|
| Ofta köpta tillsammans | Kollaborativ filtrering på transaktionsdata | Produktsida, kundvagn |
| Liknande produkter | Innehållsbaserad matchning på attribut | Produktsida, slut-i-lager-sida |
| Personliga val | Individuell kundbeteendehistorik | Hemsida, e-post |
| Nyligen visade | Sessionsbaserad surfhistorik | Hemsida, kundvagnspåminnelse |
| Trendande / bästsäljare | Aggregerad försäljningshastighet | Hemsida, kategorisida |
Produktrekommendationsmotorer och AI-driven handel
AI-shoppingassistenter som ChatGPT Shopping, Perplexity Shopping och Amazon Rufus fungerar i praktiken som ett externt rekommendationslager, och visar produktförslag för shoppare redan innan de når en återförsäljares egen webbplats. Detta höjer ribban för vad en rekommendationsmotor på webbplatsen måste kunna: den måste vara minst lika relevant och personlig som vad en shoppare skulle kunna få från en AI-assistent, annars riskerar återförsäljaren att förlora korsförsäljnings- och merförsäljningsmöjligheten till vad AI-ytan rekommenderar istället. AmICiteds eshop_get_product_affinity-verktyg analyserar verkliga transaktionsdata för att visa vilka produkter som verkligen köps tillsammans, visas i sekvens eller köps av överlappande kundsegment, vilket ger handlare en databaserad grund för rekommendationslogik istället för att förlita sig på manuella gissningar om vilka produkter som passar ihop. Denna typ av förankrad affinitetsdata hjälper också handlare att säkerställa att deras produktflöden och strukturerade data är konsekventa med verkliga köpmönster, vilket blir allt viktigare i takt med att AI-shoppingytor i allt högre grad hämtar produktrelationsdata direkt från handlares kataloger.

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Bästa praxis för produktrekommendationsmotorer
- Basera rekommendationslogik på verkliga transaktionsdata, inte antaganden om vilka produkter som borde passa ihop
- Placera rekommendationer vid de tillfällen där de har störst chans att påverka ett beslut: produktsida, kundvagn och efter köp
- Testa olika rekommendationstyper (ofta köpta tillsammans vs. personliga val) istället för att anta att ett format fungerar överallt
- Uppdatera rekommendationsdata regelbundet, eftersom produktaffinitet och kundbeteende förändras med säsong och katalogförändringar
- Undvik att rekommendera slut-i-lager eller lågmarginalprodukter bara för att de passar ett mönster, eftersom irrelevanta förslag urholkar förtroendet för rekommendationsfunktionen
- Mät effekten genom kontrollerad A/B-testning av konverteringsgrad och genomsnittligt ordervärde, inte bara genom att anta att en ökning har skett
Vanliga misstag med produktrekommendationsmotorer
Att lansera en rekommendationsmotor utan tillräckligt med transaktionsdata för att stödja den. Kollaborativ filtrering behöver en meningsfull volym av köphistorik för att hitta tillförlitliga mönster; en liten katalog eller en butik med låg trafik får ofta mer värde från enkla, manuellt skapade par än från en maskininlärningsmodell som arbetar med för lite data. Att rekommendera produkter enbart baserat på popularitet snarare än relevans. Att visa samma bästsäljare för varje kund oavsett vad de faktiskt tittar på motverkar syftet med personalisering och tenderar att prestera sämre än verkligt relevanta, beteendebaserade förslag. Att låta inaktuell data styra rekommendationerna. En motor tränad på data från en tidigare säsong eller före en större katalogförändring kan fortsätta att visa irrelevanta eller utgångna produkter, vilket skadar förtroendet för rekommendationsfunktionen snabbare än att inte ha några rekommendationer alls. Att överbelasta en sida med rekommendationsblock. Att stapla flera rekommendationskaruseller på en enda sida kan överväldiga shoppare och urvattna effekten av varje enskilt förslag; ett mindre antal välplacerade, tydligt relevanta rekommendationer presterar generellt bättre än en rörig sida. Att inte mäta rekommendationernas prestanda separat från webbplatsens övergripande konvertering. Utan att genom A/B-testning isolera den specifika ökning som kan tillskrivas rekommendationsplaceringar är det lätt att antingen överskatta deras värde eller missa när ett rekommendationsblock har slutat prestera och behöver justeras eller tas bort.