


Produktanbefalingsmotor
En produktanbefalingsmotor er et system, der analyserer kundeadfærd, købshistorik og produktsammenhænge for at foreslå relevante varer til shoppere, såsom relaterede produkter, ofte købte sæt eller personlige anbefalinger. Det anvender typisk teknikker som kollaborativ filtrering, indholdsbaseret matching eller en hybrid af begge. Anbefalingsmotorer er et af de mest direkte værktøjer, e-handelsbrands har til at øge gennemsnitlig ordreværdi og gentagelseskøbsadfærd.
Definition af produktanbefalingsmotor
En produktanbefalingsmotor er et softwaresystem, der analyserer kundeadfærd, købshistorik og produktsammenhænge for at præsentere relevante produktforslag til shoppere på centrale punkter i deres shoppingrejse — på produktsider, i kurven, på forsiden eller i e-mails efter køb. I stedet for at vise alle kunder det samme generiske sæt af produkter, skræddersyer en anbefalingsmotor hvad der vises baseret på mønstre i data: hvad lignende kunder har købt, hvilke produkter der ofte købes sammen, eller hvad en bestemt shopper tidligere har set eller købt. Anbefalingsmotorer spænder fra simple regelbaserede systemer (manuelt konfigurerede “kunder købte også”-sammensætninger) til sofistikerede maskinlæringsmodeller, der løbende opdateres efterhånden som nye transaktionsdata kommer ind. Uanset hvilken underliggende metode der anvendes, er målet det samme: at præsentere det produkt, en shopper med størst sandsynlighed vil have brug for, i det øjeblik hvor de er mest tilbøjelige til at handle på det.
Sådan fungerer produktanbefalingsmotorer
De fleste anbefalingsmotorer bygger på en eller en kombination af følgende tilgange:
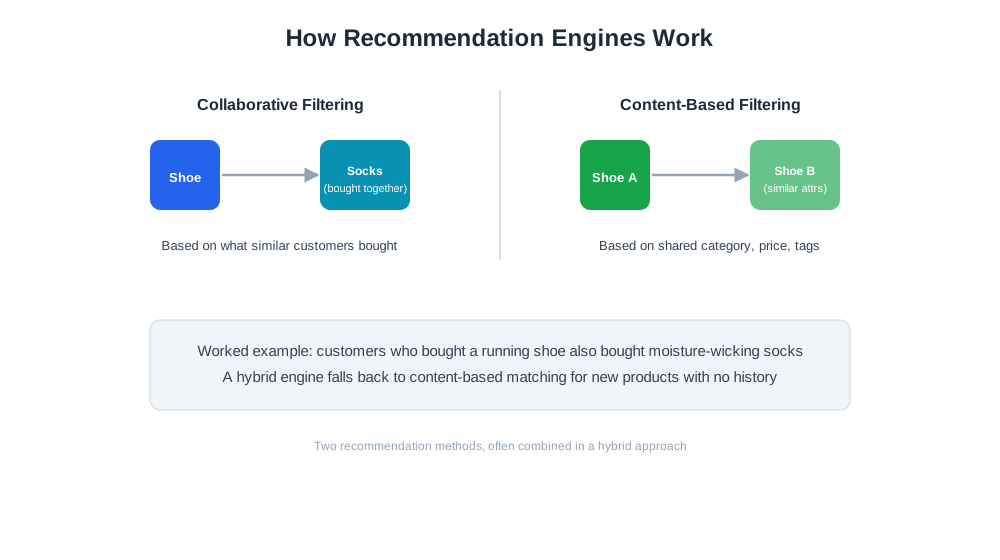
Kollaborativ filtrering ser på mønstre på tværs af mange kunders adfærd og anbefaler produkter baseret på hvad kunder med lignende købs- eller browserhistorier har købt. Hvis kunder der købte Produkt A ofte også købte Produkt B, vil motoren anbefale B til en ny kunde der lige har købt A, selv uden at kende noget til produkternes faktiske egenskaber.
Indholdsbaseret filtrering anbefaler produkter baseret på fælles egenskaber — kategori, materiale, prisklasse, mærke eller tags — og matcher en kundes tidligere sete eller købte varer med lignende produkter i kataloget. Denne tilgang fungerer godt for nye produkter med begrænset transaktionshistorik, da den ikke er afhængig af andre kunders adfærd for at give en anbefaling.
Hybride tilgange kombinerer begge metoder, ved at bruge kollaborativ filtrering hvor der er nok adfærdsdata, og falde tilbage på indholdsbaseret matching for nyere produkter eller mindre kataloger hvor adfærdsmønstre endnu ikke er opstået.
Arbejdseksempel: en kunde køber en specifik model løbesko. En kollaborativ filtreringsmotor bemærker at en stor andel af kunder der købte den sko, også købte et bestemt mærke fugttransporterende sokker i samme ordre eller kort efter, så den præsenterer sokkerne som et “ofte købt sammen”-forslag. En indholdsbaseret motor, der arbejder uafhængigt, kunne separat anbefale et andet par løbesko i samme kategori og prisklasse baseret på fælles egenskaber, nyttigt for kunder der stadig sammenligner muligheder frem for at være klar til at gå til kassen.

Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Hvorfor produktanbefalingsmotorer er vigtige for e-handelsbrands
Anbefalingsmotorer er et af de mest direkte værktøjer en forhandler har til at øge gennemsnitlig ordreværdi, da et relevant krydssalg eller bundlingsforslag ved kassen eller på en produktside konverterer yderligere omsætning, som en generisk browsingoplevelse ville have misset helt. De understøtter også gentagelseskøbsadfærd på længere sigt: personlige genbestillingspåmindelser og relaterede produktforslag i e-mails efter køb eller på sidenotifikationer holder et brand relevant for en kunde mellem køb, i stedet for udelukkende at stole på at kunden selv husker at komme tilbage. Ud over den direkte omsætningseffekt forbedrer anbefalingsmotorer den samlede shoppingoplevelse ved at reducere indsatsen der kræves for at finde relevante produkter i et stort katalog, hvilket bliver stadig vigtigere efterhånden som produktantallet vokser og manuel browsing bliver mindre praktisk for kunderne.
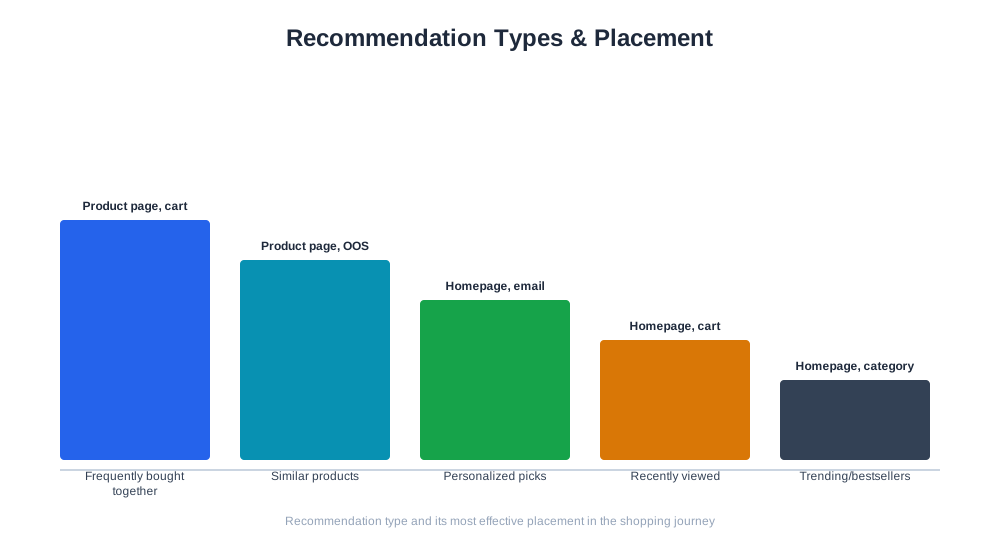
| Anbefalingstype | Metode | Bedste placering |
|---|---|---|
| Ofte købt sammen | Kollaborativ filtrering på transaktionsdata | Produktside, kurv |
| Lignende produkter | Indholdsbaseret matching på egenskaber | Produktside, udsolgt-side |
| Personlige anbefalinger | Individuel kundeadfærdshistorik | Forside, e-mail |
| For nyligt set | Sessionsbaseret browserhistorik | Forside, kurvpåmindelse |
| Trends / bestsellere | Samlet salgshastighed | Forside, kategoriside |
Produktanbefalingsmotorer og AI-drevet handel
AI-shoppingassistenter som ChatGPT Shopping, Perplexity Shopping og Amazon Rufus fungerer i praksis som et eksternt anbefalingslag, der præsenterer produktforslag til shoppere før de overhovedet når frem til en forhandlers egen hjemmeside. Dette hæver barren for hvad en on-site anbefalingsmotor skal kunne: den skal være mindst lige så relevant og personlig som hvad en shopper kunne få fra en AI-assistent, ellers risikerer forhandleren at miste krydssalgs- og opgraderingsmuligheden til hvad AI-overfladen i stedet anbefaler. AmICiteds eshop_get_product_affinity-værktøj analyserer faktiske transaktionsdata for at afdække hvilke produkter der reelt købes sammen, ses i rækkefølge, eller købes af overlappende kundesegmenter, hvilket giver forhandlere et databaseret grundlag for anbefalingslogik i stedet for at stole på manuel gætning af hvilke produkter der passer godt sammen. Denne form for forankret affinitetsdata hjælper også forhandlere med at sikre at deres produktfeeds og strukturerede data er i overensstemmelse med faktiske købsmønstre, hvilket er vigtigt efterhånden som AI-shoppingoverflader i stigende grad indhenter produktrelationsdata direkte fra forhandlernes kataloger.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Bedste praksis for produktanbefalingsmotorer
- Baser anbefalingslogik på rigtige transaktionsdata, ikke antagelser om hvilke produkter der burde passe godt sammen
- Placer anbefalinger på de tidspunkter hvor de mest sandsynligt påvirker en beslutning: produktside, kurv og efter køb
- Test forskellige anbefalingstyper (ofte købt sammen vs. personlige anbefalinger) i stedet for at antage at ét format virker overalt
- Opdater anbefalingsdata regelmæssigt, da produktaffinitet og kundeadfærd ændrer sig med sæsonudsving og katalogændringer
- Undgå at anbefale udsolgte eller lavmarginsprodukter blot fordi de passer ind i et mønster, da irrelevante forslag underminerer tilliden til anbefalingsfunktionen
- Mål effekten gennem kontrolleret A/B-testning på konverteringsrate og gennemsnitlig ordreværdi, ikke blot ved at antage at en stigning er opstået
Almindelige fejl med produktanbefalingsmotorer
At lancere en anbefalingsmotor uden nok transaktionsdata til at understøtte den. Kollaborativ filtrering har brug for en meningsfuld mængde købshistorik for at finde pålidelige mønstre; en lille katalog eller butik med lav trafik får ofte mere værdi fra simple, manuelt kuraterede sammensætninger end fra en maskinlæringsmodel der arbejder med for lidt data. At anbefale produkter udelukkende baseret på popularitet frem for relevans. At vise de samme bestsellere til alle kunder uanset hvad de rent faktisk kigger på, modvirker formålet med personalisering og har tendens til at præstere dårligere end ægte relevante, adfærdsbaserede forslag. At lade forældede data drive anbefalinger. En motor trænet på data fra en tidligere sæson eller før en større katalogændring kan blive ved med at foreslå irrelevante eller udgåede produkter, hvilket skader tilliden til anbefalingsfunktionen hurtigere end slet ikke at have anbefalinger. At overbelaste en side med anbefalingsblokke. At stable flere anbefalingskaruseller på en enkelt side kan overvælde shoppere og udvande effekten af ethvert enkelt forslag; et mindre antal velplacerede, tydeligt relevante anbefalinger klarer sig generelt bedre end en rodet side. Ikke at måle anbefalingers ydeevne separat fra den samlede sidekonvertering. Uden at isolere den specifikke stigning der kan tilskrives anbefalingsplaceringer gennem A/B-testning, er det let enten at overvurdere deres værdi eller ikke at opdage når en anbefalingsblok er holdt op med at præstere og skal justeres eller fjernes.