


Indkøbskurvanalyse
Indkøbskurvanalyse er praksissen med at undersøge, hvilke produkter kunder har tendens til at købe sammen i samme transaktion, for at afdække meningsfulde købsmønstre. Den understøtter beslutninger om produktpakker, krydssalg, butiksindretning og merchandising ved at afsløre reelle, databackede relationer mellem produkter frem for antagede.
Definition af indkøbskurvanalyse
Indkøbskurvanalyse er teknikken med at undersøge transaktionsdata for at identificere, hvilke produkter kunder har tendens til at købe sammen i samme ordre. Navnet kommer fra den fysiske indkøbskurv: I stedet for at analysere produkter isoleret set, ser indkøbskurvanalyse på det fulde indhold af hvert gennemført køb for at finde tilbagevendende samkøbsmønstre. Det er en grundlæggende teknik bag produktpakker, anbefalinger om “ofte købt sammen” og merchandising-beslutninger, fordi den erstatter gætværk om, hvilke produkter der passer godt sammen, med evidens hentet direkte fra faktisk kundeadfærd.
Sådan fungerer indkøbskurvanalyse
Indkøbskurvanalyse anvender tre centrale statistiske mål til at vurdere, om en parring mellem to produkter er meningsfuld. Support måler hvor ofte en bestemt parring optræder på tværs af alle transaktioner — hvis 50 ud af 1.000 ordrer indeholder både Produkt A og Produkt B, er supporten for den parring 5 %. Konfidens måler hvor ofte køb af Produkt A også fører til køb af Produkt B, beregnet som antallet af transaktioner, der indeholder begge, divideret med antallet af transaktioner, der indeholder Produkt A alene — hvis 200 ordrer indeholder Produkt A, og 50 af dem også indeholder Produkt B, er konfidensen 25 %. Lift måler om dette samkøb forekommer oftere, end tilfældighed alene ville tilsige, beregnet ved at sammenligne den faktiske konfidens med, hvad Produkt Bs samlede popularitet ville forudsige — en lift over 1 indikerer en ægte positiv relation, mens en lift tæt på eller under 1 indikerer, at parringen er tilfældig eller endda negativt associeret.
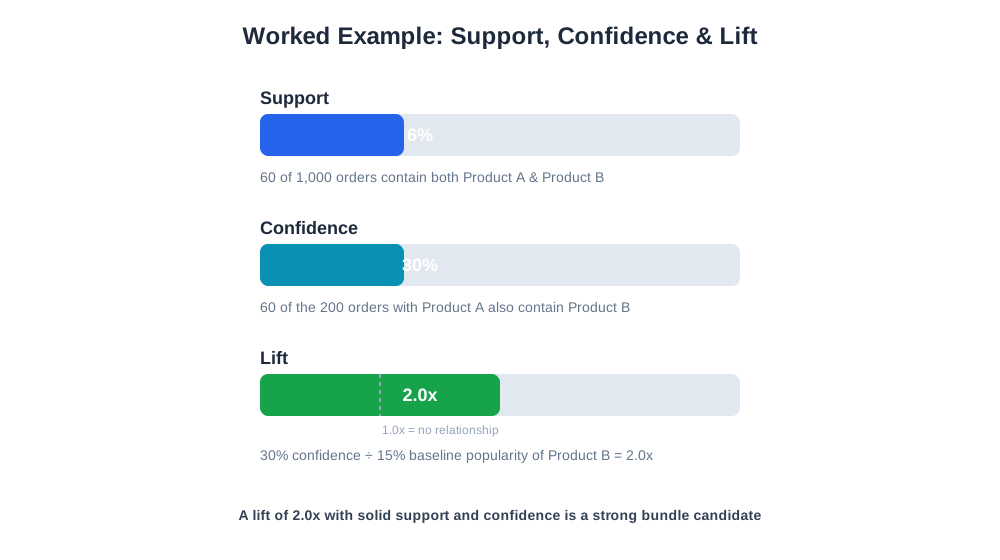
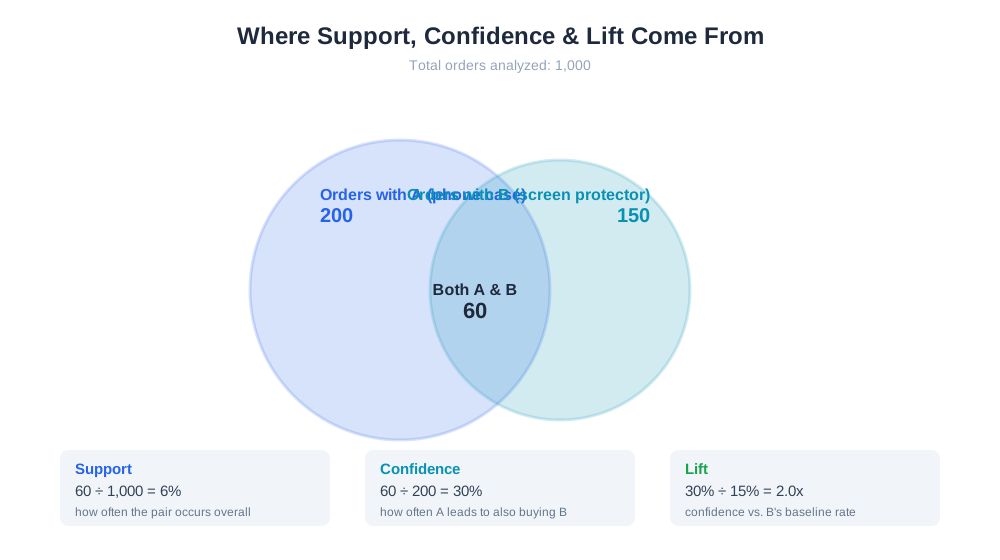
Et gennemregnet eksempel gør det konkret. Antag en butik har 1.000 ordrer i alt. Produkt A (et telefoncover) optræder i 200 af dem. Produkt B (en skærmbeskytter) optræder i 150 af dem. Af de 200 ordrer, der indeholder Produkt A, indeholder 60 også Produkt B. Support for parringen er 60 ÷ 1.000 = 6 %. Konfidens er 60 ÷ 200 = 30 %. For at beregne lift sammenlignes denne konfidens på 30 % med Produkt Bs grundlæggende popularitet på 150 ÷ 1.000 = 15 %: lift er 30 % ÷ 15 % = 2,0, hvilket betyder, at kunder, der køber Produkt A, er dobbelt så tilbøjelige til også at købe Produkt B som en tilfældig kunde ville være. En lift på 2,0 med rimelig support og konfidens er en stærk kandidat til en pakke eller krydssalgsanbefaling, da relationen både er statistisk meningsfuld og almindelig nok til at handle på.

Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Hvorfor indkøbskurvanalyse er vigtig for e-handelsmærker
Indkøbskurvanalyse er vigtig, fordi merchandising-beslutninger truffet uden den har tendens til at stole på antagelser — kategorinærhed, mavefornemmelse eller hvad der “umiddelbart” burde passe godt sammen — der ofte ikke matcher faktisk kundeadfærd. En butik kan antage, at to produkter i samme kategori naturligt sælges sammen, kun for gennem indkøbskurvanalyse at opdage, at kunderne faktisk parrer et af disse produkter med noget fra en helt anden kategori i stedet. At handle på verificerede indkøbskurvanalyseresultater frem for antagede relationer har tendens til at producere pakker og krydssalgsanbefalinger, der konverterer bedre, fordi de afspejler efterspørgselsmønstre, der allerede finder sted, snarere end mønstre, en merchandiser håber vil opstå.
| Måling | Hvad den måler | Eksempeltolkning |
|---|---|---|
| Support | Hyppigheden af parringen på tværs af alle ordrer | Lav support kan betyde for lidt data til at stole på resultatet |
| Konfidens | Sandsynlighed for at B købes, når A er købt | Høj konfidens indikerer en stærk retningsbestemt relation |
| Lift | Om parringen overgår tilfældighed | Lift tæt på 1 betyder ingen reel relation |
Indkøbskurvanalyse og AI-drevet handel
AI-shoppingassistenter som ChatGPT Shopping og Perplexity Shopping besvarer i stigende grad implicitte spørgsmål som “hvad passer til dette”, når de hjælper en shopper med at sammenligne eller gennemføre et køb, hvilket betyder, at et mærkes egne verificerede indkøbskurvanalyseresultater kan fungere som input til at opbygge præcise pakke- og anbefalingstilbud, som disse assistenter med større sandsynlighed vil gentage over for shoppere. AmICiteds eshop_get_product_bundles-værktøj kører denne analyse direkte mod en butiks faktiske ordrehistorik, fremhæver parringer scoret med support, lift og konfidens, så en forhandler kan handle på ægte stærke relationer frem for antagelser — uanset om målet er at opbygge en pakke, forbedre krydssalgsplaceringer på siden, eller blot forstå katalogets faktiske købsstruktur bedre.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Bedste praksis for indkøbskurvanalyse
- Kræv et minimumsniveau af support, før du behandler en parring som pålidelig, da parringer med lavt volumen er tilbøjelige til at indeholde støj
- Prioriter lift sammen med konfidens, da en parring med høj konfidens stadig kan være uinformativ, hvis lift er tæt på 1
- Genkør indkøbskurvanalyse periodisk, da købsmønstre ændrer sig med sæsonudsving, kampagner og katalogændringer
- Segmentér indkøbskurvanalyse efter kundetype eller kanal, hvor relevant, da nye og tilbagevendende kunder kan parre produkter forskelligt
- Brug resultaterne til at informere pakker, krydssalgsplaceringer og endda kategorisidestruktur, ikke kun kampagnetilbud
Almindelige fejl i indkøbskurvanalyse
En hyppig fejl er at handle alene på support uden at kontrollere lift, hvilket kan fremhæve parringer mellem to blot populære produkter, der ikke har nogen reel relation — to bestsellere vil forekomme sammen i et meningsfuldt antal ordrer rent tilfældigt, så lift er afgørende for at filtrere disse falske positiver fra. Et andet almindeligt problem er at køre indkøbskurvanalyse på et for lille datasæt, såsom et nyudgivet produkt med kun en håndfuld ordrer, og behandle den resulterende parring som pålidelig, når den i virkeligheden blot er et artefakt af en lille stikprøvestørrelse; fastsættelse af en minimumsordretærskel, før man stoler på et resultat, undgår dette. Nogle virksomheder lader også indkøbskurvanalyseresultater blive forældede ved at opbygge en pakke eller anbefaling for år tilbage baseret på et mønster, der ikke længere holder, efterhånden som kataloget og kundegrundlaget har udviklet sig — en periodisk genkørsel mod aktuelle data fanger denne forskydning. At behandle hver parring med høj lift som lige handlingsværdig er endnu en fejl, da en stærk statistisk relation mellem to lavmargin-, sjældent søgte produkter måske ikke er værd at bygge merchandising omkring, selvom tallene ser rene ud; indkøbskurvanalyseresultater bør afvejes mod forretningsværdi, ikke kun statistisk signifikans.