


Kurvanalyse
Kurvanalyse er praksisen med å undersøke hvilke produkter kunder har en tendens til å kjøpe sammen i samme transaksjon, for å avdekke meningsfulle kjøpsmønstre. Den underbygger beslutninger om produktpakking, kryssalg, butikkutforming og merchandising ved å avsløre reelle, databaserte sammenhenger mellom produkter i stedet for antatte.
Definisjon av kurvanalyse
Kurvanalyse er teknikken for å undersøke transaksjonsdata for å identifisere hvilke produkter kunder har en tendens til å kjøpe sammen i samme ordre. Navnet kommer fra den fysiske handlekurven: I stedet for å analysere produkter isolert, ser kurvanalyse på hele innholdet i hvert fullførte kjøp for å finne gjentatte samkjøpsmønstre. Det er en grunnleggende teknikk bak produktpakking, «ofte kjøpt sammen»-anbefalinger og merchandising-beslutninger, fordi den erstatter gjetninger om hvilke produkter som passer sammen med bevis hentet direkte fra faktisk kundeatferd.
Slik fungerer kurvanalyse
Kurvanalyse bygger på tre kjernemålinger for å vurdere om en paring mellom to produkter er meningsfull. Støtte (support) måler hvor ofte en bestemt paring forekommer på tvers av alle transaksjoner — hvis 50 av 1000 totale ordrer inneholder både produkt A og produkt B, er støtten for den paringen 5 %. Konfidens (confidence) måler hvor ofte kjøp av produkt A fører til også å kjøpe produkt B, beregnet som antall transaksjoner som inneholder begge delt på antall transaksjoner som inneholder produkt A alene — hvis 200 ordrer inneholder produkt A, og 50 av disse også inneholder produkt B, er konfidensen 25 %. Løft (lift) måler om samkjøpet forekommer oftere enn forventet ved ren tilfeldighet, beregnet ved å sammenligne den faktiske konfidensen mot hva produkt Bs totale popularitet skulle tilsi — et løft over 1 tyder på en ekte positiv relasjon, mens et løft nær eller under 1 tyder på at paringen er tilfeldig eller til og med negativt assosiert.
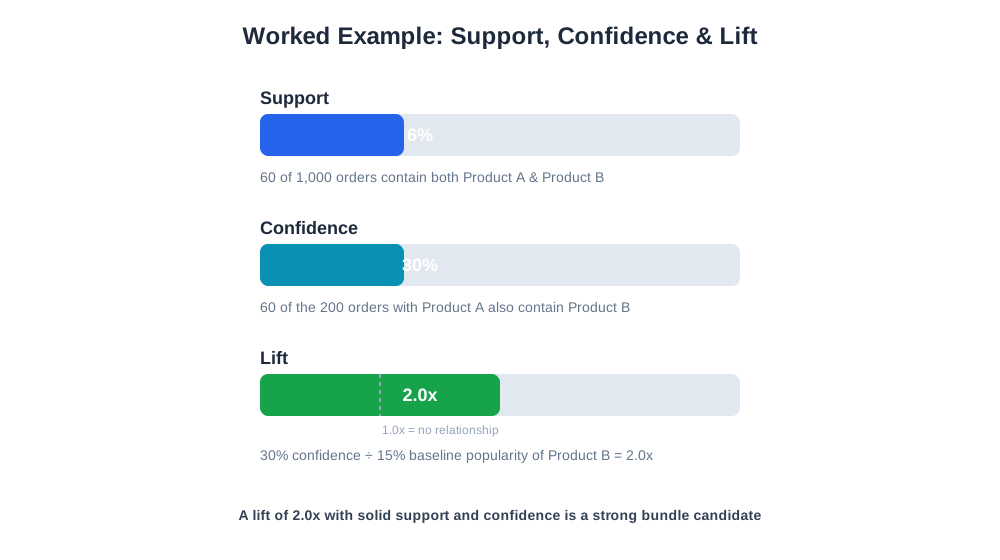
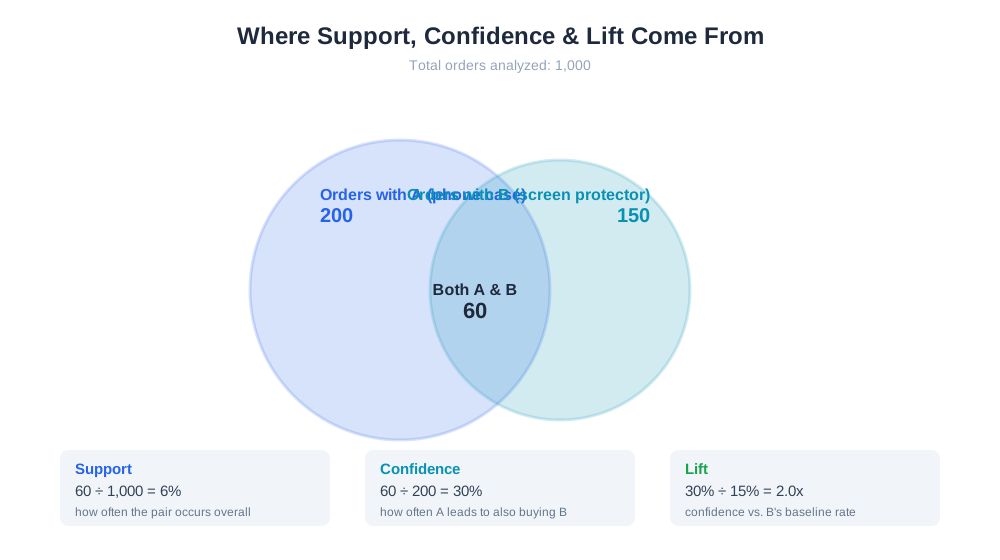
Et regneeksempel gjør dette konkret. Anta at en butikk har 1000 totale ordrer. Produkt A (et telefondeksel) forekommer i 200 av dem. Produkt B (et skjermbeskyttelse) forekommer i 150 av dem. Av de 200 ordrene som inneholder produkt A, inneholder 60 også produkt B. Støtte for paringen er 60 ÷ 1000 = 6 %. Konfidens er 60 ÷ 200 = 30 %. For å beregne løft, sammenlign den 30 % konfidensen mot produkt Bs grunnleggende popularitet på 150 ÷ 1000 = 15 %: løft er 30 % ÷ 15 % = 2,0, noe som betyr at kunder som kjøper produkt A er dobbelt så sannsynlige til også å kjøpe produkt B som en tilfeldig kunde ville vært. Et løft på 2,0 med rimelig støtte og konfidens er en sterk kandidat for en pakke eller kryssalgsanbefaling, siden relasjonen både er statistisk meningsfull og vanlig nok til å handle på.

Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Hvorfor kurvanalyse er viktig for e-handelsmerker
Kurvanalyse er viktig fordi merchandising-beslutninger tatt uten den har en tendens til å bygge på antagelser — kategorinærhet, magefølelse eller hva som «virker som» det bør passe sammen — som ofte ikke samsvarer med faktisk kundeatferd. En butikk kan anta at to produkter i samme kategori naturlig selges sammen, bare for å oppdage gjennom kurvanalyse at kundene faktisk parer ett av disse produktene med noe fra en helt annen kategori i stedet. Å handle på bekreftede kurvanalyseresultater, i stedet for antatte relasjoner, gir vanligvis pakker og kryssalgsanbefalinger som konverterer bedre, fordi de reflekterer etterspørselsmønstre som allerede skjer, snarere enn mønstre en merchandiser håper vil skje.
| Måling | Hva den måler | Eksempel på tolkning |
|---|---|---|
| Støtte (Support) | Hyppighet av paringen på tvers av alle ordrer | Lav støtte kan bety for lite data til å stole på resultatet |
| Konfidens (Confidence) | Sannsynlighet for at B kjøpes når A er kjøpt | Høy konfidens tyder på en sterk retningsbestemt relasjon |
| Løft (Lift) | Om paringen slår tilfeldighet | Løft nær 1 betyr at ingen reell relasjon eksisterer |
Kurvanalyse og AI-drevet handel
AI-baserte handleassistenter som ChatGPT Shopping og Perplexity Shopping svarer i økende grad på implisitte «hva passer med dette»-spørsmål når de hjelper en kunde med å sammenligne eller fullføre et kjøp, noe som betyr at en merkevares egne bekreftede kurvanalyseresultater kan fungere som input for å bygge nøyaktige pakke- og anbefalingstilbud som disse assistentene er mer sannsynlige til å gjenspeile tilbake til kundene. AmICiteds eshop_get_product_bundles-verktøy kjører denne analysen direkte mot en butikks faktiske ordrehistorikk, og viser paringer scoret med støtte, løft og konfidens slik at en handler kan handle på ekte sterke relasjoner i stedet for antagelser, enten målet er å bygge en pakke, forbedre kryssalgsplasseringer på nettstedet, eller rett og slett forstå katalogens faktiske kjøpsstruktur bedre.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Beste praksis for kurvanalyse
- Krev et minimumsnivå av støtte før du behandler en paring som pålitelig, siden paringer med lavt volum er utsatt for støy
- Prioriter løft sammen med konfidens, siden en paring med høy konfidens fortsatt kan være uintformativ hvis løft er nær 1
- Kjør kurvanalyse periodisk på nytt, siden kjøpsmønstre endrer seg med sesong, kampanjer og katalogendringer
- Segmenter kurvanalyse etter kundetype eller kanal der det er relevant, siden nye og tilbakevendende kunder kan pare produkter forskjellig
- Bruk resultater til å påvirke pakker, kryssalgsplasseringer og til og med kategorisidestruktur, ikke bare kampanjetilbud
Vanlige feil i kurvanalyse
En vanlig feil er å handle på støtte alene uten å sjekke løft, noe som kan fremheve paringer mellom to rett og slett populære produkter som faktisk ikke har noen reell sammenheng — to bestselgere vil forekomme sammen i et meningsfullt antall ordrer rent tilfeldig, så løft er avgjørende for å filtrere ut disse falske positive. Et annet vanlig problem er å kjøre kurvanalyse på et for lite datasett, for eksempel et nytt produkt med bare en håndfull ordrer, og behandle den resulterende paringen som pålitelig når den egentlig bare er et artefakt av lavt utvalg; å sette en minimumsordreterskel før man stoler på et resultat unngår dette. Noen bedrifter lar også kurvanalyseresultater bli utdaterte, og bygger en pakke eller anbefaling for år siden basert på et mønster som ikke lenger holder når katalogen og kundebasen har utviklet seg — en periodisk nykjøring mot nåværende data fanger opp denne endringen. Å behandle hver paring med høyt løft som like handlingsbar er en annen feil, siden en sterk statistisk sammenheng mellom to lavmarginprodukter som sjelden søkes på kanskje ikke er verdt å bygge merchandising rundt, selv om tallene ser rene ut; kurvanalyseresultater bør vurderes opp mot forretningsverdi, ikke statistisk signifikans alene.