URLs Canoniques pour la Recherche IA : Comment les Implémenter Correctement
Un guide technique pour implémenter des URLs canoniques pour la recherche IA : syntaxe HTML et en-têtes HTTP correcte, configuration inter-domaine et hreflang, les erreurs qui brisent l’attribution, et comment auditer votre implémentation.
Comment les Systèmes d’IA Regroupent les URLs Quasi Identiques
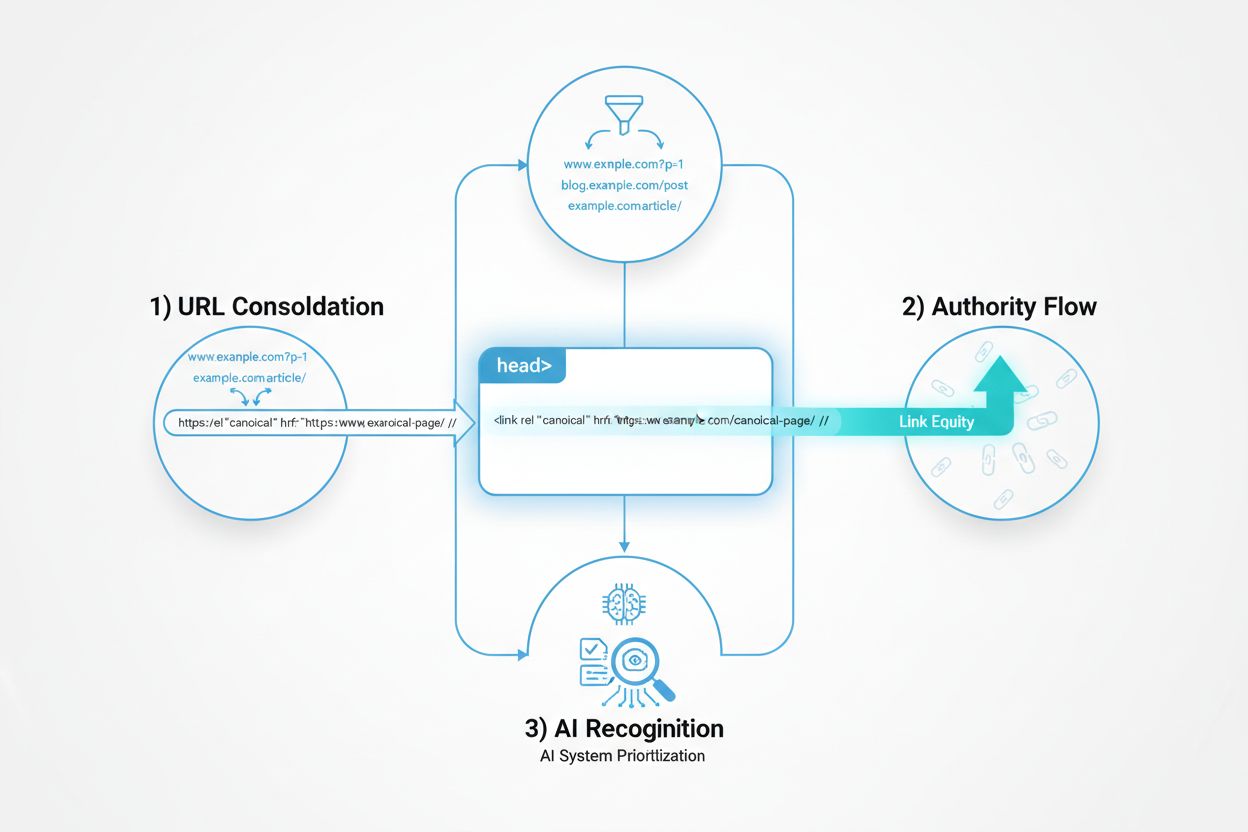
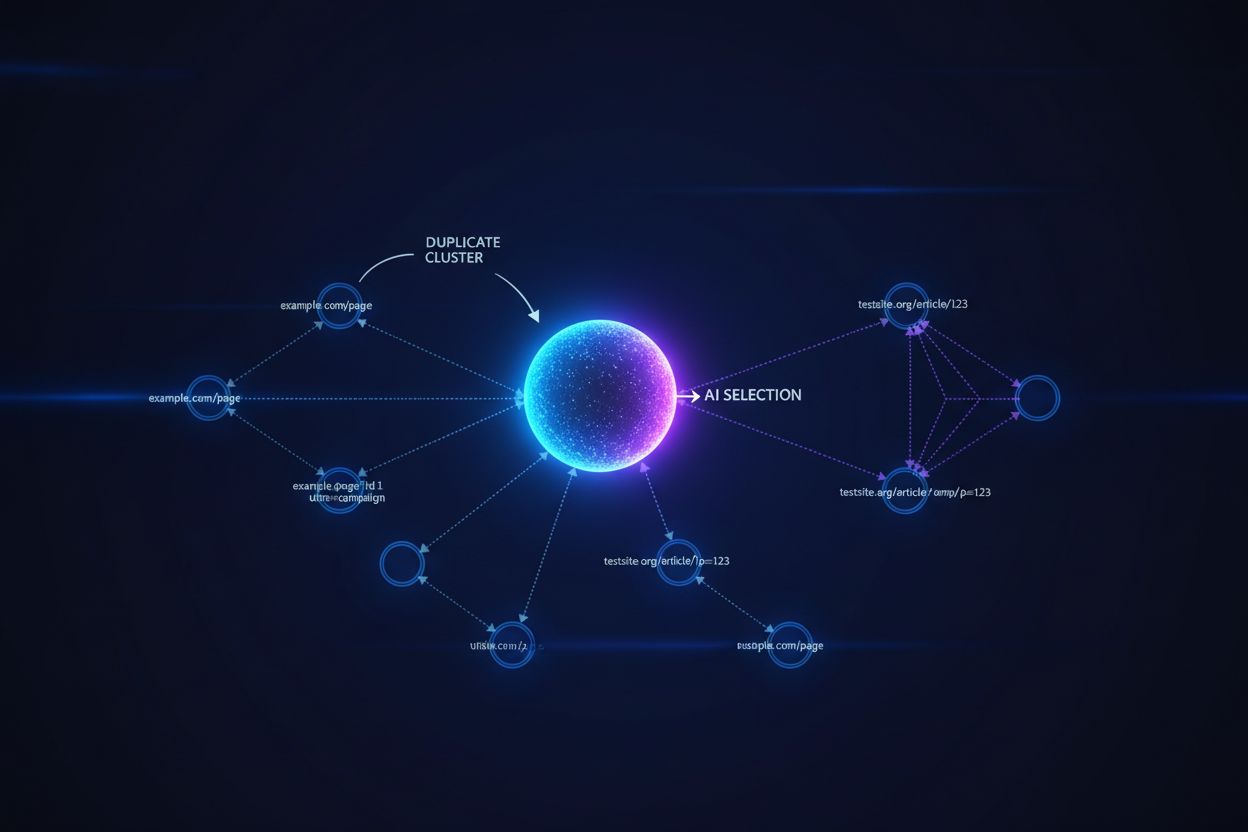
Les grands modèles de langage et les systèmes de recherche IA utilisent des algorithmes de clustering sophistiqués pour identifier et regrouper les URLs quasi identiques, traitant plusieurs versions du même contenu comme une seule entité à des fins de classement et de citation. Lorsque les systèmes d’IA rencontrent du contenu dupliqué, ils doivent sélectionner la version à prioriser — une décision qui impacte directement quelle URL reçoit la visibilité, les signaux d’autorité et l’attribution utilisateur. Le problème critique survient lorsque l’IA sélectionne la mauvaise version : si votre URL canonique pointe vers la page préférée mais que le système d’IA regroupe et classe un doublon de moindre qualité à la place, votre contenu perd en visibilité et en crédit de citation. Ce guide couvre l’aspect technique pour résoudre ce problème — syntaxe canonique correcte, configurations inter-domaines et les erreurs qui brisent silencieusement l’attribution. Si vos doublons proviennent de la syndication ou de la republication de contenu sur d’autres plateformes, les questions de stratégie de contenu sur quand et comment le faire en toute sécurité sont traitées dans notre guide complémentaire sur la gestion du contenu dupliqué pour le contenu republié.
Balises Canoniques vs Redirections vs Noindex
Les balises canoniques servent de signaux explicites aux systèmes d’IA indiquant quelle version du contenu dupliqué doit être considérée comme faisant autorité, influençant directement si votre URL préférée apparaît dans les réponses générées par l’IA et reçoit une attribution appropriée, tout en gardant chaque version accessible et explorable. Les redirections (301 pour permanente, 302 pour temporaire) sont un signal plus fort car elles consolident toute l’autorité en une seule URL et éliminent complètement le doublon du web — utilisez-les lorsque vous retirez définitivement une URL ou consolidez des domaines, pas lorsqu’une version secondaire doit encore exister. Noindex se situe à l’opposé : il supprime une page de l’indexation, elle ne peut donc jamais être sélectionnée comme version représentative, ce qui est l’outil approprié lorsqu’un doublon ne doit avoir aucune visibilité plutôt qu’une visibilité réduite.
Scénario
Balise Canonique
Redirection
Noindex
Les deux versions doivent rester accessibles
Oui — garde les URLs accessibles tout en signalant une préférence
Non — supprime l’URL secondaire
Non — la retire de l’indexation mais la laisse accessible
Consolidation d’autorité
Distribue l’autorité mais signale une préférence
Consolide entièrement l’autorité en une seule URL
Supprime la page du pool d’autorité
Idéal pour
Paramètres de suivi, URLs héritées, copies syndiquées que vous ne contrôlez pas
Déplacements permanents de domaines, pages retirées, nettoyage de paramètres
Doublons internes, versions de test, pages qui ne devraient jamais être citées
Réversibilité
Facile à modifier
Permanent, plus difficile à inverser
Facile à modifier
Différences clés à retenir : les redirections envoient les utilisateurs vers une seule URL tandis que les canoniques maintiennent les utilisateurs sur leur URL d’origine ; les redirections réduisent le gaspillage d’exploration en éliminant l’exploration des doublons tandis que les canoniques nécessitent encore l’exploration des deux versions ; et les canoniques nécessitent une implémentation HTML/en-tête tandis que les redirections nécessitent une configuration serveur.
Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Implémentation des URLs Canoniques Étape par Étape
Utilisez toujours des URLs absolues dans vos balises canoniques plutôt que des URLs relatives, afin que les systèmes d’IA et les moteurs de recherche puissent identifier sans ambiguïté l’URL cible, quel que soit l’endroit où la balise apparaît. Obtenir les URLs dans votre canonique exactement correctes — absolues, pas relatives, et pointant vers une page accessible et indexable — est le détail d’implémentation le plus courant que les équipes négligent. Incluez des canoniques auto-référencées sur vos pages préférées — même les pages sans doublons doivent se référencer elles-mêmes comme canonique, empêchant les systèmes d’IA de déduire des canoniques basées sur des modèles de liens ou la similarité de contenu. Placez les balises canoniques dans la section <head> de votre document HTML, et pour le contenu non-HTML (PDF, images), implémentez les canoniques via des en-têtes HTTP pour garantir que les robots d’exploration IA reconnaissent votre préférence quel que soit le type de contenu.
<!-- Implémentation correcte de la canonique dans le head HTML --><linkrel="canonical"href="https://example.com/article/canonical-urls-ai" />
# Implémentation via en-tête HTTP pour le contenu non-HTML (ex. PDFs)
Link: <https://example.com/whitepaper.pdf>; rel="canonical"
Incluez les URLs canoniques dans vos sitemaps XML pour renforcer quelles versions sont autoritaires. Les balises canoniques sont des signaux forts, pas des directives — les systèmes d’IA peuvent toujours ignorer votre préférence s’ils jugent qu’une version différente est plus digne de confiance en fonction de la qualité du contenu, des profils de liens ou de la fraîcheur, ce qui explique exactement pourquoi une implémentation propre et sans ambiguïté est importante.
Balises Canoniques pour le Contenu Inter-Domaine et Localisé
Les canoniques inter-domaines sont pertinentes chaque fois que le même contenu doit légitimement exister sur plus d’un domaine : un site franchisé ou partenaire qui republie votre article, une plateforme de syndication hébergeant une copie, ou un domaine régional servant une variante localisée. Pointer une canonique inter-domaine du domaine secondaire vers votre domaine préféré indique aux systèmes d’IA quelle version traiter comme faisant autorité, même lorsque les deux pages sont entièrement accessibles et indexables.
Le contenu localisé nécessite un modèle différent. Les variantes régionales (exemple.com, exemple.co.uk, exemple.de) ne sont pas de véritables doublons — ce sont des variations intentionnelles destinées à différents publics — donc une seule canonique pointant tout vers un seul domaine supprimerait des pages qui devraient légitimement être classées pour leur propre région. À la place, associez une canonique auto-référencée sur chaque page régionale avec des balises hreflang réciproques et un repli x-default :
<!-- Sur la version US (example.com/article) --><linkrel="canonical"href="https://example.com/article/canonical-urls-ai" />
<linkrel="alternate"hreflang="en-GB"href="https://example.co.uk/article/canonical-urls-ai" />
<linkrel="alternate"hreflang="de"href="https://example.de/artikel/canonical-urls-ai" />
<linkrel="alternate"hreflang="x-default"href="https://example.com/article/canonical-urls-ai" />
Chaque page régionale se canonicalise elle-même tandis que hreflang déclare la relation familiale, de sorte que les systèmes d’IA et les moteurs de recherche comprennent qu’il s’agit de variantes intentionnelles en compétition pour différentes requêtes plutôt que de doublons en compétition pour le même emplacement de cluster. L’efficacité de hreflang comme signal de clustering dans la recherche IA est encore moins établie que dans la recherche traditionnelle, donc associez-la à un contenu régional véritablement différencié (prix, terminologie, exemples) plutôt que de vous fier uniquement à la balise.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Erreurs Canoniques Courantes Qui Brisent l’Attribution IA
Les chaînes canoniques (A→B→C) sont l’erreur d’implémentation la plus fréquente — lorsque la page A canonicalise vers B, et B canonicalise vers C au lieu de pointer directement vers la destination finale, les robots d’exploration et les systèmes d’IA peuvent ne pas résoudre correctement la chaîne, laissant l’autorité bloquée sur une page intermédiaire. Canonicaliser vers une page noindex crée une contradiction : vous dites aux systèmes d’IA qu’une page est digne de confiance tout en leur disant simultanément de ne pas l’indexer, ce qui aboutit généralement à ce qu’aucune des deux pages ne soit fiable. Utiliser les canoniques pour manipuler le classement — pointer une canonique vers un contenu sans rapport pour tenter d’hériter de son autorité — ne fonctionne pas et risque la crédibilité de tout le domaine si détecté. L’absence de canoniques auto-référencées laisse les systèmes d’IA déduire la préférence canonique à partir des modèles de liens et de la similarité de contenu plutôt que d’un signal explicite, ce qui est exactement l’ambiguïté que les balises canoniques existent pour éliminer. Les URLs relatives plutôt qu’absolues dans la balise canonique peuvent être résolues incorrectement selon la façon dont la page est servie, brisant silencieusement le signal sans aucune erreur visible.
Auditer et Surveiller Votre Implémentation Canonique
Auditez votre canonique en explorant l’ensemble de votre site avec des outils comme Screaming Frog, SEMrush ou Ahrefs pour identifier les pages avec des canoniques manquantes, des chaînes canoniques brisées ou des canoniques pointant vers des pages noindex — ces problèmes empêchent les systèmes d’IA de consolider correctement l’autorité. Utilisez le rapport de couverture de Google Search Console pour identifier les pages ayant des problèmes de contenu dupliqué et vérifier que Google reconnaît vos préférences canoniques, puis recoupez avec Bing Webmaster Tools pour voir comment ces mêmes moteurs de recherche interprètent vos signaux canoniques pour les résultats propulsés par l’IA. Implémentez IndexNow pour notifier les moteurs de recherche et les robots d’exploration IA immédiatement lorsque vous ajoutez, mettez à jour ou supprimez des balises canoniques, plutôt que d’attendre les cycles d’exploration naturels — cela accélère la découverte de vos préférences canoniques et réduit le temps pendant lequel les doublons apparaissent dans les réponses IA. Enfin, surveillez les citations IA directement en utilisant des outils comme AmICited.com et des recherches manuelles dans ChatGPT, Claude et Perplexity pour vérifier que vos URLs préférées reçoivent une attribution dans les réponses générées par l’IA — si des doublons sont cités à la place, revoyez votre implémentation et confirmez que les balises sont correctement formatées, absolues et placées dans le head HTML.
Questions fréquemment posées
Une URL canonique est la version préférée d'une page que vous souhaitez voir reconnue comme faisant autorité par les moteurs de recherche et les systèmes d'IA. Elle est importante pour la recherche IA car les LLM regroupent les URLs quasi identiques et sélectionnent une version pour représenter l'ensemble. Sans une implémentation canonique correcte, les systèmes d'IA peuvent citer la mauvaise version de votre contenu, fragmentant ainsi votre visibilité et votre attribution entre plusieurs URLs.
Les systèmes d'IA utilisent des algorithmes de clustering pour regrouper les URLs quasi identiques en entités uniques, puis sélectionnent une version pour représenter l'ensemble du cluster. Cela diffère des moteurs de recherche traditionnels car les réponses IA nécessitent une seule URL source pour l'attribution. Si votre canonique n'est pas correctement implémentée, l'IA peut sélectionner une version syndiquée, une copie en cache ou une variante de moindre qualité au lieu de votre URL préférée.
Utilisez des balises canoniques lorsque vous devez conserver plusieurs URLs pour des raisons commerciales (paramètres de suivi, URLs héritées, différents publics) tout en signalant une préférence aux systèmes d'IA. Utilisez des redirections lorsque vous retirez définitivement une URL, consolidez des domaines ou éliminez des variations de paramètres qui ne servent à rien. Les redirections sont des signaux plus forts car elles consolident entièrement l'autorité, tandis que les canoniques distribuent l'autorité mais signalent une préférence.
Utilisez toujours des URLs absolues (https://exemple.com/page, pas /page), placez les balises canoniques dans la section head du HTML, incluez des canoniques auto-référencées sur toutes les pages, et évitez les chaînes canoniques (A→B→C). Pour le contenu non-HTML comme les PDF, utilisez des en-têtes HTTP. Incluez les canoniques dans votre sitemap XML et associez-les aux balises hreflang pour le contenu international.
Une balise canonique indique aux systèmes d'IA quelle version d'un contenu dupliqué traiter comme faisant autorité tout en gardant chaque version accessible et explorable. Une balise noindex supprime une page de l'indexation, elle ne peut donc jamais être sélectionnée comme version représentative. Utilisez canonique lorsque les deux versions doivent rester accessibles ; utilisez noindex lorsqu'un doublon ne doit avoir aucune visibilité.
Associez une canonique auto-référencée sur chaque page régionale avec des balises hreflang réciproques déclarant la relation entre les variantes linguistiques et régionales, plus un repli x-default. Cela indique aux systèmes d'IA que les pages sont des variantes régionales intentionnelles plutôt que des doublons en compétition pour le même emplacement de cluster, de sorte que chaque variante puisse encore être sélectionnée pour son public cible.
Oui, les balises canoniques sont des signaux forts mais pas des directives. Les systèmes d'IA peuvent ignorer votre préférence canonique s'ils déterminent qu'une version différente est plus digne de confiance en fonction de la qualité du contenu, des profils de liens, de la fraîcheur ou d'autres signaux. C'est pourquoi une implémentation correcte combinée à un contenu solide et des signaux d'autorité est importante — cela augmente la probabilité que les systèmes d'IA respectent votre préférence canonique.
Utilisez Google Search Console et Bing Webmaster Tools pour vérifier la reconnaissance canonique, surveillez les citations IA via AmICited.com et des recherches manuelles dans ChatGPT/Claude/Perplexity, et auditez votre site avec des outils d'exploration comme Screaming Frog ou SEMrush. Si des doublons sont cités au lieu de votre canonique, revoyez votre implémentation et assurez-vous que les balises sont correctement formatées et placées dans le head HTML.
Yasha est un développeur logiciel talentueux spécialisé en Python, Java et apprentissage automatique. Yasha rédige des articles techniques sur l'IA, l'ingénierie de prompts et le développement de chatbots.
Yasha Boroumand
CTO, FlowHunt
Surveillez Vos Citations IA avec AmICited
Suivez comment les systèmes d'IA comme ChatGPT, Claude et Perplexity citent votre contenu. Assurez-vous que vos URLs canoniques sont correctement reconnues et que votre marque reçoit une attribution appropriée dans les réponses générées par l'IA.
Stratégie Canonique pour la Recherche IA : Optimisez Votre Contenu pour les Moteurs d'IA
Apprenez comment les balises canoniques aident votre contenu à se classer dans les moteurs de recherche IA. Découvrez les bonnes pratiques de stratégie canoniqu...
Découvrez ce qu'est une URL canonique, comment elle prévient les problèmes de contenu dupliqué et pourquoi elle est essentielle pour le SEO. Comprenez les balis...
Comment les moteurs de recherche IA gèrent-ils le contenu dupliqué ? Est-ce différent de Google ?
Discussion communautaire sur la manière dont les systèmes d'IA traitent le contenu dupliqué différemment des moteurs de recherche traditionnels. Les professionn...
8 min de lecture
Discussion
Technical SEO
+1
Consentement aux Cookies Nous utilisons des cookies pour améliorer votre expérience de navigation et analyser notre trafic. See our privacy policy.
Ces cookies sont nécessaires pour le fonctionnement du site web et ne peuvent pas être désactivés.
Cookies d'Analyse
Ces cookies nous aident à comprendre comment les visiteurs interagissent avec notre site web.
Cookies Marketing
Ces cookies sont utilisés pour mesurer l'efficacité de nos campagnes publicitaires et pour soutenir une publicité pertinente sur des plateformes tierces.
Cookies Fonctionnels
Ces cookies sont utilisés pour mémoriser vos préférences et améliorer votre expérience.