La correspondance sémantique de requêtes est une technique basée sur l’IA qui comprend l’intention et la signification des requêtes de recherche, fournissant des résultats pertinents même lorsque les mots-clés exacts ne correspondent pas. Elle utilise le traitement du langage naturel et l’apprentissage automatique pour interpréter le contexte, les synonymes et les relations entre les concepts, permettant des expériences de recherche plus précises et intuitives dans les systèmes d’IA comme GPT, Perplexity et Google AI Overviews.
Correspondance sémantique de requêtes
La correspondance sémantique de requêtes est une technique basée sur l'IA qui comprend l'intention et la signification des requêtes de recherche, fournissant des résultats pertinents même lorsque les mots-clés exacts ne correspondent pas. Elle utilise le traitement du langage naturel et l'apprentissage automatique pour interpréter le contexte, les synonymes et les relations entre les concepts, permettant des expériences de recherche plus précises et intuitives dans les systèmes d'IA comme GPT, Perplexity et Google AI Overviews.
Comprendre la correspondance sémantique de requêtes
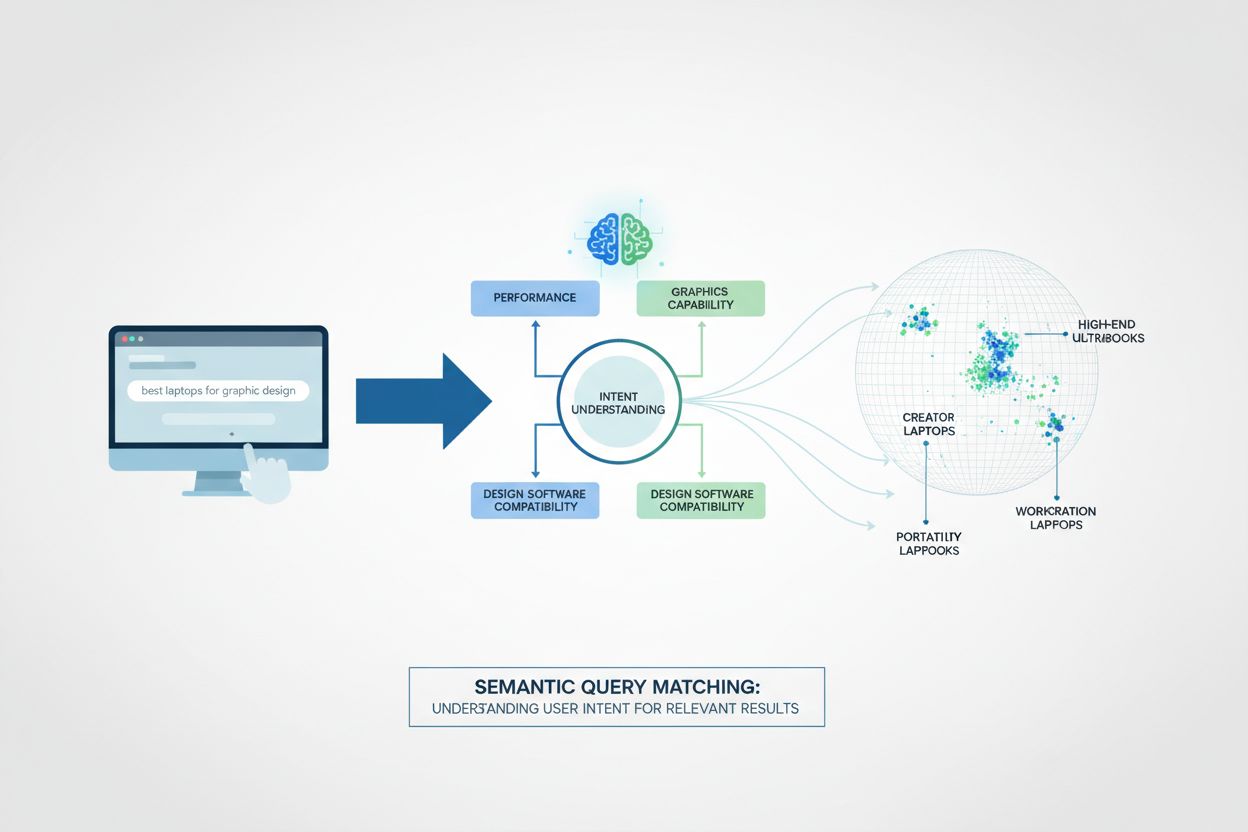
La correspondance sémantique de requêtes est une technologie de recherche sophistiquée qui comprend le sens et l’intention derrière les requêtes des utilisateurs plutôt que de simplement faire correspondre des mots-clés individuels. Contrairement à la correspondance par mots-clés traditionnelle, qui recherche des correspondances exactes de mots ou des variations simples, la correspondance sémantique de requêtes analyse le sens contextuel des termes de recherche pour fournir des résultats plus pertinents. Par exemple, un système sémantique reconnaîtrait que « Comment réparer l’écran cassé de mon téléphone ? » et « L’écran de mon appareil est fissuré » sont essentiellement la même requête, bien qu’ils utilisent des mots complètement différents, alors qu’un système basé sur des mots-clés les traiterait comme des recherches distinctes.
Comment fonctionne la correspondance sémantique de requêtes
La correspondance sémantique de requêtes fonctionne grâce à un processus technique multicouche qui transforme à la fois les requêtes et les documents en représentations mathématiques appelées embeddings. Le système traite d’abord le langage naturel via des algorithmes de NLP pour extraire le sens, puis convertit cette compréhension en vecteurs multidimensionnels qui capturent les relations sémantiques. Un mécanisme de calcul de similarité compare le vecteur de la requête aux vecteurs des documents pour classer les résultats par pertinence plutôt que par fréquence de mots-clés. Cette approche permet au système de comprendre les synonymes, le contexte et l’intention de l’utilisateur sans programmation explicite pour chaque variation.
Aspect
Recherche par mots-clés traditionnelle
Correspondance sémantique de requêtes
Méthode de correspondance
Correspondance exacte ou partielle de mots
Score de similarité basé sur le sens
Compréhension de l’intention
Limitée ; repose sur la présence de mots-clés
Analyse contextuelle approfondie de l’intention utilisateur
Gestion des synonymes
Nécessite des listes de synonymes manuelles
Reconnaît automatiquement les équivalents sémantiques
Conscience contextuelle
Minimale ; traite les mots indépendamment
Complète ; analyse les relations entre les termes
Capacité d’apprentissage
Statique ; ne s’améliore pas avec l’usage
Dynamique ; s’améliore grâce aux mises à jour du modèle et aux retours
Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Technologies fondamentales de la correspondance sémantique
La base technologique de la correspondance sémantique de requêtes repose sur plusieurs composants interconnectés qui travaillent de concert :
Traitement du langage naturel (NLP) : Décompose le langage humain en composants analysables, extrayant la structure grammaticale, les entités et les relations sémantiques
Modèles d’apprentissage automatique : Des modèles avancés comme BERT et GPT comprennent les nuances linguistiques, le contexte et le sens à grande échelle
Embeddings vectoriels : Convertissent le texte en représentations numériques où la similarité sémantique se traduit par une proximité géométrique dans l’espace vectoriel
Graphes de connaissances : Bases de données structurées qui cartographient les relations entre concepts, entités et idées pour améliorer la compréhension contextuelle
Moteurs d’analyse contextuelle : Évaluent les informations environnantes pour lever les ambiguïtés et résoudre les références dans les requêtes
Applications concrètes dans tous les secteurs
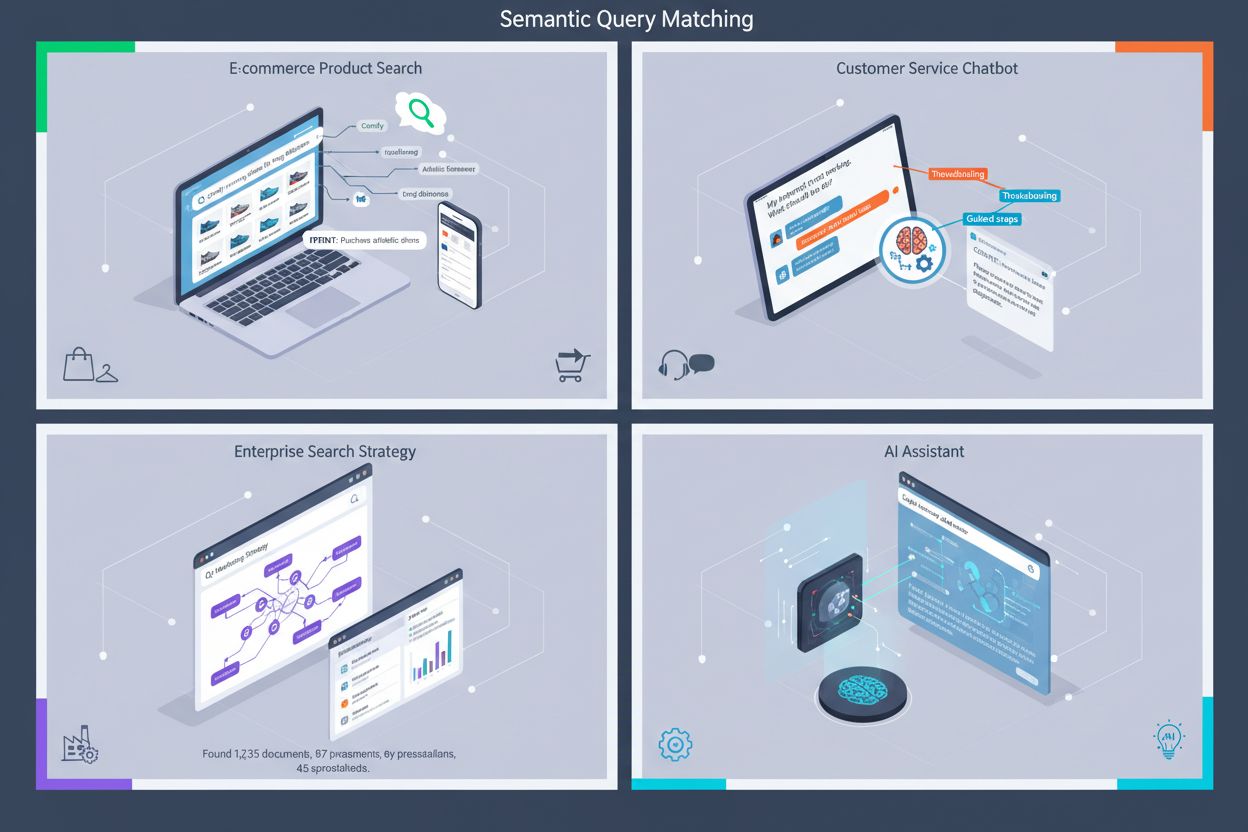
La correspondance sémantique de requêtes est devenue indispensable dans de nombreux secteurs et applications. Dans le commerce électronique, elle aide les clients à trouver des produits en utilisant des descriptions en langage naturel plutôt que des noms de produits exacts — rechercher « chaussures confortables pour courir » renvoie des chaussures de sport pertinentes même sans ces mots-clés exacts. Les systèmes de support client utilisent la correspondance sémantique pour orienter les demandes vers les services appropriés en comprenant le problème sous-jacent plutôt que des déclencheurs par mots-clés. Les plateformes de recherche d’entreprise permettent aux employés de trouver des documents internes à l’aide de requêtes conceptuelles. Les systèmes d’IA modernes comme ChatGPT, Perplexity et Google AI Overviews s’appuient fortement sur la correspondance sémantique de requêtes pour comprendre l’intention des utilisateurs et récupérer les données d’entraînement pertinentes. Les moteurs de recommandation de contenu utilisent la correspondance sémantique pour suggérer des articles, des vidéos et des produits en fonction du sens plutôt que d’étiquettes explicites.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Principaux avantages et bénéfices
Les avantages de la correspondance sémantique de requêtes améliorent considérablement l’expérience utilisateur et l’efficacité du système. Une pertinence améliorée signifie que les utilisateurs trouvent ce qu’ils recherchent réellement du premier coup, réduisant ainsi la frustration et les itérations de recherche. La technologie excelle dans le traitement des requêtes ambiguës ou mal formulées, comprenant l’intention même lorsque les utilisateurs peinent à exprimer précisément leurs besoins. La compréhension des synonymes élimine la nécessité pour les utilisateurs de deviner la terminologie exacte — que vous recherchiez « automobile », « voiture » ou « véhicule », les systèmes sémantiques reconnaissent ces termes comme équivalents. Cette capacité génère un engagement accru car les utilisateurs découvrent un contenu plus pertinent, ce qui conduit à une plus grande satisfaction et à de meilleurs taux de conversion. L’expérience utilisateur supérieure créée par la correspondance sémantique est devenue une nécessité concurrentielle dans les produits numériques modernes.
Défis et limites
Malgré ses avantages, la correspondance sémantique de requêtes fait face à des défis techniques et pratiques importants. La complexité informatique reste substantielle ; le traitement de vecteurs multidimensionnels et le calcul de similarités sur des millions de documents nécessitent une puissance de traitement et des investissements d’infrastructure considérables. Les préoccupations relatives à la confidentialité des données surviennent parce que les systèmes sémantiques doivent traiter et analyser les requêtes des utilisateurs en détail, soulevant des questions sur la conservation et la sécurité des données. L’entraînement des modèles exige de grands ensembles de données de haute qualité et des ressources informatiques importantes, créant des barrières pour les petites organisations. La technologie comporte un risque de mauvaise interprétation — les modèles sémantiques peuvent renvoyer avec assurance des résultats non pertinents lorsqu’ils comprennent mal le contexte ou rencontrent des requêtes hors domaine. Le classique compromis entre latence et précision signifie qu’une analyse sémantique plus sophistiquée prend plus de temps, ce qui peut dégrader les performances de recherche en temps réel.
Correspondance sémantique de requêtes dans la surveillance de marque par l’IA
AmICited.com exploite la correspondance sémantique de requêtes pour révolutionner la façon dont les marques surveillent leur présence dans le contenu et les réponses générées par l’IA. Plutôt que de simplement suivre les mentions exactes du nom de marque, la plateforme d’AmICited.com comprend l’intention et le contexte de la façon dont les systèmes d’IA référencent les marques, produits et entreprises sur ChatGPT, Perplexity, Google AI Overviews et d’autres grandes plateformes d’IA. L’approche sémantique permet la détection de références indirectes, de mentions comparatives et de citations contextuelles qu’une surveillance basée sur des mots-clés manquerait complètement. Cette compréhension approfondie offre aux marques une visibilité complète sur la façon dont les systèmes d’IA présentent leurs offres aux utilisateurs — une information cruciale pour maintenir la réputation de la marque et le positionnement sur le marché. Les capacités sémantiques d’AmICited.com fonctionnent en parfaite synergie avec des outils complémentaires comme FlowHunt.io, spécialisé dans l’optimisation des flux de travail, créant ainsi un écosystème complet pour la surveillance de l’IA et le renseignement sur les marques. En comprenant le sens sémantique derrière les réponses générées par l’IA, AmICited.com aide les marques à identifier les opportunités, à corriger les erreurs de représentation et à optimiser leur présence dans le paysage informationnel piloté par l’IA.
Erreurs courantes lors de la mise en œuvre de la correspondance sémantique de requêtes
Partir du principe que la correspondance sémantique seule est suffisante et abandonner complètement les mécanismes de repli basés sur les mots-clés. Comme indiqué dans la FAQ de cette page, la plupart des systèmes matures utilisent une approche hybride plutôt qu’une correspondance sémantique pure, car les modèles sémantiques peuvent renvoyer avec assurance des résultats non pertinents lorsqu’ils interprètent mal le contexte ou rencontrent des requêtes hors domaine. Supprimer complètement la capacité de correspondance exacte laisse sans solution de repli lorsque le modèle sémantique se trompe.
Sous-estimer le coût informatique jusqu’à ce qu’il soit en production. Le traitement de vecteurs multidimensionnels et le calcul de similarité sur de grands ensembles de documents nécessitent une infrastructure beaucoup plus importante que l’indexation par mots-clés — les équipes qui prototypent la correspondance sémantique sur un petit ensemble de données et ne budgétisent pas la courbe de coût à l’échelle de la production rencontrent souvent des problèmes de performance ou de coût après le lancement.
Considérer qu’un seul modèle d’embedding est définitivement suffisant. Étant donné que les modèles d’embedding sont entraînés sur des données et des périodes spécifiques, un modèle qui fonctionne bien au lancement peut voir sa pertinence diminuer à mesure que l’usage linguistique et le corpus de contenu sous-jacent évoluent ; ne pas prévoir de réévaluation ou de réentraînement périodiques conduit à une dégradation progressive de la qualité de correspondance qu’il est facile de manquer sans surveillance explicite.
Ignorer le compromis entre latence et précision lors de la conception plutôt qu’après l’arrivée des plaintes. Une analyse sémantique plus sophistiquée prend plus de temps à calculer, et si ce compromis n’est pas explicitement décidé en amont — en choisissant où se situer sur le spectre pour un cas d’utilisation donné — la tendance par défaut est de dériver vers une précision maximale au détriment du temps de réponse, le problème ne faisant surface qu’une fois que les utilisateurs remarquent le ralentissement.
Négliger les implications en matière de confidentialité des données liées au traitement du texte intégral des requêtes. Étant donné que les systèmes sémantiques doivent analyser le sens des requêtes en détail plutôt que de simplement faire correspondre des tokens, ils traitent intrinsèquement davantage de données brutes de l’utilisateur que les systèmes par mots-clés — les équipes qui ne définissent pas explicitement des politiques de conservation et d’anonymisation pour ces données peuvent créer une exposition réglementaire qui n’était pas un problème avec le système précédent basé sur les mots-clés.
Questions fréquemment posées
La correspondance sémantique comprend l'intention et la signification, tandis que la recherche par mots-clés cherche des correspondances exactes de mots. La correspondance sémantique peut trouver des résultats pertinents même lorsque les mots-clés exacts ne sont pas utilisés, en reconnaissant que différentes phrases peuvent exprimer le même concept.
Les embeddings vectoriels convertissent le texte en représentations numériques qui capturent la signification. Les concepts similaires sont positionnés proches les uns des autres dans l'espace vectoriel, ce qui permet au système de trouver du contenu sémantiquement lié en calculant les distances entre les vecteurs.
Le traitement du langage naturel (NLP), les modèles d'apprentissage automatique comme BERT et GPT, les embeddings vectoriels et les graphes de connaissances travaillent ensemble pour comprendre l'intention des requêtes et les faire correspondre au contenu pertinent.
Oui, la correspondance sémantique excelle dans la compréhension des synonymes et des variations sémantiques. Elle reconnaît que « voiture », « véhicule » et « automobile » ont des significations similaires et peut faire correspondre des requêtes utilisant n'importe lequel de ces termes sans configuration manuelle.
Elle fournit des résultats plus pertinents plus rapidement, réduit le besoin pour les utilisateurs d'affiner leurs recherches et permet une formulation de requêtes plus naturelle et conversationnelle sans nécessiter de correspondance exacte de mots-clés.
Les principaux défis incluent la complexité informatique, les préoccupations liées à la confidentialité des données, la nécessité d'un entraînement continu des modèles, le risque de mauvaise interprétation et l'équilibre entre précision et rapidité de réponse.
La correspondance sémantique permet à des systèmes comme AmICited.com de comprendre l'intention derrière le contenu généré par l'IA et de suivre les mentions de marque même lorsque les noms exacts de marque ne sont pas utilisés, offrant ainsi une visibilité complète de la marque.
Bien que la correspondance sémantique devienne plus courante, les deux approches coexistent. De nombreux systèmes modernes utilisent des approches hybrides combinant la compréhension sémantique avec la correspondance par mots-clés pour des résultats optimaux.
Surveillez comment les systèmes d'IA référencent votre marque
AmICited.com utilise la correspondance sémantique de requêtes pour suivre les mentions de votre marque dans ChatGPT, Perplexity et Google AI Overviews — en comprenant non seulement ce qui est dit, mais aussi l'intention derrière.
Qu'est-ce que la recherche sémantique pour l'IA ? Son fonctionnement et son importance
Découvrez comment la recherche sémantique utilise l'IA pour comprendre l'intention de l'utilisateur et le contexte. Apprenez en quoi elle diffère de la recherch...
La recherche sémantique interprète le sens et le contexte des requêtes à l'aide du NLP et de l'apprentissage automatique. Découvrez en quoi elle diffère de la r...
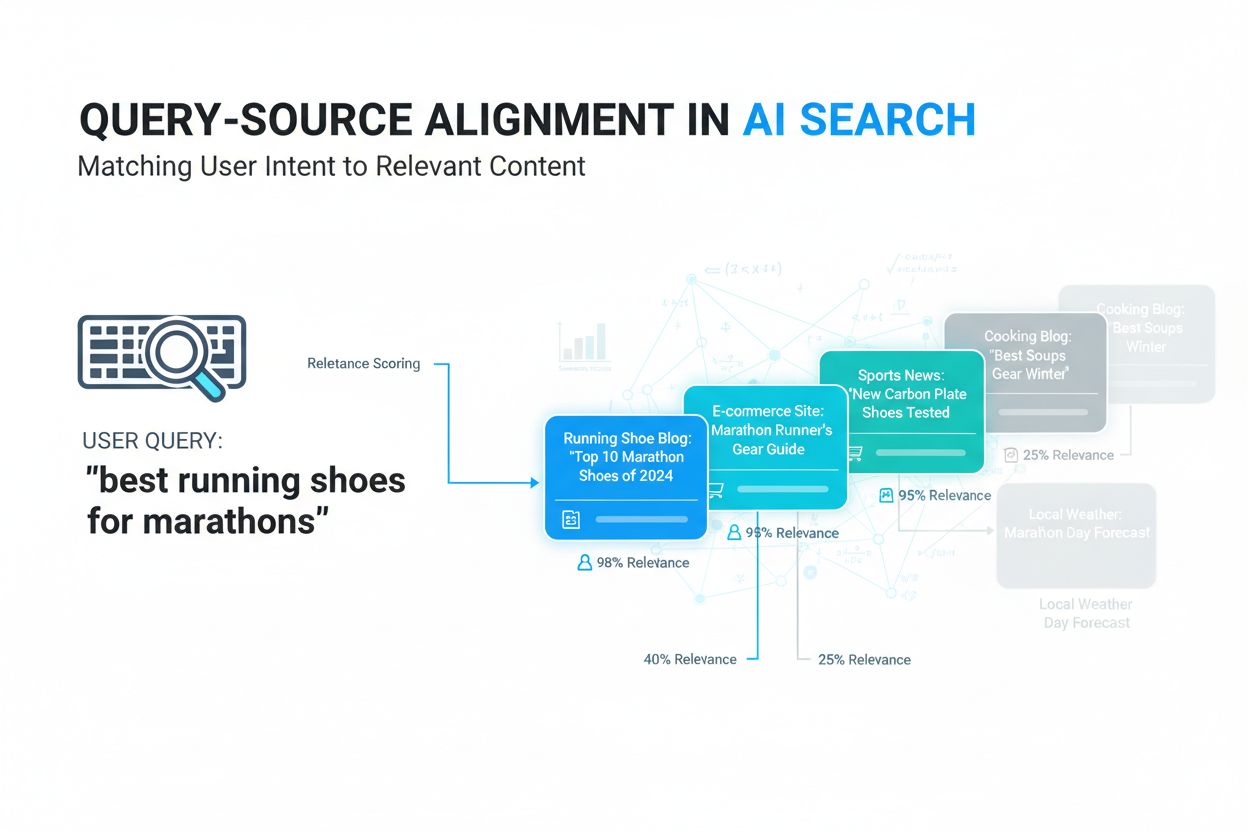
Découvrez ce qu'est l'alignement requête-source, comment les systèmes IA associent les requêtes utilisateurs aux sources pertinentes, et pourquoi cela est essen...
16 min de lecture
Consentement aux Cookies Nous utilisons des cookies pour améliorer votre expérience de navigation et analyser notre trafic. See our privacy policy.
Ces cookies sont nécessaires pour le fonctionnement du site web et ne peuvent pas être désactivés.
Cookies d'Analyse
Ces cookies nous aident à comprendre comment les visiteurs interagissent avec notre site web.
Cookies Marketing
Ces cookies sont utilisés pour mesurer l'efficacité de nos campagnes publicitaires et pour soutenir une publicité pertinente sur des plateformes tierces.
Cookies Fonctionnels
Ces cookies sont utilisés pour mémoriser vos préférences et améliorer votre expérience.