


Kurvanalyse
Lær hva kurvanalyse er, hvordan den avdekker reelle produktrelasjoner ved hjelp av støtte, konfidens og løft, og hvordan den bidrar til beslutninger om produktp...
5 min lesing
Markedskurvanalyse er en datagruveteknikk som undersøker hvilke produkter kunder har en tendens til å kjøpe sammen, og avdekker mønstre som «kunder som kjøper X kjøper også Y.» Forhandlere bruker det til å informere produktplassering, pakking, kryssalgsanbefalinger og kampanjestrategi basert på faktisk samkjøpsatferd i stedet for gjetting.
Markedskurvanalyse er en datagruveteknikk som undersøker hvilke produkter kunder har en tendens til å kjøpe sammen, og avdekker mønstre som «kunder som kjøper X kjøper også Y.» Forhandlere bruker det til å informere produktplassering, pakking, kryssalgsanbefalinger og kampanjestrategi basert på faktisk samkjøpsatferd i stedet for gjetting.
Markedskurvanalyse er en datagruveteknikk som identifiserer mønstre i hva kunder kjøper sammen i samme transaksjon. Navnet kommer fra dens opprinnelige detaljhandelsanvendelse — bokstavelig talt å analysere innholdet i en handlekurv for å se hvilke varer som har en tendens til å vises side om side. Teknikken produserer assosiasjonsregler i formen «hvis en kunde kjøper vare A, er de også sannsynlig å kjøpe vare B», og den gjør dette ved å utvinne historiske ordredata i stedet for å stole på antakelser eller kategorigrupperinger som en merchandiser mener gir mening. Innen e-handel spesifikt har markedskurvanalyse blitt et grunnleggende input til produktanbefalingsmotorer, pakkedesign og kampanjeplanlegging, fordi den erstatter gjetting om hvilke produkter som komplementerer hverandre med bevis hentet direkte fra faktisk kundeadferd.
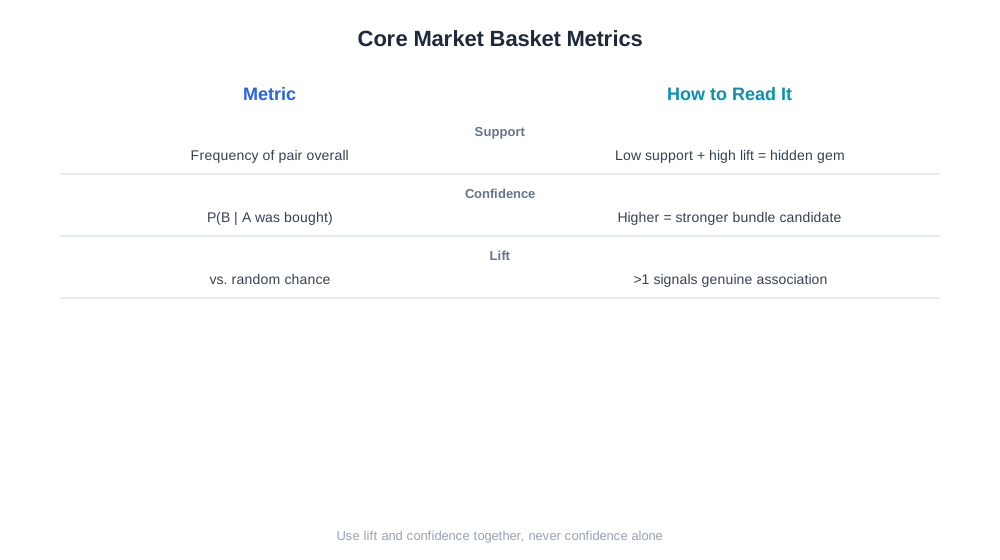
Markedskurvanalyse er avhengig av tre kjernestatistiske mål. Støtte måler hvor ofte en kombinasjon av varer forekommer på tvers av alle transaksjoner — hvis 500 av 10 000 ordrer inkluderer både et telefondeksel og en skjermbeskytter, er støtten for det paret 5 prosent. Konfidens måler den betingede sannsynligheten for at en kunde som kjøper vare A også kjøper vare B — hvis 60 prosent av personene som kjøpte telefondekselet også kjøpte skjermbeskytteren, er konfidensen for den regelen 60 prosent. Løft sammenligner den konfidensen med hva som ville vært forventet hvis de to kjøpene var uavhengige; en løftverdi over 1 betyr at parringen skjer oftere enn tilfeldighetene skulle tilsi, mens et løft nær 1 antyder at varene er uavhengige og bare tilfeldigvis er populære hver for seg.
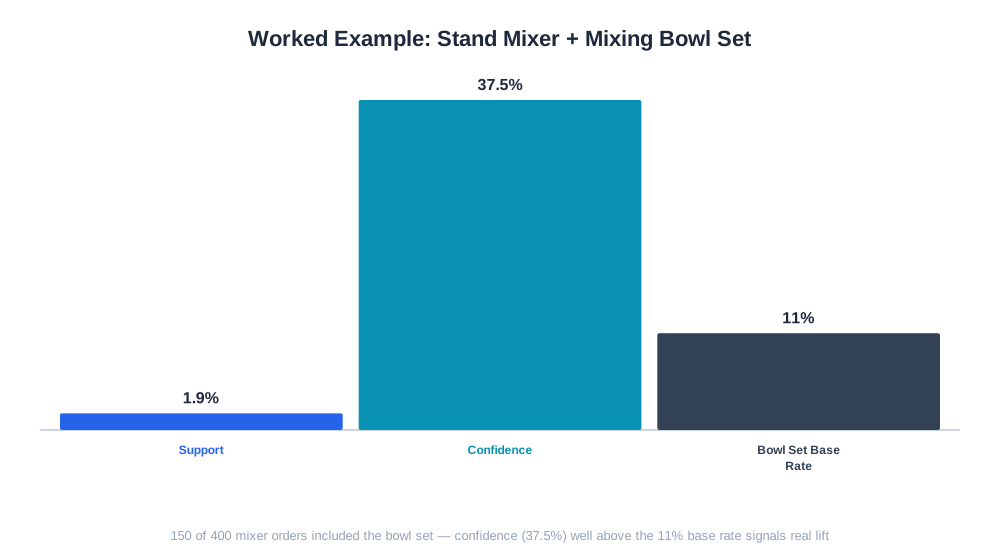
Et praktisk eksempel: anta at en hjemmeinnredningsbutikk selger 8 000 ordrer i et kvartal. En kjøkkenmaskin vises i 400 av dem, og et sett med mikseboller vises i 900 av dem. Hvis 150 ordrer inneholder begge deler, er støtten for det paret omtrent 1,9 prosent. Konfidensen for at et kjøp av kjøkkenmaskin inkluderer et sett med mikseboller er 150 delt på 400, eller 37,5 prosent — sammenlignet med miksebollesettets generelle kjøpsrate på omtrent 11 prosent, noe som gir et løft godt over 1 og bekrefter en genuin assosiasjon verdt å handle på med en pakke eller en «ofte kjøpt sammen»-plassering.

Følg med på hvordan AI-chatboter nevner merkevaren din i ChatGPT, Perplexity og andre plattformer.
Uten markedskurvanalyse blir merchandising-beslutninger om pakker, kryssalg og produktplassering basert på intuisjon, som ofte overser ikke-åpenbare parringer som ikke passer inn i en åpenbar kategorirelasjon — en campingbutikk kan oppdage at kunder som kjøper telt også i uforholdsmessig grad kjøper et spesifikt merke myggmiddel, en sammenheng en kategorisjef neppe ville ha gjettet uten dataene.
Å handle på reelle assosiasjoner har en tendens til å øke gjennomsnittlig ordreverdi mer pålitelig enn generiske «du vil kanskje også like»-widgeter bygget på kategorilikhet alene, fordi anbefalingen reflekterer faktisk kjøpsatferd i stedet for en taksonomitreff. Markedskurvanalyse hjelper også med å unngå bortkastet kampanjebruk: å gi rabatt på to produkter som allerede nesten alltid kjøpes sammen øker ikke kurvstørrelsen, det reduserer bare marginen på et kjøp som uansett ville ha skjedd, mens rabatt på en parring med høyt løft men lav støtte kan konvertere en uutnyttet assosiasjon til nye inkrementelle inntekter.
| Måling | Hva den måler | Hvordan tolke den |
|---|---|---|
| Støtte | Hvor ofte varekombinasjonen vises totalt | Lav støtte med høyt løft kan fortsatt være en skjult perle verdt å teste |
| Konfidens | Sannsynlighet for å kjøpe B gitt at A ble kjøpt | Høyere konfidens betyr en sterkere kandidat for «ofte kjøpt sammen» |
| Løft | Hvor mye mer sannsynlig parringen er enn tilfeldighet | Løft over 1 signaliserer en genuin assosiasjon, ikke tilfeldighet |
| Overbevisning | Hvor avhengig Bs fravær er av As fravær | Nyttig for å identifisere nesten obligatoriske tilleggskjøp |
Få de nyeste innsiktene om AI-omtaler, merkevareovervåking og optimaliseringsstrategier.
Ettersom AI-handelsassistenter som ChatGPT Shopping og Perplexity Shopping i økende grad genererer flervare-kjøpsforslag som svar på en enkelt forespørsel, blir den underliggende logikken i markedskurvanalyse anvendt på et nytt nivå: en AI-assistent som anbefaler «et telt, en sovepose og myggmiddel» for en campingtur-forespørsel utfører effektivt en sanntidsversjon av den samme assosiasjonsregel-resonneringen som forhandlere har brukt på sine egne ordredata i flere tiår. Merker som forstår sine egne sterkeste produktassosiasjoner er bedre posisjonert til å strukturere produktlister, pakker og innhold slik at AI-systemer viser de riktige kombinasjonene i stedet for et vilkårlig eller ufullstendig sett. På driftssiden er AmICiteds eshop_get_product_bundles-verktøy en direkte implementering av markedskurvanalyse mot en butikks egen ordrehistorikk — det behandler transaksjonsdata for å avdekke statistisk meningsfulle produktpar og -grupper, slik at en forhandler kan se hvilke pakker som er støttet av reell samkjøpsdokumentasjon i stedet for en magefølelse, og deretter kan handle på signalet både i butikkens merchandising og i hvordan produkter beskrives for AI-drevet oppdagelse.
En vanlig feil er å behandle støtte, konfidens og løft som om de er utskiftbare, når hver av dem svarer på et annet spørsmål; å stole på konfidens alene kan avdekke par som rett og slett er populære varer snarere enn genuint assosierte, noe som fører til pakker som faktisk ikke flytter gjennomsnittlig ordreverdi. Et annet vanlig problem er å kjøre analysen på en for liten dataprøve, spesielt for butikker med begrenset ordrevolum, noe som produserer statistisk ustabile assosiasjoner som ser sterke ut én måned og forsvinner den neste — en regel bygget på ti ordrer er langt mindre pålitelig enn en bygget på tusen. Noen forhandlere anvender også funn for bokstavelig på SKU-nivå når det underliggende mønsteret egentlig er på kategorinivå, og går glipp av bredere pakkemuligheter fordi de ser etter en eksakt gjentatt parring i stedet for en generaliserbar relasjon. Det er også vanlig å ignorere sesongvariasjoner: en parring som så sterk ut i en høytidsperiode holder kanskje ikke resten av året, og å behandle den som en permanent pakke kan føre til lavere enn forventet tilleggssalgsrate utenfor det vinduet. Til slutt kjører mange butikker analysen én gang og går aldri tilbake til den, og går dermed glipp av nye assosiasjoner som oppstår når katalogen endrer seg, noe som betyr at pakke- og kryssalgslogikken gradvis glir ut av sync med faktisk nåværende kundeadferd.
Begynn å spore hvordan AI-chatbots nevner merkevaren din på tvers av ChatGPT, Perplexity og andre plattformer. Få handlingsrettede innsikter for å forbedre din AI-tilstedeværelse.
Lær hva kurvanalyse er, hvordan den avdekker reelle produktrelasjoner ved hjelp av støtte, konfidens og løft, og hvordan den bidrar til beslutninger om produktp...
Lær hva produktaffinitet er, hvordan det beregnes, og hvordan e-handelsmerker bruker det til å bygge smartere kryssalgs-, pakkeløsnings- og anbefalingsstrategie...
Lær hva kurvstørrelse betyr i e-handel, hvordan det måles, og hvordan kurvstørrelsesfordeling avslører muligheter for pakking og kryssalg.
Informasjonskapselsamtykke
Vi bruker informasjonskapsler for å forbedre din surfeopplevelse og analysere vår trafikk. See our privacy policy.