


Produktschema
Produktschema är strukturerad datamarkering som hjälper sökmotorer och AI-system att förstå produktdetaljer. Lär dig hur du implementerar det för bättre synligh...
21 min läsning
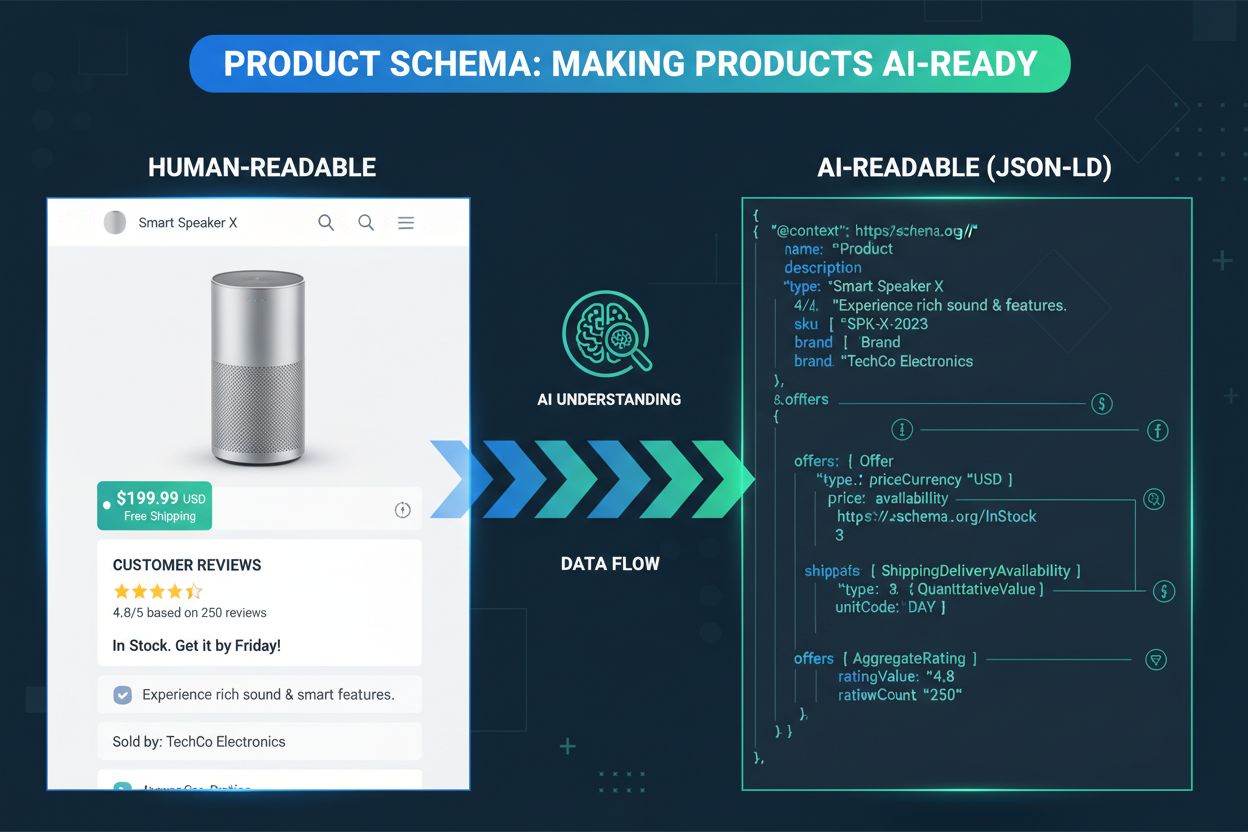
En teknisk genomgång av implementering av produktschemamarkering: Schema.org-produktegenskaper, JSON-LD-syntax, nästlade Offer/AggregateRating/Review-typer, plattformskonfiguration och valideringsverktyg, samt vilka AI-shoppingmotorer som faktiskt läser datan.
Din e-handelswebbplats kan ha utmärkta produkter, övertygande beskrivningar och konkurrenskraftiga priser, men när kunder frågar AI-assistenter om rekommendationer dyker konkurrenter upp istället. Strukturerad datamarkering är vanligtvis skillnaden. Till skillnad från traditionella sökmotorer som förlitar sig på nyckelordsmatchning och sidinnehållsanalys, är AI-shoppingmotorer starkt beroende av strukturerad data för att förstå produktattribut, relationer och sammanhang med precision. I takt med att AI-shoppingmotorer blir mer sofistikerade avgör fullständigheten i ditt produktschema i allt högre grad om dina produkter överhuvudtaget upptäcks, korrekt representeras och rekommenderas till potentiella kunder.
Den här guiden täcker både varför och hur: varför produktschema driver AI-shoppingsynlighet, vilka AI-shoppingmotorer som faktiskt läser det, och de exakta egenskaperna, JSON-LD-syntaxen, nästlade typerna, plattformskonfigurationen och valideringsstegen som krävs för att få det rätt från början. Att få implementeringen rätt spelar roll eftersom AI-system inte kan utläsa innebörd från en produktsida på samma sätt som en mänsklig shoppare kan. De scannar efter strukturerad data i specifika format och specifika egenskaper, och luckor i den markeringen är luckor i vad AI-system kan säga om din produkt.
När en AI-shoppingmotor genomsöker din webbplats extraherar den strukturerad produktdata och matar in den i sitt Knowledge Graph, en enorm databas med sammankopplad produktinformation som driver intelligenta sök- och rekommendationsfunktioner. Detta är en fundamentalt annorlunda process än traditionell nyckelordsindexering.
| Aspekt | Traditionell sökning | AI-shoppingmotorer |
|---|---|---|
| Datakälla | Sidinnehåll + meta-taggar | Strukturerat schema + innehåll |
| Förståelse | Nyckelordsbaserad matchning | Semantisk förståelse |
| Produktkontext | Begränsad | Omfattande |
| Rekommendationskvalitet | Grundläggande filtrering | Avancerad AI-analys |
Detta strukturerade tillvägagångssätt gör att AI-system kan förstå inte bara vad en produkt är utan dess specifikationer, priser och tillgänglighet i en enhetlig, maskinläsbar profil, istället för att pussla ihop det från spridd sidtext. De exakta egenskaperna som matar denna profil täcks i detalj nedan.
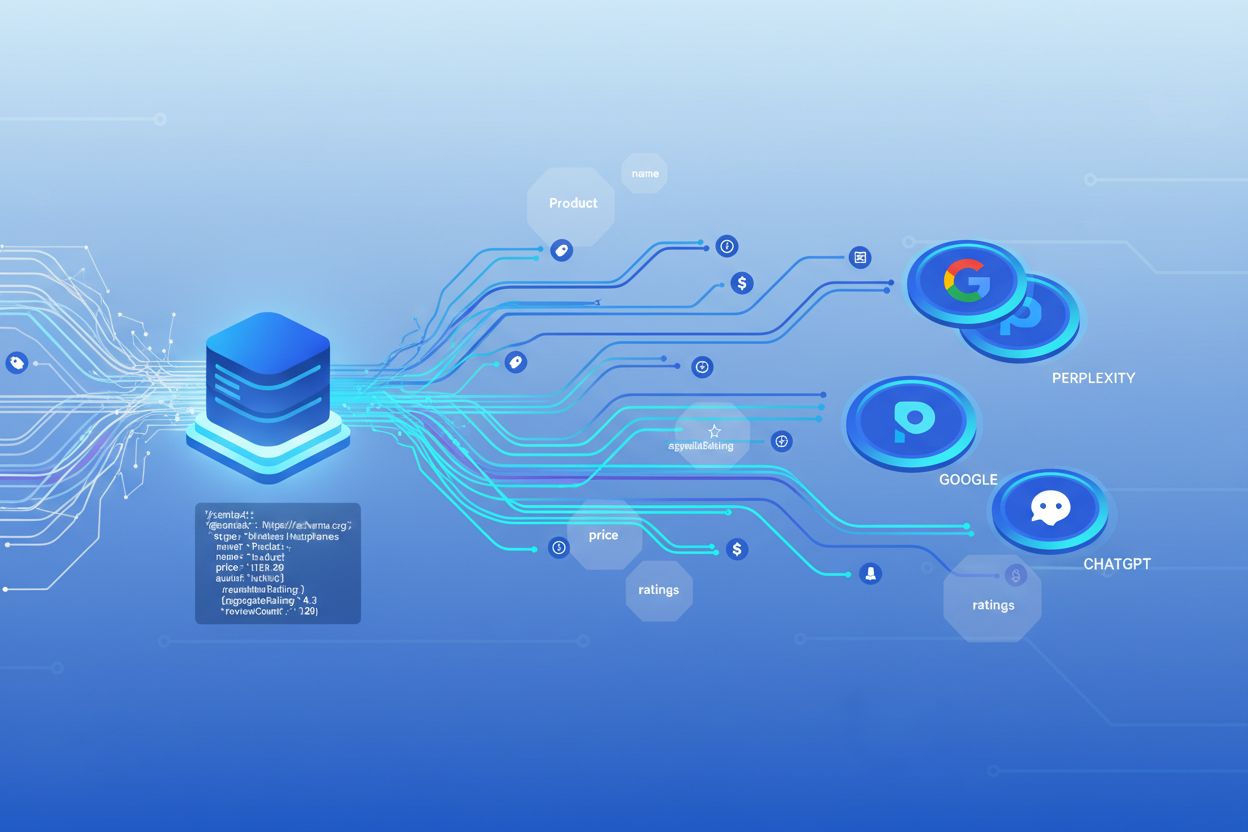
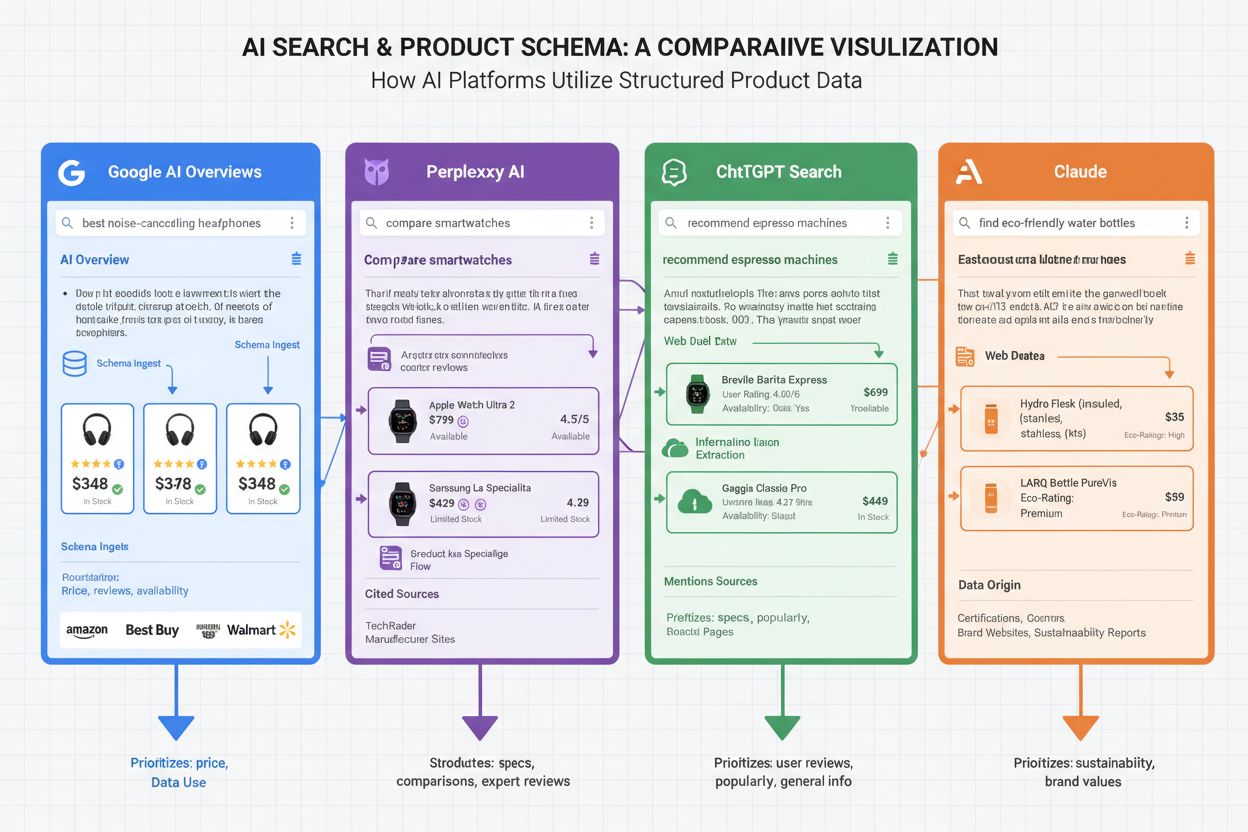
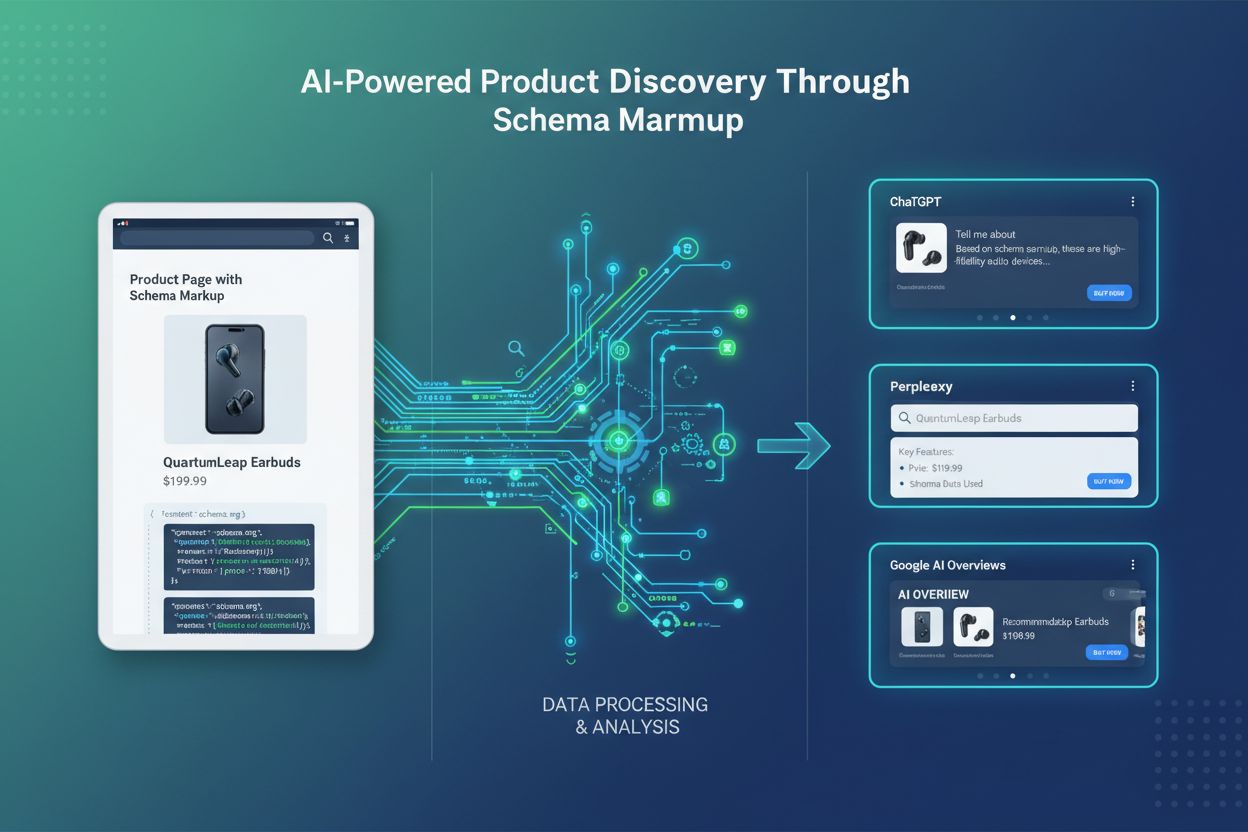
Alla AI-shoppingmotorer väger inte samma egenskaper på samma sätt, och att känna till skillnaderna hjälper dig att prioritera var du ska fokusera. Google AI Overviews (tidigare SGE) förlitar sig starkt på produktschema för att generera AI-drivna shopping-sammanfattningar som visas högst upp i sökresultaten; dess beroende av fullständig pris-, tillgänglighets- och betygsdata gör schemimplementering avgörande för alla som vill synas i Googles AI-funktioner. Perplexity AI använder produktschema för att tillhandahålla korrekt produktinformation, priser och tillgänglighet i sina konversationsbaserade sökresultat, och det märks att den föredrar att citera källor med välorganiserad data framför de utan. ChatGPT Search integrerar produktschemadata för att leverera aktuell pris-, lagerstatus- och produktbeskrivning när användare ställer shoppingrelaterade frågor, och prioriterar källor med omfattande strukturerad data framför sådana som den måste utläsa från brödtext. Claude och andra AI-assistenter refererar allt oftare till produkter med korrekt schemamarkering när de svarar på konsumentfrågor, eftersom strukturerad data tillhandahåller tillförlitlig, verifierbar information som är lättare att lita på än fritextpåståenden.
Standardvokabulären för produktschemamarkering kommer från Schema.org, ett öppen källkod-samarbetsprojekt som stöds av Google, Microsoft, Yahoo och Yandex som definierar hur olika typer av innehåll ska markeras. Product-typen är ryggraden i e-handelsstrukturerad data. Som minimum inkluderar en fullständig implementering: name (den exakta produktiteln, som matchar vad som står på sidan), description, sku (din interna lagerhållningsenhet), gtin eller mpn (tillverkarens globala identifierare, användbar för att korsreferera din listning mot tillverkarens katalogdata), brand, image (en eller flera webbadresser, helst flera vinklar) och category. Ingen av dessa egenskaper är valfria om du vill att AI-system ska ha en fullständig bild; ett ofullständigt Product-block är en av de vanligaste orsakerna till att produkter hoppas över i AI-genererade rekommendationer.
| Egenskap | Typ | Syfte |
|---|---|---|
name | Text | Exakt produktitel för matchning |
sku / gtin / mpn | Text | Unika identifierare, förhindrar dubblettlistningar |
brand | Brand-objekt | Tillverkare eller varumärkesnamn |
image | Webbadress(er) | Visuell data som AI-system kan analysera |
category | Text | Klassificering för filtrering och jämförelse |
offers | Offer-objekt | Pris, tillgänglighet, köp-URL |
aggregateRating | AggregateRating-objekt | Övergripande betygspoäng |
review | Review-objekt | Individuell kundfeedback |

Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
De övergripande Product-egenskaperna tar dig bara halvvägs – de nästlade objekten är där merparten av den användbara detaljen finns. Offer-objektet bär price, priceCurrency, availability (med Schema.orgs kontrollerade vokabulär som https://schema.org/InStock), url och eventuellt priceValidUntil för tidsbegränsade priser. Utan ett giltigt Offer har AI-system inget tillförlitligt svar på “finns detta i lager och vad kostar det”, vilket ofta är den avgörande faktorn för om en produkt överhuvudtaget rekommenderas. AggregateRating-objektet bär ratingValue, reviewCount och eventuellt bestRating/worstRating för att definiera skalan; utelämna skalan och vissa parsrar antar ett standardvärde som kanske inte matchar ditt faktiska betygssystem. Review-objektet kapslar in individuella recensioner med author, reviewBody, datePublished och ett reviewRating-underobjekt. Du behöver inte bädda in varje recension i ditt produktschema (det sväller sidan); att bädda in ett representativt urval tillsammans med aggregeringen är standardpraxis.
JSON-LD (JavaScript Object Notation for Linked Data) är det föredragna implementeringsformatet eftersom det lever i ett enda, fristående <script>-block istället för att vara utspritt över HTML-attribut, vilket gör både strukturerad data och din markering lättare att underhålla. Här är ett komplett exempel som kombinerar egenskaperna ovan:
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Premium Waterproof Hiking Boots",
  "description": "Durable waterproof hiking boots with ankle support and grip sole",
  "image": "https://example.com/hiking-boots.jpg",
  "brand": {
    "@type": "Brand",
    "name": "TrailMaster"
  },
  "offers": {
    "@type": "Offer",
    "price": "149.99",
    "priceCurrency": "USD",
    "availability": "https://schema.org/InStock",
    "url": "https://example.com/hiking-boots"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.7",
    "reviewCount": "328"
  },
  "sku": "HB-WP-001",
  "mpn": "TRAILMASTER-HB-2024"
}
Detta block ska placeras inom <script type="application/ld+json">-taggar, antingen i sidans <head> eller i sidans brödtext – båda är giltiga, men att placera det i <head> innebär att AI-sökrobotar stöter på det innan de måste tolka resten av sidans innehåll.
De flesta e-handelsplattformar genererar automatiskt ett visst grundschema, men “visst” gör mycket arbete i den meningen. Shopify-teman levererar vanligtvis name, price och availability som standard, men hoppar ofta över aggregateRating och review; om ditt tema inte har inbyggt stöd för recensionsschema behöver du en recensionsapp som skriver sin egen JSON-LD eller en anpassad Liquid-mall. WooCommerce-implementeringar varierar enormt beroende på vilket SEO-plugin som är aktivt; Yoast och RankMath genererar båda produktschema, men täckningen av nästlade Offer- och Review-egenskaper skiljer sig åt, så granska den faktiska utdatan istället för att anta att pluginet hanterar allt. Magentos inbyggda produktschema är relativt starkt direkt ur lådan men utelämnar vanligtvis gtin/mpn, vilket spelar roll om AI-system korsrefererar din listning mot tillverkardata. I varje fall är lösningen densamma: visa sidkällkod, hitta ditt JSON-LD-block och kontrollera det mot egenskapstabellen ovan istället för att lita på att “plattformen hanterar schema” är ett fullständigt svar, särskilt om du också optimerar för AI-sökning över flera plattformar samtidigt.
Implementeringen är inte klar förrän den är validerad. Googles Rich Results Test kontrollerar om ditt schema inte bara är tekniskt giltigt utan också kvalificerat för förbättrade sökfunktioner – kör varje mall genom det, inte bara en exempelsida. Schema.orgs egen validator fångar syntaxfel som Rich Results Test kanske inte flaggar. Google Search Console visar schemarelaterade fel och varningar över hela din webbplats över tid, vilket är det bästa sättet att fånga regressioner efter en temauppdatering eller plugin-ändring. Innan du rullar ut schemaändringar på hela webbplatsen, testa på en representativ delmängd sidor – olika produkttyper (paket, varianter, slut-i-lager-varor) tenderar att bryta mallar på olika sätt, och att fånga det på tio sidor är mycket billigare än att fånga det på tio tusen.
Statiskt schema som blir inaktuellt är utan tvekan sämre än inget schema alls, eftersom det aktivt matar AI-system med felaktig information. Realtidsuppdateringar av data är icke förhandlingsbara för pris och tillgänglighet; implementera automatiserade processer som återskapar schema närhelst din produktdatabas ändras, istället för att förlita dig på manuella redigeringar eller periodiska batchjobb. Det mest pålitliga mönstret är att hämta schemadata från samma sanningskälla som ditt synliga sidinnehåll, så att de två aldrig kan glida isär. AI-system väger konsekvens och färskhet när de bestämmer vilka källor de ska lita på för rekommendationer, och ett schemablock som inte har matchat verkligheten på tre veckor gör mer skada än nytta.
Avkastningen från schemimplementering visas på en förutsägbar tidslinje. Rich result-visningar förbättras vanligtvis inom 2–4 veckor efter korrekt implementering, synligt först i Google Search Console. AI Overview-framträdanden och röstsökningsvinster följer vanligtvis inom 4–8 veckor. Affärsmått – förbättrad konverteringsgrad och ökad genomsnittlig beställning – visas vanligtvis inom 2–3 månader, när AI-system har haft tillräcklig exponering för din strukturerade data för att konsekvent lita på och rekommendera dina listningar.
Det är därför schema är ett affärsbeslut, inte bara en teknisk kryssruta. Om du säljer över flera marknadsplatser såväl som din egen webbplats, spelar implementering av schema på din egen domän fortfarande roll: det etablerar din webbplats som den auktoritativa källan som AI-system kan citera direkt, istället för att låta AI-shoppingmotorer enbart hämta från marknadsplatslistningar som du inte fullt ut kontrollerar. I takt med att AI-shoppingassistenter allt oftare rekommenderar produkter direkt, vill du att de citerar dig, inte bara den marknadsplats som råkar vara värd för din listning.
Att mäta schemats affärspåverkan kräver spårning av mått bortom traditionell SEO. AmICited.com tillhandahåller en centraliserad instrumentpanel där du kan övervaka hur ofta dina produkter visas i AI-sökresultat på olika plattformar, så att du inte manuellt behöver fråga ChatGPT och Perplexity samma frågor varje vecka. ROI-spårning innebär att jämföra kostnaden för att implementera och underhålla schema mot intäkterna från AI-hänvisade kunder, vilket hjälper till att motivera fortsatt investering. Innan du kan lita på någon av dessa siffror är det dock värt att bekräfta grundläggande AI-sökrobotåtkomst till dina sidor – citatspårning är meningslös om sökrobotarna inte kan nå dina produktsidor från första början. Ställ in aviseringar för när dina produkter citeras i större AI-plattformar och jämför din prestanda mot konkurrenter för att identifiera luckor i din nuvarande schemastrategi.
| Misstag | Problem | Lösning |
|---|---|---|
| Ofullständiga egenskaper | Saknad gtin/mpn/aggregateRating lämnar AI-system gissande | Granska mot den fullständiga egenskapstabellen, inte bara plattformens standard |
| Felaktig data | Schemavärden skiljer sig från vad som visas på sidan | Generera schema och sidinnehåll från samma datakälla |
| Föråldrade egenskaper | Användning av schematyper eller fält som sökmotorer inte längre känner igen | Granska schema.orgs ändringsloggar kvartalsvis |
| Nyckelordsfyllning | Uppblåsta beskrivningar eller falska recensioner i schemat | Håll schemat ärligt; AI-system upptäcker allt oftare manipulation |
| Ingen realtidssynkning | Priser och lager blir inaktuella i JSON-LD | Automatisera schemaåterskapning vid dataändring |
Utöver tabellen förtjänar ett strukturellt misstag ett eget omnämnande: att implementera schema endast på desktopmallar. Om ditt mobiltema renderar en avskalad sida, verifiera att dess JSON-LD-block också är komplett – mobilt-först-indexering innebär att ett tunt mobilt schema kan underminera en annars solid desktopimplementering.
Ett fåtal strategiska misstag förvärrar dessa tekniska och kostar specifikt företag AI-synlighet. Att behandla schema som ett engångsprojekt snarare än ett pågående åtagande: AI-plattformar utvecklar sina datakrav över tid och viktar olika egenskaper allt eftersom deras shoppingfunktioner mognar, och en strategi som var vettig för ett år sedan kan lämna synlighet på bordet idag. Att skriva produktbeskrivningar för nyckelordstäthet istället för tydlighet: AI-system straffar allt oftare manipulerande produktbeskrivningar och belönar naturliga, korrekta sådana som ger dem verklig information att sammanfatta. Att enbart förlita sig på marknadsplatsnärvaro: utan eget schema har du noll kontroll över hur AI-system karakteriserar ditt varumärke i förhållande till konkurrenter som säljer samma produkt. Se även de tekniska fel som oftast skadar AI-sökprestanda mer brett.
När grunderna är på plats låter nästlade schemarelationer dig beskriva mer komplexa kataloger: produktpaket och set, kompatibla tillbehör, reservdelar och storleks-/färgvarianter via ProductGroup och isVariantOf. Flerspråkigt schema är viktigt för internationella kataloger; implementera schema per språkområde istället för att förlita dig på ett enda kanoniskt språkblock, eftersom AI-system allt oftare levererar språkspecifika rekommendationer. Att hålla denna strukturerade data komplett och synkroniserad över varje mall och språkområde stöder också flerkanalssynlighet, eftersom samma underliggande JSON-LD matar AI Overviews, Perplexity, ChatGPT och röstassistenter samtidigt istället för att kräva separata implementeringar för varje.
Ett bredare semantiskt lager håller också på att växa fram över e-handelsplattformar, ett som går bortom grundläggande attribut till att omfatta relationer, användningsfall och hållbarhetsdata – rikare än vad de flesta schemimplementeringar fångar idag. Framväxande funktioner som visuell sökintegrering, rösthandel och personliga rekommendationer kommer allt mer att vara beroende av omfattande, välorganiserad produktdata för att överhuvudtaget fungera. Framöver, i takt med att konversationshandelns schematyper mognar och täcker flervarvig produktupptäckt och agentinitierade transaktioner, förväntas de förlänga denna egenskapsuppsättning snarare än ersätta den, så en välorganiserad Product-implementering idag är grunden som dessa tillägg kommer att bygga på. I takt med att konkurrensen intensifieras bland AI-shoppingplattformar kommer de handlare som tillhandahåller den högsta kvaliteten på strukturerad data att vara de som AI-system litar på för att bygga överlägsna rekommendationsupplevelser kring, vilket skapar ett växande incitament att investera i schema nu snarare än efter att konkurrenter redan har gjort anspråk på det förtroendet.
Yasha är en talangfull mjukvaruutvecklare specialiserad på Python, Java och maskininlärning. Yasha skriver tekniska artiklar om AI, prompt engineering och chatbotutveckling.
AmICited spårar hur AI-system refererar till dina produkter i ChatGPT, Perplexity, Google AI Overviews med flera. Verifiera att din schemimplementering översätts till verkliga AI-citat.
Produktschema är strukturerad datamarkering som hjälper sökmotorer och AI-system att förstå produktdetaljer. Lär dig hur du implementerar det för bättre synligh...
Lär dig vad produktflöden för AI är, hur de skiljer sig från traditionella flöden och hur du optimerar dem för ChatGPT, Google AI Overviews och Perplexity shopp...
Cookie-samtycke
Vi använder cookies för att förbättra din surfupplevelse och analysera vår trafik. See our privacy policy.