


Sådan optimerer du produktsider til AI-søgemaskiner
Lær hvordan du optimerer produktsider til AI-søgemaskiner som ChatGPT og Perplexity. Opdag implementering af strukturerede data, indholdsstrategier og tekniske ...
7 min læsning
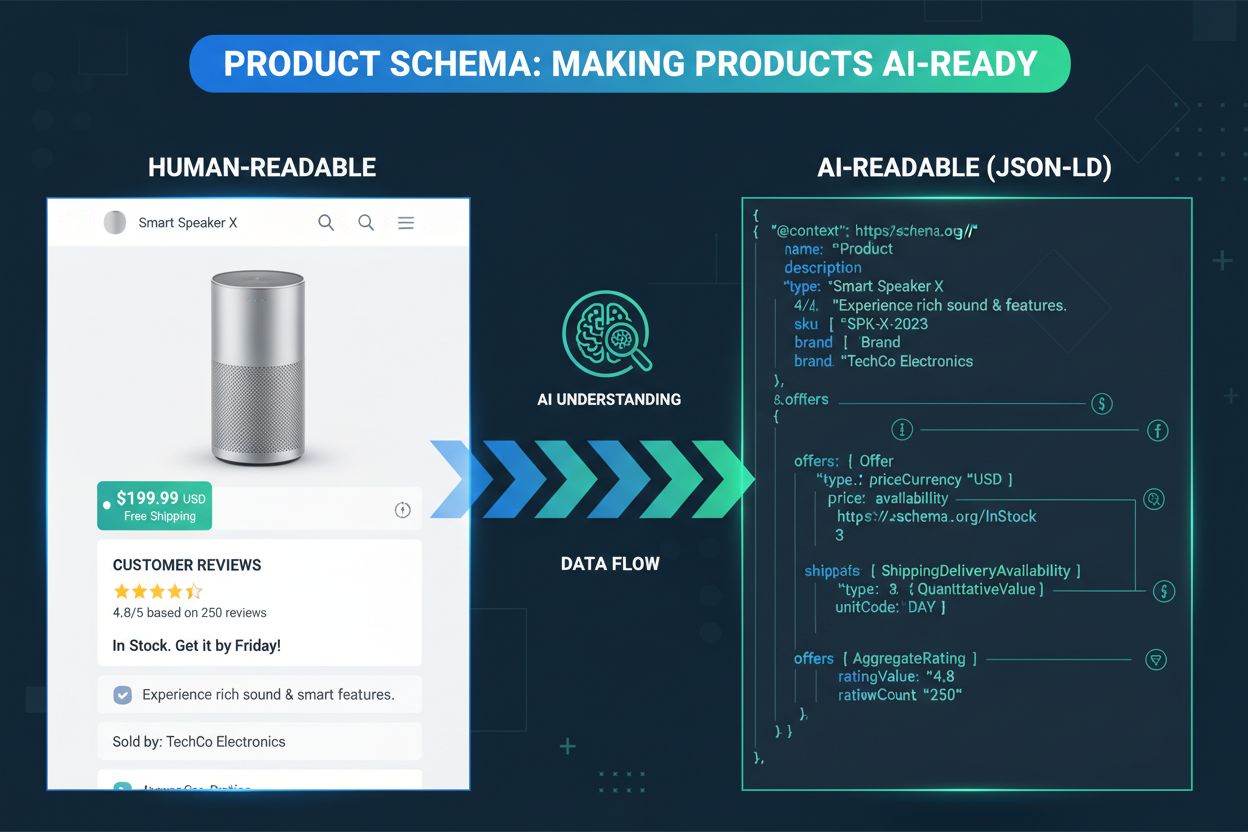
En teknisk gennemgang af implementering af produktskema markup: Schema.org Product-egenskaber, JSON-LD-syntaks, indlejrede Offer/AggregateRating/Review-typer, platformopsætning og valideringsværktøjer, samt hvilke AI-shoppingmotorer der faktisk læser disse data.
Dit e-handelswebsted har gode produkter, overbevisende beskrivelser og konkurrencedygtige priser. Alligevel dukker dine konkurrenter op, når kunder spørger AI-assistenter om anbefalinger. Struktureret data-markup er normalt forskellen. I modsætning til traditionelle søgemaskiner, der støtter sig til søgeordsmatchning og sideindholdsanalyse, er AI-shoppingmotorer stærkt afhængige af strukturerede data for præcist at forstå produktattributter, relationer og kontekst. Efterhånden som AI-shoppingmotorer bliver mere sofistikerede, afgør fuldstændigheden af dit produktskema i stigende grad, om dine produkter overhovedet bliver opdaget, præcist repræsenteret og anbefalet til potentielle kunder.
Denne guide dækker både “hvorfor”, altså hvorfor produktskema driver AI-shopping-synlighed, og hvilke AI-shoppingmotorer der faktisk læser det, og “hvordan”, altså de præcise egenskaber, JSON-LD-syntaks, indlejrede typer, platformopsætning og valideringstrin, der skal til for at få produktskema markup rigtigt i første forsøg. At få implementeringen rigtig er vigtigt, fordi AI-systemer ikke kan udlede mening fra en produktside på samme måde som en menneskelig shopper. De scanner efter struktureret data i specifikke formater og specifikke egenskaber, og huller i den markup er huller i, hvad AI-systemer kan sige om dit produkt.
Når en AI-shoppingmotor gennemgår dit websted, udtrækker den strukturerede produktdata og føder dem ind i sin Knowledge Graph, en stor database med sammenkoblet produktinformation, der driver intelligente søge- og anbefalingsfunktioner. Dette er en grundlæggende anderledes proces end traditionel søgeordsindeksering.
| Aspekt | Traditionel søgning | AI-shoppingmotorer |
|---|---|---|
| Datakilde | Sideindhold + meta-tags | Struktureret skema + indhold |
| Forståelse | Søgeordsbaseret matchning | Semantisk forståelse |
| Produktkontekst | Begrænset | Omfattende |
| Anbefalingskvalitet | Grundlæggende filtrering | Avanceret AI-analyse |
Denne strukturerede tilgang gør det muligt for AI-systemer ikke kun at forstå hvad et produkt er, men også dets specifikationer, prissætning og tilgængelighed i én samlet, maskinlæsbar profil, i stedet for at samle det fra spredt sidetekst. De præcise egenskaber, der indgår i denne profil, gennemgås i detaljer længere nede.

Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
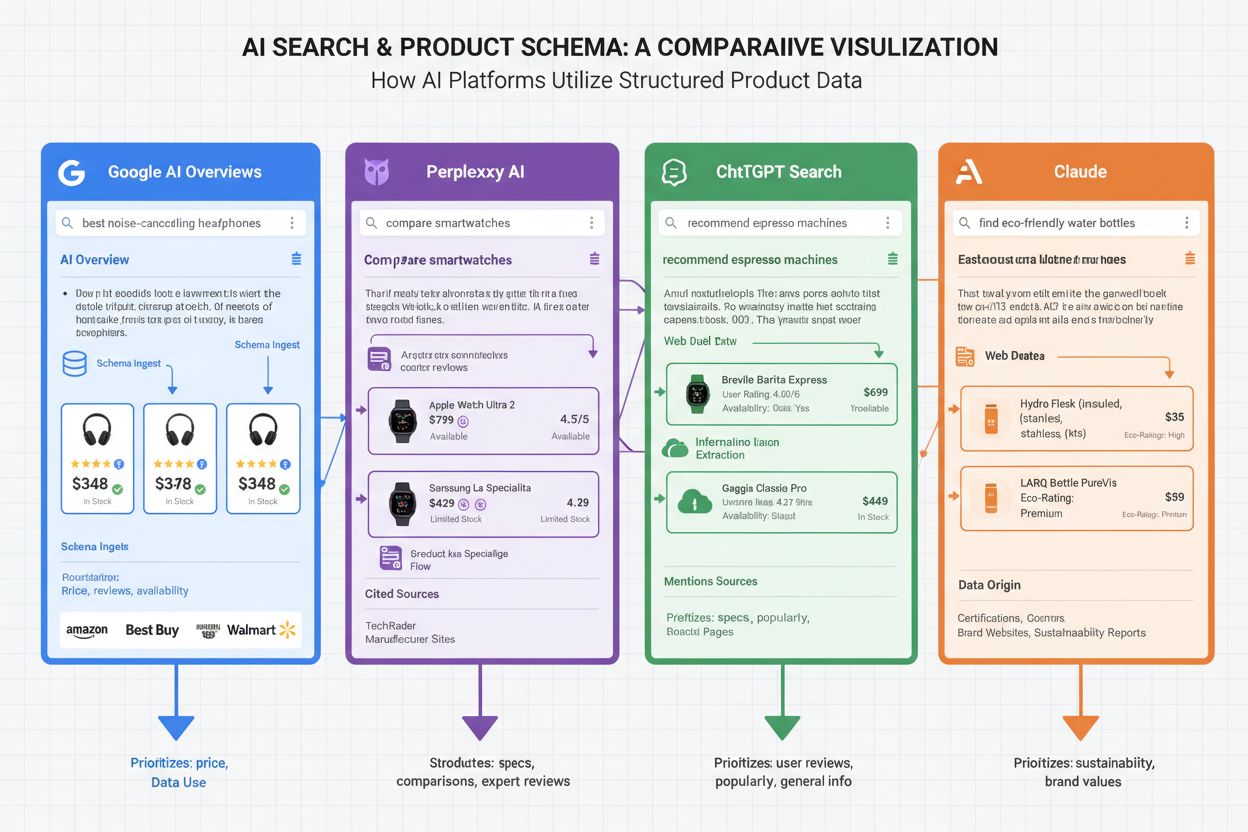
Ikke alle AI-shoppingmotorer vægter de samme egenskaber på samme måde, og at kende forskellene hjælper dig med at prioritere, hvor du skal fokusere. Google AI Overviews (tidligere SGE) er stærkt afhængig af produktskema til at generere AI-drevne shoppingoversigter, der vises øverst i søgeresultaterne, dets afhængighed af komplette pris-, tilgængeligheds- og bedømmelsesdata gør skemaimplementering afgørende for alle, der forsøger at optræde i Googles AI-funktioner. Perplexity AI bruger produktskema til at levere præcis produktinformation, prissætning og tilgængelighed i sine samtalebaserede søgeresultater og favoriserer tydeligt kilder med velstrukturerede data frem for dem uden. ChatGPT Search integrerer produktskemadata for at levere aktuelle priser, lagerstatus og produktbeskrivelser, når brugere stiller shoppingrelaterede spørgsmål, og prioriterer kilder med omfattende strukturerede data frem for dem, det skal udlede fra prosatekst. Claude og andre AI-assistenter refererer i stigende grad til produkter med korrekt skema-markup, når de besvarer forbrugeres spørgsmål, fordi strukturerede data giver pålidelig, verificerbar information, der er lettere at stole på end fritekst-påstande.
Standardordforrådet for produktskema markup kommer fra Schema.org, et open-source samarbejdsprojekt støttet af Google, Microsoft, Yahoo og Yandex, der definerer, hvordan man markerer forskellige typer indhold. Product-typen er rygraden i e-handels struktureret data. Som minimum inkluderer en komplet implementering: name (den præcise produktittel, der matcher hvad der står på siden), description, sku (dit interne lagerstyringsnummer), gtin eller mpn (producentens globale identifikator, nyttig til at krydsreferere din listing mod producentens katalogdata), brand, image (én eller flere URL’er, ideelt set fra flere vinkler) og category. Ingen af disse egenskaber er valgfrie, hvis du vil have AI-systemer til at have et komplet billede, en ufuldstændig Product-blok er en af de mest almindelige årsager til, at produkter springes over i AI-genererede anbefalinger.
| Egenskab | Type | Formål |
|---|---|---|
name | Text | Præcis produktittel til matchning |
sku / gtin / mpn | Text | Unikke identifikatorer, forhindrer dublet-lister |
brand | Brand-objekt | Producent eller brandnavn |
image | URL(er) | Visuelle data AI-systemer kan analysere |
category | Text | Klassifikation til filtrering og sammenligning |
offers | Offer-objekt | Pris, tilgængelighed, købs-URL |
aggregateRating | AggregateRating-objekt | Samlet bedømmelses-score |
review | Review-objekt(er) | Individuel kundefeedback |
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
De øverste Product-egenskaber bringer dig kun halvvejs, de indlejrede objekter er hvor størstedelen af den handlingsorienterede detalje findes. Offer-objektet indeholder price, priceCurrency, availability (ved brug af Schema.org’s kontrollerede ordforråd som https://schema.org/InStock), url og eventuelt priceValidUntil for tidsbegrænsede priser. Uden et gyldigt Offer har AI-systemer intet pålideligt svar på “er dette på lager og hvad koster det,” hvilket ofte er den afgørende faktor for, om et produkt overhovedet bliver anbefalet. AggregateRating-objektet indeholder ratingValue, reviewCount og eventuelt bestRating/worstRating til at definere skalaen, udelader du skalaen antager nogle parserne en standard, der måske ikke matcher dit faktiske bedømmelsessystem. Review-objektet indlejrer individuelle anmeldelser med author, reviewBody, datePublished og et reviewRating-underobjekt. Du behøver ikke at indlejre hver eneste anmeldelse i dit Product-skema (det gør siden tung); at indlejre en repræsentativ stikprøve sammen med det samlede er standard praksis.
JSON-LD (JavaScript Object Notation for Linked Data) er det foretrukne implementeringsformat, fordi det lever i en enkelt, selvstændig <script>-blok frem for at være spredt ud over HTML-attributter, at adskille struktureret data fra din markup gør begge dele lettere at vedligeholde. Her er et komplet eksempel, der kombinerer egenskaberne ovenfor:
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Premium Waterproof Hiking Boots",
  "description": "Durable waterproof hiking boots with ankle support and grip sole",
  "image": "https://example.com/hiking-boots.jpg",
  "brand": {
    "@type": "Brand",
    "name": "TrailMaster"
  },
  "offers": {
    "@type": "Offer",
    "price": "149.99",
    "priceCurrency": "USD",
    "availability": "https://schema.org/InStock",
    "url": "https://example.com/hiking-boots"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.7",
    "reviewCount": "328"
  },
  "sku": "HB-WP-001",
  "mpn": "TRAILMASTER-HB-2024"
}
Denne blok bør placeres inden i <script type="application/ld+json">-tags, enten i sidens <head> eller inden for sidens body, begge dele er gyldige, men at placere den i <head> betyder, at AI-crawlere støder på den, før de skal fortolke resten af sideindholdet.
De fleste e-handelsplatforme genererer noget grundlæggende skema automatisk, men “noget” bærer meget vægt i den sætning. Shopify-temaer leverer typisk name, price og availability som standard, men springer ofte aggregateRating og review over, hvis dit tema ikke understøtter anmeldelsesskema naturligt, skal du bruge en anmeldelsesapp, der skriver sin egen JSON-LD, eller en tilpasset Liquid-skabelontilføjelse. WooCommerce-implementeringer varierer enormt afhængigt af hvilket SEO-plugin der er aktivt; Yoast og RankMath genererer begge Product-skema, men dækningen af indlejrede Offer- og Review-egenskaber er forskellig mellem dem, så gennemgå det faktiske output i stedet for at antage at plugin’et håndterer alt. Magento’s indbyggede Product-skema er relativt stærkt ud af boksen, men udelader almindeligvis gtin/mpn, hvilket betyder noget hvis AI-systemer krydsrefererer din listing mod producentdata. I alle tilfælde er løsningen den samme: se sidens kildekode, find din JSON-LD-blok, og tjek den op mod egenskabstabellen ovenfor i stedet for at stole på at “platformen håndterer skema” er et komplet svar, især hvis du også optimerer til AI-søgning på tværs af flere platforme på én gang.
Implementering er ikke færdig, før den er valideret. Googles Rich Results Test kontrollerer, om dit skema ikke bare er teknisk gyldigt, men også kvalificeret til forbedrede søgefunktioner, kør hver skabelon igennem den, ikke kun én enkelt prøveside. Schema.org’s egen validator fanger syntaksfejl, som Rich Results Test måske ikke markerer. Google Search Console afslører skemarelaterede fejl og advarsler på tværs af hele dit site over tid, hvilket er den bedste måde at fange regressioner efter en temaopdatering eller plugin-ændring. Før du ruller skemaændringer ud på hele siden, test på et repræsentativt undersæt af sider, forskellige produkttyper (bundter, varianter, udsolgte varer) har tendens til at bryde skabeloner på forskellige måder, og at fange det på ti sider er meget billigere end at fange det på ti tusind.
Statisk skema, der bliver forældet, er værre end slet intet skema, fordi det aktivt fodrer AI-systemer med forkert information. Realtidsdataopdateringer er ikke til forhandling for pris og tilgængelighed, implementér automatiserede processer, der regenererer skema, når din produktdatabase ændres, i stedet for at stole på manuelle redigeringer eller periodiske batch-job. Det mest pålidelige mønster er at trække skemadata fra den samme kilde som dit synlige sideindhold, så de to aldrig kan komme på afstand af hinanden. AI-systemer vægter konsistens og friskhed, når de beslutter hvilke kilder de vil stole på til anbefalinger, og en skemablok der ikke har matchet virkeligheden i tre uger gør mere skade end gavn.
Afkastet fra skemaimplementering viser sig på en forudsigelig tidslinje. Rich result-visninger forbedres typisk inden for 2-4 uger efter korrekt implementering, først synligt i Google Search Console. AI Overview-forekomster og synlighedsgevinster i talesøgning følger normalt inden for 4-8 uger. Forretningsmålinger, forbedringer i konverteringsrate og stigning i gennemsnitlig ordreværdi, viser sig typisk inden for 2-3 måneder, når AI-systemer har haft tilstrækkelig eksponering for dine strukturerede data til at stole på og anbefale dine produktlister konsekvent.
Dette er grunden til, at skema er en forretningsbeslutning, ikke kun en teknisk afkrydsningsboks. Hvis du sælger på tværs af flere markedspladser såvel som dit eget websted, betyder implementering af skema på dit eget domæne stadig noget: det etablerer dit websted som den autoritative kilde, AI-systemer kan citere direkte, i stedet for at lade AI-shoppingmotorer udelukkende trække fra markedspladsfortegnelser, du ikke har fuld kontrol over. Efterhånden som AI-shoppingassistenter i stigende grad anbefaler produkter direkte, vil du have dem til at citere dig, ikke kun den markedsplads, der tilfældigvis huser din fortegnelse.
Måling af skemats forretningsmæssige effekt kræver sporing af målinger ud over traditionel SEO. AmICited.com tilbyder et centraliseret dashboard, hvor du kan overvåge, hvor ofte dine produkter vises i AI-søgeresultater på tværs af forskellige platforme, så du ikke manuelt skal stille ChatGPT og Perplexity de samme spørgsmål hver uge. ROI-sporing indebærer at sammenligne omkostningerne ved at implementere og vedligeholde skema mod omsætningen genereret fra AI-henviste kunder, hvilket hjælper med at retfærdiggøre fortsat investering. Før du kan stole på nogen af disse tal, er det dog værd at bekræfte grundlæggende AI-crawleradgang til dine sider, citationssporing er meningsløs, hvis crawlerne ikke kan nå dine produktsider i første omgang. Opsæt alarmer, når dine produkter citeres på større AI-platforme, og sammenlign din præstation med konkurrenter for at identificere huller i din nuværende skemastrategi.
| Fejl | Problem | Løsning |
|---|---|---|
| Ufuldstændige egenskaber | Manglende gtin/mpn/aggregateRating får AI-systemer til at gætte | Gennemgå mod den fulde egenskabstabel, ikke kun platformens standard |
| Uoverensstemmende data | Skema-værdier adskiller sig fra hvad der vises på siden | Generér skema og sideindhold fra samme datakilde |
| Forældede egenskaber | Brug af skematyper eller felter som søgemaskiner ikke længere genkender | Gennemgå schema.org-ændringslogge kvartalsvis |
| Keyword stuffing | Oppustede beskrivelser eller falske anmeldelser i skemaet | Hold skemaet ærligt; AI-systemer opdager i stigende grad manipulation |
| Ingen realtidssynkronisering | Priser og lagerbeholdning bliver forældet i JSON-LD | Automatisér skemaregenerering ved dataændringer |
Ud over tabellen fortjener en strukturel fejl sin egen opmærksomhed: at implementere skema kun på desktop-skabeloner. Hvis dit mobil-tema gengiver en reduceret side, verificér at JSON-LD-blokken også er komplet, mobil-først indeksering betyder, at et tyndt mobil-skema kan underminere en ellers solid desktop-implementering.
Flere strategiske fejl forstærker disse tekniske problemer og koster specifikt virksomheder AI-synlighed. At behandle skema som et engangsprojekt snarere end en løbende forpligtelse: AI-platforme udvikler deres datakrav over tid og vægter forskellige egenskaber, efterhånden som deres shoppingfunktioner modnes, og en strategi, der gav mening for et år siden, kan efterlade synlighed på bordet i dag. At skrive produktbeskrivelser for søgeordstæthed i stedet for klarhed: AI-systemer straffer i stigende grad manipulerende produktbeskrivelser og belønner naturlige, præcise, som giver dem reel information at opsummere. Udelukkende at stole på tilstedeværelse på markedspladser: uden dit eget skema har du ingen kontrol over, hvordan AI-systemer karakteriserer dit brand i forhold til konkurrenter, der sælger samme produkt.
Når grundlaget er solidt, lader indlejrede skema-relationer dig beskrive mere komplekse kataloger: produktbundter og -sæt, kompatible tilbehør, reservedele og størrelses-/farvevarianter via ProductGroup og isVariantOf. Flersproget skema er vigtigt for internationale kataloger, implementér skema pr. sprogområde i stedet for at stole på én kanonisk sprogblok, da AI-systemer i stigende grad leverer sprogspecifikke anbefalinger. At holde dette strukturerede data komplet og synkroniseret på tværs af hver skabelon og hvert sprogområde understøtter også multi-kanal synlighed, da den samme underliggende JSON-LD fodrer AI Overviews, Perplexity, ChatGPT og stemmeassistenter samtidigt i stedet for at kræve separate implementeringer til hver.
Et bredere semantisk lag er også ved at opstå på tværs af e-handelsplatforme, der går ud over grundlæggende attributter til at inkludere relationer, anvendelsesmuligheder og bæredygtighedsdata, rigere end hvad de fleste skemaimplementeringer fanger i dag. Nye funktioner som visuel søgeintegration, stemmehandel og personlige anbefalinger vil i stigende grad være afhængige af omfattende, velstrukturerede produktdata for overhovedet at fungere. Ser man fremad, efterhånden som skematyper for konversationel handel modnes, der dækker flertrins produktopdagelse og agent-initierede transaktioner, forventes de at udvide dette egenskabssæt frem for at erstatte det, så en velstruktureret Product-implementering i dag er det fundament, som disse tilføjelser vil bygge på. Efterhånden som konkurrencen intensiveres blandt AI-shoppingplatforme, vil de forhandlere, der leverer de strukturerede data af højeste kvalitet, være dem, AI-systemer stoler på til at bygge overlegne anbefalingsoplevelser omkring, hvilket skaber et voksende incitament til at investere i skema nu, snarere end efter konkurrenter allerede har gjort krav på den tillid.
Yasha er en talentfuld softwareudvikler med speciale i Python, Java og maskinlæring. Yasha skriver tekniske artikler om AI, prompt engineering og chatbotudvikling.
AmICited sporer, hvordan AI-systemer refererer til dine produkter på tværs af ChatGPT, Perplexity, Google AI Overviews og meget mere. Verificér at din skemaimplementering bliver omsat til reelle AI-citationer.
Lær hvordan du optimerer produktsider til AI-søgemaskiner som ChatGPT og Perplexity. Opdag implementering af strukturerede data, indholdsstrategier og tekniske ...
Opdag hvilke typer schema markup der øger din synlighed i AI-søgemaskiner som ChatGPT, Perplexity og Gemini. Lær JSON-LD implementeringsstrategier for AI-svarge...
Cookie Samtykke
Vi bruger cookies til at forbedre din browsingoplevelse og analysere vores trafik. See our privacy policy.