


Product Schema
Product Schema is gestructureerde gegevensmarkering die zoekmachines en AI-systemen helpt productdetails te begrijpen. Leer hoe u het implementeert voor betere ...
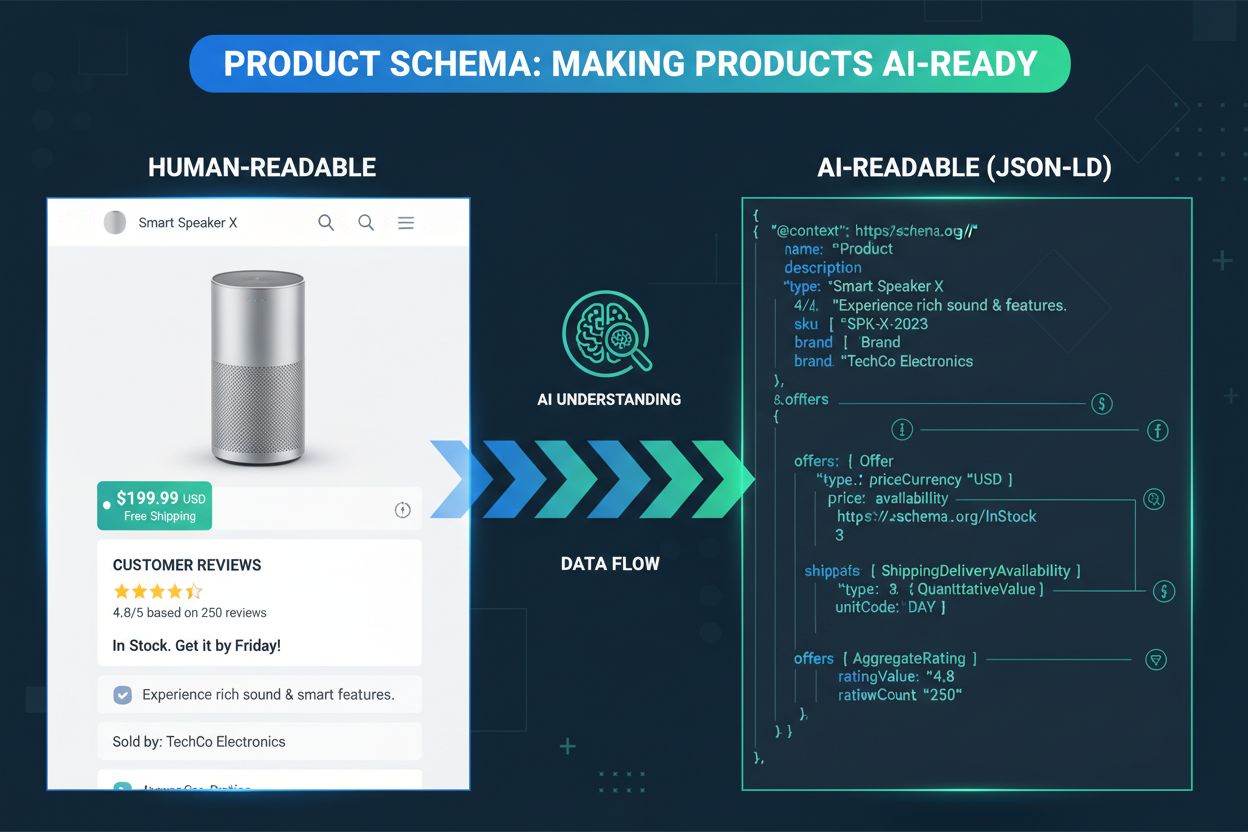
Een technische handleiding voor het implementeren van product schema markup: Schema.org Product-eigenschappen, JSON-LD-syntax, geneste Offer/AggregateRating/Review-types, platformconfiguratie en validatietools, plus welke AI-winkelzoekmachines die data daadwerkelijk lezen.
Uw e-commercesite kan geweldige producten, overtuigende beschrijvingen en concurrerende prijzen hebben, maar wanneer klanten AI-assistenten om aanbevelingen vragen, verschijnen concurrenten in plaats daarvan. Gestructureerde data-markup is meestal het verschil. In tegenstelling tot traditionele zoekmachines die vertrouwen op trefwoordmatching en paginacontentanalyse, zijn AI-winkelzoekmachines sterk afhankelijk van gestructureerde data om productkenmerken, relaties en context met precisie te begrijpen. Naarmate AI-winkelzoekmachines geavanceerder worden, bepaalt de volledigheid van uw product schema steeds meer of uw producten worden ontdekt, accuraat worden weergegeven en überhaupt worden aanbevolen aan potentiële klanten.
Deze gids behandelt zowel het waarom als het hoe: waarom product schema de AI-winkelzichtbaarheid stimuleert, welke AI-winkelzoekmachines het daadwerkelijk lezen, en de exacte eigenschappen, JSON-LD-syntax, geneste typen, platformconfiguratie en validatiestappen die nodig zijn om het in één keer goed te doen. Een correcte implementatie is belangrijk omdat AI-systemen geen betekenis kunnen afleiden uit een productpagina zoals een menselijke koper dat kan. Ze scannen op gestructureerde data in specifieke formaten en specifieke eigenschappen, en hiaten in die markup zijn hiaten in wat AI-systemen over uw product kunnen zeggen.
Wanneer een AI-winkelzoekmachine uw website crawlt, haalt het gestructureerde productgegevens op en voert het deze in zijn Knowledge Graph, een enorme database van onderling verbonden productinformatie die intelligente zoek- en aanbevelingsfuncties aandrijft. Dit is een fundamenteel ander proces dan traditionele trefwoordindexering.
| Aspect | Traditioneel Zoeken | AI-Winkelzoekmachines |
|---|---|---|
| Gegevensbron | Paginacontent + meta-tags | Gestructureerd schema + content |
| Begrip | Trefwoordgebaseerd matchen | Semantisch begrip |
| Productcontext | Beperkt | Uitgebreid |
| Aanbevelingskwaliteit | Basisfiltering | Geavanceerde AI-analyse |
Deze gestructureerde aanpak stelt AI-systemen in staat om niet alleen te begrijpen wat een product is, maar ook de specificaties, prijzen en beschikbaarheid in één verenigd, machineleesbaar profiel, in plaats van het uit verspreide paginatekst samen te stellen. De exacte eigenschappen die dit profiel voeden, worden hieronder in detail behandeld.

Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
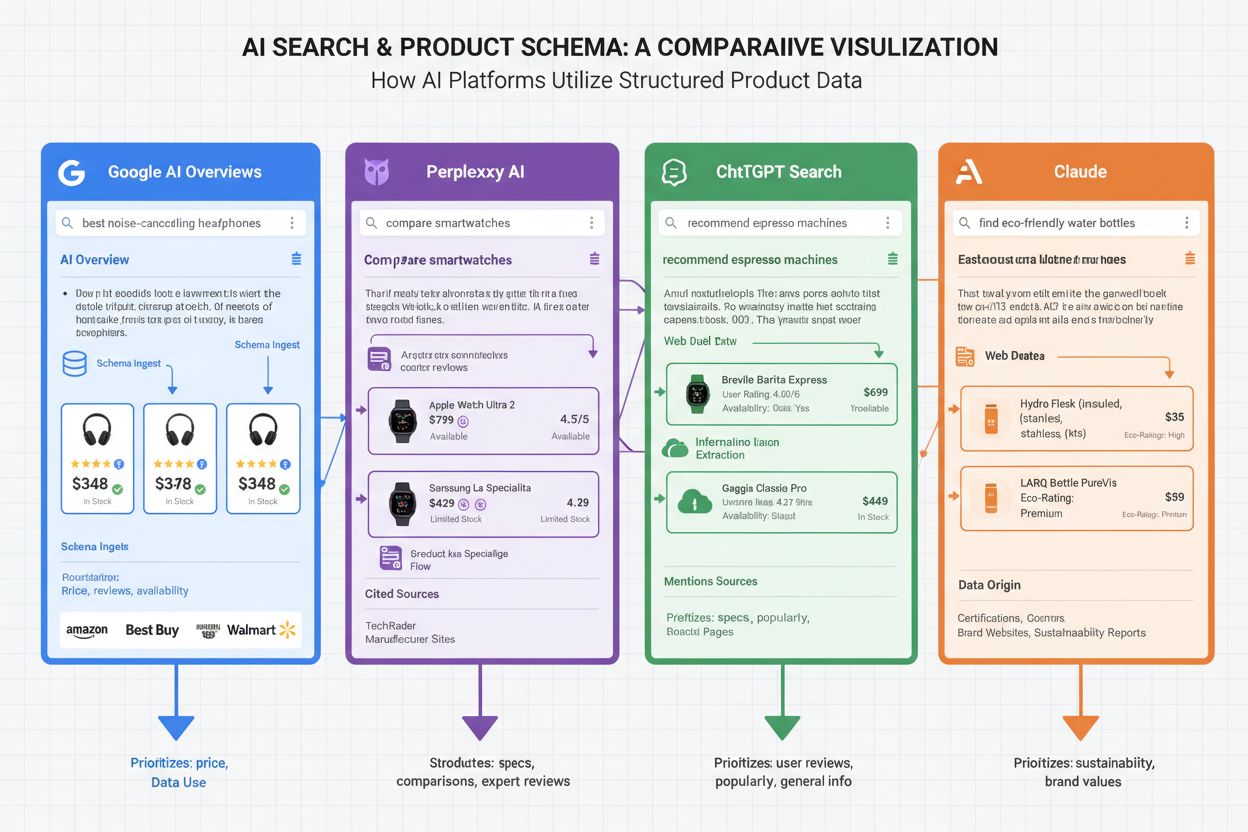
Niet elke AI-winkelzoekmachine weegt dezelfde eigenschappen op dezelfde manier, en het kennen van de verschillen helpt u te prioriteren waar u zich op moet richten. Google AI Overviews (voorheen SGE) vertrouwt sterk op product schema om AI-gestuurde winkeloverzichten te genereren die bovenaan de zoekresultaten verschijnen; de afhankelijkheid van volledige prijs-, beschikbaarheids- en beoordelingsgegevens maakt schema-implementatie cruciaal voor iedereen die in Google’s AI-functies wil verschijnen. Perplexity AI gebruikt product schema om accurate productinformatie, prijzen en beschikbaarheid te bieden in conversationele zoekresultaten, en citeert merkbaar vaker bronnen met goed gestructureerde data dan bronnen zonder. ChatGPT Search integreert product schema-gegevens om actuele prijzen, voorraadstatus en productbeschrijvingen te leveren wanneer gebruikers winkelgerelateerde vragen stellen, waarbij bronnen met uitgebreide gestructureerde data worden geprioriteerd boven bronnen waar het uit proza moet worden afgeleid. Claude en andere AI-assistenten verwijzen steeds vaker naar producten met correcte schema-markup bij het beantwoorden van consumentenvragen, omdat gestructureerde data betrouwbare, verifieerbare informatie biedt die gemakkelijker te vertrouwen is dan vrije-tekstclaims.
De standaardwoordenschat voor product schema-markup komt van Schema.org, een opensource-samenwerkingsproject ondersteund door Google, Microsoft, Yahoo en Yandex dat definieert hoe verschillende soorten content moeten worden gemarkeerd. Het Product-type is de ruggengraat van gestructureerde e-commercedata. Een volledige implementatie omvat minimaal: name (de exacte producttitel, overeenkomend met wat op de pagina staat), description, sku (uw interne voorraadeenheid), gtin of mpn (de wereldwijde identificatiecode van de fabrikant, nuttig voor het kruisverwijzen van uw aanbieding naar catalogusgegevens van de fabrikant), brand, image (een of meer URL’s, idealiter meerdere hoeken) en category. Geen van deze eigenschappen is optioneel als u wilt dat AI-systemen een volledig beeld hebben; een onvolledig Product-blok is een van de meest voorkomende redenen waarom producten worden overgeslagen in AI-gegenereerde aanbevelingen.
| Eigenschap | Type | Doel |
|---|---|---|
name | Tekst | Exacte producttitel voor matching |
sku / gtin / mpn | Tekst | Unieke identificatiegegevens, voorkomt dubbele aanbiedingen |
brand | Brand-object | Fabrikant- of merknaam |
image | URL(’s) | Visuele data die AI-systemen kunnen analyseren |
category | Tekst | Classificatie voor filteren en vergelijken |
offers | Offer-object | Prijs, beschikbaarheid, aankoop-URL |
aggregateRating | AggregateRating-object | Algemene beoordelingsscore |
review | Review-object(en) | Individuele klantfeedback |
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
De top-level Product-eigenschappen brengen u slechts halverwege; de geneste objecten bevatten de meeste bruikbare details. Het Offer-object bevat price, priceCurrency, availability (met behulp van Schema.org’s gecontroleerde woordenschat zoals https://schema.org/InStock), url, en optioneel priceValidUntil voor tijdsgebonden prijzen. Zonder een geldig Offer hebben AI-systemen geen betrouwbaar antwoord op “is dit op voorraad en hoeveel kost het”, wat vaak de doorslaggevende factor is of een product überhaupt wordt aanbevolen. Het AggregateRating-object bevat ratingValue, reviewCount, en optioneel bestRating/worstRating om de schaal te definiëren; als u de schaal weglaat, nemen sommige parsers een standaard aan die mogelijk niet overeenkomt met uw werkelijke beoordelingssysteem. Het Review-object nest individuele reviews met author, reviewBody, datePublished, en een reviewRating-subobject. U hoeft niet elke review in uw Product schema in te bedden (dat maakt de pagina te groot); het inbedden van een representatieve steekproef naast de aggregate is de standaardpraktijk.
JSON-LD (JavaScript Object Notation for Linked Data) is het voorkeursimplementatieformaat omdat het in één enkel, zelfstandig <script>-blok leeft in plaats van verspreid over HTML-attributen; het scheiden van gestructureerde data van uw markup maakt beide eenvoudiger te onderhouden. Hier is een volledig voorbeeld dat de bovenstaande eigenschappen combineert:
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Premium Waterdichte Wandelschoenen",
  "description": "Duurzame waterdichte wandelschoenen met enkelondersteuning en gripzool",
  "image": "https://example.com/hiking-boots.jpg",
  "brand": {
    "@type": "Brand",
    "name": "TrailMaster"
  },
  "offers": {
    "@type": "Offer",
    "price": "149.99",
    "priceCurrency": "USD",
    "availability": "https://schema.org/InStock",
    "url": "https://example.com/hiking-boots"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.7",
    "reviewCount": "328"
  },
  "sku": "HB-WP-001",
  "mpn": "TRAILMASTER-HB-2024"
}
Dit blok moet worden geplaatst binnen <script type="application/ld+json">-tags, ofwel in de pagina-<head> of in de paginabody; beide zijn geldig, maar het plaatsen in de <head> betekent dat AI-crawlers het tegenkomen voordat ze de rest van de paginacontent moeten parseren.
De meeste e-commerceplatformen genereren automatisch enig basisschema, maar “enig” doet veel werk in die zin. Shopify-thema’s geven doorgaans standaard name, price en availability weer, maar slaan vaak aggregateRating en review over; als uw thema niet standaard reviewschema ondersteunt, heeft u een review-app nodig die zijn eigen JSON-LD schrijft of een aangepaste Liquid-sjabloontoevoeging. WooCommerce-implementaties variëren enorm afhankelijk van welke SEO-plugin actief is; Yoast en RankMath genereren beide Product schema, maar de dekking van geneste Offer- en Review-eigenschappen verschilt tussen beide, dus controleer de daadwerkelijke output in plaats van aan te nemen dat de plugin alles afhandelt. Magento’s ingebouwde Product schema is relatief sterk uit de doos, maar mist vaak gtin/mpn, wat ertoe doet als AI-systemen uw aanbieding kruisverwijzen met fabrikantgegevens. In elk geval is de oplossing hetzelfde: bekijk de paginabron, vind uw JSON-LD-blok en controleer het aan de hand van de bovenstaande eigenschappentabel, in plaats van te vertrouwen op “het platform regelt het schema” als volledig antwoord, vooral als u ook optimaliseert voor AI-zoekopdrachten op meerdere platforms tegelijk.
Implementatie is pas klaar als het is gevalideerd. Google’s Rich Results Test controleert of uw schema niet alleen technisch geldig is, maar ook in aanmerking komt voor uitgebreide zoekfuncties; voer elke sjabloon erdoorheen, niet slechts één voorbeeldpagina. Schema.org’s eigen validator vangt syntaxfouten op die Rich Results Test mogelijk niet markeert. Google Search Console toont schema-gerelateerde fouten en waarschuwingen op uw hele site in de loop van de tijd, wat de beste manier is om regressies op te sporen na een thema-update of plugin-wijziging. Voordat u schema-wijzigingen sitebreed uitrolt, test u op een representatieve subset van pagina’s; verschillende producttypen (bundels, varianten, uitverkochte artikelen) hebben de neiging om sjablonen op verschillende manieren te breken, en het opsporen daarvan op tien pagina’s is veel goedkoper dan het opsporen op tienduizend.
Statisch schema dat veroudert, is misschien wel erger dan helemaal geen schema, omdat het AI-systemen actief verkeerde informatie voedt. Realtime data-updates zijn niet onderhandelbaar voor prijs en beschikbaarheid; implementeer geautomatiseerde processen die schema regenereren wanneer uw productdatabase verandert, in plaats van te vertrouwen op handmatige bewerkingen of periodieke batchtaken. Het meest betrouwbare patroon is het halen van schema-data uit dezelfde bron van waarheid als uw zichtbare paginacontent, zodat de twee nooit uit elkaar kunnen groeien. AI-systemen wegen consistentie en actualiteit bij het bepalen welke bronnen ze vertrouwen voor aanbevelingen, en een schema-blok dat al drie weken niet overeenkomt met de werkelijkheid, doet meer kwaad dan goed.
De opbrengst van schema-implementatie verschijnt volgens een voorspelbare tijdlijn. Rich result-vertoningen verbeteren doorgaans binnen 2-4 weken na correcte implementatie, eerst zichtbaar in Google Search Console. AI Overview-verschijningen en spraakzoekzichtbaarheid volgen meestal binnen 4-8 weken. Bedrijfsmetrics, conversieratio-verbeteringen en stijgingen van de gemiddelde bestelwaarde, verschijnen doorgaans binnen 2-3 maanden, zodra AI-systemen voldoende blootstelling aan uw gestructureerde data hebben gehad om uw aanbiedingen consistent te vertrouwen en aan te bevelen.
Daarom is schema een zakelijke beslissing, niet alleen een technisch vinkje. Als u op meerdere marktplaatsen én uw eigen site verkoopt, is het implementeren van schema op uw eigen domein nog steeds belangrijk: het vestigt uw site als de gezaghebbende bron die AI-systemen direct kunnen citeren, in plaats van AI-winkelzoekmachines uitsluitend te laten putten uit marktplaatslijsten die u niet volledig beheert. Nu AI-winkelassistenten steeds vaker direct producten aanbevelen, wilt u dat ze u citeren, niet alleen de marktplaats die toevallig uw aanbieding host.
Het meten van de zakelijke impact van schema vereist het volgen van metrics die verder gaan dan traditionele SEO. AmICited.com biedt een gecentraliseerd dashboard waar u kunt monitoren hoe vaak uw producten verschijnen in AI-zoekresultaten op verschillende platforms, zodat u niet elke week handmatig dezelfde vragen aan ChatGPT en Perplexity hoeft te stellen. ROI-tracking omvat het vergelijken van de kosten van het implementeren en onderhouden van schema met de inkomsten gegenereerd door AI-verwezen klanten, wat helpt om voortdurende investeringen te rechtvaardigen. Voordat u echter op deze cijfers kunt vertrouwen, is het de moeite waard om de basis-AI-crawlertoegang tot uw pagina’s te bevestigen; citatietracking is zinloos als de crawlers uw productpagina’s niet kunnen bereiken. Stel meldingen in voor wanneer uw producten worden geciteerd in grote AI-platforms en vergelijk uw prestaties met concurrenten om hiaten in uw huidige schemastrategie te identificeren.
| Fout | Probleem | Oplossing |
|---|---|---|
| Onvolledige eigenschappen | Ontbrekende gtin/mpn/aggregateRating laat AI-systemen gissen | Controleer aan de hand van de volledige eigenschappentabel, niet alleen de standaard van het platform |
| Niet-overeenkomende data | Schema-waarden verschillen van wat op de pagina wordt getoond | Genereer schema en paginacontent uit dezelfde gegevensbron |
| Verouderde eigenschappen | Gebruik van schematypen of velden die zoekmachines niet meer herkennen | Bekijk schema.org-wijzigingslogs per kwartaal |
| Trefwoordproppen | Opgeblazen beschrijvingen of nepreviews in schema | Houd schema eerlijk; AI-systemen detecteren steeds vaker manipulatie |
| Geen realtime-synchronisatie | Prijzen en voorraad worden verouderd in de JSON-LD | Automatiseer schemaregeneratie bij datawijziging |
Naast de tabel verdient één structurele fout een eigen vermelding: schema alleen implementeren op desktop-sjablonen. Als uw mobiele thema een uitgeklede pagina weergeeft, controleer dan of het JSON-LD-blok ook compleet is; mobile-first indexering betekent dat een dun mobiel schema een anderszins solide desktop-implementatie kan ondermijnen.
Een paar strategische fouten versterken deze technische fouten en kosten bedrijven specifiek AI-zichtbaarheid. Schema behandelen als een eenmalig project in plaats van een doorlopende verplichting: AI-platforms evolueren hun datavereisten in de loop van de tijd, waarbij ze verschillende eigenschappen zwaarder wegen naarmate hun winkel-functies volwassener worden, en een strategie die een jaar geleden zinvol was, kan nu zichtbaarheid op tafel laten liggen. Productbeschrijvingen schrijven voor trefwoorddichtheid in plaats van helderheid: AI-systemen bestraffen steeds vaker manipulerende productbeschrijvingen en belonen natuurlijke, accurate beschrijvingen die hen echte informatie geven om samen te vatten. Uitsluitend vertrouwen op marktplaatsaanwezigheid: zonder uw eigen schema heeft u nul controle over hoe AI-systemen uw merk karakteriseren ten opzichte van concurrenten die hetzelfde product verkopen. Zie ook de technische fouten die het vaakst de AI-zoekprestaties in bredere zin schaden.
Zodra de basis op orde is, kunt u met geneste schemarelaties complexere catalogi beschrijven: productbundels en -sets, compatibele accessoires, vervangingsonderdelen en maat-/kleurvarianten via ProductGroup en isVariantOf. Meertalig schema is belangrijk voor internationale catalogi; implementeer schema per landinstelling in plaats van te vertrouwen op één canoniek taalblok, aangezien AI-systemen steeds vaker taalspecifieke aanbevelingen doen. Het compleet en gesynchroniseerd houden van deze gestructureerde data op elke sjabloon en landinstelling ondersteunt ook multi-channel zichtbaarheid, aangezien dezelfde onderliggende JSON-LD tegelijkertijd AI Overviews, Perplexity, ChatGPT en spraakassistenten voedt, in plaats van afzonderlijke implementaties voor elk kanaal te vereisen.
Er ontstaat ook een bredere semantische laag binnen e-commerceplatforms, een die verder gaat dan basisattributen en relaties, gebruiksscenario’s en duurzaamheidsdata omvat — rijker dan wat de meeste schema-implementaties vandaag vastleggen. Opkomende mogelijkheden zoals visuele zoekintegratie, spraakhandel en gepersonaliseerde aanbevelingen zullen steeds meer afhankelijk zijn van uitgebreide, goed gestructureerde productgegevens om te kunnen functioneren. Vooruitkijkend, naarmate conversationele handel-schematypen volwassener worden en multi-turn productontdekking en door agenten geïnitieerde transacties omvatten, zullen ze naar verwachting deze eigenschappenset uitbreiden in plaats van vervangen, dus een goed gestructureerde Product-implementatie vandaag is de basis waarop die toevoegingen zullen voortbouwen. Naarmate de concurrentie tussen AI-winkelplatforms toeneemt, zullen de handelaren die de hoogste kwaliteit gestructureerde data leveren, degenen zijn die AI-systemen vertrouwen om superieure aanbevelingservaringen omheen te bouwen, wat een cumulatieve prikkel creëert om nu in schema te investeren in plaats van nadat concurrenten dat vertrouwen al hebben opgeëist.
Yasha is een getalenteerde softwareontwikkelaar gespecialiseerd in Python, Java en machine learning. Yasha schrijft technische artikelen over AI, prompt engineering en chatbotontwikkeling.
AmICited volgt hoe AI-systemen naar uw producten verwijzen via ChatGPT, Perplexity, Google AI Overviews en meer. Controleer of uw schema-implementatie wordt omgezet in echte AI-citaties.
Product Schema is gestructureerde gegevensmarkering die zoekmachines en AI-systemen helpt productdetails te begrijpen. Leer hoe u het implementeert voor betere ...
Leer hoe u Organization schema markup implementeert voor AI-zichtbaarheid. Stapsgewijze gids voor het toevoegen van JSON-LD gestructureerde data, het verbeteren...
Cookie Toestemming
We gebruiken cookies om uw browse-ervaring te verbeteren en ons verkeer te analyseren. See our privacy policy.