


Product Schema
Product Schema je značkování strukturovaných dat, které pomáhá vyhledávačům a AI systémům porozumět detailům produktů. Naučte se, jak jej implementovat pro lepš...
24 min čtení
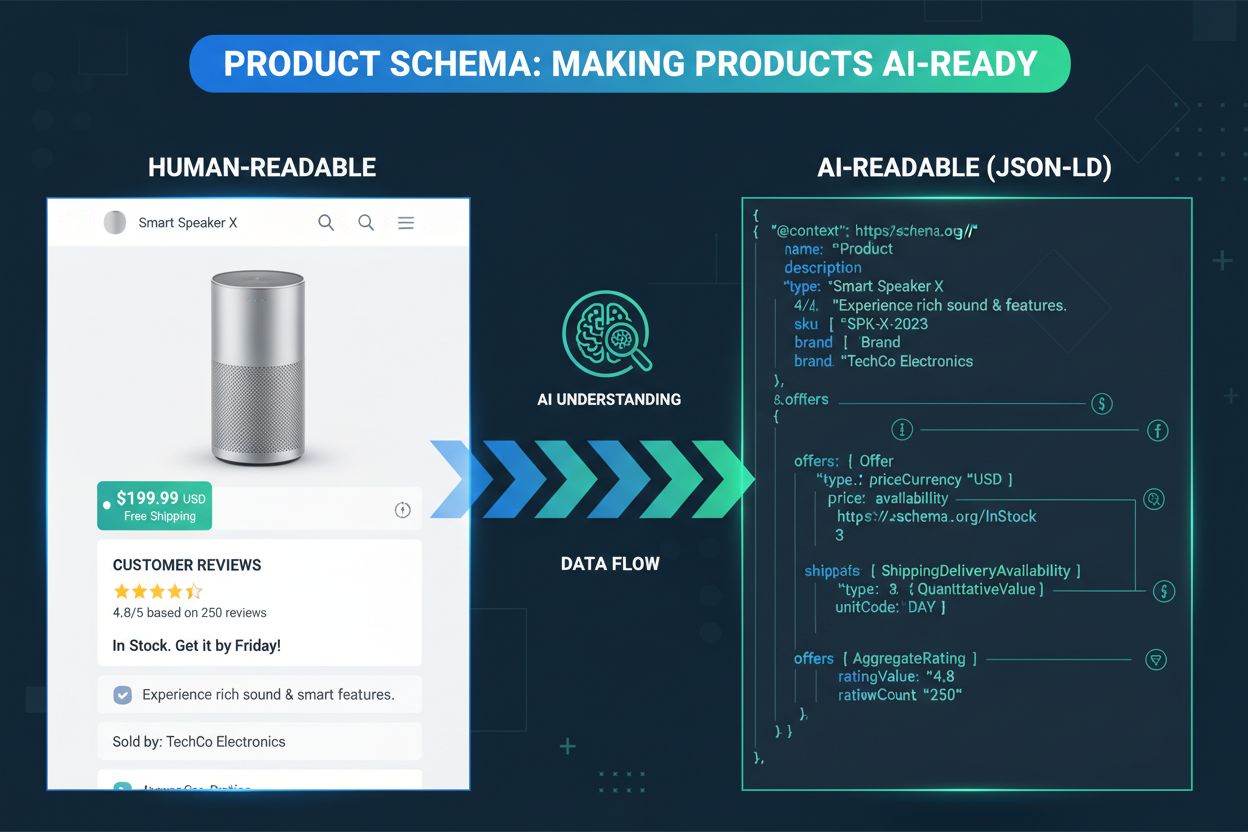
Technický návod implementace značkování produktového schématu: Schema.org vlastnosti produktů, syntaxe JSON-LD, vnořené typy Offer/AggregateRating/Review, nastavení platforem a validační nástroje, včetně toho, které AI nákupní enginy tato data skutečně čtou.
Váš e-shop může mít skvělé produkty, působivé popisy a konkurenceschopné ceny, ale když se zákazníci ptají AI asistentů na doporučení, objeví se místo vašich produktů konkurence. Rozdíl obvykle dělá strukturované datové značkování. Na rozdíl od tradičních vyhledávačů, které se opírají o přiřazování klíčových slov a analýzu obsahu stránky, AI nákupní enginy silně závisí na strukturovaných datech, aby s přesností porozuměly atributům produktů, vztahům a kontextu. S tím, jak jsou AI nákupní enginy stále sofistikovanější, úplnost vašeho produktového schématu stále více určuje, zda jsou vaše produkty vůbec objeveny, přesně reprezentovány a doporučovány potenciálním zákazníkům.
Tento průvodce pokrývá jak „proč", tak „jak": proč produktové schéma pohání viditelnost v AI nakupování, které AI nákupní enginy ho skutečně čtou, a přesné vlastnosti, syntaxi JSON-LD, vnořené typy, nastavení platforem a validační kroky potřebné k tomu, aby bylo vše správně napoprvé. Správná implementace je důležitá, protože AI systémy nedokážou odvodit význam z produktové stránky tak, jako to dokáže lidský zákazník. Skenují strukturovaná data v konkrétních formátech a konkrétních vlastnostech a mezery v tomto značkování jsou mezerami v tom, co o vašem produktu mohou AI systémy říci.
Když AI nákupní engine prochází váš web, extrahuje strukturovaná produktová data a vkládá je do svého znalostního grafu, rozsáhlé databáze propojených informací o produktech, která pohání inteligentní vyhledávání a doporučovací funkce. Jedná se o zásadně odlišný proces než tradiční indexování klíčových slov.
| Aspekt | Tradiční vyhledávání | AI nákupní enginy |
|---|---|---|
| Zdroj dat | Obsah stránky + meta tagy | Strukturované schéma + obsah |
| Porozumění | Přiřazování klíčových slov | Sémantické porozumění |
| Kontext produktu | Omezený | Komplexní |
| Kvalita doporučení | Základní filtrování | Pokročilá AI analýza |
Tento strukturovaný přístup umožňuje AI systémům porozumět nejen tomu, co produkt je, ale také jeho specifikacím, ceně a dostupnosti v jednom jednotném, strojově čitelném profilu, namísto skládání informací z rozptýleného textu stránky. Přesné vlastnosti, které tento profil napájejí, jsou podrobně popsány níže.
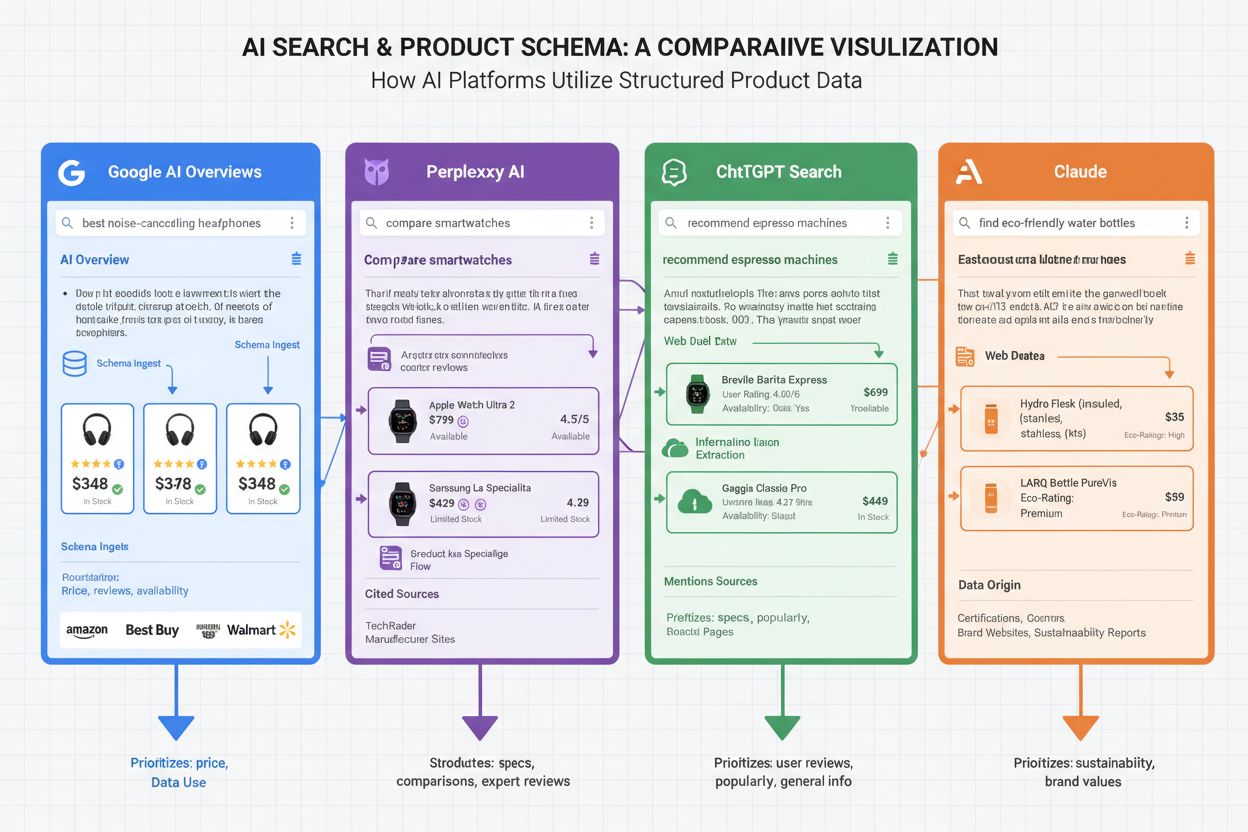
Ne každý AI nákupní engine váží stejné vlastnosti stejným způsobem a znalost rozdílů vám pomůže určit priority. Google AI Overviews (dříve SGE) silně spoléhá na produktové schéma při generování AI nákupních souhrnů, které se zobrazují v horní části výsledků vyhledávání; jeho závislost na úplných datech o ceně, dostupnosti a hodnocení činí implementaci schématu kritickou pro každého, kdo se snaží objevit v AI funkcích Googlu. Perplexity AI používá produktové schéma k poskytování přesných informací o produktu, ceně a dostupnosti ve svých konverzačních výsledcích vyhledávání a znatelně upřednostňuje citování zdrojů s dobře strukturovanými daty před těmi bez nich. ChatGPT Search integruje data produktového schématu k doručování aktuálních cen, stavu skladu a popisů produktů, když uživatelé pokládají nákupní otázky, a upřednostňuje zdroje s komplexními strukturovanými daty před těmi, z nichž musí informace odvozovat z textu. Claude a další AI asistenti stále častěji odkazují na produkty se správným značkováním schématu při zodpovídání spotřebitelských otázek, protože strukturovaná data poskytují spolehlivé, ověřitelné informace, kterým lze snáze důvěřovat než tvrzením z volného textu.
Standardní slovník pro značkování produktového schématu pochází z Schema.org, otevřeného kolaborativního projektu podporovaného Googlem, Microsoftem, Yahoo a Yandex, který definuje, jak označovat různé typy obsahu. Typ Product je páteří e-commerce strukturovaných dat. Minimálně úplná implementace zahrnuje: name (přesný název produktu, odpovídající tomu, co je na stránce), description (popis), sku (vaše interní skladové číslo), gtin nebo mpn (globální identifikátor výrobce, užitečný pro křížové odkazování vašeho výpisu s katalogovými daty výrobce), brand (značka), image (jedna nebo více URL, ideálně z více úhlů) a category (kategorie). Žádná z těchto vlastností není volitelná, pokud chcete, aby měly AI systémy úplný obrázek – neúplný blok Product je jedním z nejčastějších důvodů, proč jsou produkty v AI-generovaných doporučeních přeskakovány.
| Vlastnost | Typ | Účel |
|---|---|---|
name | Text | Přesný název produktu pro přiřazování |
sku / gtin / mpn | Text | Jedinečné identifikátory, zabraňuje duplicitním výpisům |
brand | Objekt Brand | Výrobce nebo název značky |
image | URL | Vizuální data, která mohou AI systémy analyzovat |
category | Text | Klasifikace pro filtrování a srovnání |
offers | Objekt Offer | Cena, dostupnost, URL pro nákup |
aggregateRating | Objekt AggregateRating | Celkové skóre hodnocení |
review | Objekt(y) Review | Jednotlivé zpětné vazby zákazníků |

Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Vlastnosti nejvyšší úrovně Product vás dostanou jen do poloviny – vnořené objekty obsahují většinu užitečných detailů. Objekt Offer nese price (cena), priceCurrency (měna), availability (dostupnost – s použitím řízeného slovníku Schema.org jako https://schema.org/InStock), url a volitelně priceValidUntil pro časově omezené ceny. Bez platného Offer nemají AI systémy spolehlivou odpověď na otázku „je to skladem a kolik to stojí", což je často rozhodující faktor, zda je produkt vůbec doporučen. Objekt AggregateRating nese ratingValue (hodnota hodnocení), reviewCount (počet recenzí) a volitelně bestRating/worstRating pro definici škály; vynecháním škály některé parsery předpokládají výchozí hodnotu, která nemusí odpovídat vašemu skutečnému systému hodnocení. Objekt Review vnořuje jednotlivé recenze s author (autor), reviewBody (text recenze), datePublished (datum publikace) a podobjektem reviewRating. Nemusíte do svého produktového schématu vkládat každou recenzi (to by stránku nafouklo); standardní praxí je vložit reprezentativní vzorek spolu s agregovanými údaji.
JSON-LD (JavaScript Object Notation for Linked Data) je preferovaným implementačním formátem, protože žije v jediném, samostatném bloku <script> namísto rozptýlení napříč HTML atributy – oddělení strukturovaných dat od vašeho kódu usnadňuje údržbu obojího. Zde je kompletní příklad kombinující výše uvedené vlastnosti:
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Premium Waterproof Hiking Boots",
  "description": "Durable waterproof hiking boots with ankle support and grip sole",
  "image": "https://example.com/hiking-boots.jpg",
  "brand": {
    "@type": "Brand",
    "name": "TrailMaster"
  },
  "offers": {
    "@type": "Offer",
    "price": "149.99",
    "priceCurrency": "USD",
    "availability": "https://schema.org/InStock",
    "url": "https://example.com/hiking-boots"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.7",
    "reviewCount": "328"
  },
  "sku": "HB-WP-001",
  "mpn": "TRAILMASTER-HB-2024"
}
Tento blok by měl být umístěn uvnitř tagů <script type="application/ld+json">, buď v <head> stránky, nebo v těle stránky – obojí je platné, ale umístění v <head> znamená, že se s ním AI crawleři setkají dříve, než musí zpracovávat zbytek obsahu stránky.
Většina e-commerce platforem generuje nějaké základní schéma automaticky, ale „nějaké" v této větě dělá hodně práce. Shopify šablony typicky výchozím způsobem generují name, price a availability, ale často vynechávají aggregateRating a review; pokud vaše šablona nativně nepodporuje schéma recenzí, budete potřebovat aplikaci pro recenze, která zapisuje vlastní JSON-LD, nebo vlastní doplněk Liquid šablony. WooCommerce implementace se enormně liší v závislosti na tom, který SEO plugin je aktivní; Yoast i RankMath generují produktové schéma, ale pokrytí vnořených vlastností Offer a Review se mezi nimi liší, proto auditovat skutečný výstup, než předpokládat, že plugin řeší vše. Magento vestavěné produktové schéma je ve výchozím stavu poměrně silné, ale běžně vynechává gtin/mpn, což je důležité, pokud AI systémy křížově odkazují váš výpis s daty výrobce. V každém případě je řešení stejné: zobrazte zdrojový kód stránky, najděte svůj JSON-LD blok a zkontrolujte ho oproti tabulce vlastností výše, namísto důvěry v to, že „platforma schéma řeší" – zvláště pokud zároveň optimalizujete pro AI vyhledávání napříč více platformami.
Implementace není hotová, dokud není validována. Google Rich Results Test kontroluje, zda je vaše schéma nejen technicky platné, ale také způsobilé pro rozšířené funkce vyhledávání – protáhněte jím každou šablonu, nejen jeden vzorový produkt. Vlastní validátor Schema.org zachycuje syntaktické chyby, které Rich Results Test nemusí odhalit. Google Search Console v průběhu času odhaluje chyby a varování související se schématem napříč celým webem, což je nejlepší způsob, jak zachytit regrese po aktualizaci šablony nebo změně pluginu. Před celoplošným nasazením změn schématu testujte na reprezentativní podmnožině stránek – různé typy produktů (balíčky, varianty, nedostupné položky) mají tendenci rozbíjet šablony různými způsoby a zachytit to na deseti stránkách je mnohem levnější než na deseti tisících.
Statické schéma, které zastará, je pravděpodobně horší než žádné schéma, protože aktivně krmí AI systémy nesprávnými informacemi. Aktualizace dat v reálném čase jsou nevyjednatelné pro cenu a dostupnost; implementujte automatizované procesy, které regenerují schéma při každé změně produktové databáze, namísto spoléhání na ruční úpravy nebo periodické dávkové úlohy. Nejspolehlivějším vzorem je získávání dat schématu ze stejného zdroje pravdy jako viditelný obsah stránky, takže se nikdy nemohou rozejít. AI systémy váží konzistenci a aktuálnost při rozhodování, kterým zdrojům důvěřovat pro doporučení, a blok schématu, který již tři týdny neodpovídá realitě, nadělá více škody než užitku.
Návratnost implementace schématu se projevuje v předvídatelném časovém horizontu. Imprese bohatých výsledků se typicky zlepší během 2–4 týdnů po správné implementaci, viditelné nejprve v Google Search Console. Výskyty v AI Overviews a zlepšení viditelnosti v hlasovém vyhledávání obvykle následují během 4–8 týdnů. Obchodní metriky – zlepšení konverzního poměru a zvýšení průměrné hodnoty objednávky – se obvykle projeví během 2–3 měsíců, jakmile mají AI systémy dostatek expozice vašim strukturovaným datům, aby vašim výpisům důvěřovaly a konzistentně je doporučovaly.
To je důvod, proč je schéma obchodním rozhodnutím, nejen technickým zaškrtávacím políčkem. Pokud prodáváte napříč vícero tržišti i na vlastním webu, implementace schématu na vlastní doméně stále záleží: ustanovuje váš web jako autoritativní zdroj, který mohou AI systémy přímo citovat, namísto toho, aby AI nákupní enginy čerpaly výhradně z výpisů na tržištích, která plně nekontrolujete. S tím, jak AI nákupní asistenti stále častěji přímo doporučují produkty, chcete, aby citovali vás, nejen tržiště, které náhodou hostí váš výpis.
Měření obchodního dopadu schématu vyžaduje sledování metrik přesahujících tradiční SEO. AmICited.com poskytuje centralizovaný dashboard, kde můžete sledovat, jak často se vaše produkty objevují ve výsledcích AI vyhledávání napříč různými platformami, abyste nemuseli každý týden ručně pokládat stejné otázky ChatGPT a Perplexity. Sledování ROI zahrnuje porovnání nákladů na implementaci a údržbu schématu s výnosy generovanými zákazníky z AI doporučení, což pomáhá ospravedlnit pokračující investice. Než však budete moci těmto číslům důvěřovat, vyplatí se potvrdit základní přístup AI crawlerů k vašim stránkám – sledování citací je bezvýznamné, pokud se crawleři nemohou na vaše produktové stránky vůbec dostat. Nastavte si upozornění na okamžiky, kdy jsou vaše produkty citovány na hlavních AI platformách, a porovnávejte svůj výkon s konkurencí, abyste identifikovali mezery ve své aktuální strategii schématu.
| Chyba | Problém | Řešení |
|---|---|---|
| Neúplné vlastnosti | Chybějící gtin/mpn/aggregateRating nechává AI systémy hádat | Audit proti úplné tabulce vlastností, nejen výchozímu nastavení platformy |
| Nesouhlasná data | Hodnoty schématu se liší od toho, co je zobrazeno na stránce | Generujte schéma a obsah stránky ze stejného zdroje dat |
| Zastaralé vlastnosti | Používání typů nebo polí schématu, které vyhledávače již nerozpoznávají | Kontrolujte changelogy schema.org čtvrtletně |
| Keyword stuffing | Nafukování popisů nebo falešné recenze uvnitř schématu | Udržujte schéma poctivé; AI systémy stále lépe detekují manipulaci |
| Žádná synchronizace v reálném čase | Ceny a skladové zásoby v JSON-LD zastarávají | Automatizujte regeneraci schématu při změně dat |
Kromě tabulky si jedna strukturální chyba zaslouží vlastní zmínku: implementace schématu pouze na desktopových šablonách. Pokud vaše mobilní šablona vykresluje zjednodušenou stránku, ověřte, že její JSON-LD blok je také kompletní – mobilní-first indexace znamená, že slabé mobilní schéma může podkopat jinak solidní desktopovou implementaci.
Několik strategických chyb tyto technické prohlubuje a konkrétně stojí firmy AI viditelnost. Považovat schéma za jednorázový projekt namísto průběžného závazku: AI platformy v průběhu času vyvíjejí své datové požadavky, váží různé vlastnosti podle toho, jak jejich nákupní funkce dozrávají, a strategie, která dávala smysl před rokem, dnes může nechávat viditelnost na stole. Psát popisy produktů pro hustotu klíčových slov namísto srozumitelnosti: AI systémy stále více penalizují manipulativní popisy produktů a odměňují přirozené, přesné popisy, které jim poskytují skutečné informace k sumarizaci. Spoléhat se výhradně na přítomnost na tržištích: bez vlastního schématu máte nulovou kontrolu nad tím, jak AI systémy charakterizují vaši značku vůči konkurentům prodávajícím stejný produkt. Viz také technické chyby , které nejčastěji poškozují výkon v AI vyhledávání v širším smyslu.
Jakmile jsou základy pevné, vnořené vztahy schématu vám umožní popsat komplexnější katalogy: produktové balíčky a sady, kompatibilní příslušenství, náhradní díly a varianty velikostí/barev pomocí ProductGroup a isVariantOf. Vícejazyčné schéma je důležité pro mezinárodní katalogy; implementujte schéma pro každou jazykovou mutaci namísto spoléhání na jeden kanonický jazykový blok, protože AI systémy stále častěji poskytují jazykově specifická doporučení. Udržování těchto strukturovaných dat kompletních a synchronizovaných napříč každou šablonou a jazykovou mutací také podporuje multi-kanálovou viditelnost, protože stejný základní JSON-LD současně napájí AI Overviews, Perplexity, ChatGPT a hlasové asistenty, namísto vyžadování samostatných implementací pro každý z nich.
Širší sémantická vrstva se také objevuje napříč e-commerce platformami – taková, která jde nad rámec základních atributů a zahrnuje vztahy, případy použití a údaje o udržitelnosti, bohatší než to, co většina implementací schématu dnes zachycuje. Vznikající schopnosti jako integrace vizuálního vyhledávání, hlasového obchodu a personalizovaných doporučení budou stále více záviset na komplexních, dobře strukturovaných produktových datech, aby vůbec fungovaly. Do budoucna, jak budou dozrávat typy schémat pro konverzační obchod pokrývající vícekolové objevování produktů a transakce iniciované agenty, očekává se, že tuto sadu vlastností rozšíří, nikoli nahradí – takže dobře strukturovaná implementace Product je dnes základem, na kterém tato rozšíření postaví. S rostoucí konkurencí mezi AI nákupními platformami budou obchodníci poskytující nejkvalitnější strukturovaná data těmi, kterým AI systémy důvěřují při vytváření lepších zážitků z doporučení, což vytváří rostoucí motivaci investovat do schématu nyní, nikoli až poté, co si konkurenti již nárokovali tuto důvěru.
Yasha je talentovaný softwarový vývojář specializující se na Python, Javu a strojové učení. Yasha píše odborné články o AI, prompt engineeringu a vývoji chatbotů.
AmICited sleduje, jak AI systémy odkazují na vaše produkty napříč ChatGPT, Perplexity, Google AI Overviews a dalšími. Ověřte si, že vaše implementace schématu se promítá do reálných AI citací.
Product Schema je značkování strukturovaných dat, které pomáhá vyhledávačům a AI systémům porozumět detailům produktů. Naučte se, jak jej implementovat pro lepš...
Zjistěte, jak optimalizovat produktové stránky pro AI vyhledávače jako ChatGPT a Perplexity. Objevte implementaci strukturovaných dat, obsahové strategie a tech...
Souhlas s cookies
Používáme cookies ke zlepšení vašeho prohlížení a analýze naší návštěvnosti. See our privacy policy.