


Produktskjema
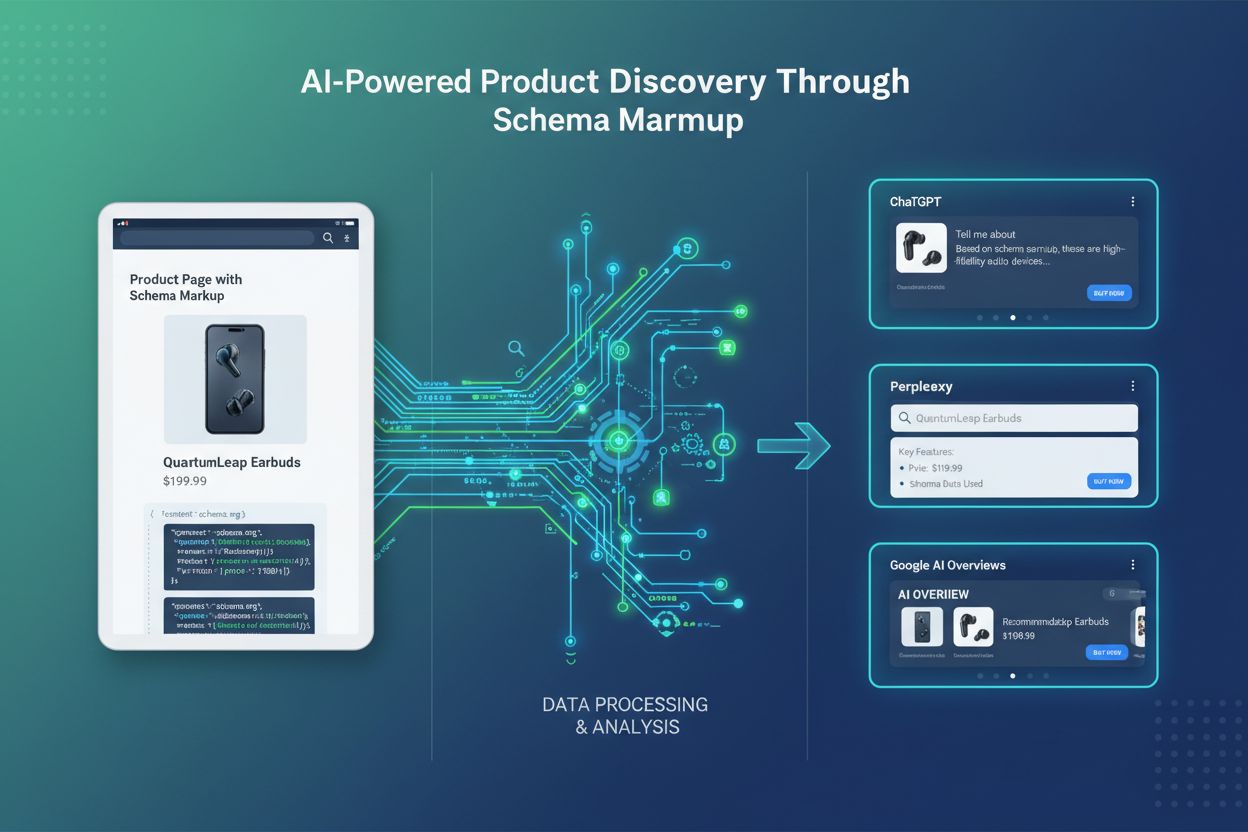
Produktskjema er strukturert dataoppmerking som hjelper søkemotorer og AI-systemer med å forstå produktdetaljer. Lær hvordan du implementerer det for bedre synl...
22 min lesing
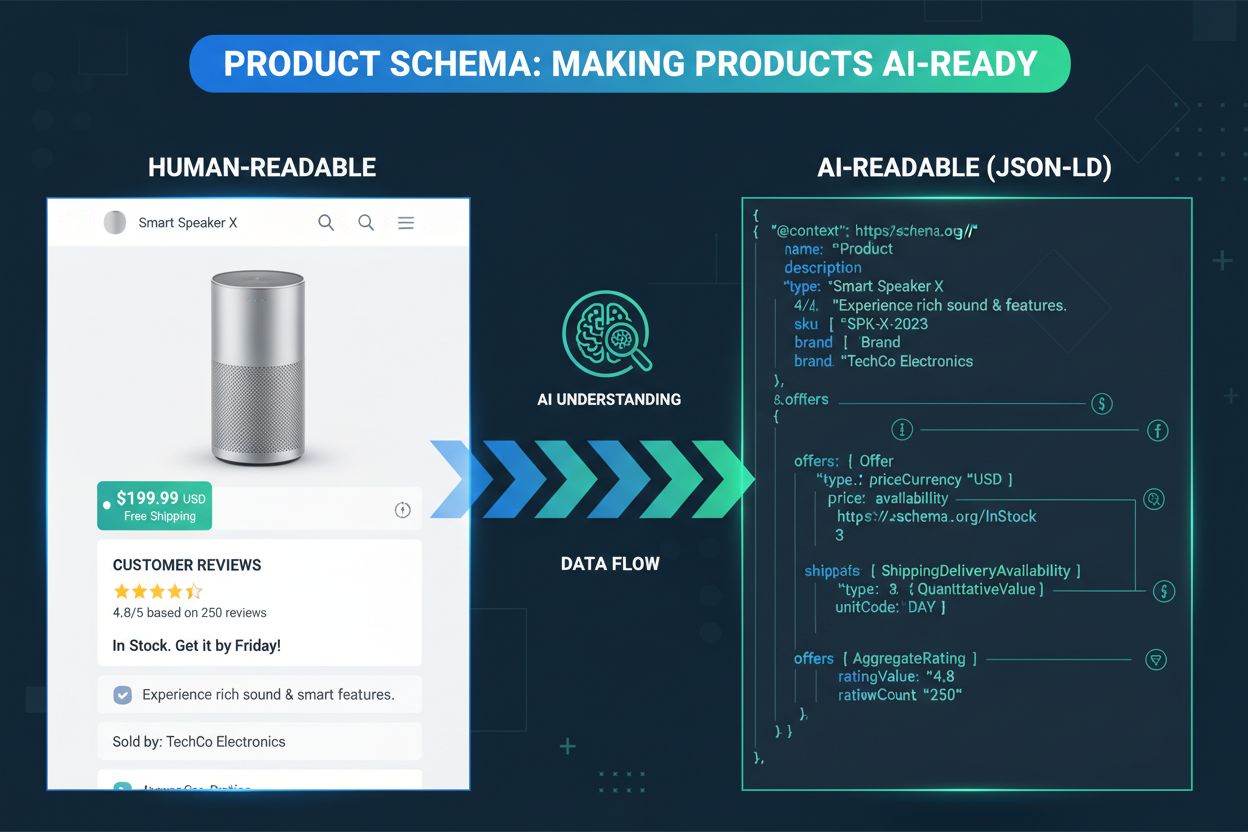
En teknisk gjennomgang av implementering av produkt-skjema markup: Schema.org Product-egenskaper, JSON-LD-syntaks, nestede Offer/AggregateRating/Review-typer, plattformoppsett og valideringsverktøy, samt hvilke AI-handelmotorer som faktisk leser disse dataene.
Netthandelssiden din kan ha gode produkter, overbevisende beskrivelser og konkurransedyktige priser, men når kunder spør AI-assistenter om anbefalinger, dukker konkurrenter opp i stedet. Strukturert datamarkup er vanligvis forskjellen. I motsetning til tradisjonelle søkemotorer som støtter seg på søkeordmatchning og sideinnholdsanalyse, er AI-handelmotorer sterkt avhengige av strukturerte data for å forstå produktattributter, relasjoner og kontekst med presisjon. Ettersom AI-handelmotorer blir mer sofistikerte, avgjør fullstendigheten av produkt-skjemaet ditt i økende grad om produktene dine blir oppdaget, nøyaktig representert og anbefalt til potensielle kunder i det hele tatt.
Denne guiden dekker både hvorfor og hvordan: hvorfor produkt-skjema driver AI-handelsynlighet, hvilke AI-handelmotorer som faktisk leser det, og de eksakte egenskapene, JSON-LD-syntaksen, nestede typene, plattformoppsettet og valideringstrinnene som trengs for å få det riktig første gang. Å få implementeringen riktig er viktig fordi AI-systemer ikke kan utlede mening fra en produktside slik et menneske kan. De skanner etter strukturerte data i spesifikke formater og spesifikke egenskaper, og hull i den markupen er hull i hva AI-systemer kan si om produktet ditt.
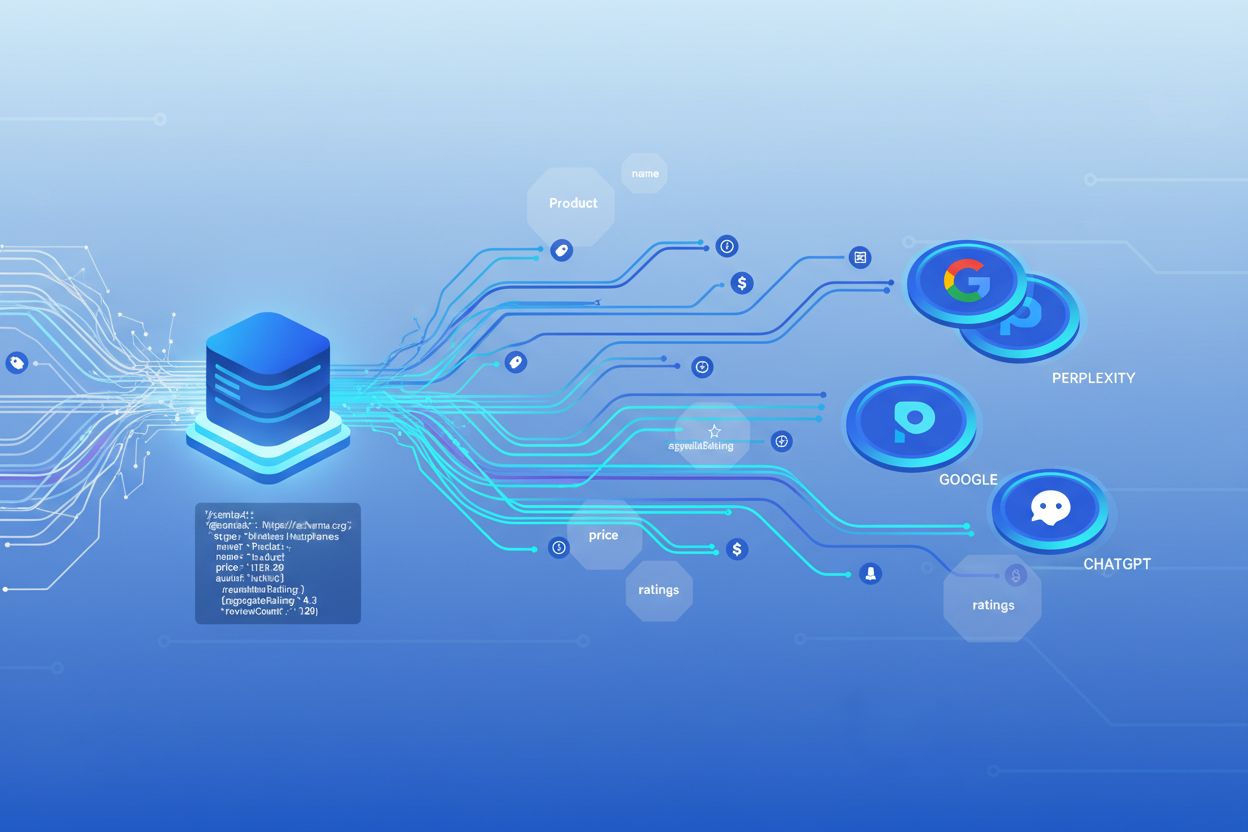
Når en AI-handelmotor gjennomsøker nettstedet ditt, henter den ut strukturerte produktdata og mater dem inn i Knowledge Graph, en stor database med sammenkoblet produktinformasjon som driver intelligente søk- og anbefalingsfunksjoner. Dette er en grunnleggende annen prosess enn tradisjonell søkeordindeksering.
| Aspekt | Tradisjonelt søk | AI-handelmotorer |
|---|---|---|
| Datakilde | Sideinnhold + metatagger | Strukturert skjema + innhold |
| Forståelse | Søkeordbasert matchning | Semantisk forståelse |
| Produktkontekst | Begrenset | Omfattende |
| Anbefalingskvalitet | Grunnleggende filtrering | Avansert AI-analyse |
Denne strukturerte tilnærmingen lar AI-systemer forstå ikke bare hva et produkt er, men også dets spesifikasjoner, priser og tilgjengelighet i én samlet, maskinlesbar profil, i stedet for å sette det sammen fra spredt sidetekst. De eksakte egenskapene som mater denne profilen, dekkes i detalj nedenfor.

Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
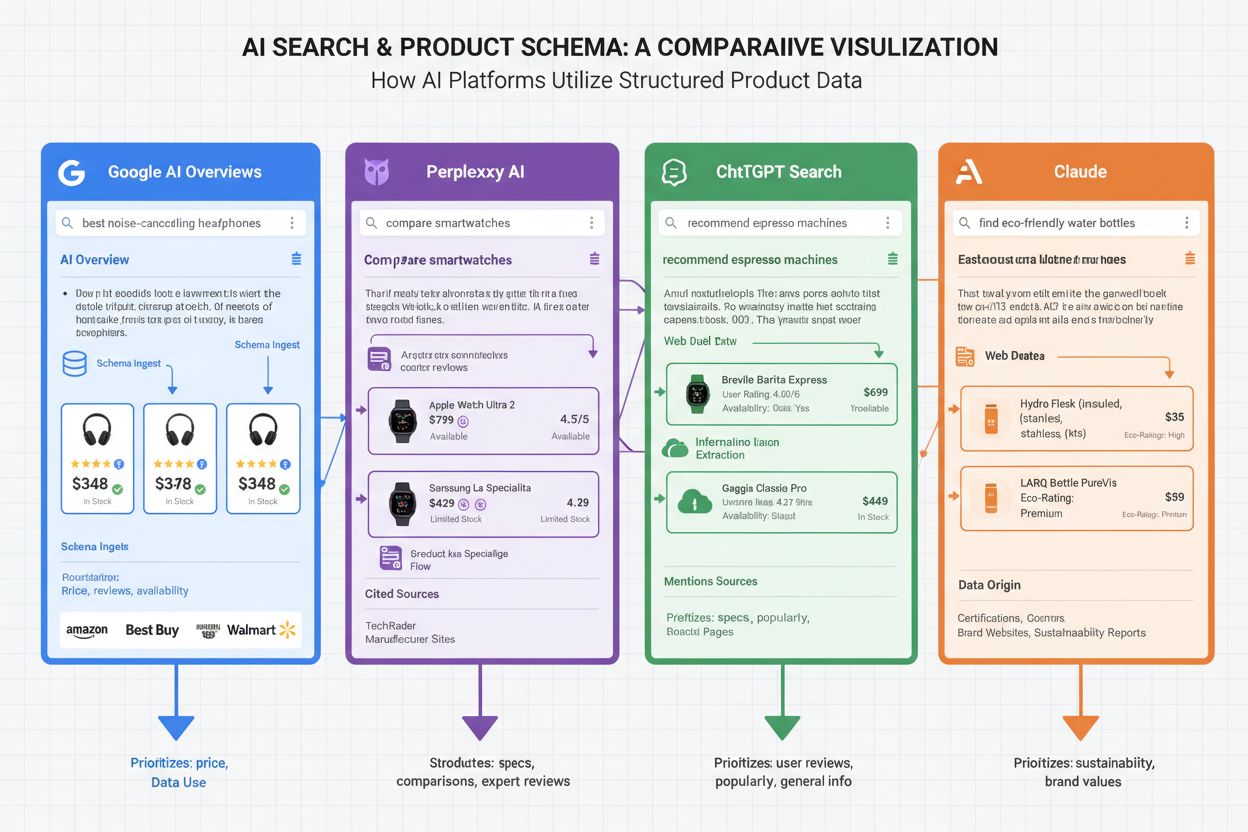
Ikke alle AI-handelmotorer vekter de samme egenskapene på samme måte, og å kjenne forskjellene hjelper deg med å prioritere hvor du skal fokusere. Google AI Oversikter (tidligere SGE) stoler sterkt på produkt-skjema for å generere AI-drevne handleoppsummeringer som vises øverst i søkeresultatene; avhengigheten av fullstendig pris-, tilgjengelighets- og vurderingsdata gjør skjemaimplementering kritisk for alle som ønsker å vises i Googles AI-funksjoner. Perplexity AI bruker produkt-skjema for å gi nøyaktig produktinformasjon, priser og tilgjengelighet i sine konversasjonelle søkeresultater, og det merkes tydelig at de favoriserer kilder med godt strukturerte data fremfor de uten. ChatGPT Search integrerer produkt-skjemadata for å levere gjeldende priser, lagerstatus og produktbeskrivelser når brukere stiller handle-relaterte spørsmål, og prioriterer kilder med omfattende strukturerte data fremfor de de må utlede fra prosa. Claude og andre AI-assistenter refererer i økende grad til produkter med skjemamarkup når de svarer på forbrukerspørsmål, fordi strukturerte data gir pålitelig, verifiserbar informasjon som er lettere å stole på enn fritekst-påstander.
Standardvokabularet for produkt-skjemamarkup kommer fra Schema.org, et åpen kildekode-samarbeidsprosjekt støttet av Google, Microsoft, Yahoo og Yandex som definerer hvordan man markerer ulike typer innhold. Product-typen er ryggraden i e-handelsstrukturerte data. Som et minimum inkluderer en fullstendig implementering: name (den nøyaktige produkttittelen, som samsvarer med det som står på siden), description, sku (ditt interne lagerføringssystem), gtin eller mpn (produsentens globale identifikator, nyttig for kryssreferanse mot produsentkatalogdata), brand, image (én eller flere URL-er, ideelt sett flere vinkler) og category. Ingen av disse egenskapene er valgfrie hvis du vil at AI-systemer skal ha et fullstendig bilde; en ufullstendig Product-blokk er en av de vanligste årsakene til at produkter blir oversett i AI-genererte anbefalinger.
| Egenskap | Type | Formål |
|---|---|---|
name | Tekst | Nøyaktig produkttittel for matchning |
sku / gtin / mpn | Tekst | Unike identifikatorer, forhindrer duplikatoppføringer |
brand | Brand-objekt | Produsent- eller merkenavn |
image | URL(er) | Visuelle data AI-systemer kan analysere |
category | Tekst | Klassifisering for filtrering og sammenligning |
offers | Offer-objekt | Pris, tilgjengelighet, kjøps-URL |
aggregateRating | AggregateRating-objekt | Samlet vurderingsscore |
review | Review-objekt(er) | Individuelle kundetilbakemeldinger |
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
De øverste Product-egenskapene tar deg bare halvveis; de nestede objektene er der mesteparten av den handlingsrelevante informasjonen ligger. Offer-objektet bærer price, priceCurrency, availability (ved bruk av Schema.orgs kontrollerte vokabular som https://schema.org/InStock), url, og valgfritt priceValidUntil for tidsbegrensede priser. Uten et gyldig Offer har AI-systemer ikke noe pålitelig svar på «er dette på lager og hva koster det», som ofte er den avgjørende faktoren for om et produkt blir anbefalt i det hele tatt. AggregateRating-objektet bærer ratingValue, reviewCount, og valgfritt bestRating/worstRating for å definere skalaen; utelater du skalaen antar noen tolker en standard som kanskje ikke samsvarer med ditt faktiske vurderingssystem. Review-objektet inneholder individuelle anmeldelser med author, reviewBody, datePublished, og et reviewRating-underobjekt. Du trenger ikke å bygge inn hver eneste anmeldelse i produkt-skjemaet ditt (det blåser opp siden); å bygge inn et representativt utvalg sammen med det aggregerte er standard praksis.
JSON-LD (JavaScript Object Notation for Linked Data) er det foretrukne implementeringsformatet fordi det lever i én enkelt, selvstendig <script>-blokk i stedet for å være spredt over HTML-attributter; å skille strukturerte data fra markupen gjør begge deler lettere å vedlikeholde. Her er et fullstendig eksempel som kombinerer egenskapene ovenfor:
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Premium Waterproof Hiking Boots",
  "description": "Durable waterproof hiking boots with ankle support and grip sole",
  "image": "https://example.com/hiking-boots.jpg",
  "brand": {
    "@type": "Brand",
    "name": "TrailMaster"
  },
  "offers": {
    "@type": "Offer",
    "price": "149.99",
    "priceCurrency": "USD",
    "availability": "https://schema.org/InStock",
    "url": "https://example.com/hiking-boots"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.7",
    "reviewCount": "328"
  },
  "sku": "HB-WP-001",
  "mpn": "TRAILMASTER-HB-2024"
}
Denne blokken bør plasseres innenfor <script type="application/ld+json">-tagger, enten i sidens <head> eller i sidens body; begge deler er gyldige, men å plassere den i <head> gjør at AI-søkere møter den før de må tolke resten av sideinnholdet.
De fleste e-handelsplattformer genererer noe grunnleggende skjema automatisk, men «noe» gjør mye av jobben i den setningen. Shopify-temaer leverer vanligvis name, price og availability som standard, men hopper ofte over aggregateRating og review; hvis temaet ditt ikke støtter anmeldelsesskjema, trenger du en anmeldelsesapp som skriver sin egen JSON-LD eller en tilpasset Liquid-mal. WooCommerce-implementeringer varierer enormt avhengig av hvilken SEO-plugin som er aktiv; Yoast og RankMath genererer begge produkt-skjema, men dekning av nestede Offer- og Review-egenskaper varierer mellom dem, så revider den faktiske utdataen i stedet for å anta at plugin-en håndterer alt. Magentos innebygde produkt-skjema er relativt sterkt ut av boksen, men utelater vanligvis gtin/mpn, noe som betyr noe hvis AI-systemer kryssrefererer oppføringen din mot produsentdata. I alle tilfeller er løsningen den samme: se sidekilde, finn JSON-LD-blokken din, og sjekk den mot egenskapstabellen ovenfor i stedet for å stole på at «plattformen håndterer skjema» er et fullstendig svar, spesielt hvis du også optimaliserer for AI-søk på tvers av flere plattformer samtidig.
Implementering er ikke ferdig før den er validert. Googles Rich Results Test sjekker om skjemaet ditt ikke bare er teknisk gyldig, men også kvalifisert for forbedrede søkefunksjoner; kjør hver mal gjennom den, ikke bare én eksempelside. Schema.orgs egen validator fanger opp syntaksfeil som Rich Results Test kanskje ikke flagger. Google Search Console viser skjemarelaterte feil og advarsler på tvers av hele nettstedet ditt over tid, noe som er den beste måten å fange opp regresjoner etter en tema- eller plugin-endring. Før du ruller ut skjemaendringer på hele nettstedet, test på et representativt undersett av sider; ulike produkttyper (pakker, varianter, utsolgte varer) har en tendens til å bryte maler på ulike måter, og å fange det opp på ti sider er mye billigere enn å fange det opp på ti tusen.
Statisk skjema som blir foreldet er muligens verre enn ikke noe skjema i det hele tatt, fordi det aktivt mater AI-systemer med feil informasjon. Sanntidsoppdateringer av data er ikke omsettelige for pris og tilgjengelighet; implementer automatiserte prosesser som regenererer skjema når produktdatabasen din endres, i stedet for å stole på manuelle redigeringer eller periodiske batch-jobber. Det mest pålitelige mønsteret er å hente skjemadata fra samme kilde som synlig sideinnhold, slik at de to aldri kan gli fra hverandre. AI-systemer vekter konsistens og ferskhet når de bestemmer hvilke kilder de skal stole på for anbefalinger, og en skjemablokk som ikke har samsvart med virkeligheten på tre uker gjør mer skade enn nytte.
Avkastningen fra skjemaimplementering viser seg på en forutsigbar tidslinje. Visninger av rike resultater forbedres typisk innen 2–4 uker etter korrekt implementering, synlig først i Google Search Console. AI Oversikter-forekomster og synlighetsgevinster for talestyrt søk følger vanligvis innen 4–8 uker. Forretningsmålinger – konverteringsrateforbedringer og økning i gjennomsnittlig ordreverdi – viser seg typisk innen 2–3 måneder, når AI-systemer har hatt nok eksponering for de strukturerte dataene dine til å stole på og anbefale oppføringene dine konsekvent.
Dette er grunnen til at skjema er en forretningsbeslutning, ikke bare en teknisk avkrysningsboks. Hvis du selger på tvers av flere markedsplasser i tillegg til din egen side, betyr implementering av skjema på ditt eget domene fortsatt noe: det etablerer siden din som den autoritative kilden AI-systemer kan sitere direkte, i stedet for å la AI-handelmotorer utelukkende hente fra markedsplassoppføringer du ikke fullt ut kontrollerer. Ettersom AI-handelassistenter i økende grad anbefaler produkter direkte, vil du at de skal sitere deg, ikke bare markedsplassen som tilfeldigvis har oppføringen din.
Å måle skjemaets forretningspåvirkning krever sporing av målinger utover tradisjonell SEO. AmICited.com tilbyr et sentralisert dashbord der du kan overvåke hvor ofte produktene dine vises i AI-søkeresultater på tvers av ulike plattformer, slik at du ikke manuelt må spørre ChatGPT og Perplexity de samme spørsmålene hver uke. Avkastningssporing innebærer å sammenligne kostnadene ved å implementere og vedlikeholde skjema mot inntektene generert fra AI-henviste kunder, noe som hjelper med å rettferdiggjøre fortsatt investering. Før du kan stole på noen av disse tallene, er det imidlertid verdt å bekrefte grunnleggende AI-søker-tilgang til sidene dine; siteringssporing er meningsløst hvis søkerne ikke kan nå produktsidene dine i utgangspunktet. Sett opp varsler for når produktene dine blir sitert i store AI-plattformer, og sammenlign ytelsen din mot konkurrenter for å identifisere hull i din nåværende skjemastrategi.
| Feil | Problem | Løsning |
|---|---|---|
| Ufullstendige egenskaper | Manglende gtin/mpn/aggregateRating lar AI-systemer gjette | Revider mot den fullstendige egenskapstabellen, ikke bare plattformstandarden |
| Feilaktige data | Skjemeverdier avviker fra hva som vises på siden | Generer skjema og sideinnhold fra samme datakilde |
| Foreldede egenskaper | Bruk av skjematyper eller felt søkemotorer ikke lenger gjenkjenner | Gå gjennom schema.org-endringslogger kvartalsvis |
| Søkeordstopping | Polstring av beskrivelser eller falske anmeldelser i skjema | Hold skjema ærlig; AI-systemer oppdager i økende grad manipulasjon |
| Ingen sanntidssynk | Priser og lager blir foreldet i JSON-LD | Automatiser skjemaregenerering ved dataendring |
Utover tabellen fortjener én strukturell feil sin egen oppmerksomhet: å implementere skjema kun på desktop-maler. Hvis mobil-temaet ditt gjengir en forenklet side, bekreft at JSON-LD-blokken også er fullstendig; mobil-først-indeksering betyr at et tynt mobilt skjema kan undergrave en ellers solid desktop-implementering.
Noen få strategiske feil forsterker disse tekniske feilene og koster spesifikt bedrifter AI-synlighet. Å behandle skjema som et engangsprosjekt i stedet for en pågående forpliktelse: AI-plattformer utvikler sine datakrav over tid, vekter ulike egenskaper etter hvert som handlefunksjonene deres modnes, og en strategi som ga mening for et år siden kan etterlate synlighet på bordet i dag. Å skrive produktbeskrivelser for søkeordtetthet i stedet for klarhet: AI-systemer straffer i økende grad manipulerende produktbeskrivelser og belønner naturlige, nøyaktige beskrivelser som gir dem reell informasjon å oppsummere. Å stole utelukkende på tilstedeværelse på markedsplasser: uten ditt eget skjema har du null kontroll over hvordan AI-systemer karakteriserer merkevaren din i forhold til konkurrenter som selger samme produkt. Se også tekniske feil som oftest skader AI-søkeytelse mer bredt.
Når grunnleggende er på plass, lar nestede skjemarelasjoner deg beskrive mer komplekse kataloger: produktpakker og sett, kompatible tilbehør, reservedeler og størrelses-/fargevarianter via ProductGroup og isVariantOf. Flerspråklig skjema betyr noe for internasjonale kataloger; implementer skjema per lokalitet i stedet for å stole på én kanonisk språkblokk, siden AI-systemer i økende grad leverer språkspesifikke anbefalinger. Å holde disse strukturerte dataene fullstendige og synkronisert på tvers av hver mal og lokalitet støtter også flerkanals synlighet, siden den samme underliggende JSON-LD-en mater AI Oversikter, Perplexity, ChatGPT og taleassistenter samtidig, i stedet for å kreve separate implementeringer for hver.
Et bredere semantisk lag er også i ferd med å dukke opp på tvers av e-handelsplattformer, et som går utover grunnleggende attributter til å inkludere relasjoner, bruksområder og bærekraftsdata – rikere enn det de fleste skjemaimplementeringer fanger opp i dag. Nye muligheter som visuell søkeintegrasjon, talehandel og personaliserte anbefalinger vil i økende grad være avhengige av omfattende, velstrukturerte produktdata for å fungere i det hele tatt. Ser vi fremover, ettersom konversasjonelle handelskjematyper modnes og dekker flertrinns produktutforskning og agent-initierte transaksjoner, forventes de å utvide dette egenskapssettet snarere enn å erstatte det, så en godt strukturert Product-implementering i dag er grunnlaget disse tilleggene vil bygge på. Ettersom konkurransen intensiveres blant AI-handelsplattformer, vil forhandlerne som leverer de høyeste kvalitetsdataene være de AI-systemer stoler på for å bygge overlegne anbefalingsopplevelser rundt, noe som skaper et sammensatt insentiv til å investere i skjema nå, i stedet for etter at konkurrenter allerede har gjort krav på den tilliten.
Yasha er en talentfull programvareutvikler som spesialiserer seg på Python, Java og maskinlæring. Yasha skriver tekniske artikler om AI, prompt engineering og chatbot-utvikling.
AmICited sporer hvordan AI-systemer refererer til produktene dine på tvers av ChatGPT, Perplexity, Google AI Oversikter og mer. Kontroller at skjemaimplementeringen din blir til reelle AI-siteringer.
Produktskjema er strukturert dataoppmerking som hjelper søkemotorer og AI-systemer med å forstå produktdetaljer. Lær hvordan du implementerer det for bedre synl...
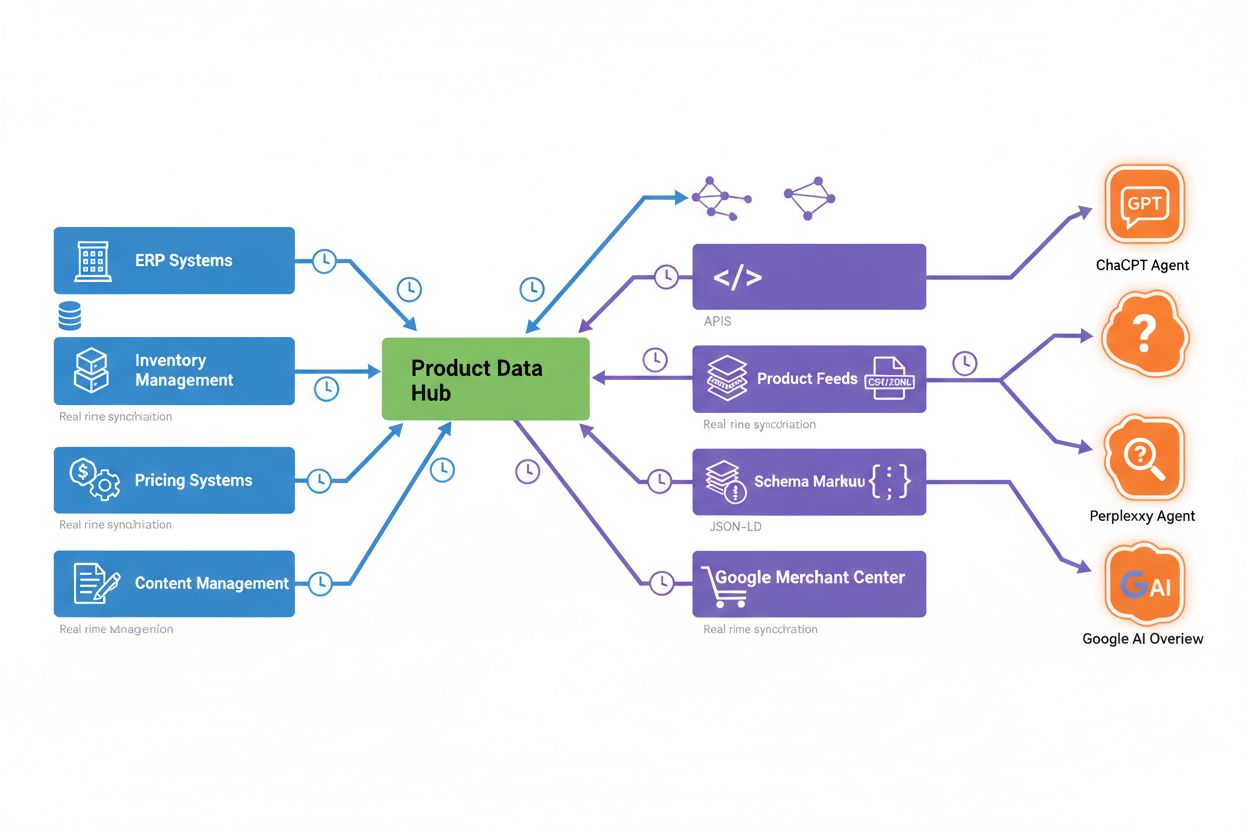
Lær de tekniske kravene til produktdata i agentisk handel. Oppdag strukturerte dataformater, synkroniseringsstrategier og optimaliseringsteknikker for å sikre a...
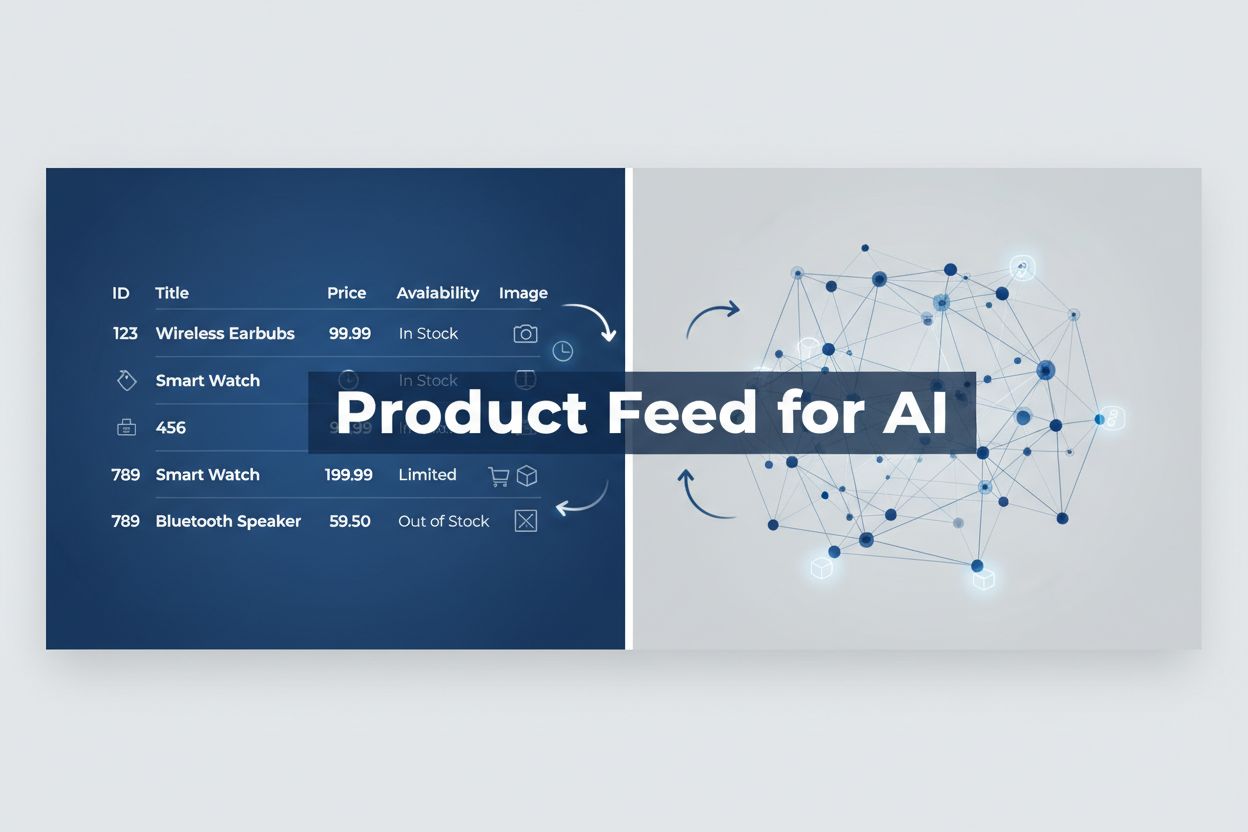
Lær hva produktfeeder for AI er, hvordan de skiller seg fra tradisjonelle feeder, og hvordan du optimaliserer dem for ChatGPT, Google AI Overviews og Perplexity...
Informasjonskapselsamtykke
Vi bruker informasjonskapsler for å forbedre din surfeopplevelse og analysere vår trafikk. See our privacy policy.