


SKU
En SKU (Stock Keeping Unit) är en unik alfanumerisk kod som en återförsäljare tilldelar en specifik produktvariant för att spåra den genom lager, försäljning och orderhantering. Till skillnad från en UPC eller streckkod är en SKU intern för verksamheten och kan koda attribut som storlek, färg eller lagerplats. Varje säljbar variant av en produkt får sin egen SKU.
Definition av SKU
En SKU (Stock Keeping Unit) är en unik identifierare som ett företag skapar för att spåra en specifik, säljbar version av en produkt genom lager-, beställnings- och försäljningssystem. Om en hoodie finns i tre färger och fyra storlekar blir det tolv SKU:er, eftersom varje kombination måste räknas, prissättas och beställas om oberoende. En SKU är inte samma sak som ett produktnamn eller en listning – en produkt kan ha många SKU:er, en för varje variant en kund faktiskt kan välja och köpa. SKU:er är interna för det företag som skapar dem, vilket skiljer dem från UPC och EAN, som är standardiserade koder tilldelade av en extern organisation (GS1) och delas av alla återförsäljare som säljer just den varan. En återförsäljare kan därför skapa sin egen SKU för en produkt den köper in, och lägga en intern kod ovanpå tillverkarens streckkod så att dess egna lager- och rapporteringssystem kan spåra den konsekvent.
Hur SKU-koder är strukturerade
Det finns ingen universell standard för SKU-format, vilket både är en styrka och en vanlig källa till kaos. De flesta handlare bygger en kort alfanumerisk sträng som kodar de attribut som är viktiga för lager- och rapporteringsändamål: kategori, produktlinje, färg och storlek är vanliga byggstenar. Ett typiskt mönster ser ut som TSH-CREW-BLK-L för en svart, stor crewneck-t-shirt, eller MUG-CER-12OZ för en 12-ounce keramikmugg. Bra SKU-design brukar följa några regler: håll koderna konsekventa i längd så att de är lätta att skanna visuellt och sortera i ett kalkylark, undvik mellanslag och specialtecken som kan störa CSV-import eller URL-sluggar, och gör koden läsbar nog att en lagerplockare kan känna igen produkten från koden utan att slå upp den. Vissa företag använder istället sekventiella numeriska SKU:er (10001, 10002…) som genereras automatiskt av deras plattform, och byter då läsbarhet mot garanterad unikhet. Båda metoderna fungerar så länge de tillämpas konsekvent – problemet är oftast inkonsekvens: en produktlinje kodad för hand, en annan autogenererad, utan gemensam logik mellan dem.
Varför SKU-spårning på variantnivå är viktigt för e-handel
SKU-granularitet är vad som överhuvudtaget gör lagerhantering möjlig. Agregerade lagersiffror på “produktnivå” döljer det faktum att en variant är slutsåld medan en annan är överlagrad – en butik kan visa “T-shirt: i lager” medan den storlek som faktiskt säljer har varit restorder i två veckor. SKU-spårning på variantnivå ligger också till grund för beräkningar av beställningspunkter, eftersom en medelstor och en extra stor av samma tröja säljs i olika takt och behöver olika beställningsutlösare. Utöver lager är SKU den naturliga kopplingsnyckeln för marginalanalys: när en SKU har en landad kostnad (enhetskostnad, inkommande frakt, emballage) kopplad till sig, kan varje orderrad knytas till en verklig kostnad, och intäkter och lönsamhet kan rapporteras på exakt samma detaljnivå som ett lager använder för att hantera stock. Utan kostnadsdata på SKU-nivå måste lönsamhetsrapportering falla tillbaka på genomsnitt på ordernivå, vilket suddar ut skillnaden mellan hög- och lågmarginalprodukter på ett sätt som döljer vilka SKU:er som faktiskt är värda att marknadsföra.
SKU vs. UPC vs. produkt-ID
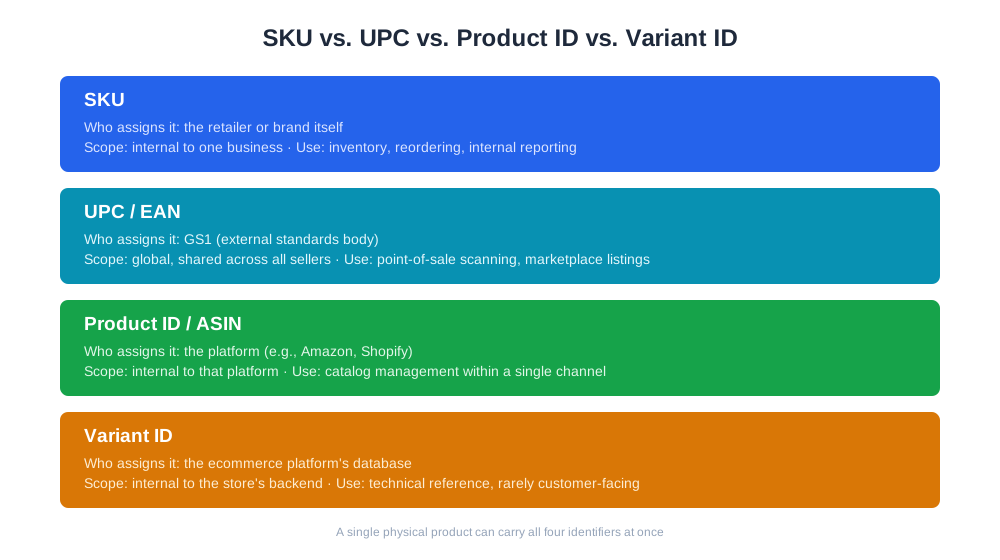
| Identifierare | Vem tilldelar den | Omfattning | Typisk användning |
|---|---|---|---|
| SKU | Återförsäljaren eller varumärket självt | Internt för ett företag | Lager, beställning, intern rapportering |
| UPC / EAN | GS1 (extern standardiseringsorganisation) | Global, delad mellan alla säljare | Kassaskanning, marknadsplatslistningar |
| Produkt-ID / ASIN | Plattformen (t.ex. Amazon, Shopify) | Internt för den plattformen | Kataloghantering inom en enda kanal |
| Variant-ID | E-handelsplattformens databas | Internt för butikens backend | Teknisk referens, sällan kundvänd |
En enda fysisk produkt kan bära alla fyra samtidigt: en tillverkartilldelad UPC, en återförsäljartilldelad SKU, en marknadsplastilldelad ASIN och en plattformstilldelad variant-ID. Flermarknadshandlare behöver vanligtvis en mappningstabell som samordnar dessa så att en försäljning på Amazon och en försäljning via en Shopify-butik båda rullas upp till samma underliggande SKU för rapportering.

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
SKU-data och AI-driven handel
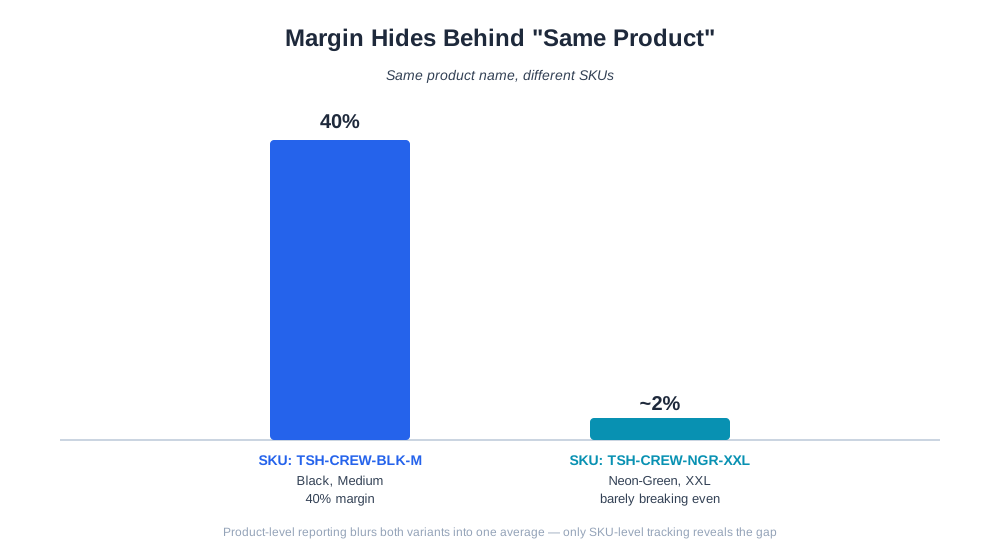
I takt med att shopping alltmer sker genom AI-assistenter som ChatGPT Shopping, Perplexity Shopping och Amazon Rufus, är produktdataflöden – den strukturerade informationen som berättar för dessa system vad som finns i lager, till vilket pris, i vilken variant – beroende av rena SKU-data under ytan. En AI-shoppingassistent som rekommenderar “medium i blått” behöver att det underliggande flödet kan lösa upp det till en faktisk SKU med verkligt lager och pris, inte en generisk produktlistning. Stökiga eller dubblerade SKU:er är en vanlig orsak till att produktflöden avvisas eller feltolkas över dessa kanaler. På analyssidan arbetar verktyg som AmICiteds eshop_get_products och eshop_list_product_costs rapporter på SKU-granularitet just för att det är den nivå på vilken lönsamhetsfrågor faktiskt besvaras – “vilken variant av denna produkt ska jag fortsätta lagerhålla” är en fråga på SKU-nivå, inte en produktnamnsfråga. Att rapportera intäkter och marginal per SKU, snarare än per produkttitel, är vad som låter en handlare se att den svarta medelstora säljs med 40% marginal medan den neon-gröna XXL, trots att den är “samma produkt”, knappt går break-even.
Bästa praxis för SKU-hantering
- Etablera en kanonisk SKU per variant innan du listar i flera kanaler och mappa varje kanalspecifikt ID tillbaka till den
- Håll SKU-koder korta, konsekventa i längd och fria från mellanslag eller specialtecken
- Koppla en landad kostnad till varje SKU, inte bara ett detaljhandelspris, så att marginal kan beräknas automatiskt
- Undvik att återanvända en pensionerad SKU för en ny, orelaterad produkt – historisk rapportering kommer att sammanblanda de två
- Granska efter dubbla eller nästan dubbla SKU:er (ett vanligt resultat av manuella kalkylarksredigeringar) regelbundet
- Inkludera SKU i varje export – ordrar, returer och kostnadsunderlag – så att datamängder alltid kan kopplas ihop igen
Vanliga SKU-misstag
Ett vanligt problem är att behandla “produkt” och “SKU” som utbytbara i rapportering, vilket ger lagersaldon och marginaler som ser bra ut i aggregerat men döljer en dåligt presterande variant under en välpresterande. Lösningen är att säkerställa att varje rapport – försäljning, lager, kostnad – genereras på SKU-nivå och endast rullas upp till produktnivå som en visningsbekvämlighet, inte som den underliggande beräkningen. Ett annat vanligt problem är SKU-drift över försäljningskanaler: en handlare skapar ett SKU-system i sitt POS-system, ett annat autogenereras av deras e-handelsplattform och ett tredje format dyker upp på en marknadsplatslistning, vilket lämnar ingen tillförlitlig metod för att sammanställa total försäljning för en given variant utan manuell matchning. Standardlösningen är en mappningstabell som underhålls centralt, helst i den plattform som gör rapporteringen, snarare än att återskapas ad hoc i ett kalkylark varje gång. Ett tredje misstag är att återanvända SKU:er när en produkt utgår och ersätts – en ny formulering eller omdesign som får den gamla SKU:n grumlar historisk trenddata, vilket får det att se ut som om samma produkt plötsligt ändrade prestanda istället för att visa ett rent före/efter-avbrott. Slutligen hoppar många mindre handlare över att koppla en verklig landad kostnad till varje SKU och använder istället en schablonmässig uppskattad marginal över hela katalogen; detta gör SKU-nivåns lönsamhetsrapportering tekniskt möjlig men praktiskt taget missvisande, eftersom den inte kan avslöja den faktiska spridningen mellan de bästa och sämst presterande varianterna.