


SKU
Un SKU (Stock Keeping Unit) est un code alphanumérique unique qu'un détaillant attribue à une variante spécifique d'un produit pour la suivre dans les stocks, les ventes et l'exécution des commandes. Contrairement à un UPC ou un code-barres, un SKU est interne à l'entreprise et peut encoder des attributs comme la taille, la couleur ou l'emplacement en entrepôt. Chaque variation vendable distincte d'un produit reçoit son propre SKU.
Définition du SKU
Un SKU (Stock Keeping Unit — Unité de Gestion de Stock) est un identifiant unique qu’une entreprise crée pour suivre une version spécifique et vendable d’un produit dans ses systèmes d’inventaire, de commande et de vente. Si un sweat à capuche existe en trois couleurs et quatre tailles, cela représente douze SKU, car chaque combinaison doit être comptée, tarifée et réapprovisionnée indépendamment. Un SKU n’est pas la même chose qu’un nom de produit ou une fiche produit : un produit peut avoir plusieurs SKU, un pour chaque variante qu’un client peut réellement sélectionner et acheter. Les SKU sont internes à l’entreprise qui les crée, ce qui les distingue des UPC et des EAN, qui sont des codes standardisés attribués par un organisme externe (GS1) et partagés par tous les détaillants vendant cet article précis. Un détaillant peut donc créer son propre SKU pour un produit qu’il achète en gros, superposant un code interne au code-barres du fabricant afin que ses propres systèmes d’entrepôt et de reporting puissent le suivre de manière cohérente.
Comment les codes SKU sont structurés
Il n’existe pas de norme universelle pour le format des SKU, ce qui est à la fois une force et une source fréquente de chaos. La plupart des marchands construisent une courte chaîne alphanumérique qui encode les attributs importants pour l’entrepôt et le reporting : catégorie, gamme de produits, couleur et taille sont des éléments courants. Un modèle typique ressemble à TSH-CREW-BLK-L pour un t-shirt noir à col rond de taille L, ou MUG-CER-12OZ pour une tasse en céramique de 12 onces. Une bonne conception de SKU suit généralement quelques règles : maintenir une longueur cohérente pour faciliter le scan visuel et le tri dans un tableur, éviter les espaces et les caractères spéciaux qui peuvent perturber les importations CSV ou les slugs d’URL, et rendre le code suffisamment lisible pour qu’un préparateur de commandes puisse reconnaître le produit à partir du seul code, sans avoir à le rechercher. Certaines entreprises utilisent plutôt des SKU numériques séquentiels (10001, 10002…) générés automatiquement par leur plateforme, échangeant la lisibilité contre une unicité garantie. Les deux approches fonctionnent tant qu’elles sont appliquées de manière cohérente — le mode de défaillance est généralement l’incohérence : une gamme de produits codée manuellement, une autre générée automatiquement, sans logique commune entre elles.
Pourquoi le suivi au niveau SKU est important pour le e-commerce
La granularité du SKU est ce qui rend la gestion des stocks possible. Les décomptes de stock agrégés au niveau « produit » masquent le fait qu’une variante est épuisée tandis qu’une autre est en surstock — une boutique peut afficher « T-shirt : en stock » alors que la taille qui se vend réellement est en commande en souffrance depuis deux semaines. Le suivi au niveau SKU sous-tend également le calcul des points de réapprovisionnement, car une taille M et une taille XL du même t-shirt se vendent à des rythmes différents et nécessitent des déclencheurs de réapprovisionnement différents. Au-delà des stocks, le SKU est la clé de jointure naturelle pour l’analyse des marges : une fois qu’un coût débarqué (coût unitaire, fret entrant, emballage) est attaché à un SKU, chaque ligne de commande peut être rattachée à un coût réel, et les revenus ainsi que la rentabilité peuvent être rapportés à la même granularité que celle utilisée par l’entrepôt pour gérer les stocks. Sans données de coût au niveau SKU, le reporting de rentabilité doit se rabattre sur des moyennes au niveau de la commande, qui mélangent les produits à forte marge et ceux vendus à perte, cachant ainsi les SKU qui méritent réellement d’être promus.
SKU vs. UPC vs. ID de produit
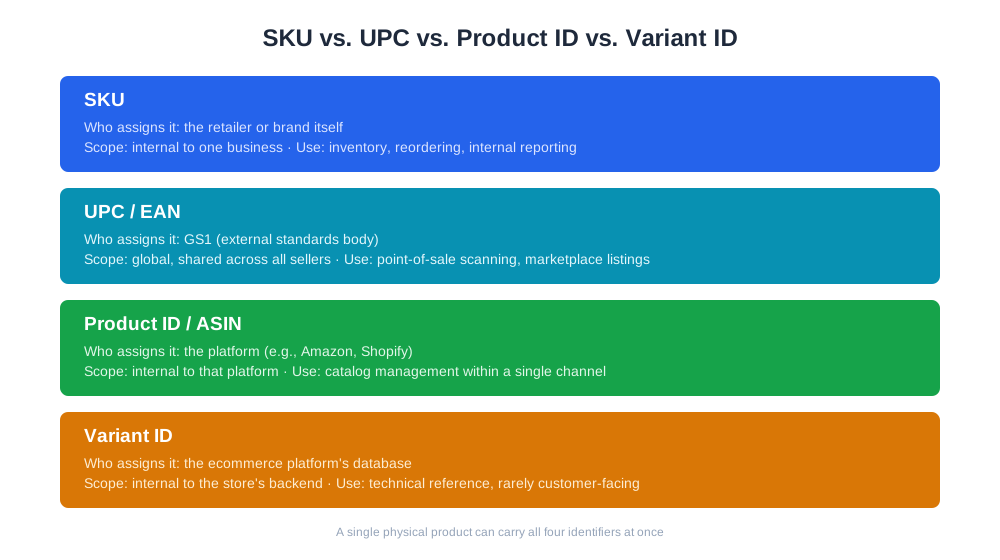
| Identifiant | Qui l’attribue | Portée | Utilisation typique |
|---|---|---|---|
| SKU | Le détaillant ou la marque elle-même | Interne à une seule entreprise | Inventaire, réapprovisionnement, reporting interne |
| UPC / EAN | GS1 (organisme de normalisation externe) | Mondial, partagé entre tous les vendeurs | Scan au point de vente, fiches sur les places de marché |
| ID de produit / ASIN | La plateforme (ex. Amazon, Shopify) | Interne à cette plateforme | Gestion de catalogue au sein d’un seul canal |
| ID de variante | La base de données de la plateforme e-commerce | Interne au système backend de la boutique | Référence technique, rarement visible par le client |
Un même produit physique peut porter les quatre simultanément : un UPC attribué par le fabricant, un SKU attribué par le détaillant, un ASIN attribué par la place de marché, et un ID de variante attribué par la plateforme. Les vendeurs multicanaux ont généralement besoin d’une table de correspondance qui réconcilie ces identifiants afin qu’une vente sur Amazon et une vente via une boutique Shopify remontent toutes deux au même SKU sous-jacent pour le reporting.

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Les données SKU et le commerce piloté par l’IA
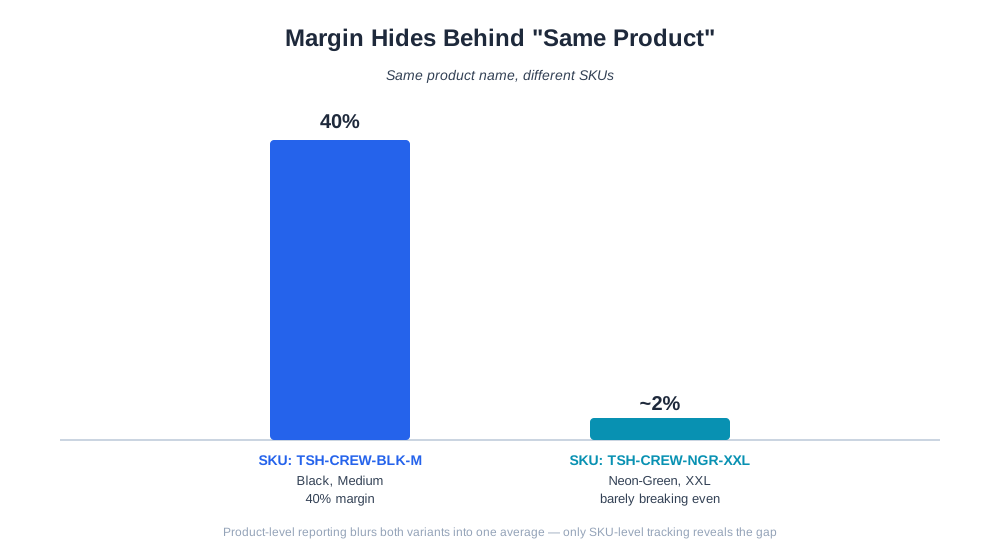
Alors que les achats se font de plus en plus via des assistants IA comme ChatGPT Shopping, Perplexity Shopping et Rufus d’Amazon, les flux de données produits — les informations structurées qui indiquent à ces systèmes ce qui est en stock, à quel prix et en quelle variante — dépendent de données SKU propres en dessous. Un assistant d’achat IA qui recommande « le modèle moyen en bleu » a besoin que le flux sous-jacent résolve cette demande en un SKU réel avec un stock et un prix réels, et non pas une simple fiche produit générique. Des SKU désordonnés ou dupliqués sont une raison fréquente pour laquelle les flux de produits sont rejetés ou mal représentés sur ces canaux. Côté analyse, des outils comme les rapports eshop_get_products et eshop_list_product_costs d’AmICited fonctionnent à la granularité SKU précisément parce que c’est à ce niveau que les questions de rentabilité trouvent réellement une réponse — « quelle variante de ce produit dois-je continuer à stocker ? » est une question de niveau SKU, pas de niveau nom de produit. Rapporter les revenus et les marges par SKU, plutôt que par titre de produit, permet à un marchand de voir que le modèle noir taille M se vend avec une marge de 40 % tandis que le XXL vert fluo, bien qu’il s’agisse du « même produit », atteint à peine le seuil de rentabilité.
Bonnes pratiques pour la gestion des SKU
- Établir un SKU canonique par variante avant de référencer sur plusieurs canaux, et mapper chaque ID spécifique à un canal vers ce SKU
- Garder les codes SKU courts, de longueur cohérente, et sans espaces ni caractères spéciaux
- Attacher un coût débarqué à chaque SKU, et pas seulement un prix de vente, afin que la marge puisse être calculée automatiquement
- Éviter de réutiliser un SKU retiré pour un nouveau produit sans lien — le reporting historique confondrait les deux
- Auditer régulièrement les SKU en double ou quasi-doubles (résultat fréquent de modifications manuelles dans un tableur)
- Inclure le SKU dans chaque exportation — commandes, retours et feuilles de coûts — afin que les ensembles de données puissent toujours être joints
Erreurs courantes avec les SKU
Un problème fréquent consiste à traiter « produit » et « SKU » comme interchangeables dans les rapports, ce qui produit des décomptes de stock et des marges qui semblent corrects dans l’ensemble mais cachent une variante peu performante sous une variante qui fonctionne bien. La solution consiste à s’assurer que chaque rapport — ventes, stocks, coûts — est généré au niveau SKU et n’est remonté au niveau produit que par commodité d’affichage, et non comme calcul sous-jacent. Un autre problème courant est la dérive des SKU entre les canaux de vente : un marchand crée un système de SKU dans son système POS, un autre est généré automatiquement par sa plateforme e-commerce, et un troisième format apparaît sur une fiche de place de marché, ne laissant aucun moyen fiable de réconcilier les ventes totales d’une variante donnée sans un rapprochement manuel. La solution standard est une table de correspondance maintenue de manière centralisée, idéalement au sein de la plateforme qui effectue le reporting, plutôt que recréée ponctuellement dans un tableur à chaque fois. Une troisième erreur consiste à réutiliser des SKU lorsqu’un produit est abandonné et remplacé — une nouvelle formulation ou refonte dotée de l’ancien SKU brouille les données de tendance historique, donnant l’impression que le même produit a soudainement changé de performance plutôt que de montrer une rupture nette avant/après. Enfin, de nombreux petits marchands négligent d’attribuer un coût débarqué réel à chaque SKU, utilisant par défaut une marge estimée forfaitaire pour l’ensemble du catalogue ; cela rend le reporting de rentabilité au niveau SKU techniquement possible mais pratiquement trompeur, car il ne peut pas révéler l’écart réel entre les variantes les plus et les moins performantes.