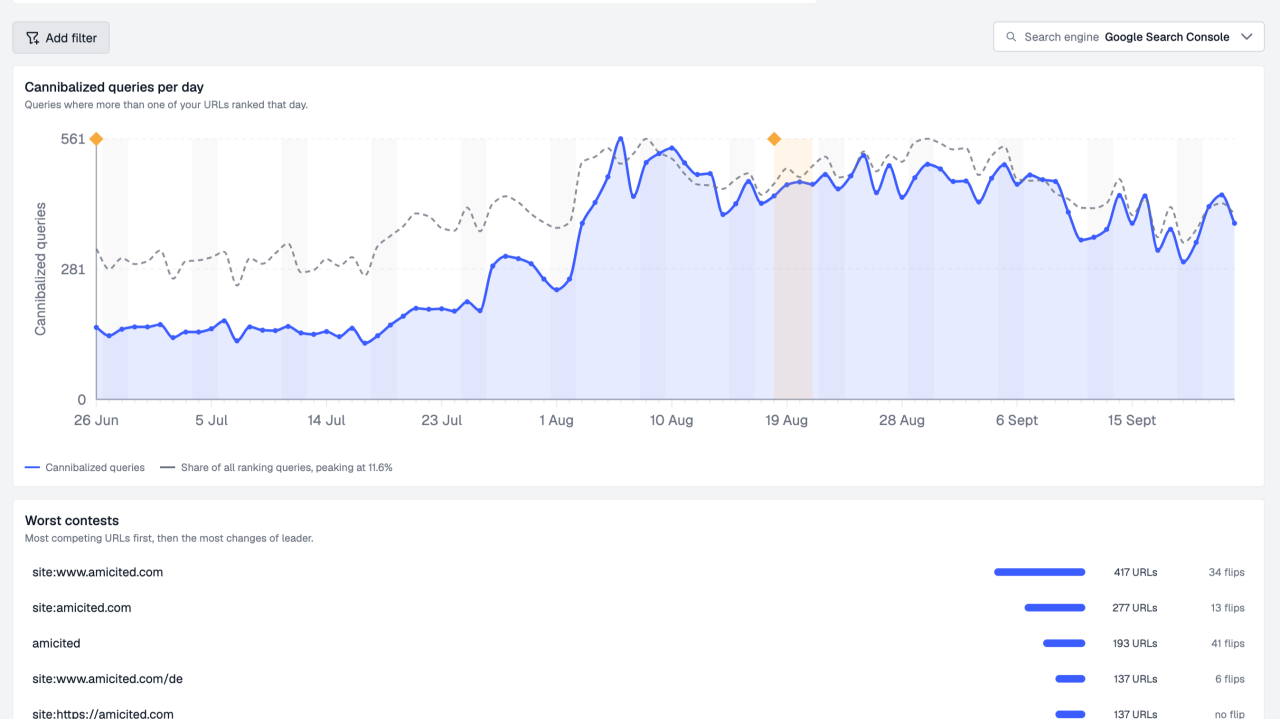
Von 140 auf 561 kannibalisierte Suchanfragen pro Tag
Zwischen Ende Juni und Mitte August stieg die Anzahl der Suchanfragen, bei denen zwei oder mehr amicited.com-URLs am selben Tag rankten, von etwa 140 pro Tag auf einen Höchststand von 561. Auf dem Höhepunkt machten kannibalisierte Suchanfragen 11,6 % aller Suchanfragen aus, für die die Seite rankte.
Also habe ich Claude Code auf das Hugo-Repository der Seite angesetzt, es mit dem AmICited SEO MCP Server verbunden und beauftragt, die Keyword-Kannibalisierung zu finden, für jeden Fall zu entscheiden, was zu tun ist, und die Korrektur in allen 16 Sprachen anzuwenden, in denen die Seite ausgeliefert wird.
Dies ist die Methode von Anfang bis Ende: die Prompts, die ich verwendet habe, was der Agent tatsächlich aufgerufen und getan hat, und die drei Dinge, die er zutage förderte, nach denen ich nie gefragt hatte. Nichts davon ist bereits deployed, betrachten Sie dies also als eine Durchlaufbeschreibung des Prozesses, nicht als Ergebnisbericht. Die 28-Tage-Überprüfung kommt später.
Keyword-Kannibalisierung liegt vor, wenn zwei oder mehr Seiten derselben Website um dieselbe Suchanfrage konkurrieren. Google wechselt dann ständig, welche Seite angezeigt wird, und keine rankt so gut wie eine einzelne starke Seite. Es handelt sich um interne Konkurrenz zwischen den eigenen URLs und es ist eine der SEO-Aufgaben, bei denen Claude Code seinen Wert beweist: Die Daten leben in der Search Console, die Korrektur lebt im Repository, und ein Agent kann beides gleichzeitig halten. (Verwechseln Sie dies nicht mit KI-Inhaltskannibalisierung, bei der eine KI-generierte Antwort den Klick erhält, den Ihre Seite sonst verdient hätte.) Wenn Sie die vollständige Aufschlüsselung wünschen, haben wir separat beschrieben, wie man Keyword-Kannibalisierungsprobleme identifiziert und behebt.
Der Aufbau
- Repository: das Repository meiner Hugo-Seite, 500+ englische Blogbeiträge, jeder in 15 andere Sprachen übersetzt.
- Daten: der AmICited MCP Server, der SEO-Berichte auf Basis der Google Search Console, einschließlich Kannibalisierung, als Tools bereitstellt, die Claude Code direkt aufrufen kann.
- Agent: Claude Code (Opus 5.5) im Automatikmodus, auf einem neuen Branch,
seo/cannibalization-oct-2026. Nichts wird committet, ohne dass ich zuerst das Diff gelesen habe.
Die Verbindung des MCP-Servers ist ein einmaliger OAuth-Schritt: /mcp ausführen, den Server auswählen, den Workspace im Browser bestätigen, und Claude Code kann ihn von da an aufrufen.
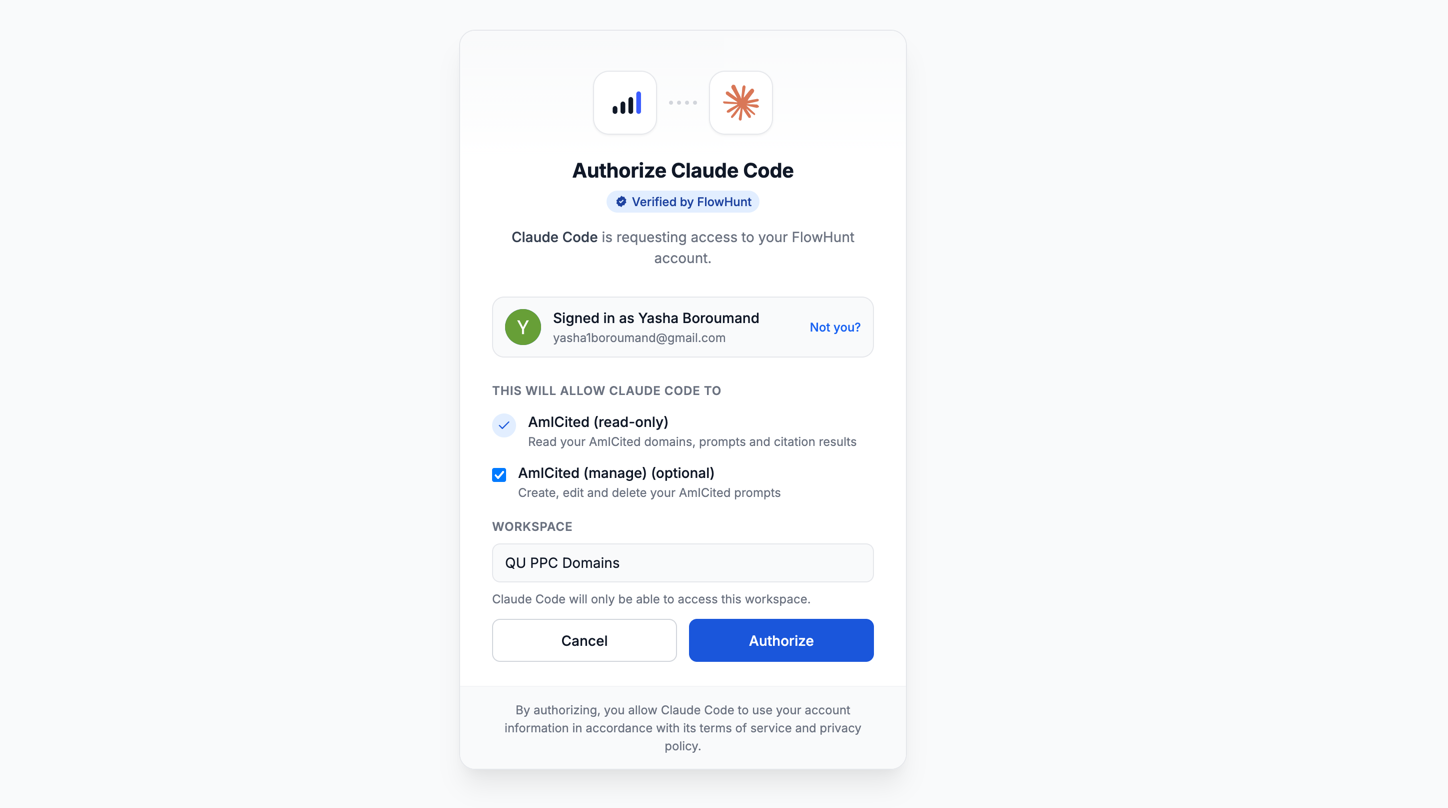
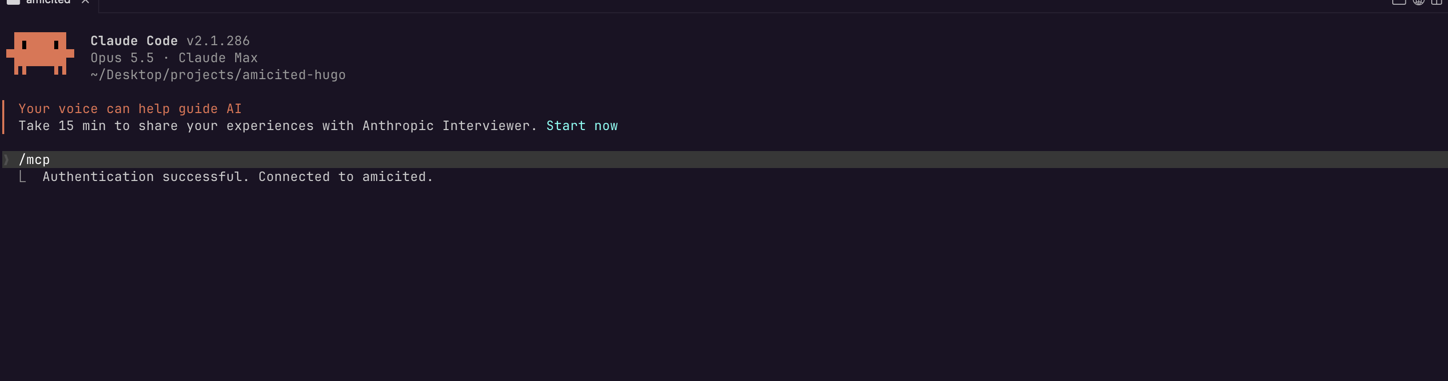
Eine Sache, die man vorab wissen sollte: Mein AmICited-Workspace enthält mehrere Domains. Jeder Prompt, den ich schrieb, nannte amicited.com explizit, und der erste Prompt forderte Claude Code auf, mir mitzuteilen, welche Domain-ID es ausgewählt hatte. Überspringen Sie diesen Schritt, und Sie vertrauen darauf, dass der Agent richtig rät.

Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Schritt 1: Kannibalisierung finden, Rauschen filtern
Verwenden Sie den AmICited MCP Server, um den Keyword-Kannibalisierungsbericht nur für die Domain amicited.com abzurufen (der Workspace enthält mehrere Domains, wählen Sie die für amicited.com und teilen Sie mir mit, welche Domain/Projekt-ID Sie verwendet haben). Verwenden Sie Google Search Console-Daten, letzte 90 Tage. Listen Sie zuerst die MCP-Tools auf, die Sie aufrufen. Rauschen ausschließen: Suchanfragen mit Suchoperatoren (site:, inurl:), reine Marken-/Navigationsanfragen („amicited“, „am i cited“) und Suchanfragen unter 50 Impressionen. Zeigen Sie die Top 15 echten Kannibalisierungs-Cluster als Tabelle an […] Bearbeiten Sie keine Dateien.
Der Rauschfilter existiert aufgrund dessen, wie der rohe Bericht tatsächlich aussieht. Die Liste der „Schlimmsten Wettkämpfe“ auf meinem Dashboard wurde angeführt von site:www.amicited.com (417 URLs), site:amicited.com (277 URLs) und der reinen Markenanfrage amicited (193 URLs). Das ist keine Kannibalisierung. Das bin ich – und wahrscheinlich mein eigenes Team –, das die Seite direkt sucht. Jedes Tool, das das als Kannibalisierungs-Cluster zählt, zählt das Falsche.
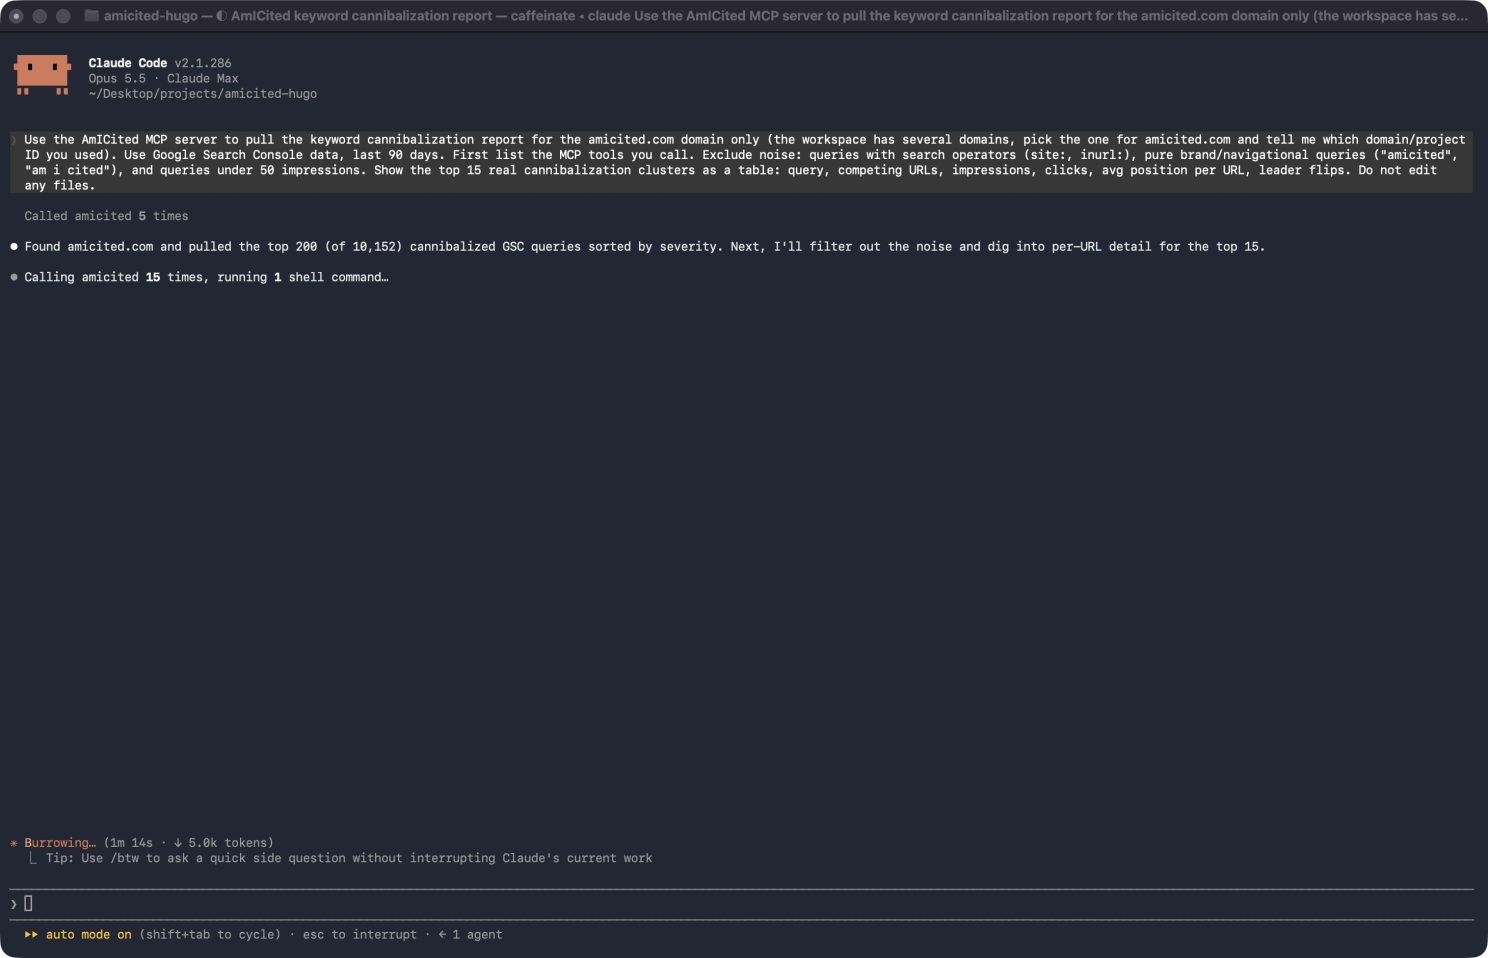
Was es der Reihe nach tat:
list_domains, um amicited.com unter den Domains im Workspace zu finden (und die verwendete Domain-ID zurückzumelden).search_tools, weil die Kannibalisierungs-Tools nicht in seiner Standard-Tool-Liste waren – es suchte also nach ihnen anhand der Beschreibung.describe_tool, zweimal, um die Eingabeschemata für die beiden Kannibalisierungsabfrage-Tools zu lesen, bevor es sie aufrief.- Das Cluster-Listen-Tool, einmal: die Top 200 Suchanfragen nach Schweregrad, von über 10.000 kannibalisierten Suchanfragen im 90-Tage-Fenster.
- Das Detail-Tool pro Suchanfrage, 15 Mal, einmal pro Cluster, das die konkurrierenden URLs und ihre täglichen Positionen abrief. Eine Antwort war zu groß, um inline angezeigt zu werden, also speicherte es die Ausgabe auf der Festplatte und fasste sie mit
jqzusammen.
Dann filterte es. Etwa 30 der Top 200 waren site:-Suchanfragen. Aus eigener Initiative fügte es zwei weitere Filter hinzu und teilte mir mit, dass es dies getan hatte: lange, promptförmige Suchanfragen mit Tausenden von Impressionen und null Klicks (sie lesen sich wie wörtlich kopierte KI-Tracking-Tool-Prompts, nicht wie echte suchende Personen) und einige codeartige Suchanfragen, die nach Bot-Traffic aussahen.
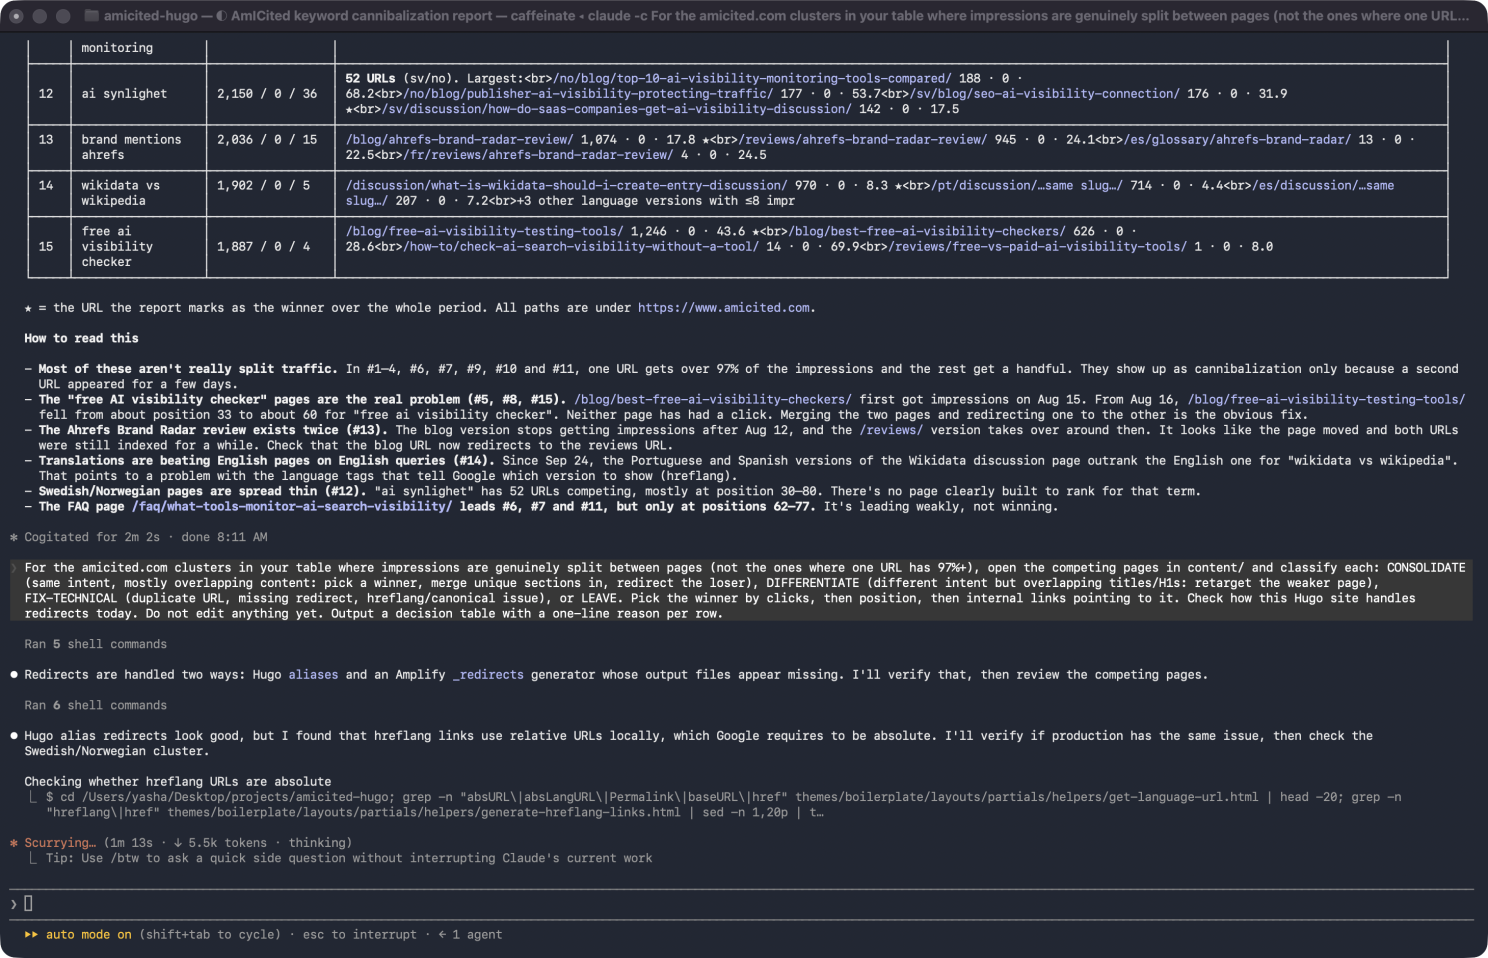
Die nützlichste Zeile in der Ausgabe war nicht die Tabelle selbst. Es war diese:
Die meisten davon sind kein wirklich geteilter Traffic. In neun der fünfzehn Top-Cluster erhält eine URL über 97 % der Impressionen, und der Rest erhält eine Handvoll.
Neun der fünfzehn „Kannibalisierungs“-Cluster bestanden aus einer Seite, die im Wesentlichen die gesamte Arbeit verrichtete, mit einer zweiten URL, die nur für ein paar Tage auftauchte und nicht mehr. Ein reiner Schweregrad-Bericht wird Ihnen das nicht sagen. Die Aufschlüsselung pro URL zu lesen hingegen schon.
Schritt 2: Erst diagnostizieren, dann beheben
Untersuchen Sie für die Cluster in Ihrer Tabelle, bei denen die Impressionen wirklich zwischen den Seiten aufgeteilt sind (nicht die, bei denen eine URL 97 %+ hat), die konkurrierenden Seiten in content/ und klassifizieren Sie jede: CONSOLIDATE, DIFFERENTIATE, FIX-TECHNICAL oder LEAVE. Wählen Sie den Gewinner nach Klicks, dann nach Position, dann nach internen Links, die darauf verweisen. Prüfen Sie, wie diese Hugo-Seite heute Weiterleitungen handhabt. Bearbeiten Sie noch nichts. Geben Sie eine Entscheidungstabelle mit einem einzeiligen Grund pro Zeile aus.
Dieser Schritt tätigte überhaupt keine MCP-Aufrufe. Es waren etwa 20 Shell-Befehle: Lesen der konkurrierenden Markdown-Dateien, Zählen der internen Links zu jeder Seite, Lesen der Theme-Vorlagen und Ausführen von curl gegen die Live-Seite, um zu sehen, was die Weiterleitungen und Hreflang-Tags tatsächlich in der Produktion zurückgaben – nicht nur im Repository.
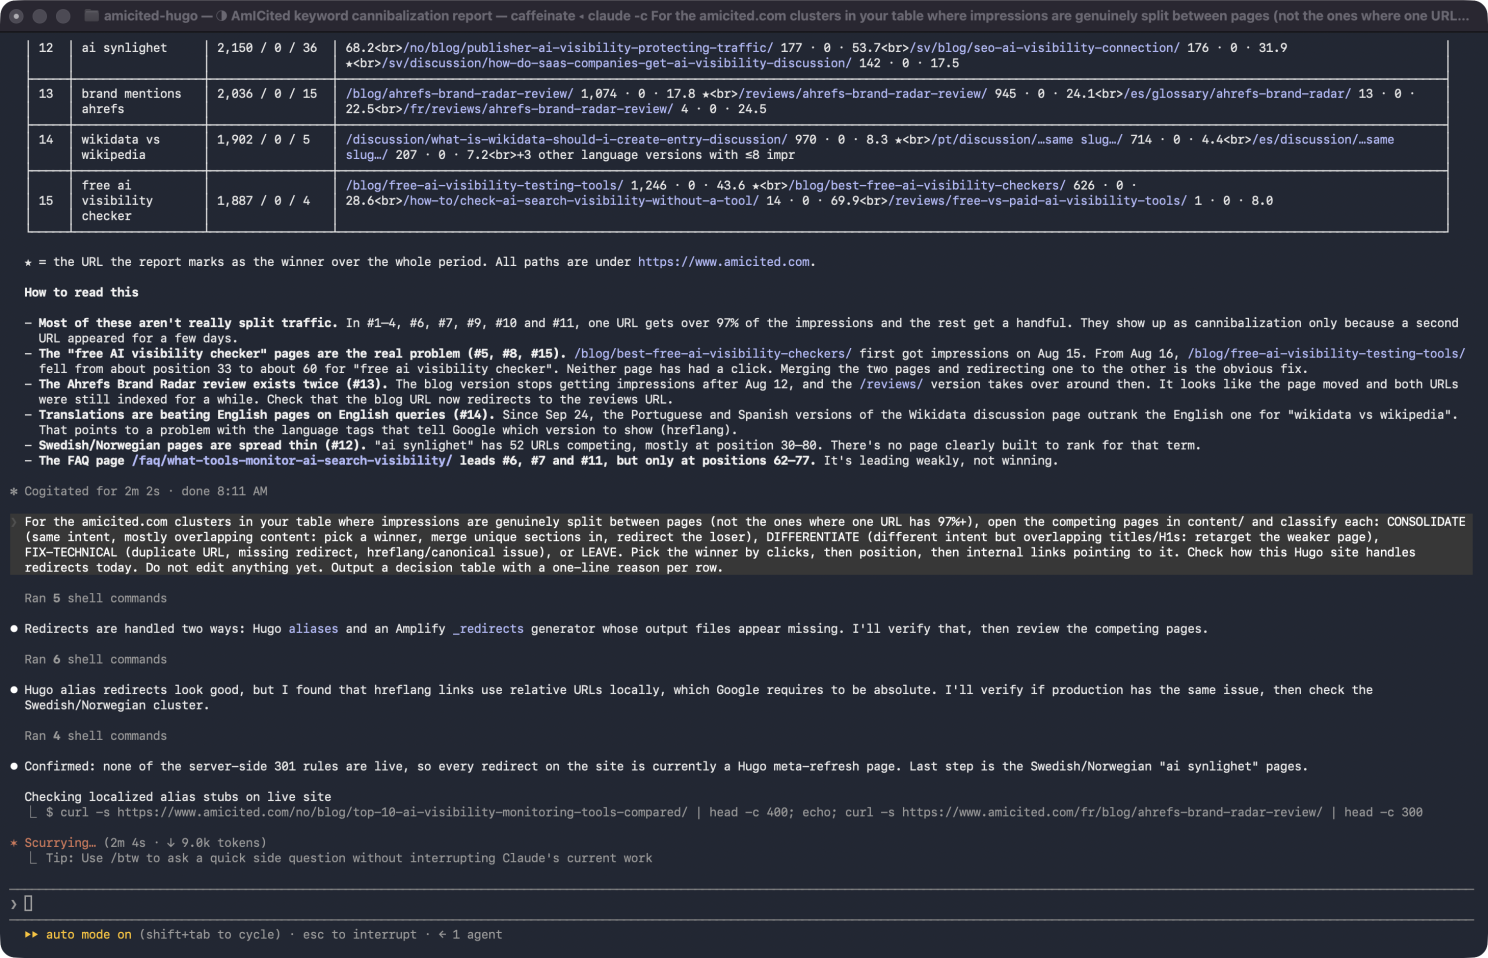
Von den fünfzehn Clustern benötigte eines eine Zusammenführung, eines eine Neuausrichtung, zwei eine technische Korrektur, und der Rest benötigte nichts. Dieses Verhältnis ist der Hauptgrund, warum ich niemals zulassen würde, dass ein Agent direkt von „hier ist ein Kannibalisierungsbericht“ zu „hier sind die Seiten, die ich gelöscht habe“ springt.
Drei Funde, nach denen ich nicht gefragt hatte
1. Meine 301-Weiterleitungsregeln hatten zwei Monate zuvor stillschweigend aufgehört zu funktionieren. Meine Seite hat ein Skript, das echte 301-Regeln für Amplify generiert. Claude Code bemerkte, dass die Ausgabedatei nicht existierte, ging die Git-Historie zurück und fand heraus, dass sie fünf Wochen zuvor innerhalb eines „update content“-Commits gelöscht worden war, der über 21.000 Dateien betraf – Kollateralschaden einer Bulk-Synchronisation, keine bewusste Entscheidung. Es bestätigte auf der Live-Seite, dass keine der Regeln aktiv war (eine verschobene URL gab einen 404 zurück, wo eine Weiterleitung hätte sein sollen). Seitdem war jede „Weiterleitung“ auf der Seite tatsächlich ein Hugo-Alias gewesen: eine Seite mit Status 200 und einem Meta-Refresh, keine echte 301.
2. Das war nicht nur theoretisch. Die alte URL einer Seite, die ich im Juli verschoben hatte, tauchte immer noch eigenständig in der Search Console auf – 188 Impressionen und weiterhin steigend, zweieinhalb Monate nach der Verschiebung. Ein Meta-Refresh-Stub, den Google immer wieder indexiert, ist genau das, was ein kaputter Alias-Aufbau in der Praxis bedeutet.
3. Es korrigierte seinen eigenen Fehler. In Schritt 1 hatte es ein Seitenpaar als wahrscheinliches Hreflang-Problem markiert, da eine übersetzte Version das englische Original überflügelte. In Schritt 2 rief es das Live-HTML ab, überprüfte, ob die Hreflang-Tags absolut und reziprok waren, wie Google es verlangt, und meldete, dass dies korrigierte, was es beim ersten Mal gesagt hatte. Der Befund wechselte von FIX zu LEAVE. Das bekomme ich viel lieber als eine selbstsichere falsche Antwort, die unangefochten in einem Bericht stehen bleibt.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Schritt 3: Die Korrektur in 16 Sprachen anwenden
Genehmigt. Wenden Sie die Entscheidungstabelle auf diesem Branch an, nicht committen. 1) CONSOLIDATE […] ohne Fakten zu erfinden oder Gedankenstriche hinzuzufügen, dann die Verlierer-Seite in jeder Sprache löschen, in der sie existiert, ihre alte URL zu den Aliassen der Gewinner-Seite in jeder passenden Sprache hinzufügen und alle internen Links zur Verlierer-Seite in content/ umbiegen. 2) DIFFERENTIATE […] in allen Sprachen und einen kontextuellen Link zur Gewinner-Seite hinzufügen. 3) FIX-TECHNICAL: Git-Historie prüfen, ob die Löschung von static/_redirects beabsichtigt war. Wenn versehentlich, neu generieren […] Wenn beabsichtigt, nicht wiederherstellen, mir nur mitteilen.
Es überprüfte Fakten, bevor es etwas zusammenführte. Die auszumusternde Seite hatte Bereiche, die die Gewinner-Seite nicht hatte: eine Erwähnung eines Konkurrenz-Tools, eine Produkt-Ranking-Funktion und eine Zusammenstellung kostenloser Testversionen. Bevor Claude Code etwas davon übernahm, rief es die Live-Seiten der Anbieter ab, um zu überprüfen, ob es noch aktuell war.
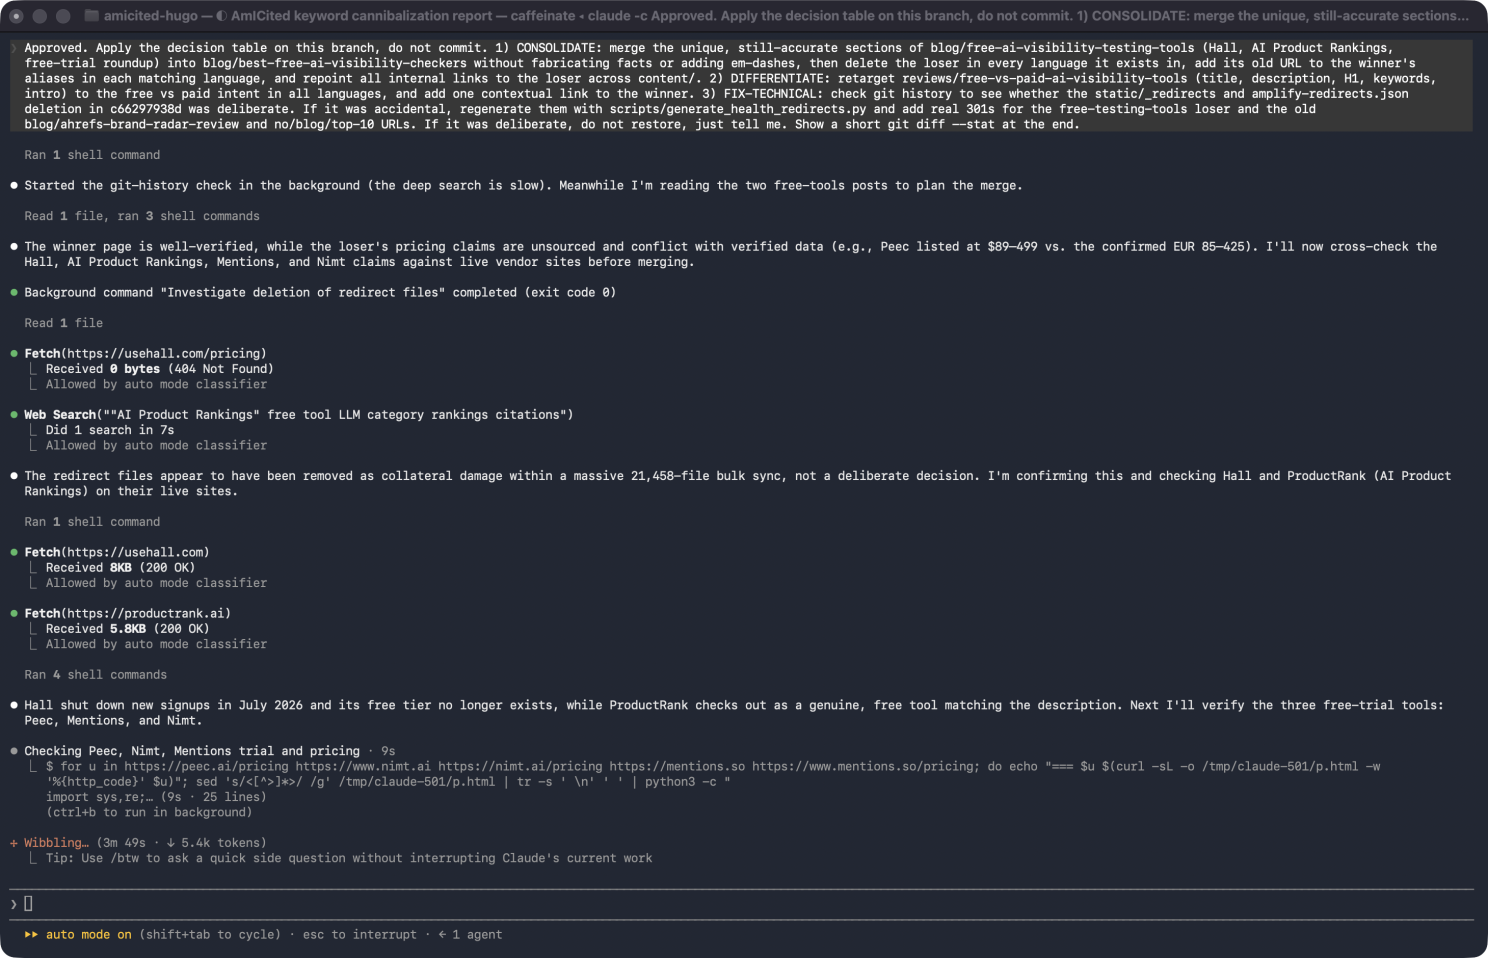
Eines der genannten Tools stellte sich als Wochen zuvor übernommen und für Neuanmeldungen geschlossen heraus – das wurde also zu einer Korrektur, statt als aktuelle Tatsache übernommen zu werden. Die Preisangabe der auszumusternden Seite für ein anderes Tool widersprach zudem der bereits auf der Gewinner-Seite verifizierten Zahl, also blieb der verifizierte Wert erhalten, und der veraltete fand keinen Eingang in die Zusammenführung.
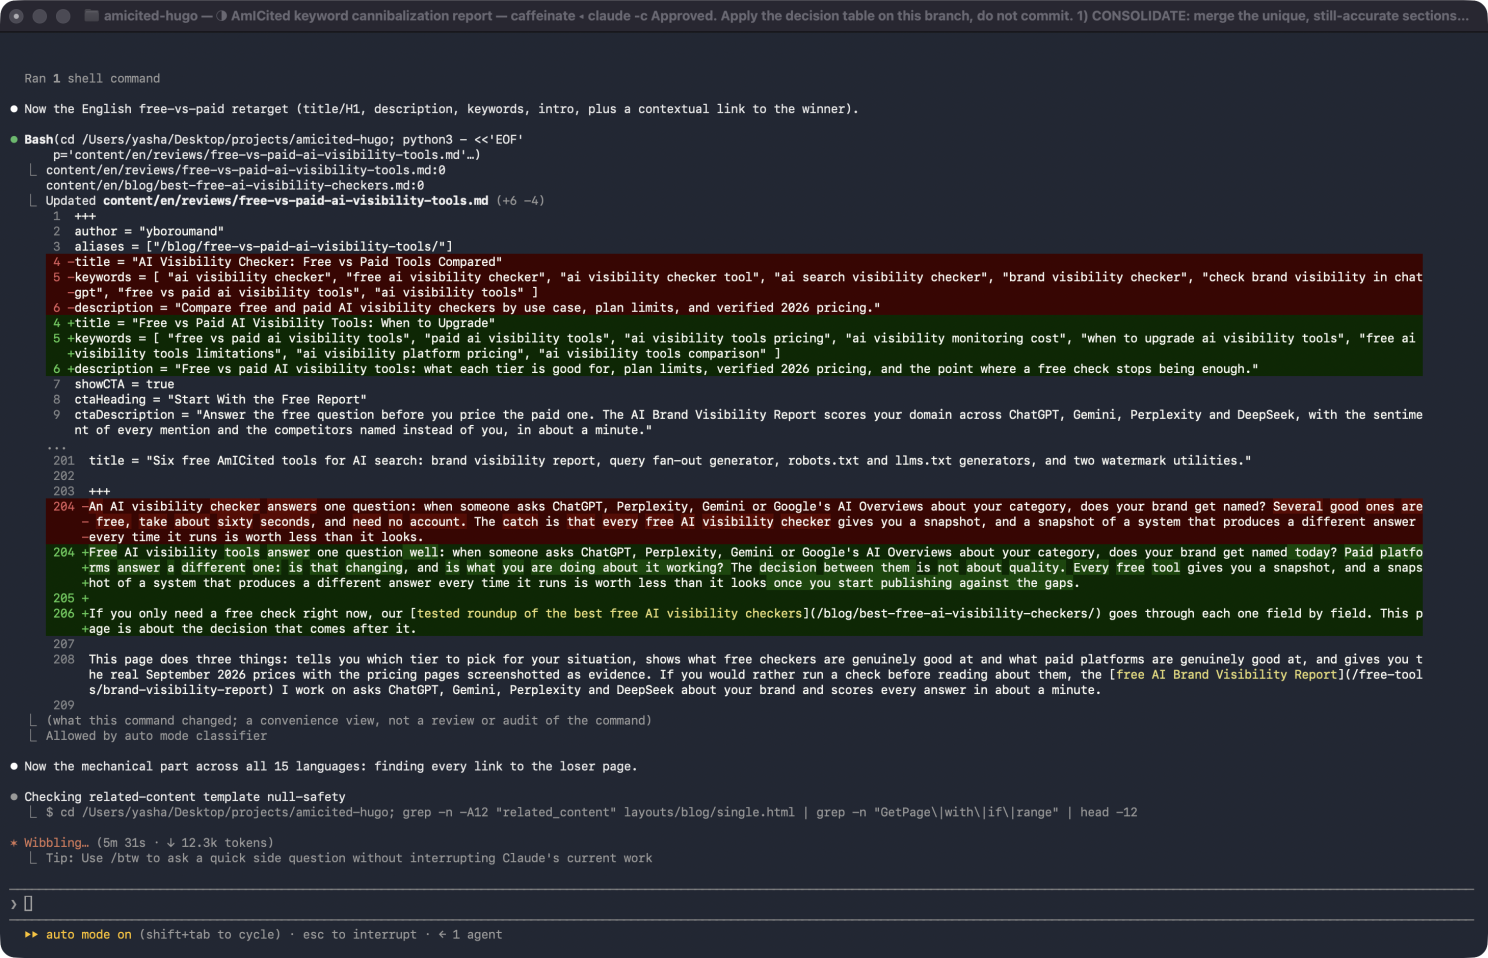
Für den FIX-TECHNICAL-Fall prüfte es, ob die Löschung der Weiterleitungen beabsichtigt war, bevor es etwas anfasste. Nach Bestätigung, dass es versehentlich war (der Bulk-Commit, der sie entfernte, betraf Tausende nicht zusammenhängender Dateien ohne Erwähnung von Weiterleitungen), generierte es die Regeln neu und fügte echte 301-Weiterleitungen für die von der Zusammenführung betroffenen Seiten und die verschobene URL hinzu, die immer noch Impressionen unter ihrer alten Adresse sammelte. Für CONSOLIDATE und DIFFERENTIATE wiederholte es die gleiche Änderung in jeder Sprache, in der die betroffenen Seiten existierten – nicht nur auf Englisch – und führte dann einen vollständigen Produktions-Build durch, um zu bestätigen, dass nichts brach.
Wie es weitergeht
Nachdem Sie neue Inhalte veröffentlicht haben, ist das nicht das Ende der Arbeit, sondern erst der Anfang. Genau zu wissen, welche URLs still miteinander konkurrieren, welche zusammengeführt werden müssen und welche nur eine technische Korrektur benötigen, ist der Schlüssel, damit diese Inhalte nicht gegen sich selbst arbeiten. Nichts aus diesem Durchlauf ist derzeit live; die 28-Tage-Überprüfung, um zu sehen, ob die Anzahl der kannibalisierten Suchanfragen tatsächlich zurückgeht, kommt als Nächstes.
Wenn Sie eine solche Kannibalisierungsanalyse für Ihre eigene Domain sehen möchten, buchen Sie einen Termin und wir gehen sie gemeinsam durch.