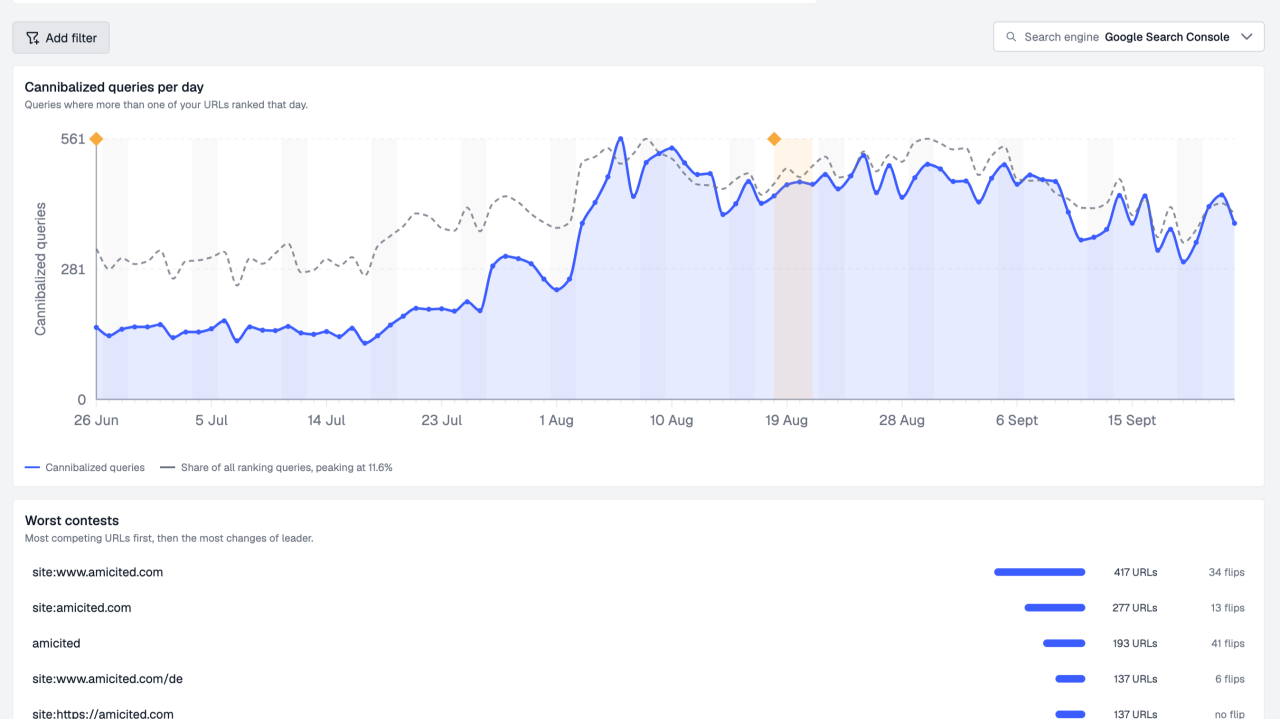
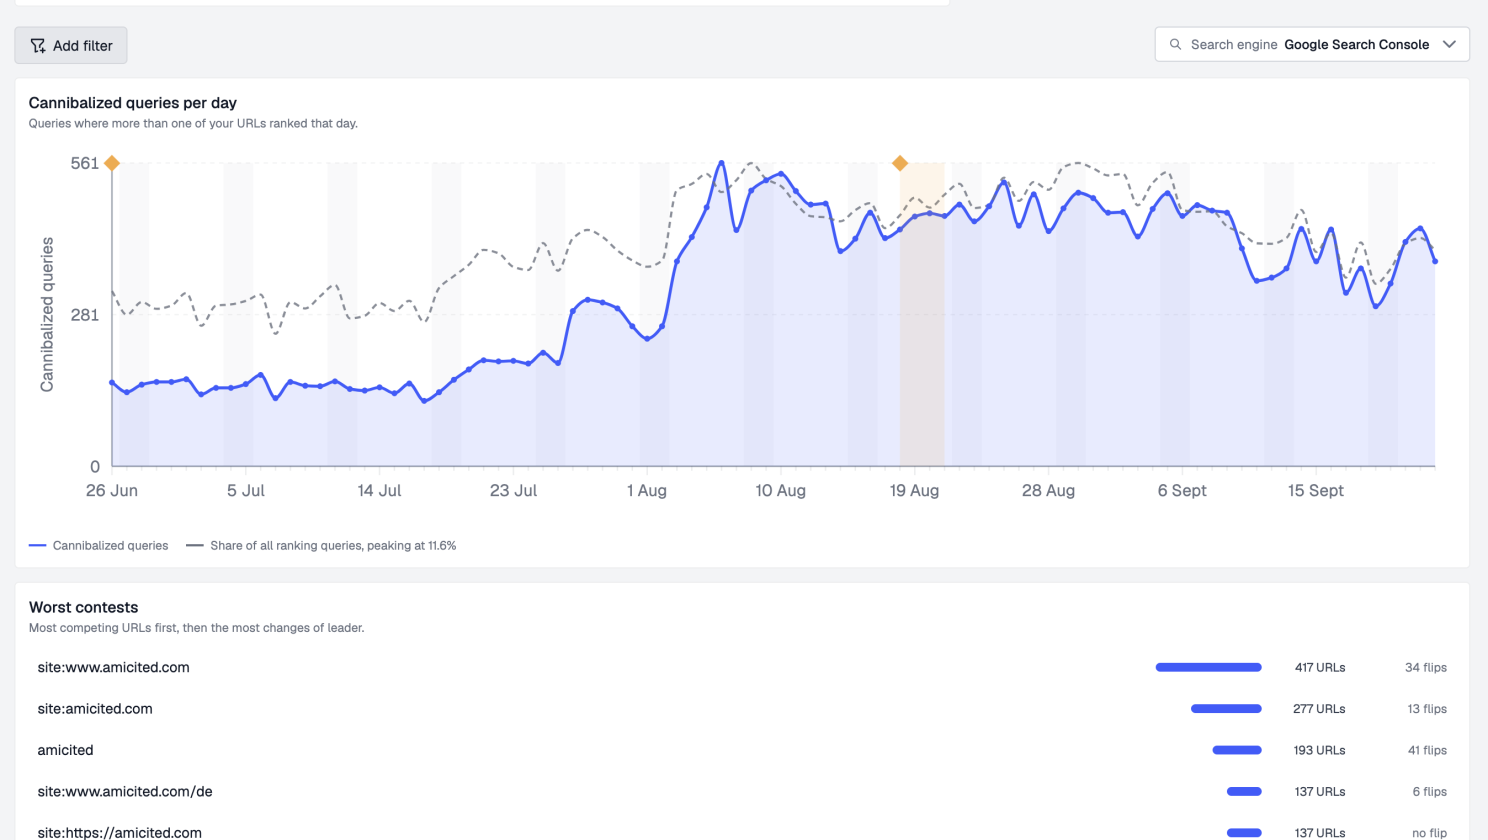
Da 140 a 561 query cannibalizzate al giorno
Tra fine giugno e metà agosto, il numero di query in cui due o più URL di amicited.com sono comparsi nella stessa giornata è salito da circa 140 al giorno a un picco di 561. Nel momento peggiore, le query cannibalizzate costituivano l'11,6% di tutto ciò per cui il sito si posizionava.
Così ho puntato Claude Code sul repository Hugo del sito, l’ho collegato al server MCP SEO di AmICited e gli ho chiesto di trovare la cannibalizzazione delle parole chiave, decidere cosa fare per ogni caso e applicare la correzione in tutte le 16 lingue in cui il sito è disponibile.
Questo è il metodo dall’inizio alla fine: i prompt che ho usato, cosa l’agente ha effettivamente chiamato e fatto, e le tre cose che ha scoperto e che non avevo mai chiesto. Niente di tutto ciò è ancora stato distribuito, quindi consideralo una dimostrazione del processo, non un post sui risultati. Il controllo a 28 giorni arriverà dopo.
La cannibalizzazione delle parole chiave si verifica quando due o più pagine dello stesso sito competono per la stessa query di ricerca, quindi Google continua a scambiare quale mostrare e nessuna delle due si posiziona bene quanto farebbe una singola pagina solida. È concorrenza interna tra i tuoi stessi URL, ed è uno di quei lavori SEO in cui Claude Code dimostra il suo valore: i dati vivono in Search Console, la correzione vive nel repository e un agente può gestire entrambi contemporaneamente. (Da non confondere con la cannibalizzazione dei contenuti AI, dove una risposta generata dall’intelligenza artificiale ruba il click che la tua pagina avrebbe guadagnato.) Se vuoi l’analisi completa, abbiamo scritto separatamente come identificare e risolvere i problemi di cannibalizzazione delle parole chiave.
La configurazione
- Repository: il repository del mio sito Hugo, oltre 500 articoli in inglese, ciascuno tradotto in altre 15 lingue.
- Dati: il server MCP AmICited, che espone report SEO basati su Google Search Console, inclusa la cannibalizzazione, come strumenti che Claude Code può chiamare direttamente.
- Agente: Claude Code (Opus 5.5) in esecuzione in modalità automatica, su un nuovo branch,
seo/cannibalization-oct-2026. Niente viene committato senza che io legga prima il diff.
Collegare il server MCP è un passaggio OAuth unico: esegui /mcp, scegli il server, approva il workspace nel browser e Claude Code può chiamarlo da quel momento in poi.
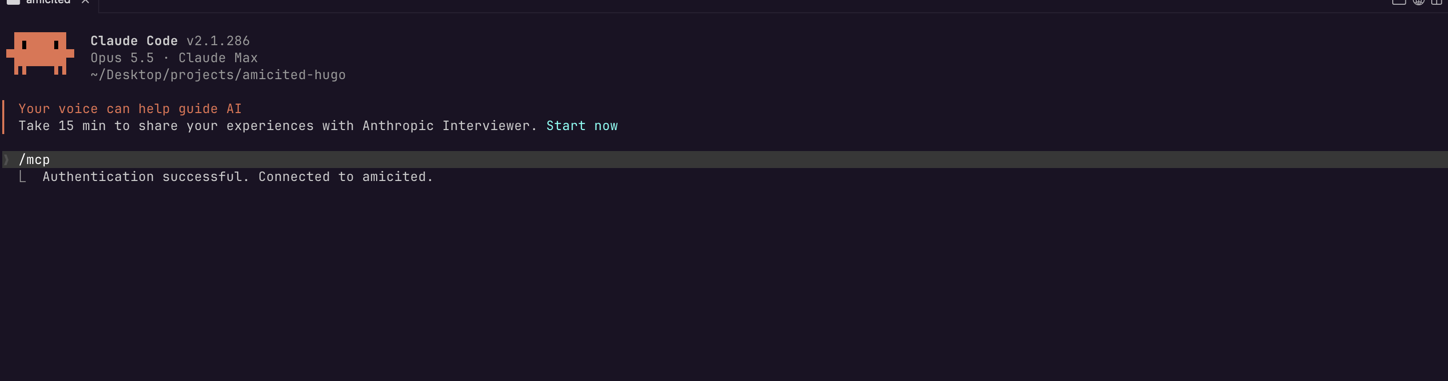
Una cosa utile da sapere in anticipo: il mio workspace AmICited contiene diversi domini. Ogni prompt che ho scritto menzionava esplicitamente amicited.com, e il primo chiedeva a Claude Code di dirmi quale ID di dominio aveva selezionato. Salta questo passaggio e ti affidi all’agente per indovinare correttamente.

Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Fase 1: Trovare la cannibalizzazione, filtrare il rumore
Usa il server MCP AmICited per estrarre il report di cannibalizzazione delle parole chiave solo per il dominio amicited.com (il workspace ha diversi domini, scegli quello per amicited.com e dimmi quale ID dominio/progetto hai usato). Usa i dati di Google Search Console, ultimi 90 giorni. Elenca prima gli strumenti MCP che chiami. Escludi il rumore: query con operatori di ricerca (site:, inurl:), query puramente di brand/navigazionali (“amicited”, “am i cited”) e query con meno di 50 impressioni. Mostra i primi 15 cluster di cannibalizzazione reali come tabella […] Non modificare alcun file.
Il filtro del rumore esiste perché il report grezzo ha un aspetto ben preciso. La lista dei “Peggiori conflitti” sulla mia dashboard era guidata da site:www.amicited.com (417 URL), site:amicited.com (277 URL) e la semplice query di brand amicited (193 URL). Questa non è cannibalizzazione. Sono io, e probabilmente il mio stesso team, che cerchiamo il sito direttamente. Qualsiasi strumento che conta questo come un cluster di cannibalizzazione sta contando la cosa sbagliata.
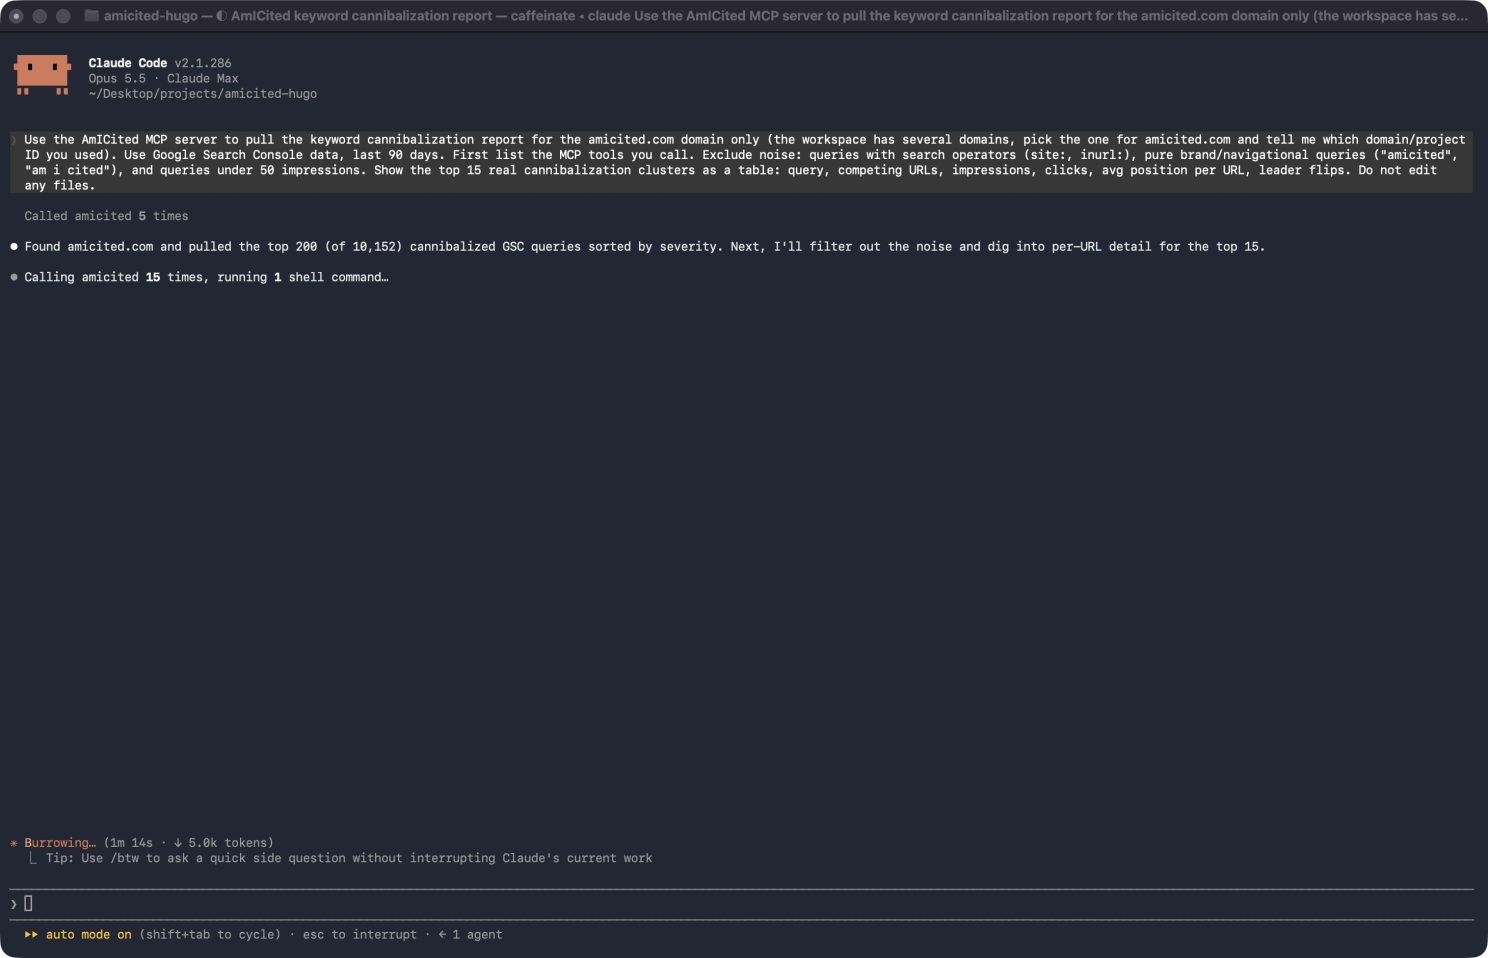
Cosa ha fatto, nell’ordine:
list_domains, per trovare amicited.com tra i domini nel workspace (e riportare l’ID dominio usato).search_tools, perché gli strumenti di cannibalizzazione non erano nella sua lista di strumenti predefinita, quindi li ha cercati per descrizione.describe_tool, due volte, per leggere gli schemi di input dei due strumenti per le query di cannibalizzazione prima di chiamarli.- Lo strumento elenco cluster, una volta: le prime 200 query per gravità, su oltre 10.000 query cannibalizzate nella finestra di 90 giorni.
- Lo strumento dettaglio per query, 15 volte, una per cluster, estraendo gli URL in competizione e le loro posizioni giornaliere. Una risposta era troppo grande per essere visualizzata in linea, quindi ha salvato l’output su disco e lo ha riassunto con
jq.
Poi ha filtrato. Circa 30 delle prime 200 erano query site:. Di propria iniziativa, ha aggiunto altri due filtri e mi ha detto di averlo fatto: lunghe query a forma di prompt con migliaia di impressioni e zero click (sembravano prompt di strumenti di tracciamento AI copiati alla lettera, non vere ricerche umane), e una manciata di query simili a codice che sembravano traffico bot.
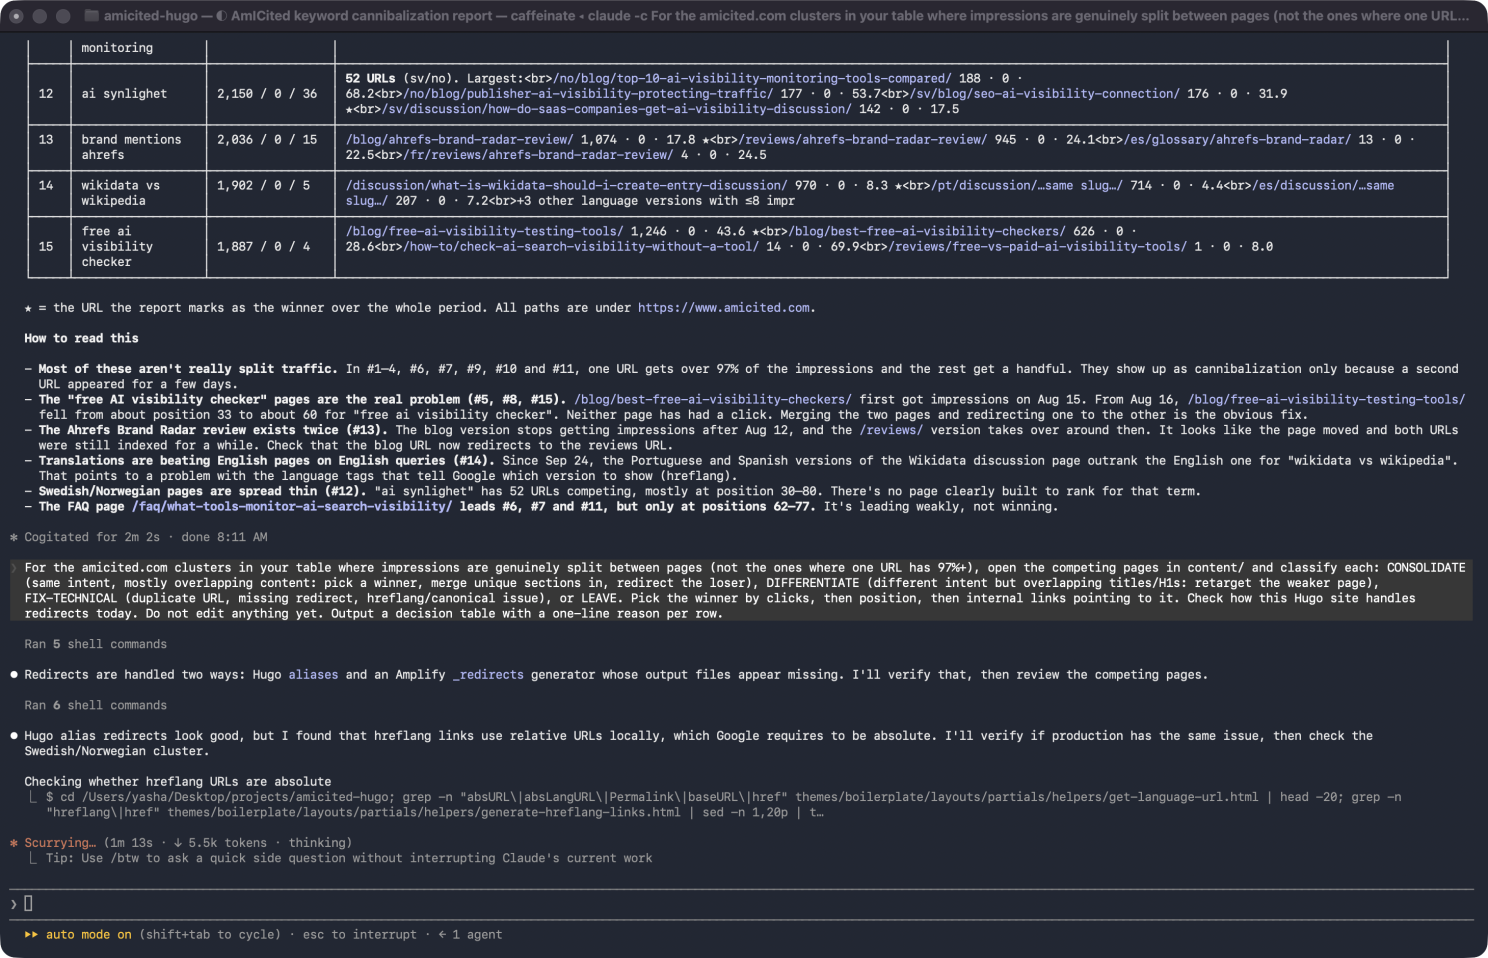
La riga più utile nell’output non era la tabella in sé. Era questa:
La maggior parte di questi non sono realmente traffico diviso. In nove dei primi quindici cluster, un URL ottiene oltre il 97% delle impressioni e gli altri ne ottengono una manciata.
Nove dei primi quindici cluster di “cannibalizzazione” erano una pagina che faceva essenzialmente tutto il lavoro, con un secondo URL apparso per qualche giorno e niente più. Un report ordinato puramente per gravità non te lo dirà. Leggere la suddivisione per-URL sì.
Fase 2: Diagnosticare prima di correggere
Per i cluster nella tua tabella in cui le impressioni sono realmente divise tra le pagine (non quelli in cui un URL ha il 97%+), apri le pagine in competizione in content/ e classifica ciascuna: CONSOLIDARE, DIFFERENZIARE, RISOLVERE-TECNICO o LASCIARE. Scegli il vincitore per click, poi posizione, poi link interni che puntano ad esso. Verifica come questo sito Hugo gestisce i redirect oggi. Non modificare ancora nulla. Restituisci una tabella decisionale con un motivo di una riga per riga.
Questa fase non ha effettuato alcuna chiamata MCP. Si è trattata di circa 20 comandi shell: leggere i file Markdown in competizione, contare i link interni a ciascuna pagina, leggere i template del tema ed eseguire curl verso il sito live per vedere cosa restituivano effettivamente i redirect e i tag hreflang in produzione, non solo nel repository.
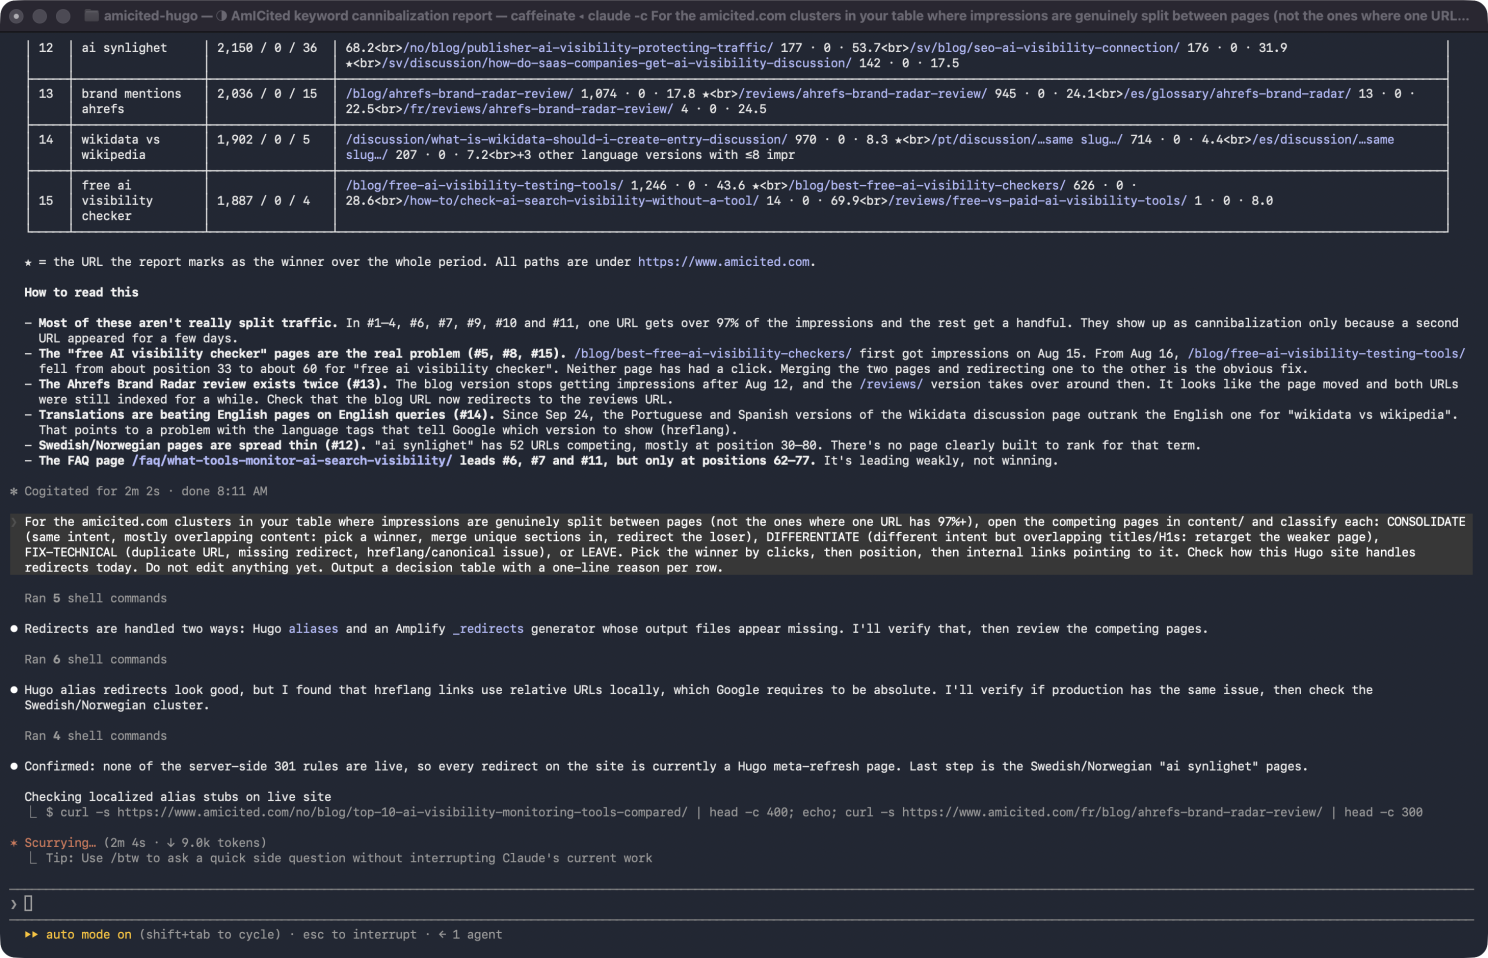
Dei quindici cluster, uno necessitava di una fusione, uno di un ritargettizzazione, due di una correzione tecnica e il resto non necessitava di nulla. Questo rapporto è il motivo principale per cui non lascerei mai che un agente passi direttamente da “ecco un report di cannibalizzazione” a “ecco le pagine che ho cancellato”.
Tre scoperte che non avevo chiesto
1. Le mie regole di redirect 301 avevano smesso silenziosamente di funzionare due mesi prima. Il mio sito ha uno script che genera regole 301 reali per Amplify. Claude Code ha notato che il file di output non esisteva, ha ripercorso la cronologia git e ha scoperto che era stato cancellato cinque settimane prima all’interno di un commit di “aggiornamento contenuti” che aveva toccato oltre 21.000 file, danno collaterale di una sincronizzazione bulk, non una decisione presa intenzionalmente da nessuno. Ha confermato sul sito live che nessuna delle regole era attiva (un URL spostato restituiva un 404 dove avrebbe dovuto esserci un redirect). Da allora, ogni “redirect” sul sito era stato in realtà un alias Hugo: una pagina con stato 200 e un meta refresh, non un vero 301.
2. Non era solo teorico. Il vecchio URL di una pagina che avevo spostato a luglio continuava a comparire da solo in Search Console, 188 impressioni e in aumento, due mesi e mezzo dopo lo spostamento. Uno stub con meta refresh che Google continua comunque a indicizzare è esattamente ciò che un setup di alias rotto sembra nella pratica.
3. Ha corretto il proprio errore. Nella fase 1, aveva segnalato una coppia di pagine come un probabile problema hreflang, poiché una versione tradotta stava superando l’originale inglese. Nella fase 2, ha recuperato l’HTML live, ha verificato che i tag hreflang fossero assoluti e reciproci come richiede Google e ha riferito di aver corretto ciò che aveva detto la prima volta. La scoperta è passata da RISOLVERE a LASCIARE. Preferisco di gran lunga ricevere questo piuttosto che una risposta sbagliata e sicura di sé che rimane incontestata in un report.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Fase 3: Applicare la correzione in 16 lingue
Approvato. Applica la tabella decisionale su questo branch, non committare. 1) CONSOLIDARE […] senza inventare fatti o aggiungere trattini em, poi elimina il perdente in ogni lingua in cui esiste, aggiungi il suo vecchio URL agli alias del vincitore in ciascuna lingua corrispondente e reindirizza tutti i link interni al perdente in content/. 2) DIFFERENZIARE […] in tutte le lingue, e aggiungi un link contestuale al vincitore. 3) RISOLVERE-TECNICO: controlla la cronologia git per vedere se l’eliminazione di static/_redirects è stata deliberata. Se è stata accidentale, rigenerali […] Se è stata deliberata, non ripristinare, dimmelo e basta.
Ha verificato i fatti prima di unire qualsiasi cosa. La pagina da ritirare aveva sezioni che il vincitore non aveva: una menzione di uno strumento concorrente, una funzionalità di classifica prodotti e una raccolta di prove gratuite. Prima di trasferire qualsiasi cosa, Claude Code ha recuperato i siti live dei fornitori per verificare che fosse ancora accurato.
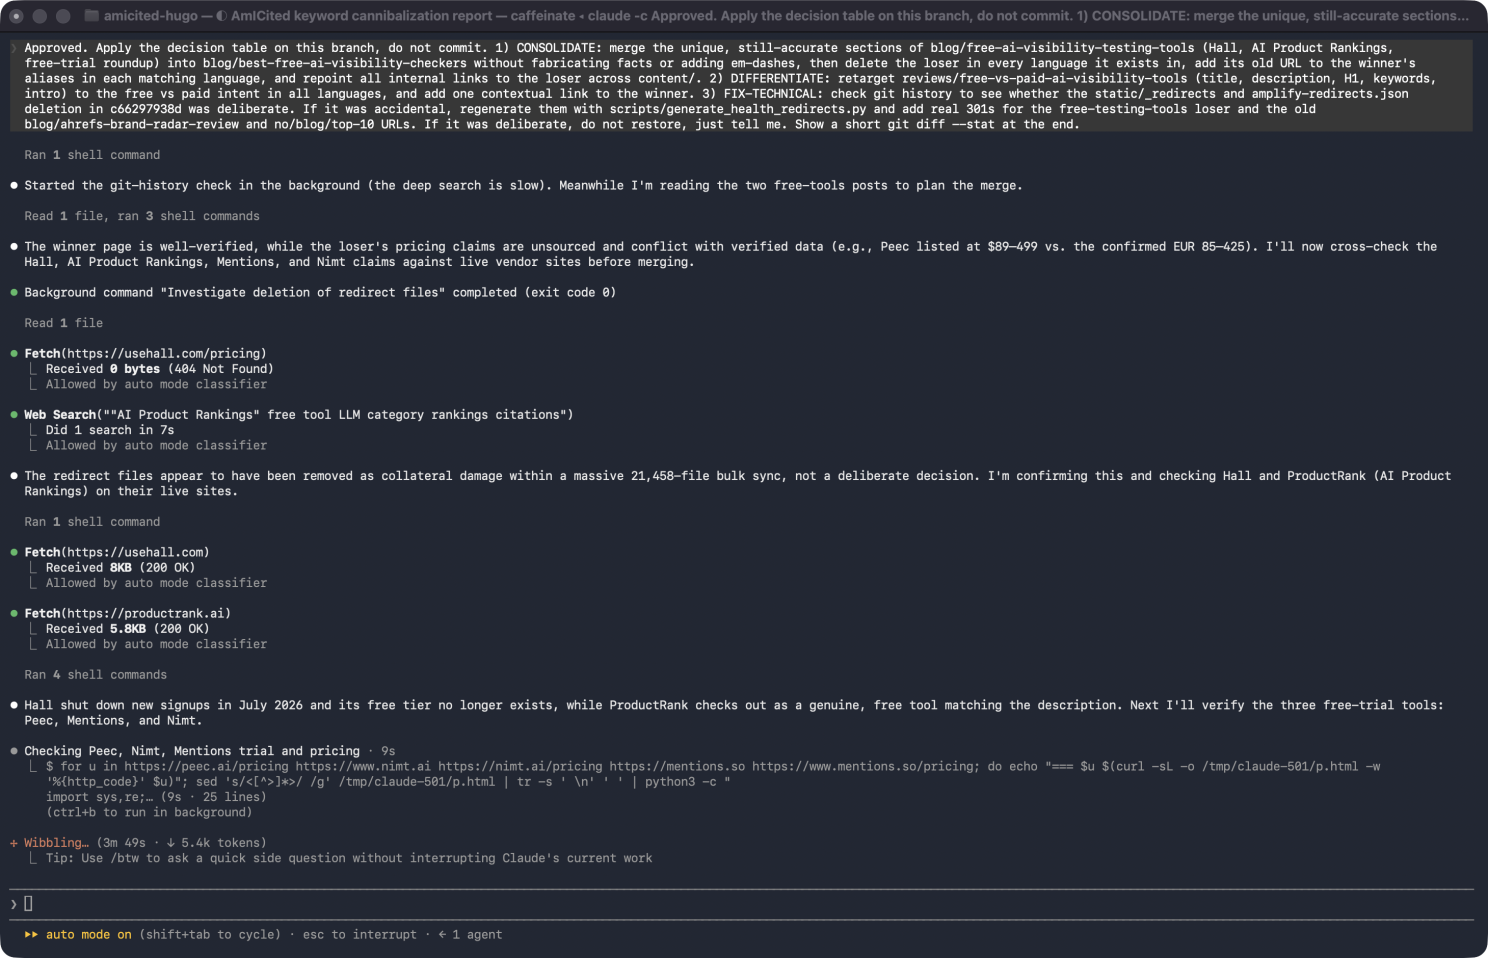
Uno degli strumenti menzionati si è rivelato essere stato acquisito e chiuso a nuove registrazioni settimane prima, quindi questo è diventato una correzione invece di qualcosa copiato come dato di fatto attuale. Anche l’affermazione sui prezzi della pagina ritirata per un altro strumento era in conflitto con il numero già verificato sulla pagina vincente, quindi la cifra verificata è rimasta e quella obsoleta non è finita nella fusione.
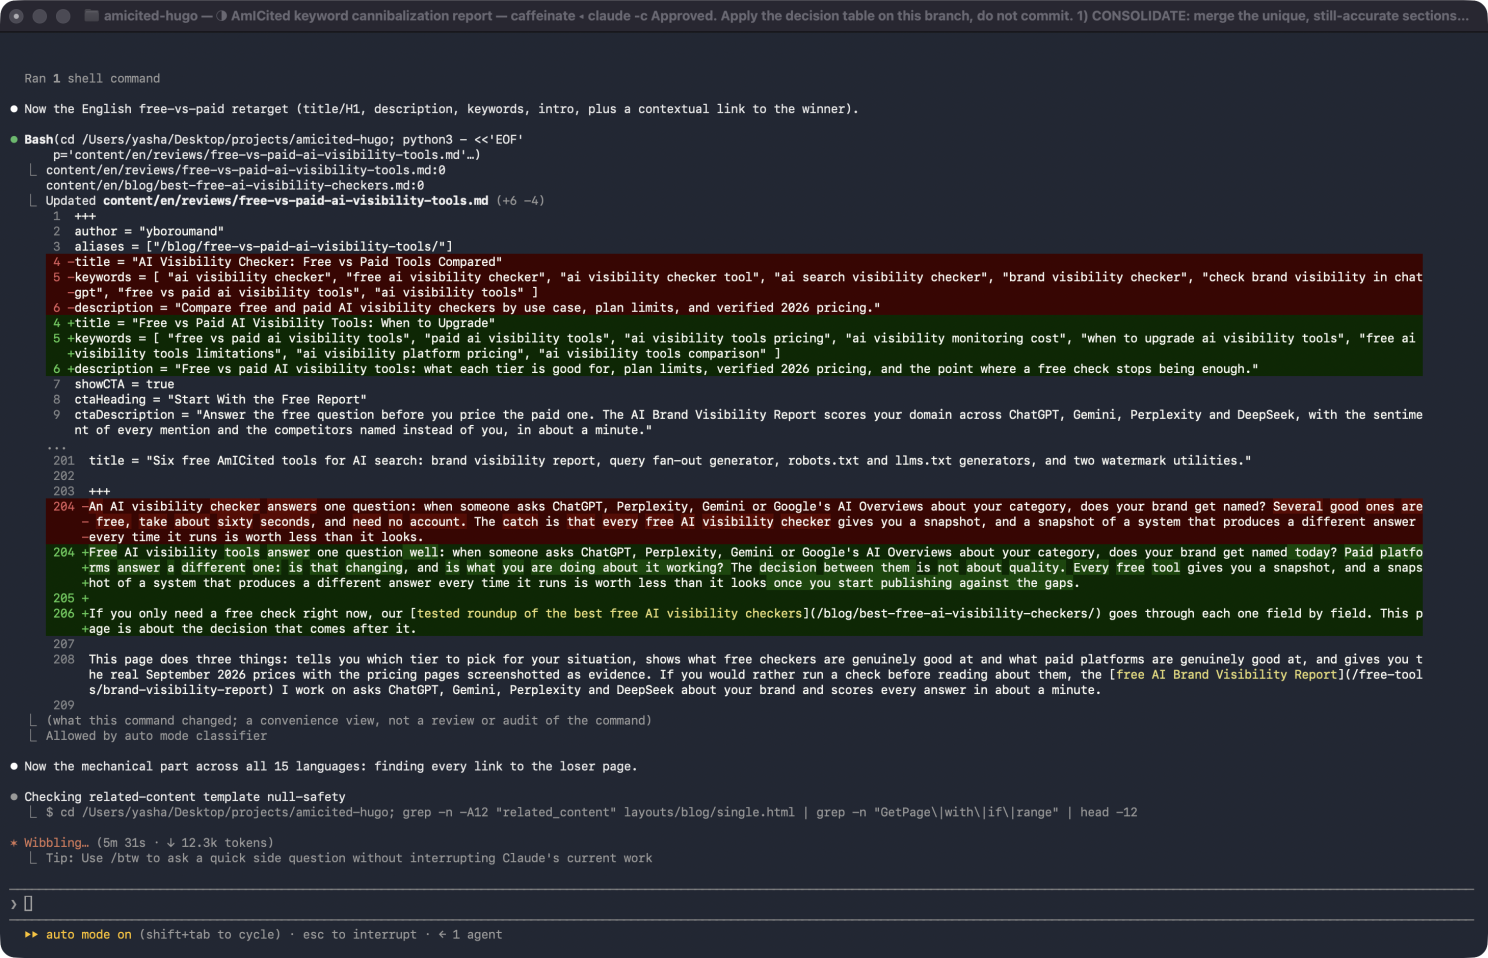
Per il caso RISOLVERE-TECNICO, ha verificato se l’eliminazione del redirect fosse stata deliberata prima di toccare qualsiasi cosa. Confermato che era accidentale (il commit bulk che l’aveva rimossa toccava migliaia di file non correlati senza menzionare redirect), ha rigenerato le regole e aggiunto veri 301 per le pagine interessate dalla fusione e per l’URL spostato che mostrava ancora impressioni sotto il vecchio indirizzo. Per CONSOLIDARE e DIFFERENZIARE, ha ripetuto la stessa modifica in ogni lingua in cui esistevano le pagine interessate, non solo in inglese, poi ha eseguito una build di produzione completa per confermare che nulla si fosse rotto.
Prossimi passi
Dopo aver pubblicato nuovi contenuti, il lavoro non è finito, è solo l’inizio. Sapere esattamente quali URL competono silenziosamente tra loro, quali devono essere uniti e quali necessitano solo di una correzione tecnica è ciò che impedisce ai tuoi contenuti di lavorare contro se stessi. Niente di questo passaggio è ancora live; il controllo a 28 giorni, per vedere se il conteggio delle query cannibalizzate scende effettivamente, è il prossimo passo.
Se vuoi vedere questo tipo di report di cannibalizzazione sul tuo dominio, prenota una chiamata e lo esamineremo insieme.