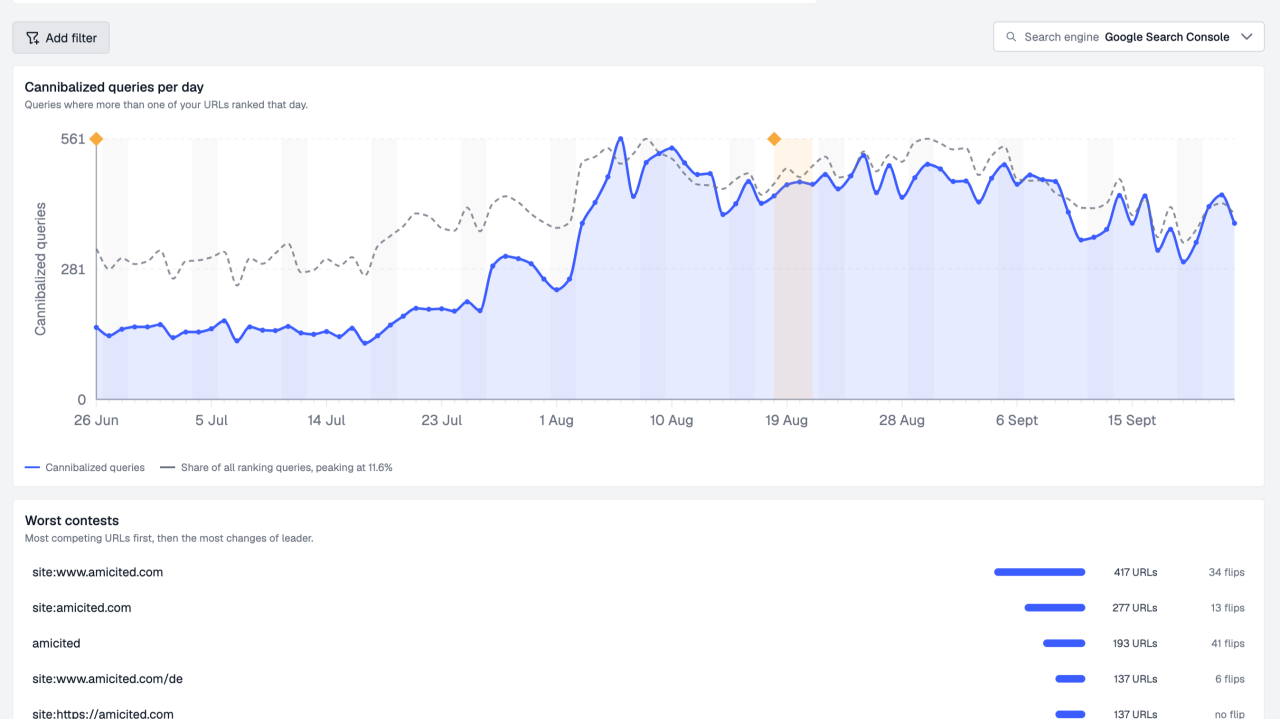
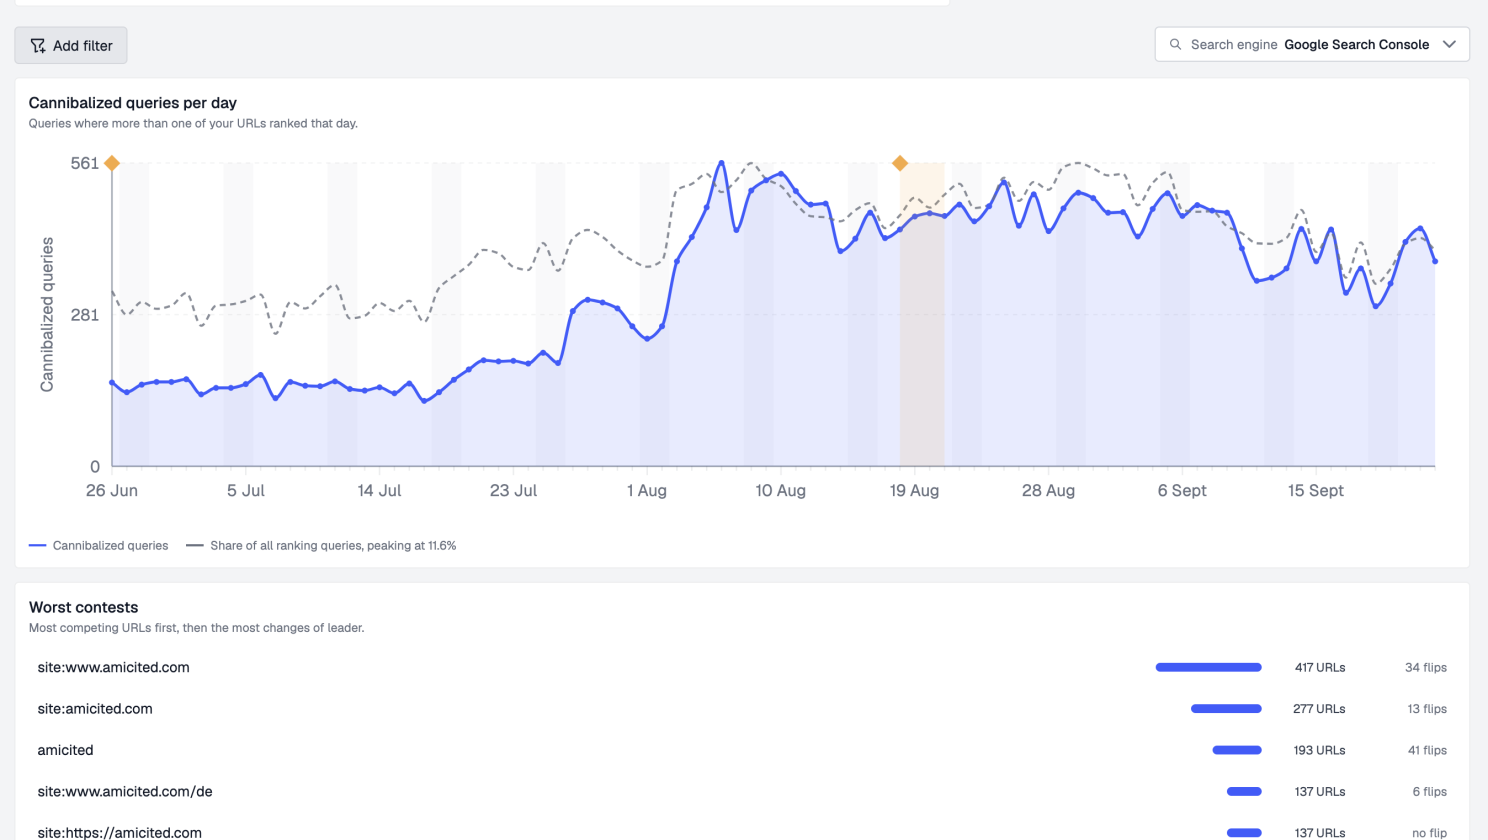
Van 140 naar 561 gecannibaliseerde zoekopdrachten per dag
Tussen eind juni en half augustus steeg het aantal zoekopdrachten waarbij twee of meer amicited.com-URL’s op dezelfde dag rankten van ongeveer 140 per dag naar een piek van 561. Op het ergste punt maakten gecannibaliseerde zoekopdrachten 11,6% uit van alles waarvoor de site rankte.
Dus richtte ik Claude Code op de Hugo-repo van de site, verbond het met de AmICited SEO MCP-server en vroeg het om de keywordcannibalisatie te vinden, te beslissen wat er met elk geval moest gebeuren en de oplossing toe te passen in alle 16 talen waarin de site wordt geleverd.
Dit is de end-to-end-methode: de prompts die ik gebruikte, wat de agent daadwerkelijk aanriep en deed, en de drie dingen die het naar boven bracht waar ik nooit naar had gevraagd. Er is nog niets van live gezet, dus beschouw dit als een walkthrough van het proces, niet als een resultatenpost. De 28-dagen-hercontrole komt later.
Keywordcannibalisatie is wanneer twee of meer pagina’s op dezelfde site concurreren voor dezelfde zoekopdracht, waardoor Google blijft wisselen welke pagina het toont en geen van beide zo goed rankt als een enkele sterke pagina zou doen. Het is interne concurrentie tussen je eigen URL’s, en het is een van de SEO-taken waarbij Claude Code zijn waarde bewijst: de gegevens leven in Search Console, de oplossing leeft in de repo en een agent kan beide tegelijk vasthouden. (Verwar het niet met AI-contentcannibalisatie, waarbij een AI-gegenereerd antwoord de klik wegneemt die jouw pagina anders zou hebben verdiend.) Als je de volledige uitleg wilt, hebben we apart beschreven hoe je keywordcannibalisatieproblemen kunt identificeren en oplossen.
De voorbereiding
- Repo: de repository van mijn Hugo-site, 500+ Engelse blogberichten, elk vertaald naar 15 andere talen.
- Gegevens: de AmICited MCP-server, die op Google Search Console gebaseerde SEO-rapporten, inclusief cannibalisatie, blootstelt als tools die Claude Code direct kan aanroepen.
- Agent: Claude Code (Opus 5.5) in automatische modus, op een nieuwe branch,
seo/cannibalization-oct-2026. Er wordt niets gecommit zonder dat ik eerst de diff heb gelezen.
Het aansluiten van de MCP-server is een eenmalige OAuth-stap: voer /mcp uit, kies de server, keur de werkruimte goed in de browser, en Claude Code kan er vanaf dat moment mee praten.
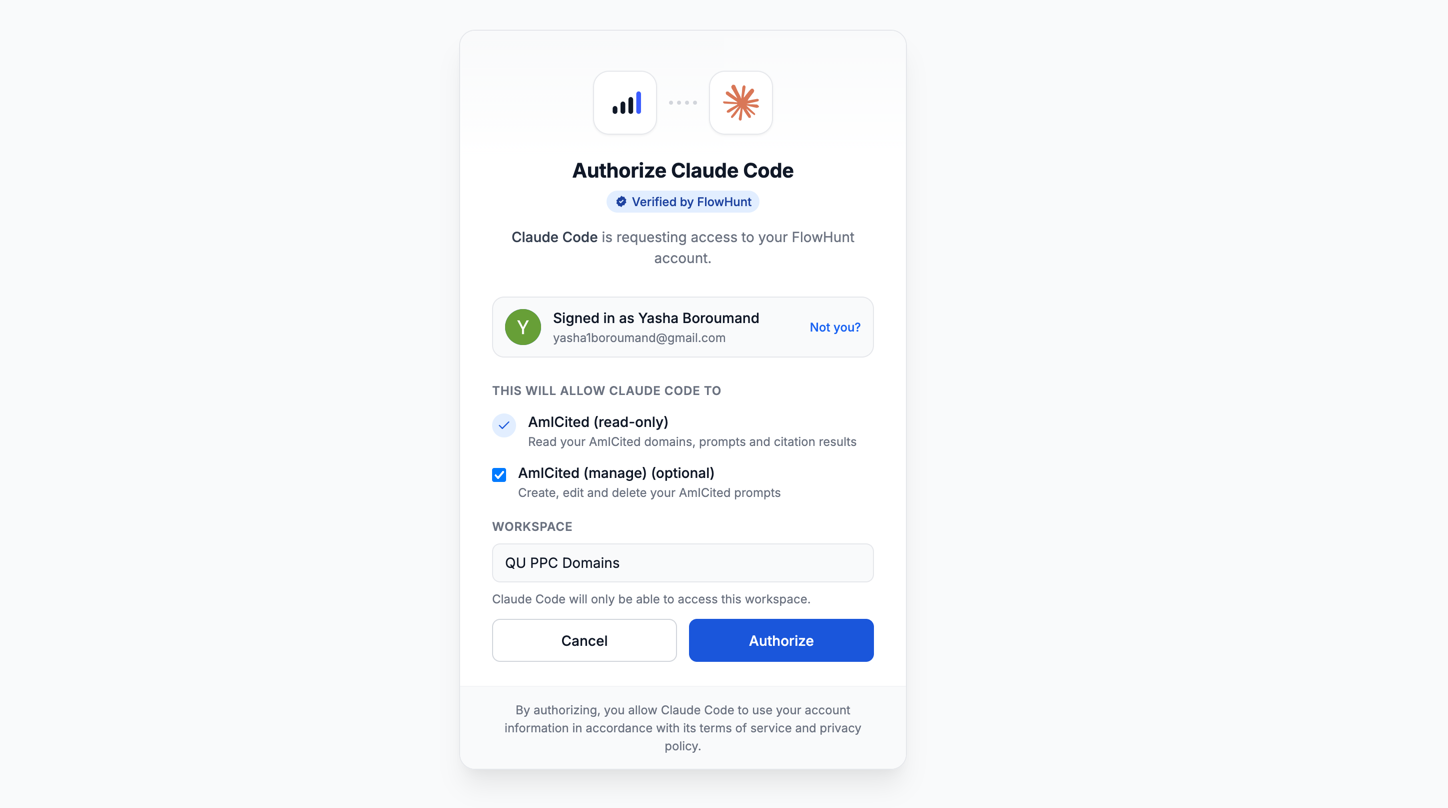
Eén ding dat het waard is om vooraf te weten: mijn AmICited-werkruimte bevat meerdere domeinen. Elke prompt die ik schreef, noemde expliciet amicited.com, en de eerste vroeg Claude Code om me te vertellen welk domein-ID het had gekozen. Sla die stap over en je vertrouwt erop dat de agent correct raadt.

Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Stap 1: Cannibalisatie vinden, ruis wegfilteren
Gebruik de AmICited MCP-server om het keywordcannibalisatierapport op te halen voor alleen het amicited.com-domein (de werkruimte heeft meerdere domeinen, kies die voor amicited.com en vertel me welk domein-/project-ID je hebt gebruikt). Gebruik Google Search Console-gegevens, laatste 90 dagen. Noem eerst de MCP-tools die je aanroept. Sluit ruis uit: zoekopdrachten met zoekoperators (site:, inurl:), zuivere merk-/navigatievragen (“amicited”, “am i cited”) en zoekopdrachten met minder dan 50 impressies. Toon de top 15 echte cannibalisatieclusters als een tabel […] Bewerk geen bestanden.
Het ruisfilter bestaat vanwege hoe het ruwe rapport er eigenlijk uitziet. De lijst “Slechtste wedstrijden” op mijn dashboard werd aangevoerd door site:www.amicited.com (417 URL’s), site:amicited.com (277 URL’s) en de kale merkvraag amicited (193 URL’s). Dat is geen cannibalisatie. Dat ben ik, en waarschijnlijk mijn eigen team, die de site direct doorzoeken. Elke tool dat dat als een cannibalisatiecluster telt, telt het verkeerde.
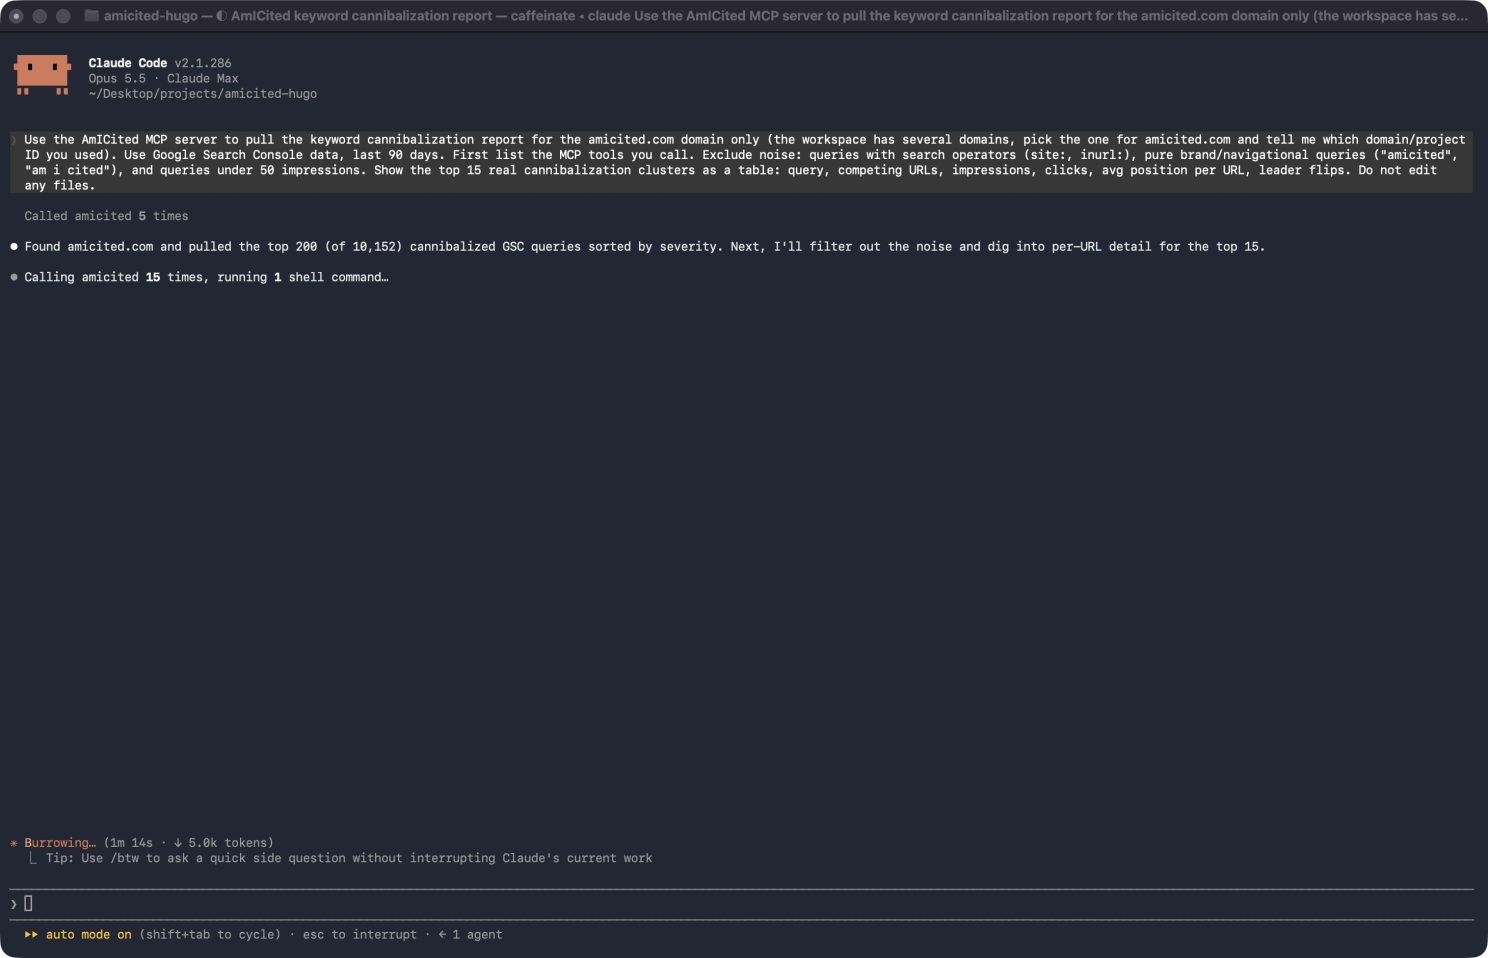
Wat het deed, in volgorde:
list_domains, om amicited.com te vinden tussen de domeinen in de werkruimte (en het gebruikte domein-ID te rapporteren).search_tools, omdat de cannibalisatietools niet in de standaard gereedschapslijst stonden, dus zocht het ernaar op beschrijving.describe_tool, twee keer, om de invoerschema’s voor de twee cannibalisatie-querytools te lezen voordat het ze aanriep.- De clusterlijst-tool, eenmaal: de top 200 zoekopdrachten op ernst, uit meer dan 10.000 gecannibaliseerde zoekopdrachten in het 90-dagenvenster.
- De per-query-detailtool, 15 keer, één keer per cluster, met de concurrerende URL’s en hun dagelijkse posities. Eén antwoord was te groot om inline weer te geven, dus sloeg het de uitvoer op schijf op en vatte het samen met
jq.
Daarna filterde het. Ongeveer 30 van de top 200 waren site:-zoekopdrachten. Op eigen initiatief voegde het twee extra filters toe en vertelde me dat het dat had gedaan: lange, prompt-achtige zoekopdrachten met duizenden impressies en nul klikken (ze lezen als AI-tracking-tool-prompts letterlijk gekopieerd, niet echte mensen die zoeken), en een handvol code-achtige zoekopdrachten die eruitzagen als botverkeer.
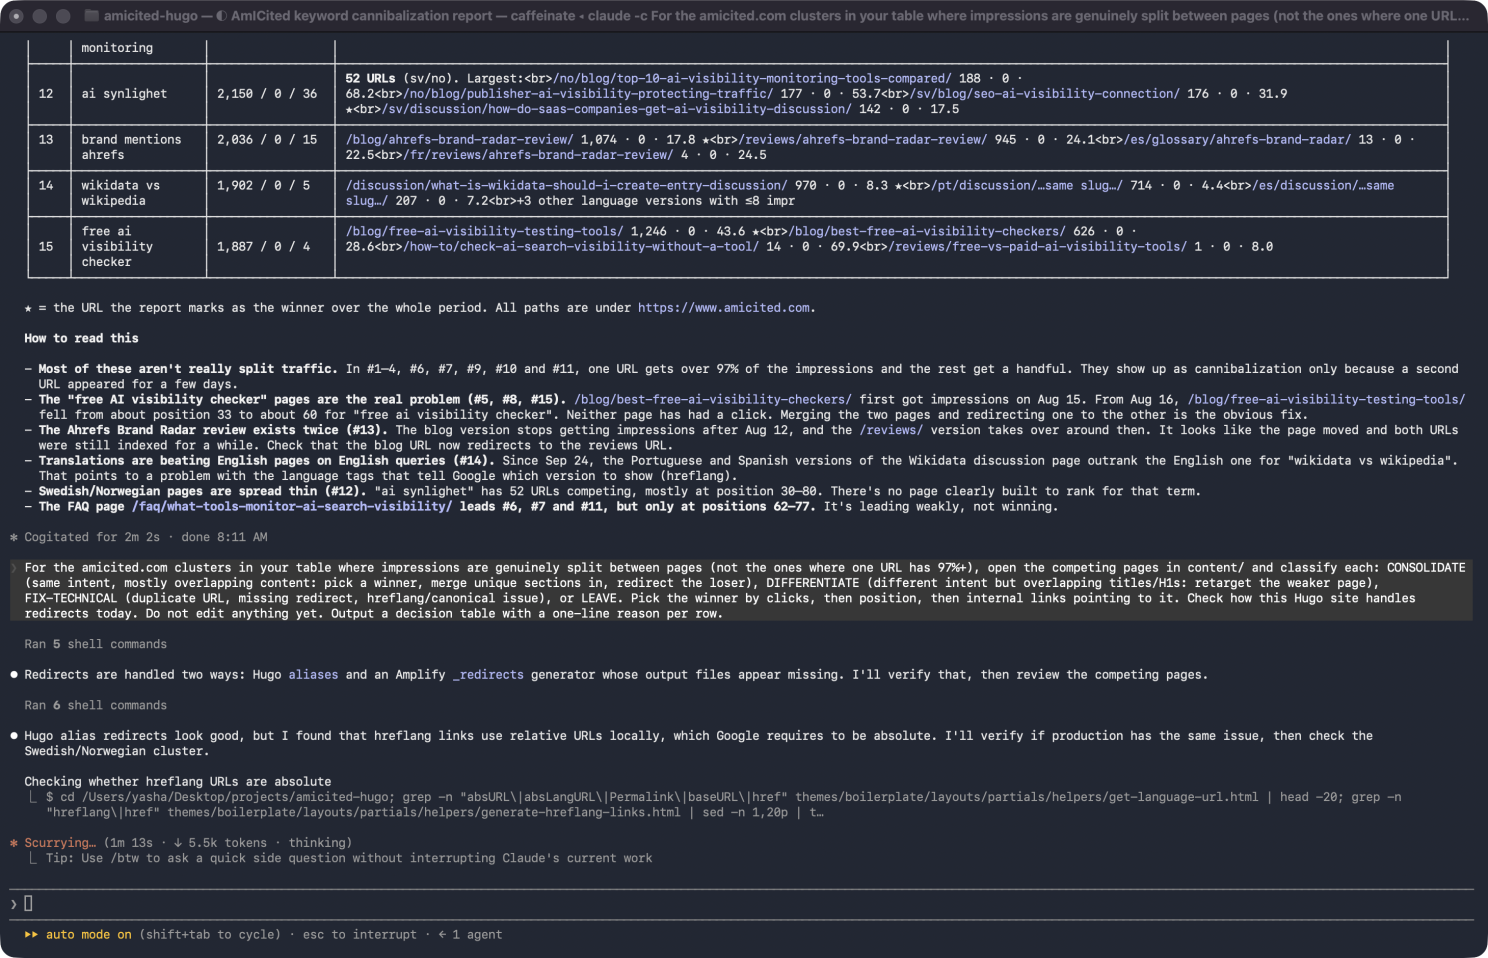
De meest bruikbare regel in de uitvoer was niet de tabel zelf. Het was deze:
De meeste hiervan zijn niet echt gesplitst verkeer. In negen van de top vijftien clusters krijgt één URL meer dan 97% van de impressies en de rest krijgt een handvol.
Negen van de top vijftien “cannibalisatie”-clusters waren één pagina die in wezen al het werk deed, met een tweede URL die een paar dagen was verschenen en niets meer. Een rapport dat puur op ernst is gesorteerd, vertelt je dat niet. Het lezen van de per-URL-verdeling wel.
Stap 2: Eerst diagnose, dan oplossen
Voor de clusters in je tabel waar impressies echt zijn verdeeld over pagina’s (niet die waar één URL 97%+ heeft), open de concurrerende pagina’s in content/ en classificeer ze: CONSOLIDATEER, DIFFERENTIEER, FIX-TECHNISCH of LAAT RUSTEN. Kies de winnaar op klikken, dan positie, dan interne links ernaartoe. Controleer hoe deze Hugo-site vandaag met redirects omgaat. Bewerk nog niets. Geef een beslissingstabel met een reden van één regel per rij.
Deze stap maakte helemaal geen MCP-aanroepen. Het ging om ongeveer 20 shell-commando’s: het lezen van de concurrerende Markdown-bestanden, het tellen van interne links naar elke pagina, het lezen van de themasjablonen en het uitvoeren van curl tegen de live site om te zien wat de redirects en hreflang-tags daadwerkelijk in productie teruggaven, niet alleen in de repo.
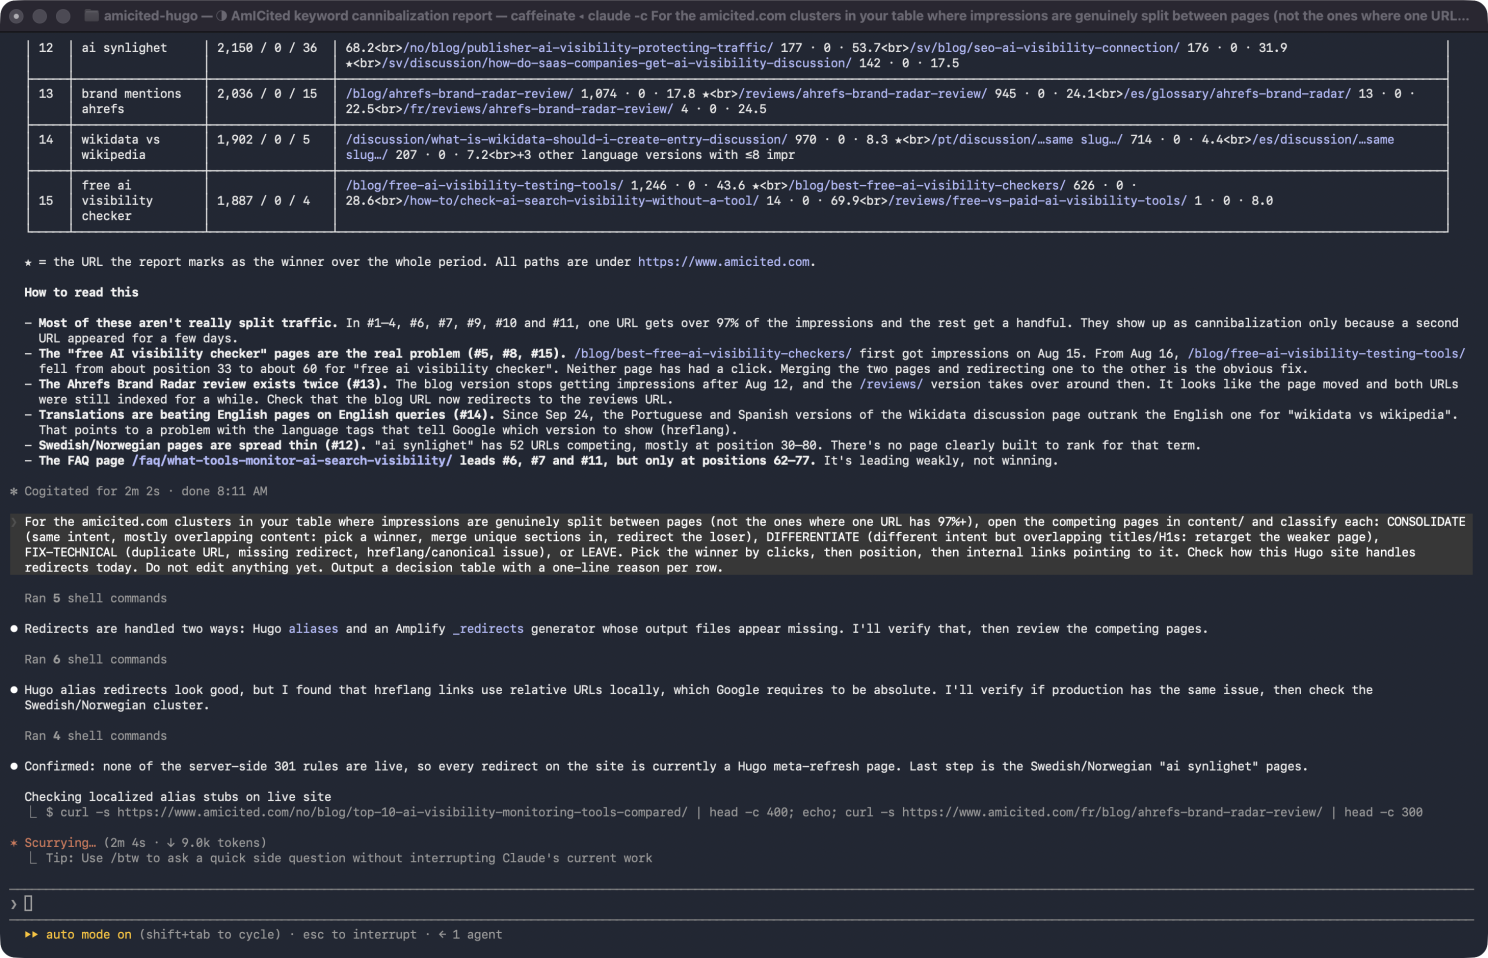
Van de vijftien clusters moest er één worden samengevoegd, één moest worden gehertarget, twee hadden een technische oplossing nodig en de rest had helemaal niets nodig. Die verhouding is de belangrijkste reden waarom ik nooit een agent rechtstreeks van “hier is een cannibalatierapport” naar “hier zijn de pagina’s die ik heb verwijderd” zou laten springen.
Drie vondsten waar ik niet om vroeg
1. Mijn 301-redirectregels waren twee maanden eerder stilletjes gestopt met werken. Mijn site heeft een script dat echte 301-regels genereert voor Amplify om te serveren. Claude Code merkte dat het uitvoerbestand niet bestond, liep terug door de git-geschiedenis en ontdekte dat het vijf weken eerder was verwijderd in een “update content”-commit die meer dan 21.000 bestanden raakte, collateral damage van een bulk-sync, geen beslissing die iemand bewust had genomen. Het bevestigde op de live site dat geen van de regels actief was (een verplaatste URL retourneerde een 404 waar een redirect had moeten zijn). Sindsdien was elke “redirect” op de site eigenlijk een Hugo-alias geweest: een pagina met status 200 met een meta-refresh, geen echte 301.
2. Dat was niet alleen theoretisch. De oude URL van een pagina die ik in juli had verplaatst, verscheen nog steeds op zichzelf in Search Console, 188 impressies en tellende, tweeënhalf maand na de verhuizing. Een meta-refresh-stub die Google toch blijft indexeren, is precies hoe een kapotte alias-opzet er in de praktijk uitziet.
3. Het ontdekte zijn eigen fout. In stap 1 had het één paginapaar gesignaleerd als een waarschijnlijk hreflang-probleem, omdat een vertaalde versie hoger rankte dan het Engelse origineel. In stap 2 haalde het de live HTML op, controleerde of de hreflang-tags absoluut en wederkerig waren zoals Google vereist, en rapporteerde dat dit corrigeerde wat het de eerste keer had gezegd. De bevinding veranderde van FIX naar LAAT RUSTEN. Dat krijg ik veel liever dan een zelfverzekerd fout antwoord dat onbetwist in een rapport blijft staan.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Stap 3: De oplossing toepassen in 16 talen
Goedgekeurd. Pas de beslissingstabel toe op deze branch, commit niet. 1) CONSOLIDATEER […] zonder feiten te verzinnen of em-dashes toe te voegen, verwijder dan de verliezer in elke taal waarin deze bestaat, voeg de oude URL toe aan de aliassen van de winnaar in elke overeenkomende taal, en verwijs alle interne links naar de verliezer in content/ opnieuw. 2) DIFFERENTIEER […] in alle talen, en voeg één contextuele link naar de winnaar toe. 3) FIX-TECHNISCH: controleer de git-geschiedenis om te zien of de verwijdering van static/_redirects opzettelijk was. Als het per ongeluk was, genereer ze opnieuw […] Als het opzettelijk was, herstel ze dan niet, vertel het me gewoon.
Het factcheckte voordat het iets samenvoegde. De pagina die werd vervangen had secties die de winnaar niet had: een vermelding van een concurrerende tool, een product-rankingfunctie en een overzicht van gratis proefversies. Voordat Claude Code iets overdroeg, haalde het de live sites van de leveranciers op om te verifiëren dat het nog steeds accuraat was.
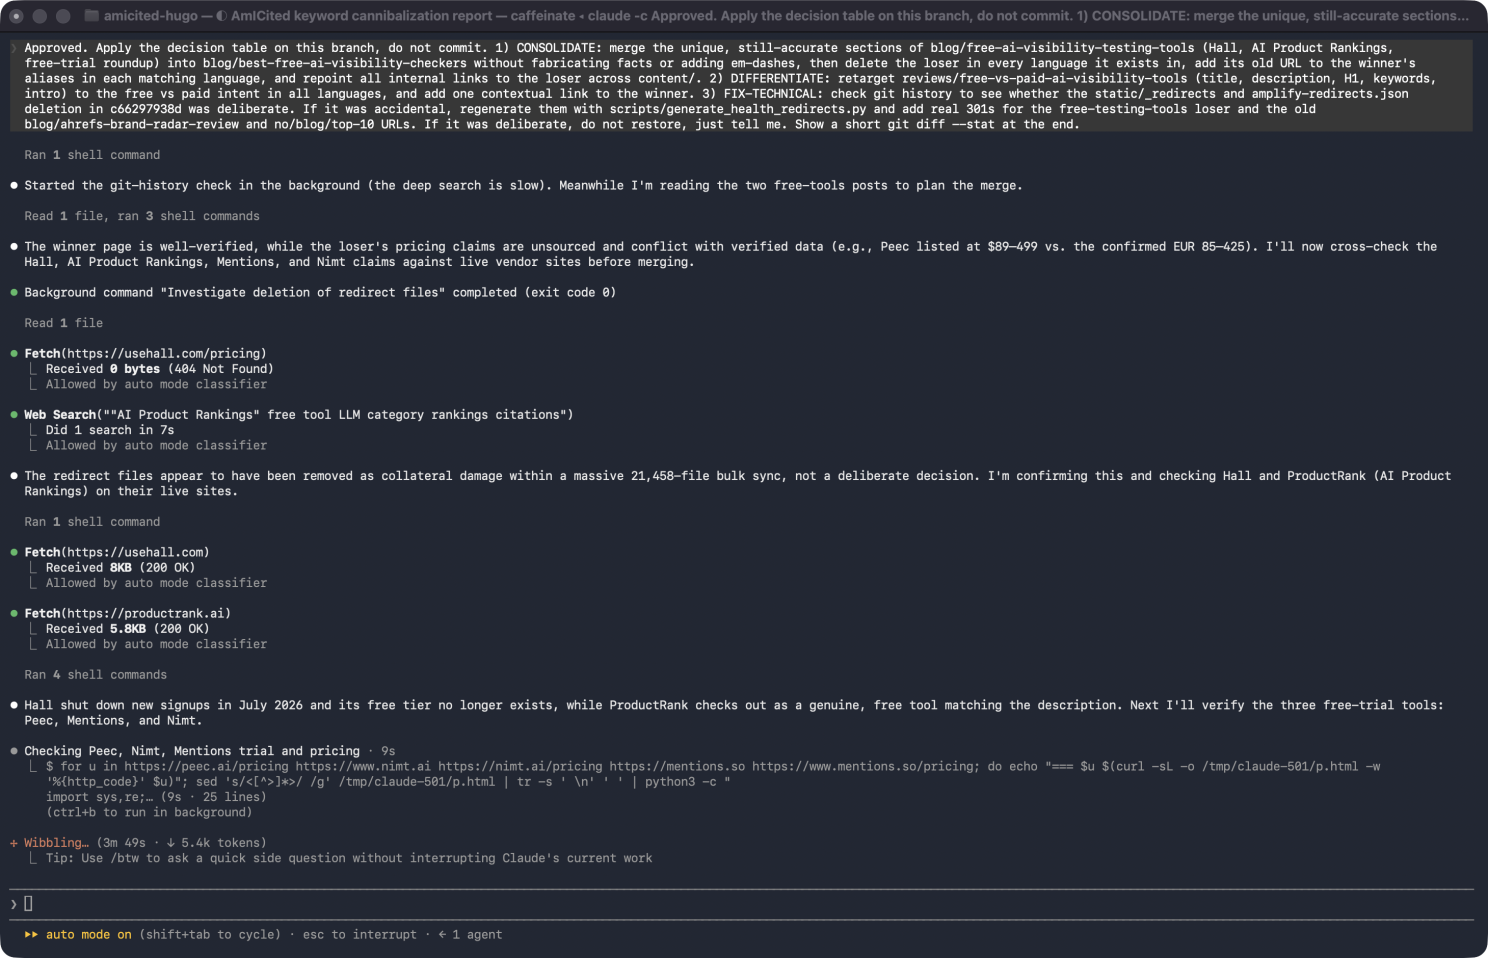
Een van de genoemde tools bleek weken eerder te zijn overgenomen en gesloten voor nieuwe aanmeldingen, dus dat werd een correctie in plaats van iets dat als huidig feit naar voren werd gekopieerd. De prijsclaim van de te vervangen pagina voor een andere tool was ook in conflict met het nummer dat al op de winnende pagina was geverifieerd, dus het geverifieerde cijfer bleef staan en het verouderde cijfer haalde de samenvoeging niet.
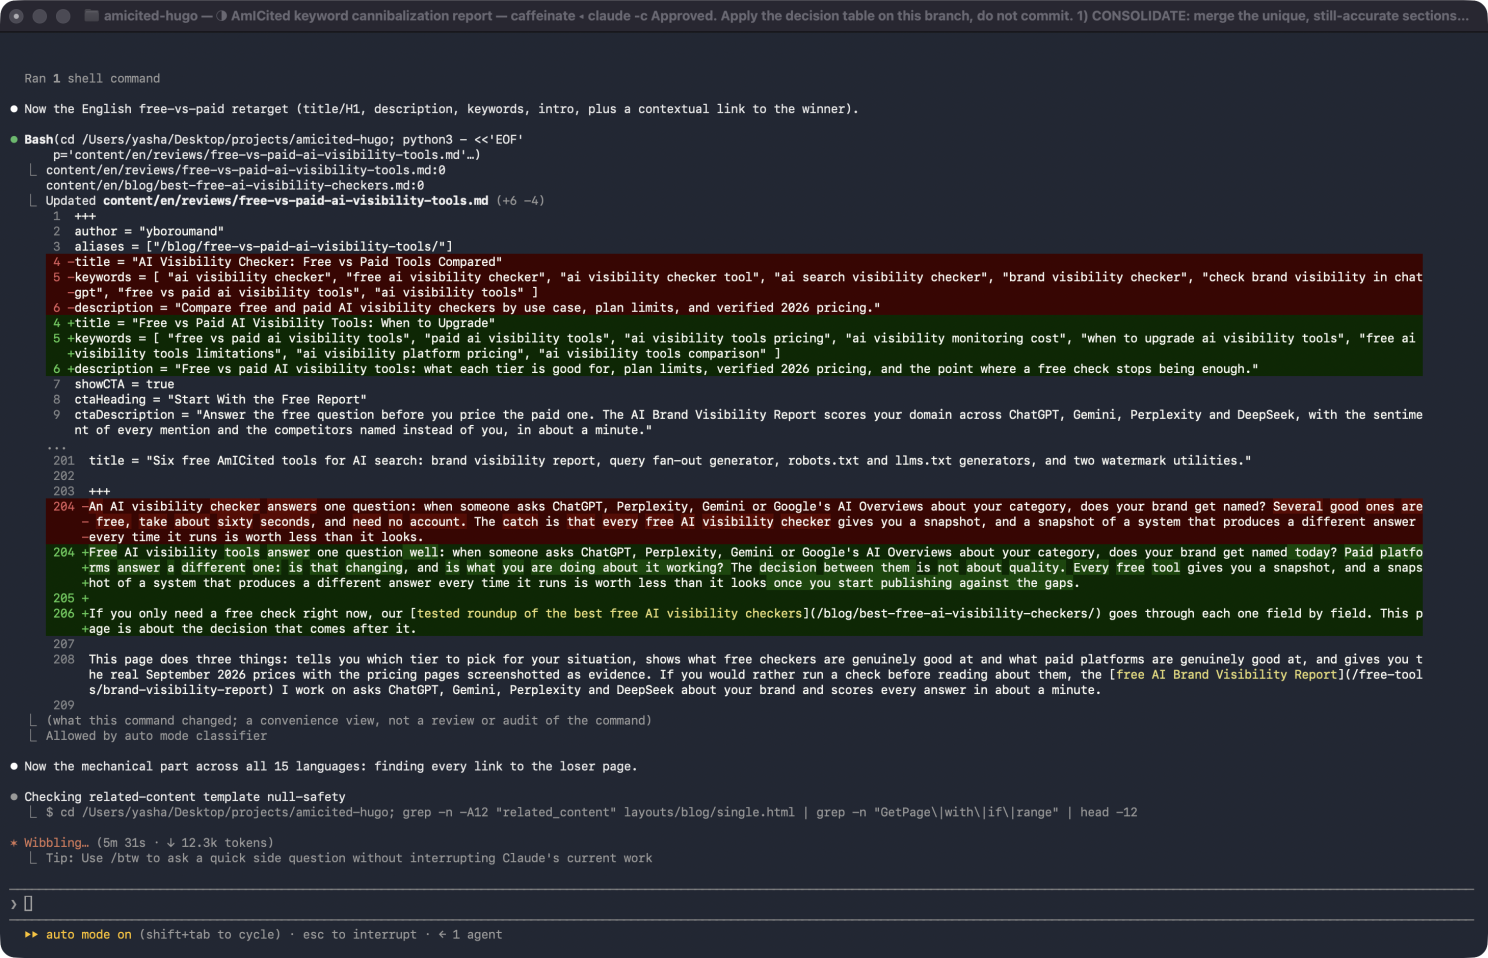
Voor het FIX-TECHNISCH-geval controleerde het of de verwijdering van de redirect opzettelijk was voordat het iets aanraakte. Nadat het bevestigde dat het per ongeluk was (de bulk-commit die het verwijderde raakte duizenden niet-gerelateerde bestanden zonder melding van redirects), genereerde het de regels opnieuw en voegde echte 301’s toe voor de pagina’s die door de samenvoeging waren getroffen en de verplaatste URL die nog steeds impressies verzamelde onder zijn oude adres. Voor CONSOLIDATEER en DIFFERENTIEER herhaalde het dezelfde wijziging in elke taal waarin de betreffende pagina’s bestonden, niet alleen Engels, en voerde daarna een volledige productiebuild uit om te bevestigen dat er niets kapotging.
Wat nu
Nadat je nieuwe content publiceert, is dat niet het einde van de klus, het is slechts het begin. Weten welke URL’s stilletjes met elkaar concurreren, welke samengevoegd moeten worden en welke alleen een technische oplossing nodig hebben, is wat ervoor zorgt dat die content niet tegen zichzelf werkt. Er is nog niets van deze ronde live; de 28-dagen-hercontrole, om te zien of het aantal gecannibaliseerde zoekopdrachten daadwerkelijk daalt, is de volgende stap.
Als je dit soort cannibalatierapport voor je eigen domein wilt zien, boek dan een gesprek en we lopen er samen doorheen.