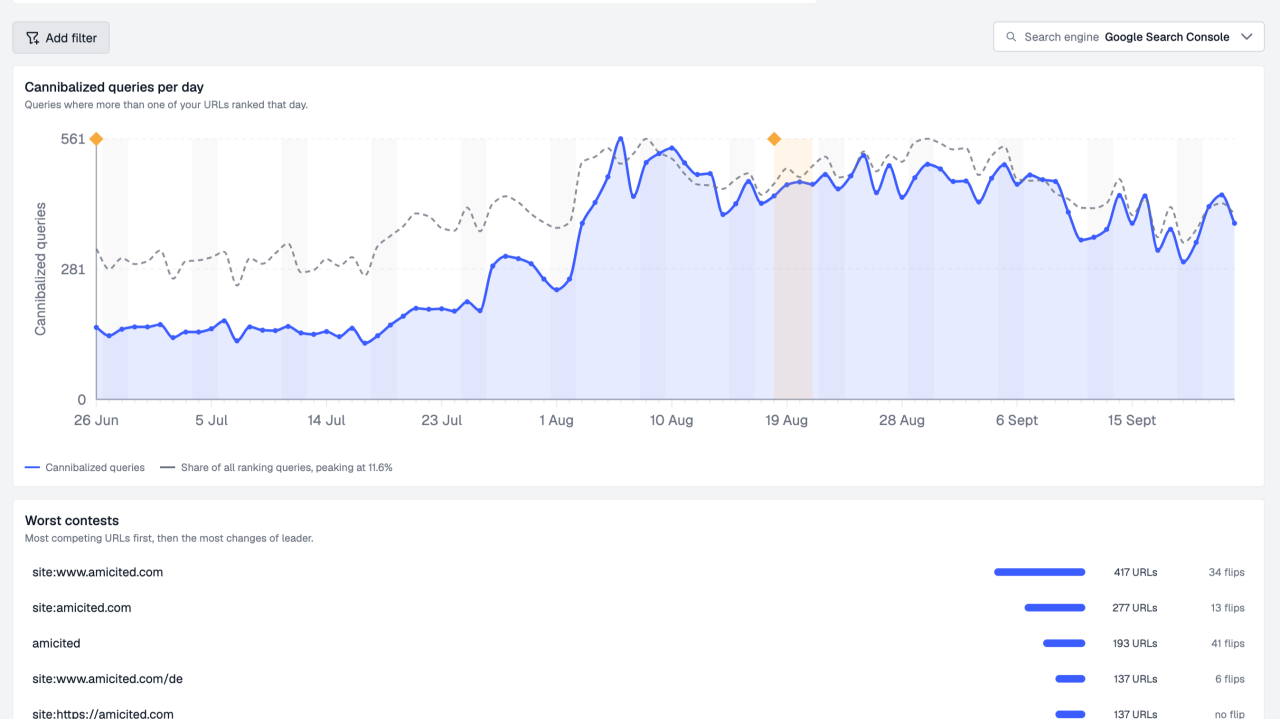
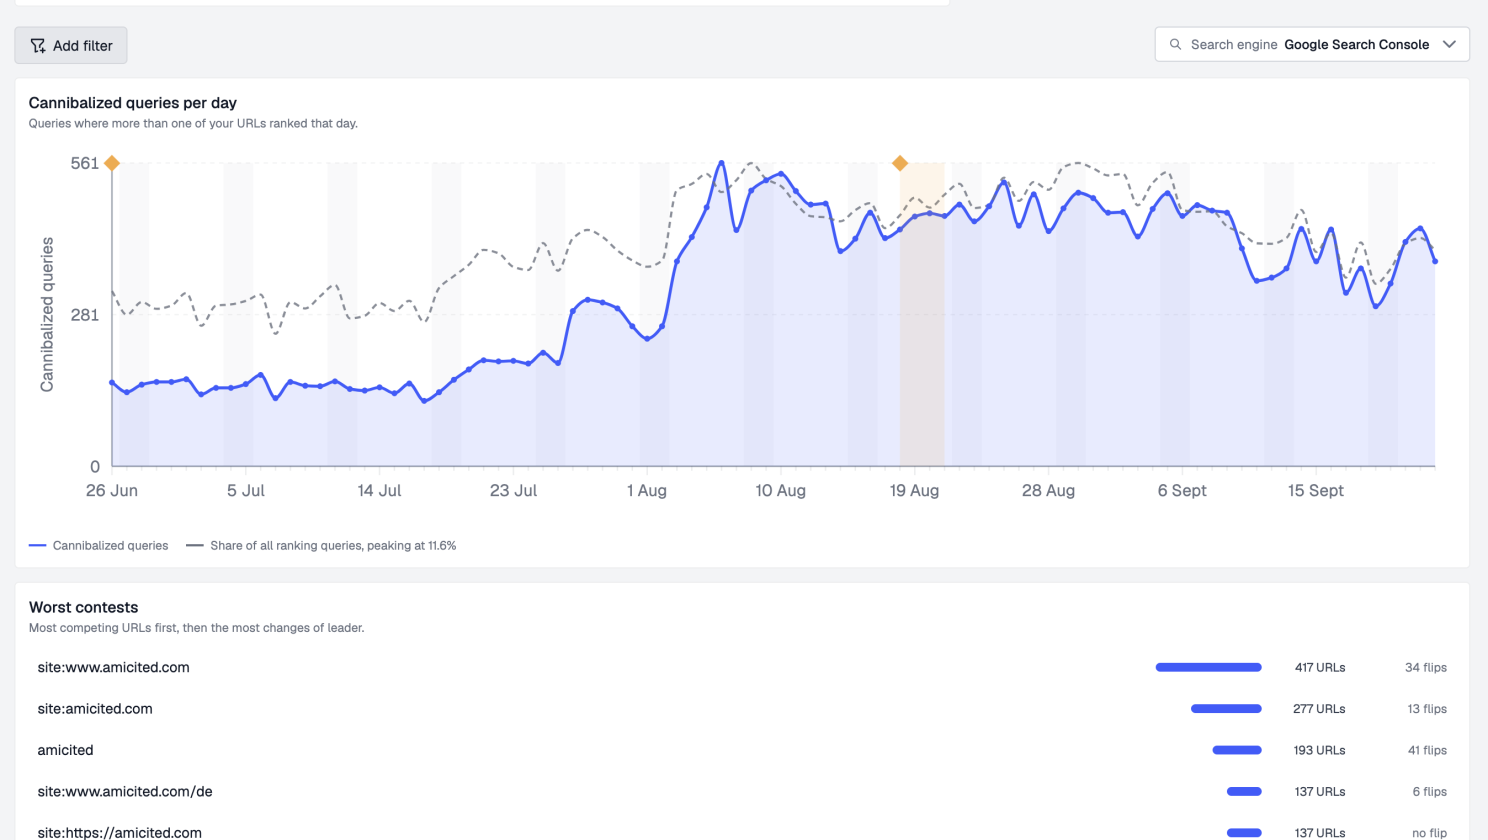
Ze 140 na 561 kanibalizovaných dotazů denně
Mezi koncem června a polovinou srpna vzrostl počet dotazů, kde se ve stejný den umístily dvě nebo více URL domény amicited.com, z přibližně 140 denně na vrchol 561. V nejhorším období tvořily kanibalizované dotazy 11,6 % všeho, na co se web umisťoval.
Nasměroval jsem tedy Claude Code na Hugo repozitář webu, připojil ho k AmICited SEO MCP serveru a požádal ho, aby našel keyword cannibalization, rozhodl, co s každým případem dělat, a aplikoval opravu napříč všemi 16 jazyky, ve kterých web vychází.
Toto je kompletní metodika: promptů, které jsem použil, co agent skutečně volal a dělal, a tři věci, které objevil, na které jsem se nikdy neptal. Nic z toho zatím není nasazeno, takže to berte jako procházku procesem, nikoli jako příspěvek o výsledcích. 28denní překontrolování přijde později.
Keyword cannibalization je situace, kdy dvě nebo více stránek na stejném webu soutěží o stejný vyhledávací dotaz, takže Google neustále přepíná, kterou zobrazí, a ani jedna se neumisťuje tak dobře, jako by se umisťovala jediná silná stránka. Je to interní konkurence mezi vašimi vlastními URL a je to jeden z SEO úkolů, kde Claude Code ukazuje svou hodnotu: data žijí v Search Console, oprava žije v repozitáři a agent může držet obojí najednou. (Nezaměňujte to s AI content cannibalization, kde odpověď generovaná umělou inteligencí přebere kliknutí, které by vaše stránka jinak získala.) Pokud chcete úplný rozbor, samostatně jsme sepsali, jak identifikovat a opravit problémy s keyword cannibalization.
Příprava
- Repozitář: repozitář mého Hugo webu, 500+ anglických blogových příspěvků, každý přeložený do 15 dalších jazyků.
- Data: AmICited MCP server, který zpřístupňuje SEO reporty založené na Google Search Console, včetně cannibalization, jako nástroje, které může Claude Code přímo volat.
- Agent: Claude Code (Opus 5.5) běžící v automatickém režimu na nové větvi
seo/cannibalization-oct-2026. Nic není commitováno, aniž bych si nejprve přečetl diff.
Připojení MCP serveru je jednorázový OAuth krok: spusťte /mcp, vyberte server, schvalte workspace v prohlížeči a Claude Code jej od té chvíle může volat.
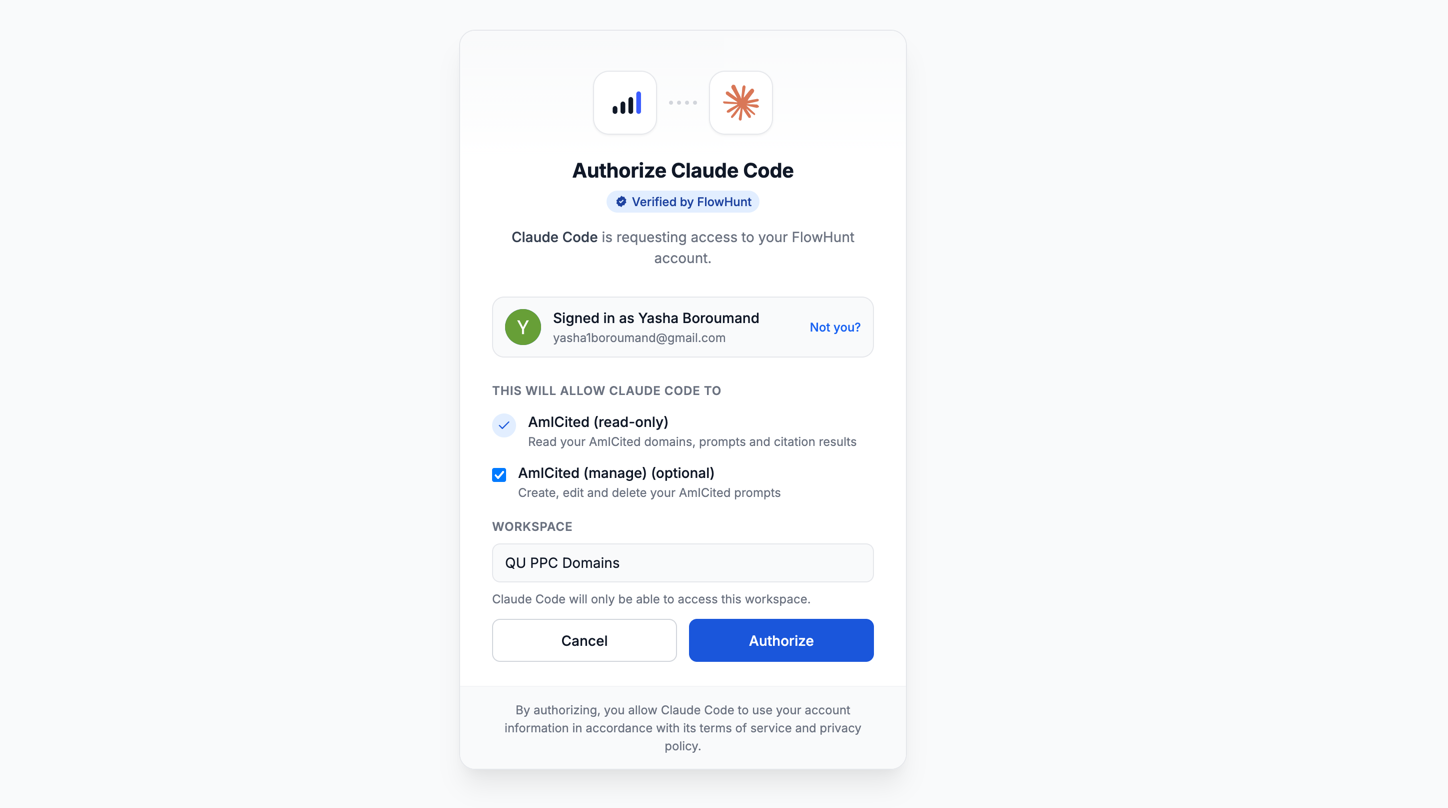
Jedna věc, kterou stojí za to vědět předem: můj AmICited workspace obsahuje několik domén. Každý prompt, který jsem napsal, explicitně jmenoval amicited.com, a první prompt požádal Claude Code, aby mi řekl, které ID domény vybral. Pokud tento krok přeskočíte, spoléháte na to, že agent uhodne správně.
Krok 1: Najděte kanibalizaci, odfiltrujte šum
Použijte AmICited MCP server k získání reportu keyword cannibalization pouze pro doménu amicited.com (workspace obsahuje několik domén, vyberte tu pro amicited.com a řekněte mi, které ID domény/projektu jste použili). Použijte data z Google Search Console za posledních 90 dní. Nejprve vyjmenujte MCP nástroje, které voláte. Vylučte šum: dotazy s vyhledávacími operátory (site:, inurl:), čistě brandové/navigační dotazy („amicited", „am i cited") a dotazy s méně než 50 zobrazeními. Zobrazte top 15 skutečných cannibalization clusterů jako tabulku […] Neupravujte žádné soubory.
Filtr šumu existuje kvůli tomu, jak surový report skutečně vypadá. Seznam „Nejhorších soupeření" na mém dashboardu vedl site:www.amicited.com (417 URL), site:amicited.com (277 URL) a holý brandový dotaz amicited (193 URL). To není cannibalization. To jsem já, a pravděpodobně můj vlastní tým, kdo hledá web přímo. Jakýkoli nástroj, který to počítá jako cannibalization cluster, počítá špatnou věc.
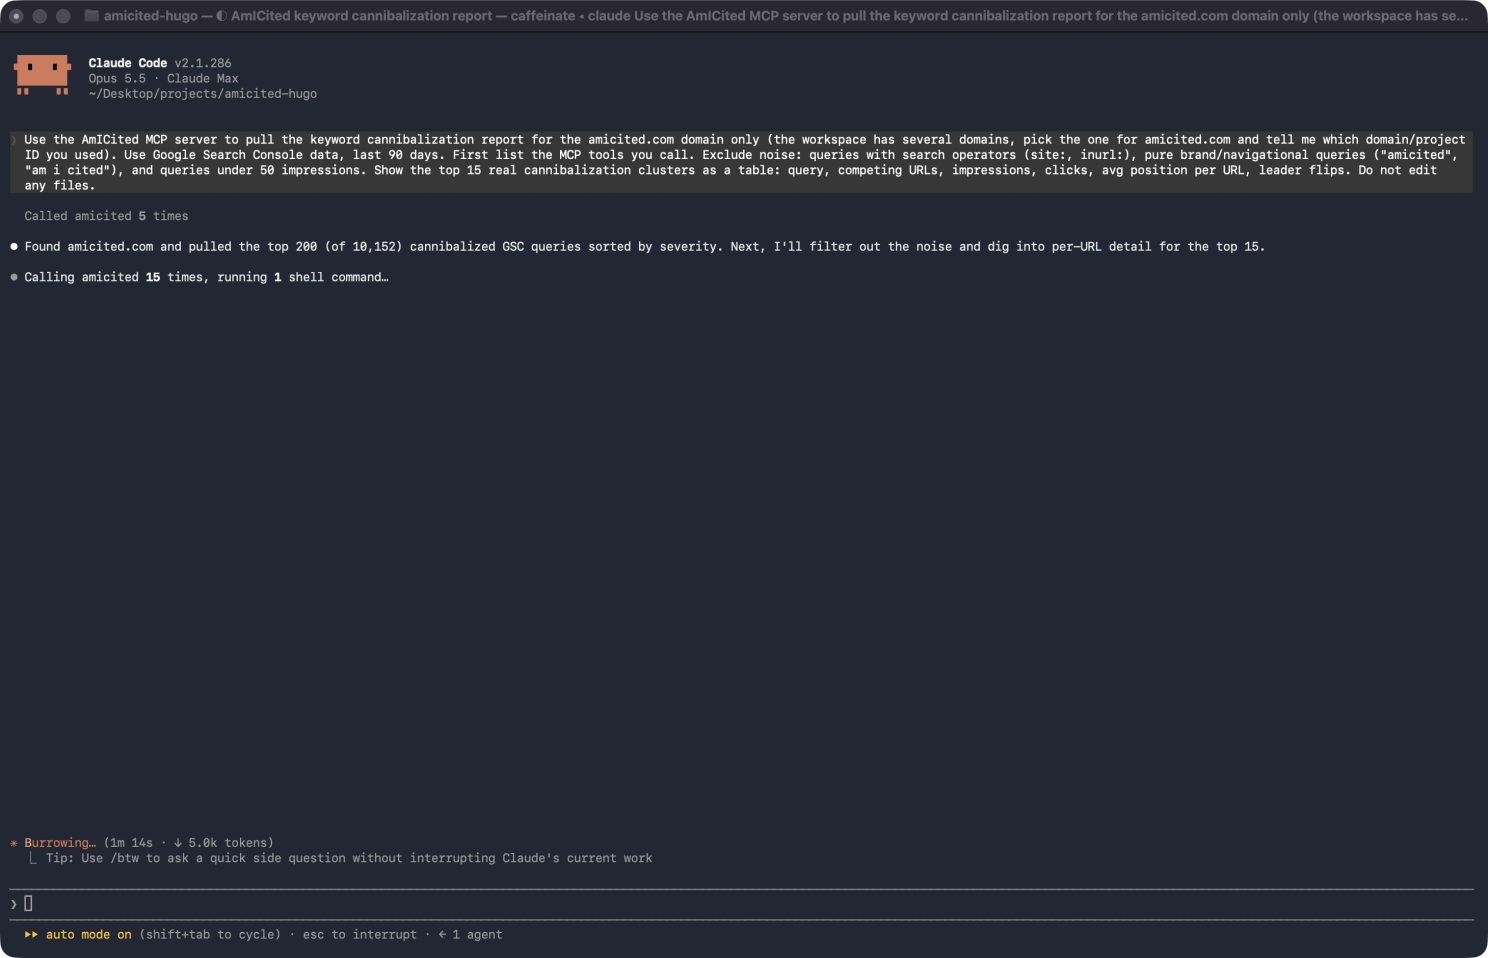
Co udělal, v pořadí:
list_domains, aby našel amicited.com mezi doménami ve workspace (a nahlásil zpět ID domény, které použil).search_tools, protože nástroje pro cannibalization nebyly v jeho výchozím seznamu nástrojů, takže je vyhledal podle popisu.describe_tool, dvakrát, aby si přečetl vstupní schémata pro dva nástroje pro dotazy cannibalization, než je zavolal.- Nástroj pro seznam clusterů, jednou: top 200 dotazů podle závažnosti z více než 10 000 kanibalizovaných dotazů v 90denním okně.
- Nástroj pro podrobnosti o jednotlivém dotazu, 15krát, jednou pro každý cluster, stahující soutěžící URL a jejich denní pozice. Jedna odpověď byla příliš velká na inline zobrazení, takže výstup uložil na disk a shrnul jej pomocí
jq.
Poté filtroval. Asi 30 z top 200 byly site: dotazy. Z vlastní iniciativy přidal dva další filtry a řekl mi, že to udělal: dlouhé dotazy ve tvaru promptů s tisíci zobrazeními a nulovými kliknutími (vypadaly jako promptové nástroje pro AI tracking zkopírované doslovně, nikoli skuteční lidé hledající) a hrstku kódu připomínajících dotazů, které vypadaly jako botí návštěvnost.
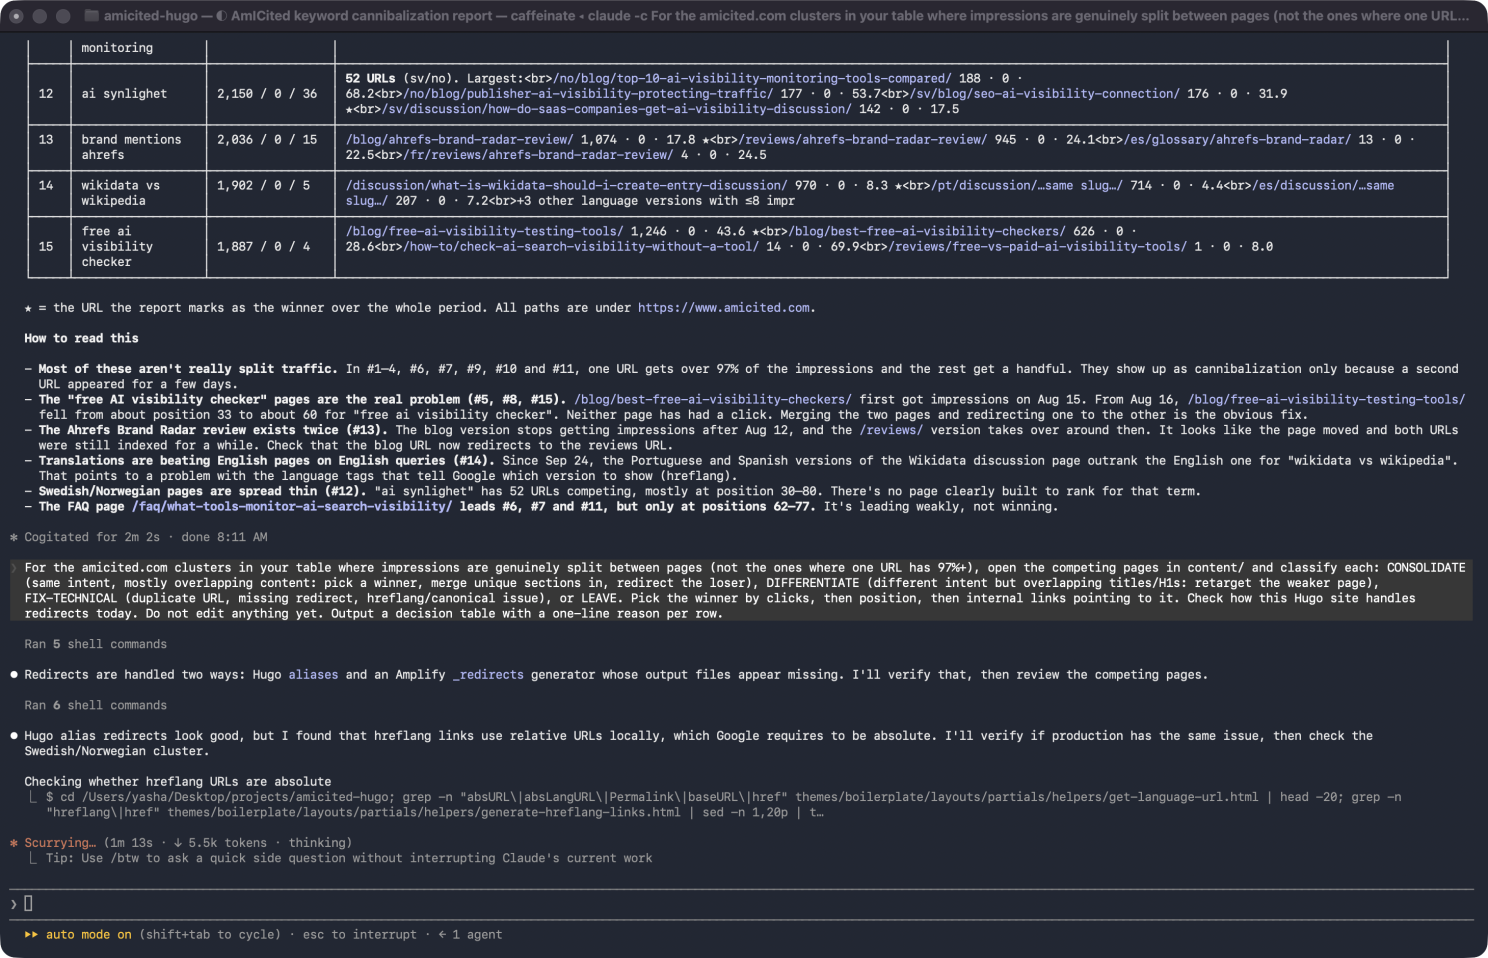
Nejužitečnější řádek ve výstupu nebyla samotná tabulka. Byl to tento:
Většina z nich není skutečně rozdělená návštěvnost. V devíti z patnácti nejlepších clusterů má jedna URL přes 97 % zobrazení a zbytek jich má jen hrstku.
Devět z patnácti nejlepších „cannibalization" clusterů byla jedna stránka odvádějící v podstatě veškerou práci, s druhou URL, která se objevila na pár dní a nic víc. Report seřazený čistě podle závažnosti vám to neřekne. Čtení rozdělení podle URL ano.
Krok 2: Nejdřív diagnóza, pak oprava
Pro clustery ve vaší tabulce, kde jsou zobrazení skutečně rozdělena mezi stránky (ne ty, kde má jedna URL 97+ %), otevřete soutěžící stránky v content/ a každou klasifikujte: CONSOLIDATE, DIFFERENTIATE, FIX-TECHNICAL nebo LEAVE. Vítěze vyberte podle kliknutí, pak pozice, pak interních odkazů na něj. Zkontrolujte, jak tento Hugo web v současnosti řeší přesměrování. Zatím nic neupravujte. Výstupem bude rozhodovací tabulka s jednořádkovým odůvodněním pro každý řádek.
Tento krok neprovedl žádná MCP volání. Šlo o zhruba 20 shellových příkazů: čtení soutěžících Markdown souborů, počítání interních odkazů na každou stránku, čtení šablon motivu a spuštění curl proti živému webu, aby viděl, co přesměrování a hreflang tagy skutečně vrací v produkci, nejen v repozitáři.
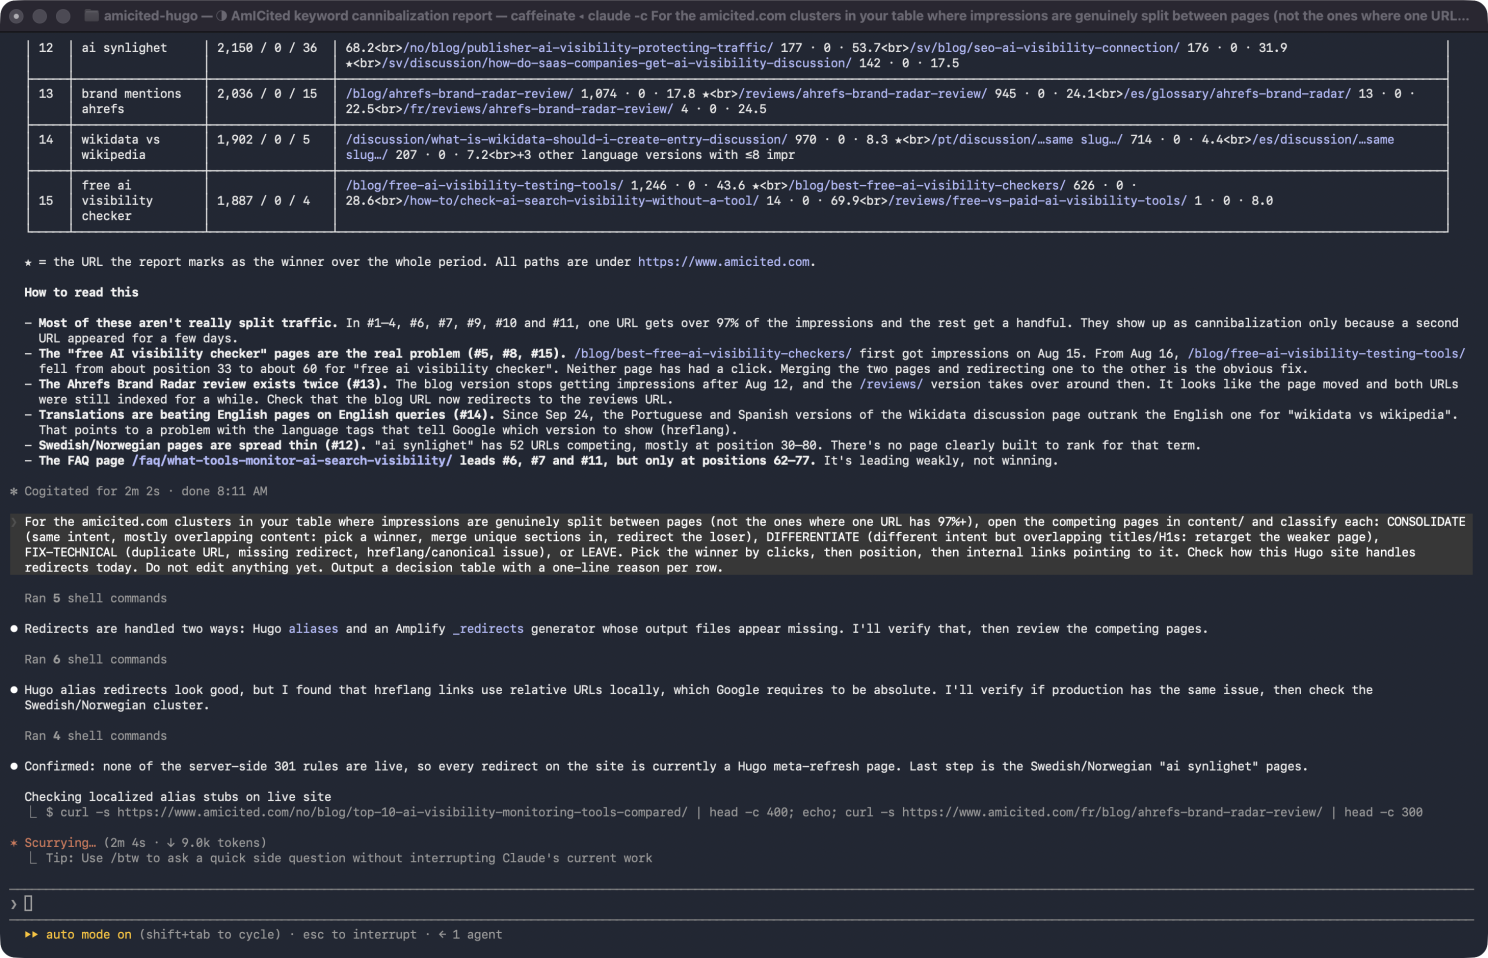
Z patnácti clusterů jeden potřeboval sloučení, jeden potřeboval přecijení, dva potřebovaly technickou opravu a zbytek nepotřeboval nic. Tento poměr je hlavním důvodem, proč bych nikdy nenechal agenta přeskočit rovnou od „zde je report cannibalization" k „zde jsou stránky, které jsem smazal".
Tři zjištění, o která jsem nežádal
1. Moje 301 přesměrování potichu přestala fungovat o dva měsíce dříve. Můj web má skript, který generuje skutečná 301 pravidla pro Amplify. Claude Code si všiml, že výstupní soubor neexistuje, prošel zpětně git historií a zjistil, že byl smazán o pět týdnů dříve uvnitř commitu „update content", který zasáhl přes 21 000 souborů – vedlejší škoda z hromadné synchronizace, nikoli rozhodnutí, které by někdo udělal schválně. Na živém webu potvrdil, že žádná z pravidel není aktivní (přesunutá URL vracela 404 tam, kde mělo být přesměrování). Od té doby bylo každé „přesměrování" na webu ve skutečnosti Hugo alias: stránka se stavovým kódem 200 s meta refreshem, nikoli skutečná 301.
2. To nebylo jen teoretické. Stará URL stránky, kterou jsem přesunul v červenci, se stále objevovala samostatně v Search Console – 188 zobrazení a stoupá, dva a půl měsíce po přesunu. Meta-refresh stub, který Google stejně nadále indexuje, je přesně to, jak vypadá rozbitá alias konfigurace v praxi.
3. Opravil vlastní chybu. V kroku 1 označil jednu dvojici stránek jako pravděpodobný problém s hreflang, protože přeložená verze překonávala anglický originál. V kroku 2 načetl živé HTML, zkontroloval, že hreflang tagy jsou absolutní a reciproční, jak Google vyžaduje, a nahlásil, že tím opravil to, co řekl poprvé. Zjištění se přesunulo z FIX na LEAVE. To je mnohem lepší, než dostat sebevědomou špatnou odpověď, která zůstane v reportu nevyvrácena.

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Krok 3: Oprava v 16 jazycích
Schváleno. Aplikujte rozhodovací tabulku na této větvi, necommitujte. 1) CONSOLIDATE […] aniž byste si vymýšleli fakta nebo přidávali em pomlčky, pak smažte poraženou stránku ve všech jazycích, ve kterých existuje, přidejte její starou URL do aliasů vítěze v každém odpovídajícím jazyce a přenastavte všechny interní odkazy na poraženou stránku napříč content/. 2) DIFFERENTIATE […] ve všech jazycích a přidejte jeden kontextový odkaz na vítěze. 3) FIX-TECHNICAL: zkontrolujte git historii, zda bylo smazání static/_redirects záměrné. Pokud bylo náhodné, regenerujte je […] Pokud bylo záměrné, neobnovujte, jen mi to řekněte.
Před sloučením čehokoli ověřoval fakta. Stránka, která byla vyřazována, obsahovala sekce, které vítězná stránka neměla: zmínku o konkurenčním nástroji, funkci hodnocení produktů a přehled bezplatných zkušebních verzí. Než cokoli přenesl, Claude Code načetl živé weby dodavatelů, aby ověřil, že informace jsou stále platné.
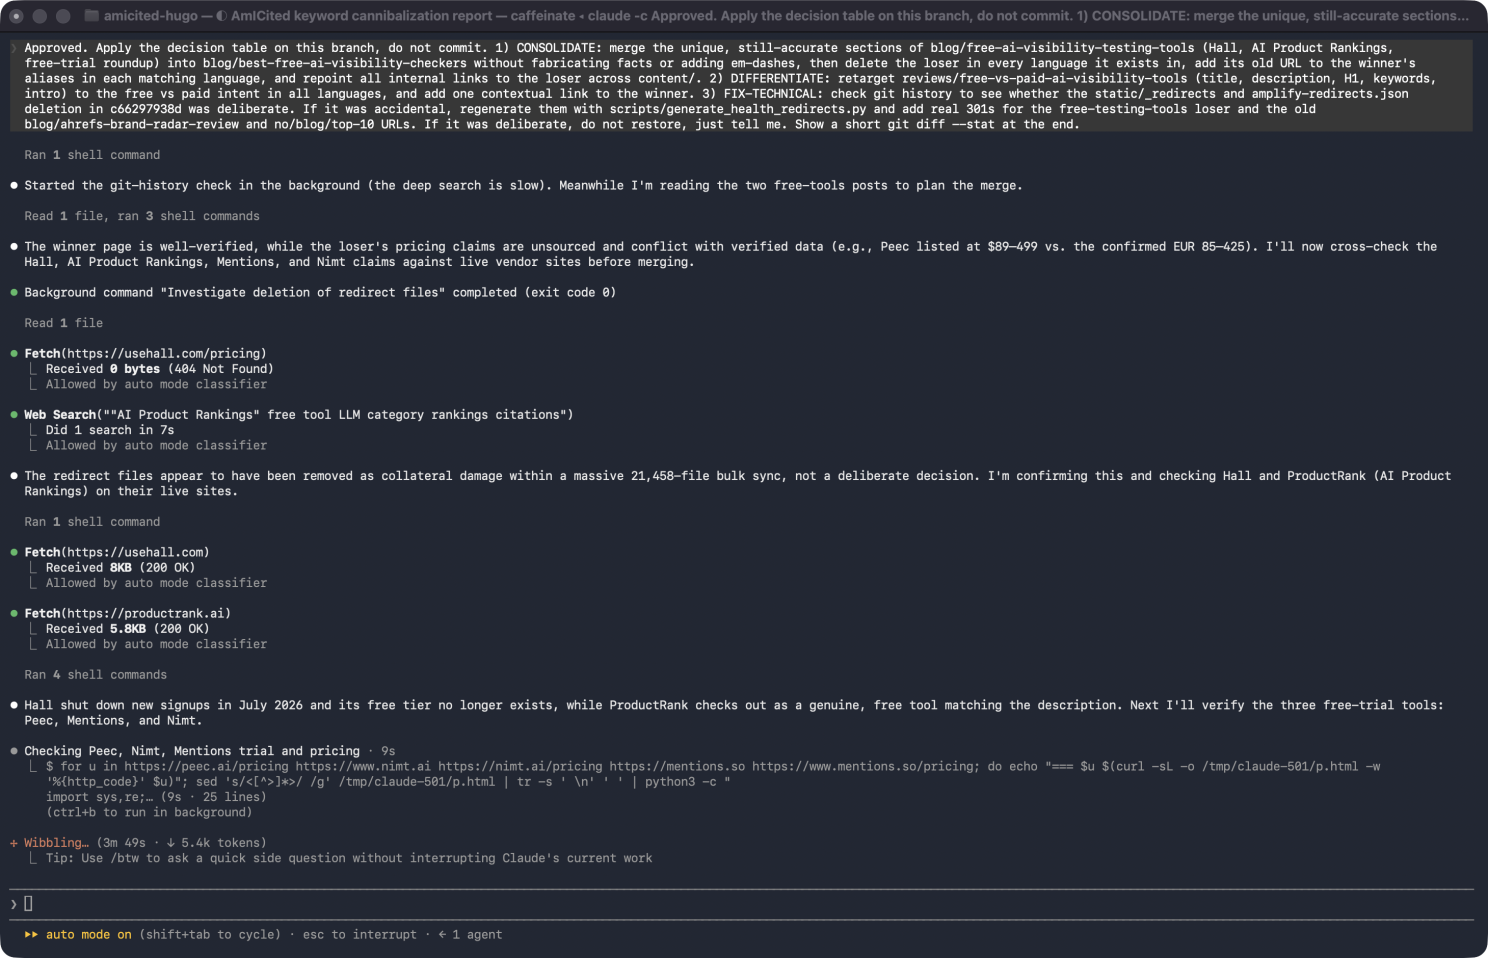
Jeden z uvedených nástrojů byl ve skutečnosti před týdny akvírován a uzavřen pro nové registrace, takže se z toho stala oprava místo něčeho zkopírovaného jako aktuální fakt. Cenové tvrzení na odcházející stránce o jiném nástroji bylo také v rozporu s již ověřeným číslem na vítězné stránce, takže ověřená hodnota zůstala a zastaralá se do sloučení nedostala.
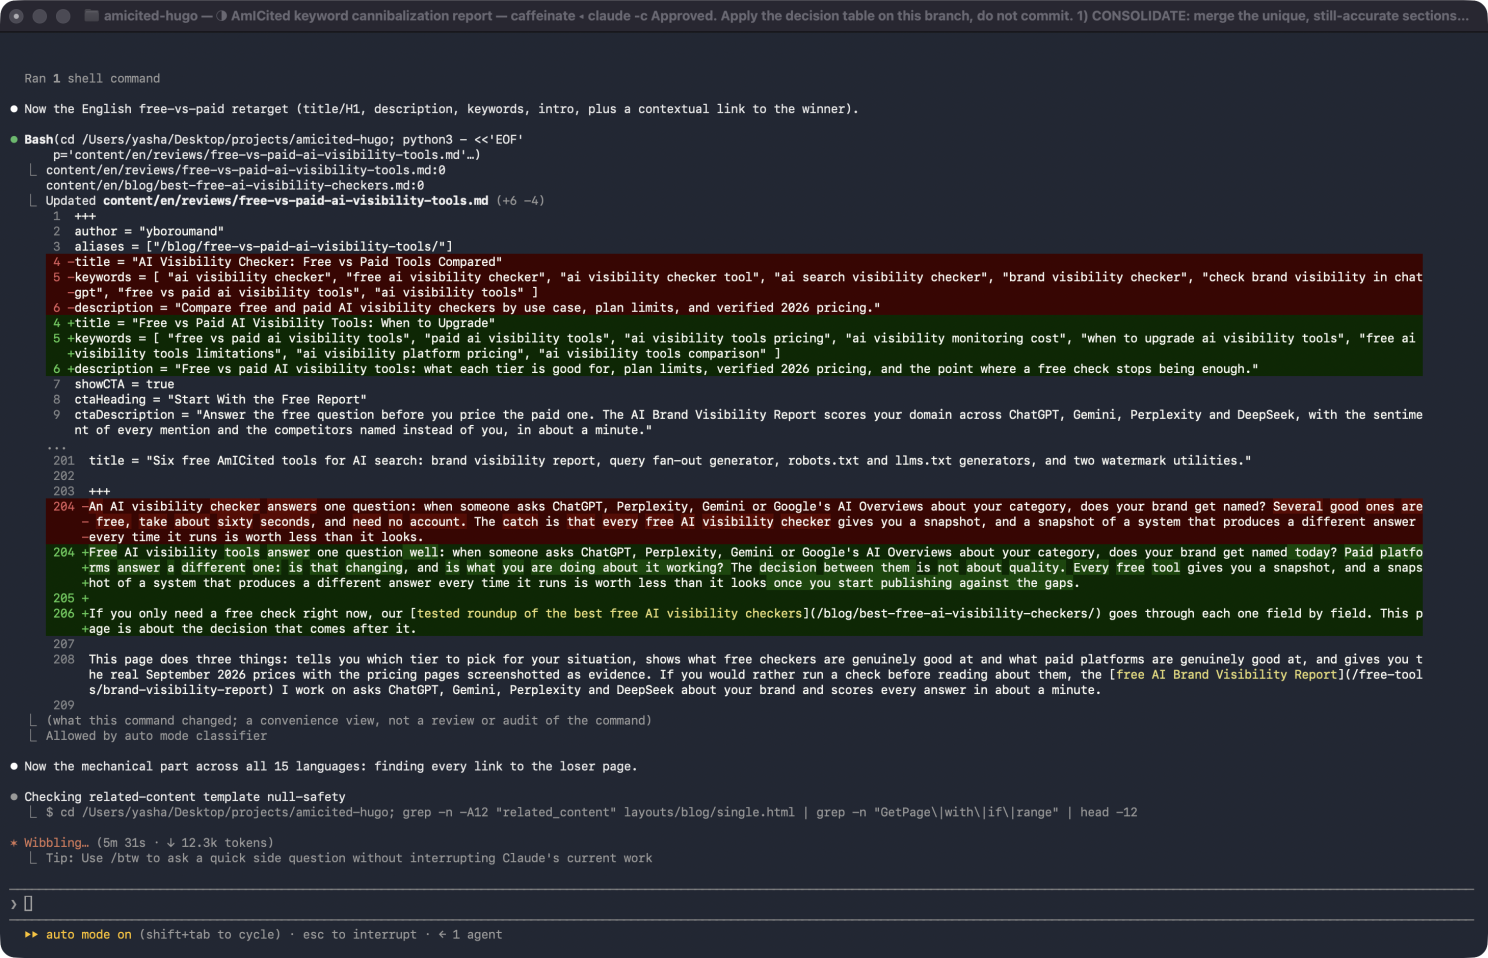
Pro případ FIX-TECHNICAL nejprve zkontroloval, zda bylo smazání přesměrování záměrné, než se čehokoli dotkl. Po potvrzení, že bylo náhodné (hromadný commit, který ho odstranil, zasáhl tisíce nesouvisejících souborů bez zmínky o přesměrováních), regeneroval pravidla a přidal skutečné 301 přesměrování pro stránky zasažené sloučením a pro přesunutou URL, která stále sbírala zobrazení pod svou starou adresou. Pro CONSOLIDATE a DIFFERENTIATE provedl stejnou změnu napříč všemi jazyky, ve kterých dotčené stránky existovaly, nejen v angličtině, a poté spustil plný produkční build, aby potvrdil, že se nic nerozbilo.
Co dál
Poté, co publikujete nový obsah, to není konec práce, je to teprve začátek. Vědět přesně, které URL spolu tiše soutěží, které je třeba sloučit a které potřebují jen technickou opravu, je to, co udržuje váš obsah v tom, aby nepracoval proti sobě. Nic z tohoto průchodu zatím není živé; 28denní překontrolování, zda se počet kanibalizovaných dotazů skutečně sníží, je na řadě.
Pokud chcete vidět takovýto report cannibalization pro svou vlastní doménu, rezervujte si hovor a projdeme si ho.