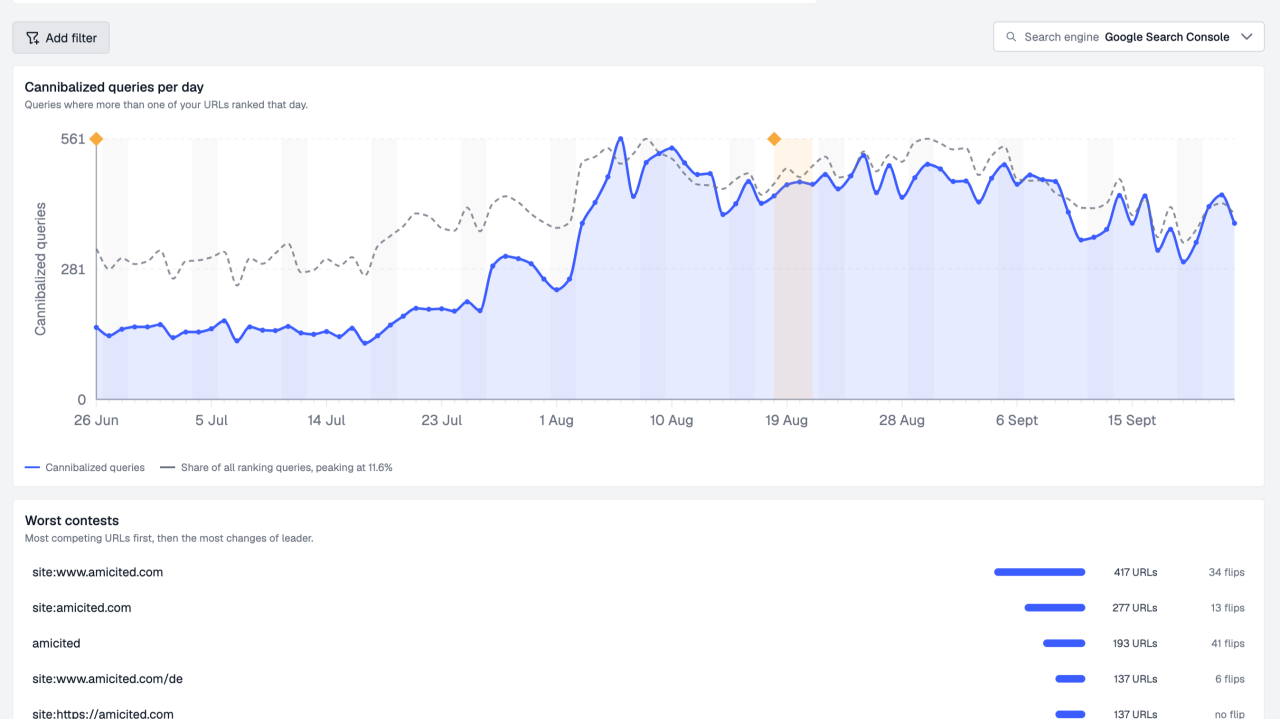
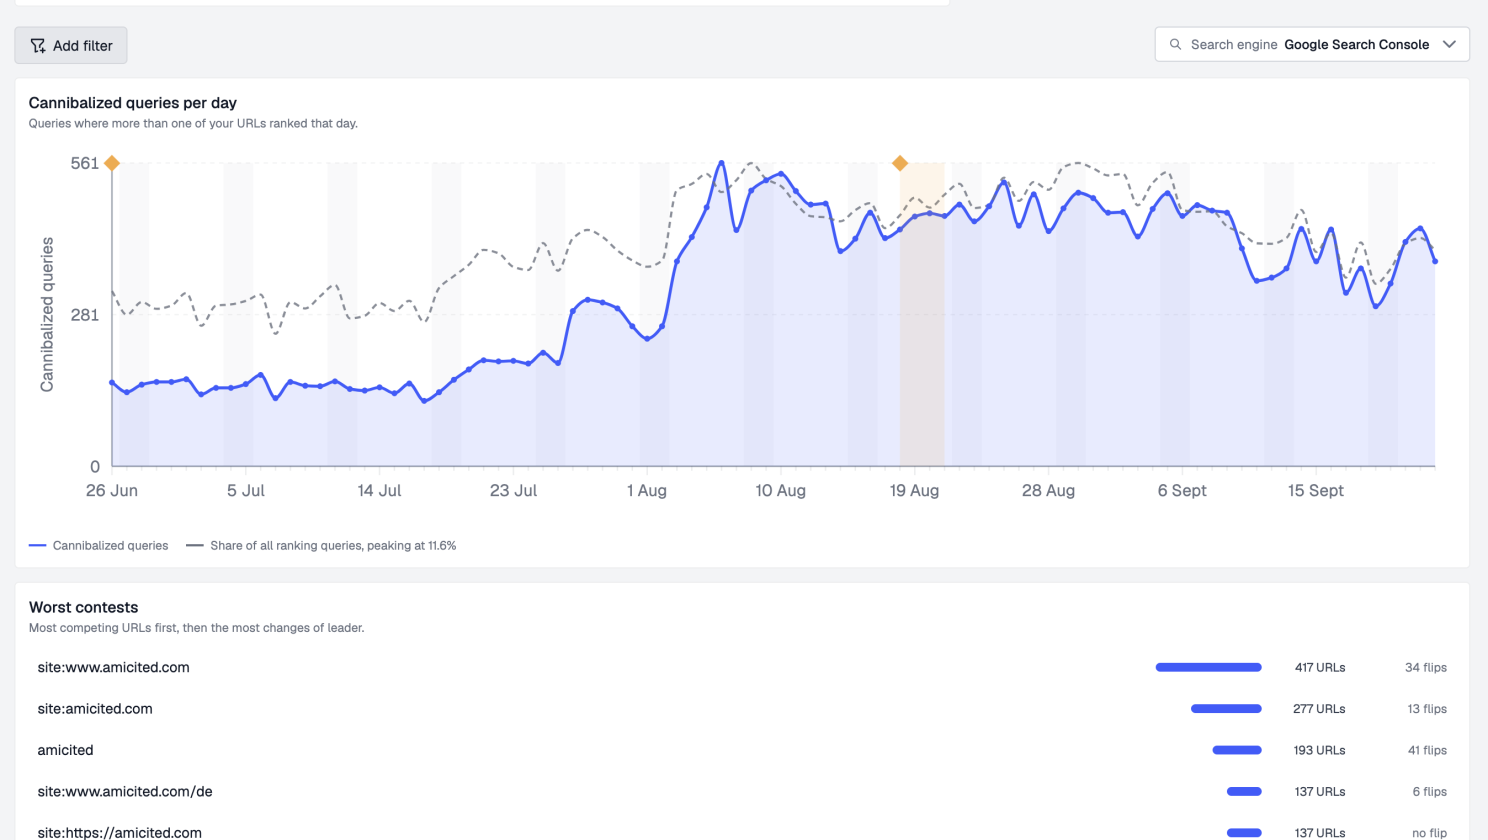
De 140 a 561 Consultas Canibalizadas al Día
Entre finales de junio y mediados de agosto, la cantidad de consultas donde dos o más URLs de amicited.com aparecían el mismo día subió de unas 140 diarias a un pico de 561. En su peor momento, las consultas canibalizadas representaban el 11.6 % de todo aquello para lo que el sitio aparecía en los resultados de búsqueda.
Así que apunté Claude Code al repositorio Hugo del sitio, lo conecté al servidor MCP de AmICited SEO, y le pedí que encontrara la canibalización de palabras clave, decidiera qué hacer con cada caso y aplicara la corrección en los 16 idiomas en los que el sitio está disponible.
Este es el método de principio a fin: las instrucciones que usé, lo que el agente realmente llamó e hizo, y las tres cosas que encontró que nunca pregunté. Nada de esto está desplegado aún, así que considera esto un recorrido por el proceso, no un artículo de resultados. La verificación a los 28 días vendrá después.
La canibalización de palabras clave ocurre cuando dos o más páginas del mismo sitio compiten por la misma consulta de búsqueda, por lo que Google cambia constantemente cuál mostrar y ninguna aparece tan bien como lo haría una sola página sólida. Es competencia interna entre tus propias URLs, y es uno de los trabajos de SEO donde Claude Code demuestra su valor: los datos están en Search Console, la corrección está en el repositorio, y un agente puede manejar ambos a la vez. (No lo confundas con la canibalización de contenido por IA, donde una respuesta generada por IA se lleva el clic que tu página habría ganado). Si quieres el análisis completo, hemos escrito por separado sobre cómo identificar y corregir problemas de canibalización de palabras clave.
La Configuración
- Repositorio: el repositorio de mi sitio Hugo, más de 500 artículos en inglés, cada uno traducido a otros 15 idiomas.
- Datos: el servidor MCP de AmICited, que expone informes SEO basados en Google Search Console, incluyendo canibalización, como herramientas que Claude Code puede llamar directamente.
- Agente: Claude Code (Opus 5.5) ejecutándose en modo automático, en una rama nueva,
seo/cannibalization-oct-2026. Nada se confirma sin que yo lea el diff primero.
Conectar el servidor MCP es un paso único de OAuth: ejecuta /mcp, selecciona el servidor, aprueba el espacio de trabajo en el navegador, y Claude Code puede llamarlo desde entonces.
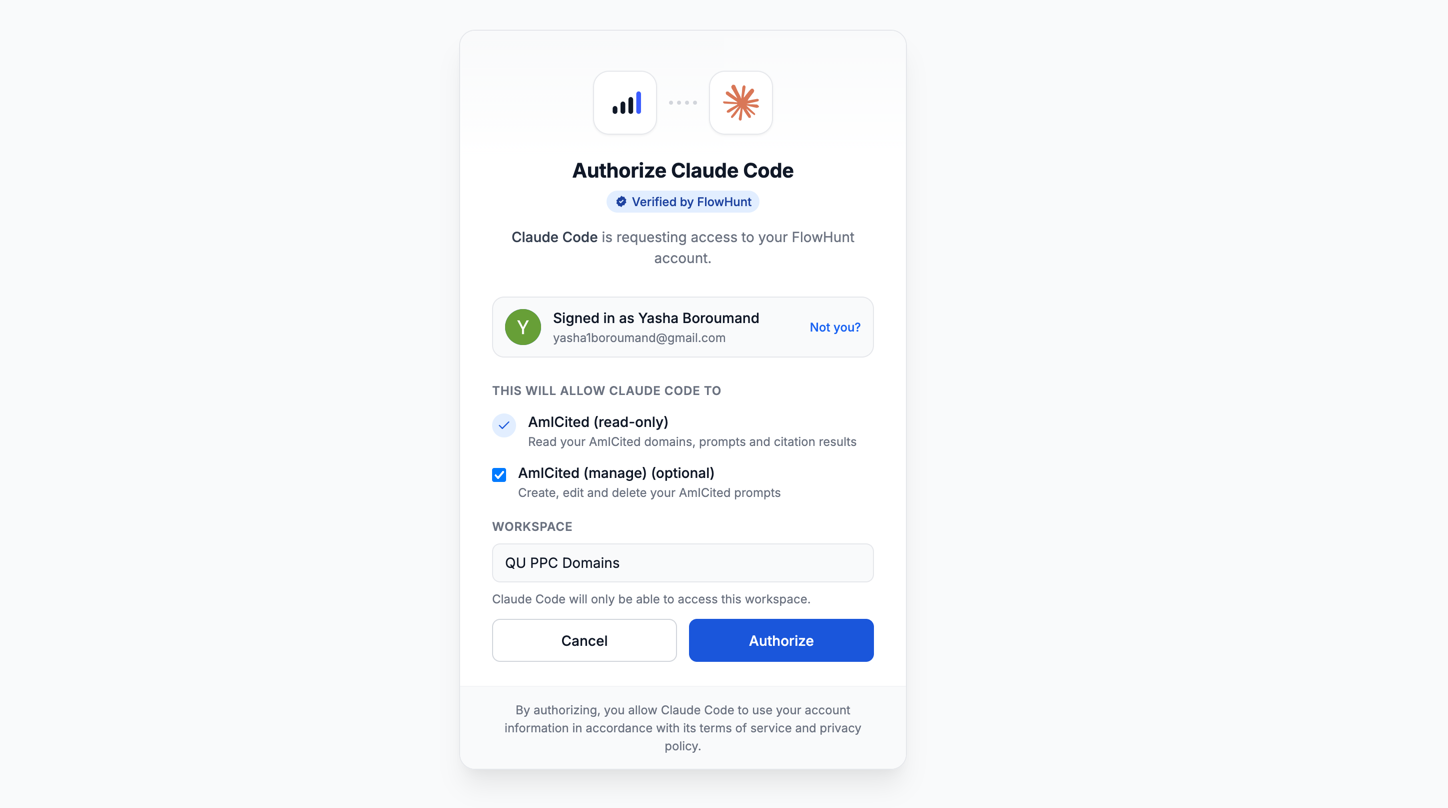
Algo que vale la pena saber de antemano: mi espacio de trabajo de AmICited tiene varios dominios. Cada instrucción que escribí nombraba amicited.com explícitamente, y la primera le pedía a Claude Code que me dijera qué ID de dominio había seleccionado. Si omites ese paso, confías en que el agente adivine correctamente.
Paso 1: Encontrar la Canibalización, Filtrar el Ruido
Usa el servidor MCP de AmICited para obtener el informe de canibalización de palabras clave solo para el dominio amicited.com (el espacio de trabajo tiene varios dominios, selecciona el de amicited.com y dime qué ID de dominio/proyecto usaste). Usa datos de Google Search Console, últimos 90 días. Primero enumera las herramientas MCP que llamas. Excluye ruido: consultas con operadores de búsqueda (site:, inurl:), consultas de marca/navegación puras (“amicited”, “am i cited”) y consultas con menos de 50 impresiones. Muestra los 15 grupos de canibalización real más importantes como una tabla […] No edites ningún archivo.
El filtro de ruido existe por cómo se ve realmente el informe en bruto. La lista de “Peores enfrentamientos” en mi panel estaba encabezada por site:www.amicited.com (417 URLs), site:amicited.com (277 URLs) y la consulta de marca simple amicited (193 URLs). Eso no es canibalización. Eso soy yo, y probablemente mi propio equipo, buscando el sitio directamente. Cualquier herramienta que cuente eso como un grupo de canibalización está contando lo incorrecto.
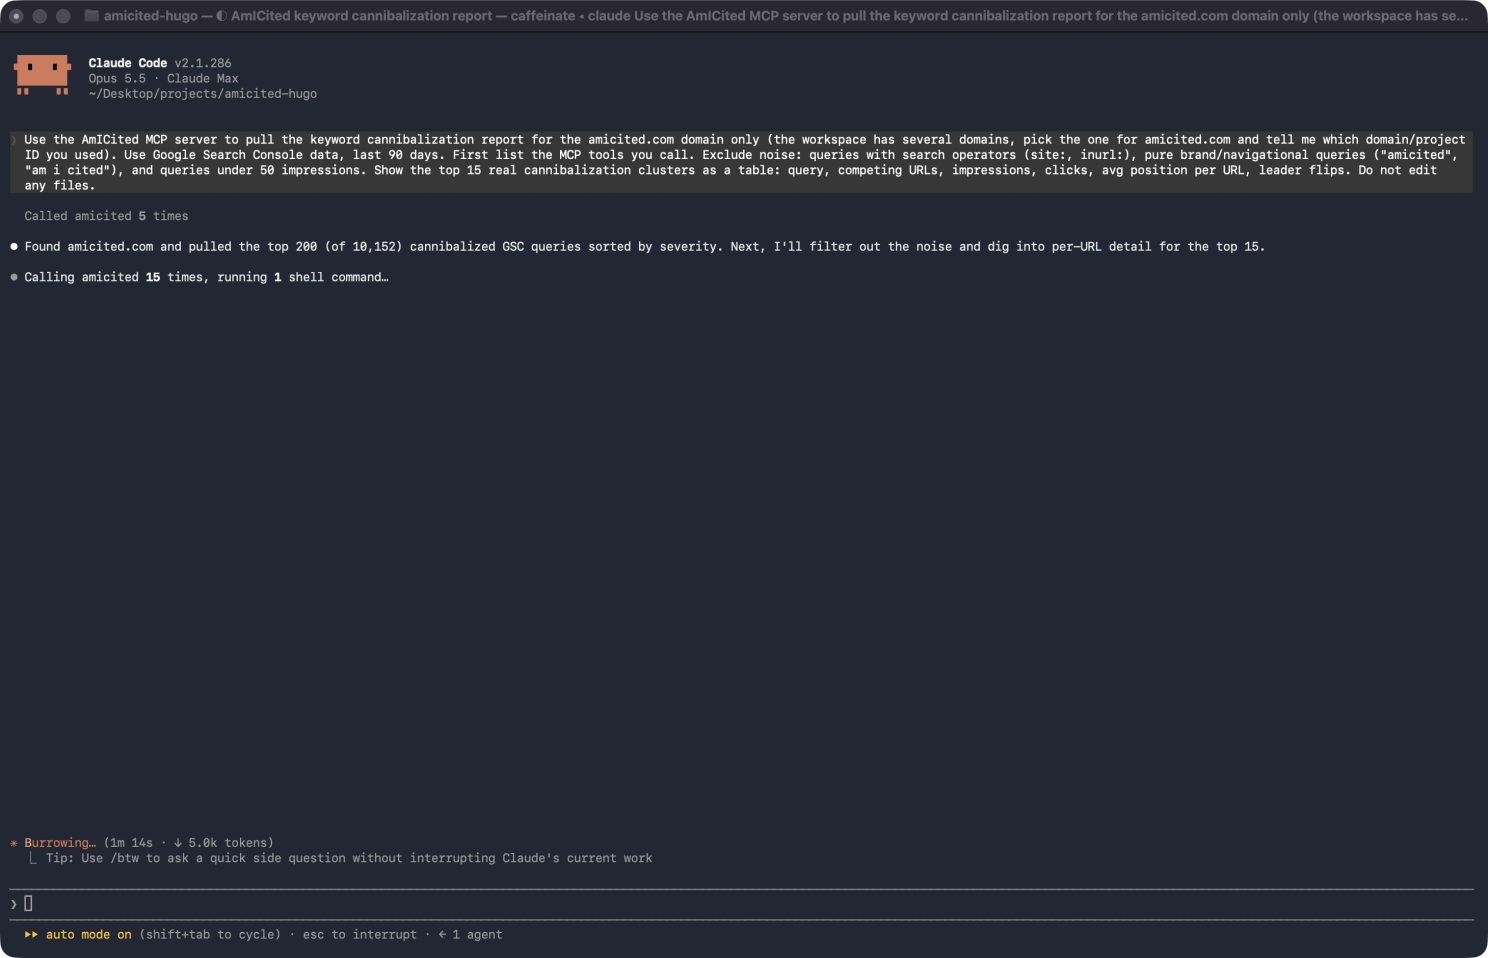
Lo que hizo, en orden:
list_domains, para encontrar amicited.com entre los dominios del espacio de trabajo (y reportar el ID de dominio que usó).search_tools, porque las herramientas de canibalización no estaban en su lista de herramientas predeterminada, así que las buscó por descripción.describe_tool, dos veces, para leer los esquemas de entrada de las dos herramientas de consulta de canibalización antes de llamarlas.- La herramienta de lista de grupos, una vez: las 200 consultas principales por severidad, de más de 10 000 consultas canibalizadas en la ventana de 90 días.
- La herramienta de detalle por consulta, 15 veces, una por grupo, obteniendo las URLs competidoras y sus posiciones diarias. Una respuesta era demasiado grande para mostrarla en línea, así que guardó la salida en disco y la resumió con
jq.
Luego filtró. Aproximadamente 30 de las 200 principales eran consultas site:. Por iniciativa propia, añadió dos filtros más y me dijo que lo había hecho: consultas largas con forma de instrucciones con miles de impresiones y cero clics (parecen instrucciones de herramientas de seguimiento de IA copiadas textualmente, no personas reales buscando), y un puñado de consultas con aspecto de código que parecían tráfico de bots.
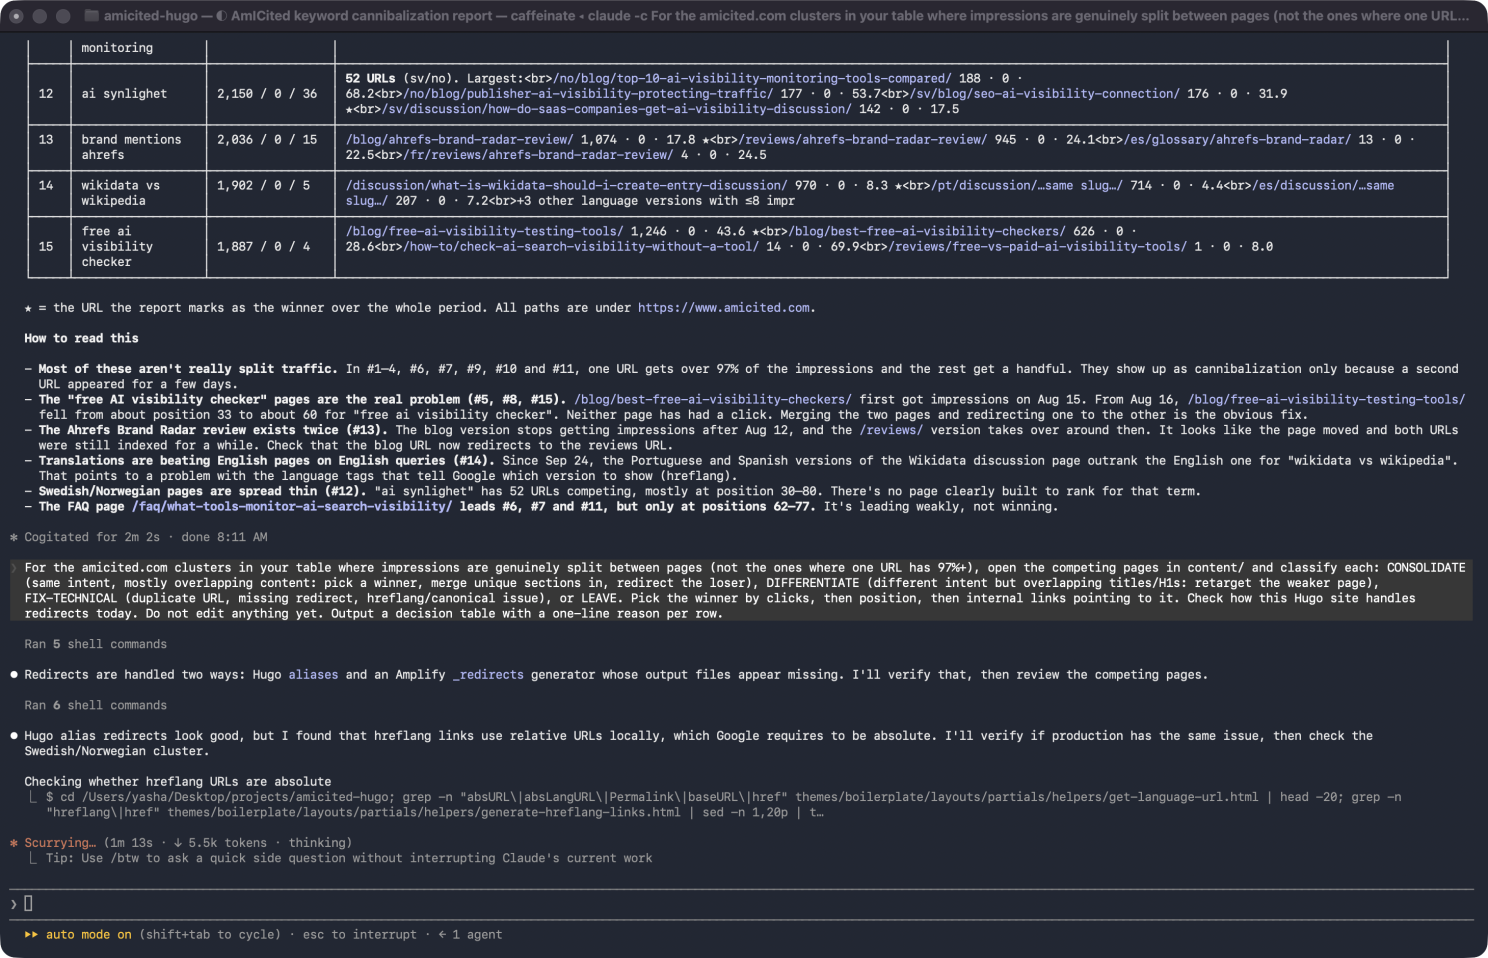
La línea más útil del resultado no fue la tabla en sí. Fue esta:
La mayoría de estos no son realmente tráfico dividido. En nueve de los quince grupos principales, una URL obtiene más del 97 % de las impresiones y el resto recibe un puñado.
Nueve de los quince grupos principales de “canibalización” eran una página haciendo esencialmente todo el trabajo, con una segunda URL que había aparecido durante unos días y nada más. Un informe ordenado puramente por severidad no te dirá eso. Leer la división por URL sí lo hace.
Paso 2: Diagnosticar Antes de Corregir
Para los grupos de tu tabla donde las impresiones están genuinamente divididas entre páginas (no aquellos donde una URL tiene el 97 % o más), abre las páginas competidoras en content/ y clasifica cada una: CONSOLIDAR, DIFERENCIAR, CORREGIR-TÉCNICO o DEJAR. Elige la ganadora por clics, luego por posición, luego por enlaces internos que apunten a ella. Revisa cómo este sitio Hugo maneja las redirecciones actualmente. No edites nada aún. Genera una tabla de decisiones con una razón de una línea por fila.
Este paso no hizo ninguna llamada MCP. Fueron unos 20 comandos de shell: leer los archivos Markdown competidores, contar los enlaces internos a cada página, leer las plantillas del tema, y ejecutar curl contra el sitio en vivo para ver qué devolvían realmente las redirecciones y etiquetas hreflang en producción, no solo en el repositorio.
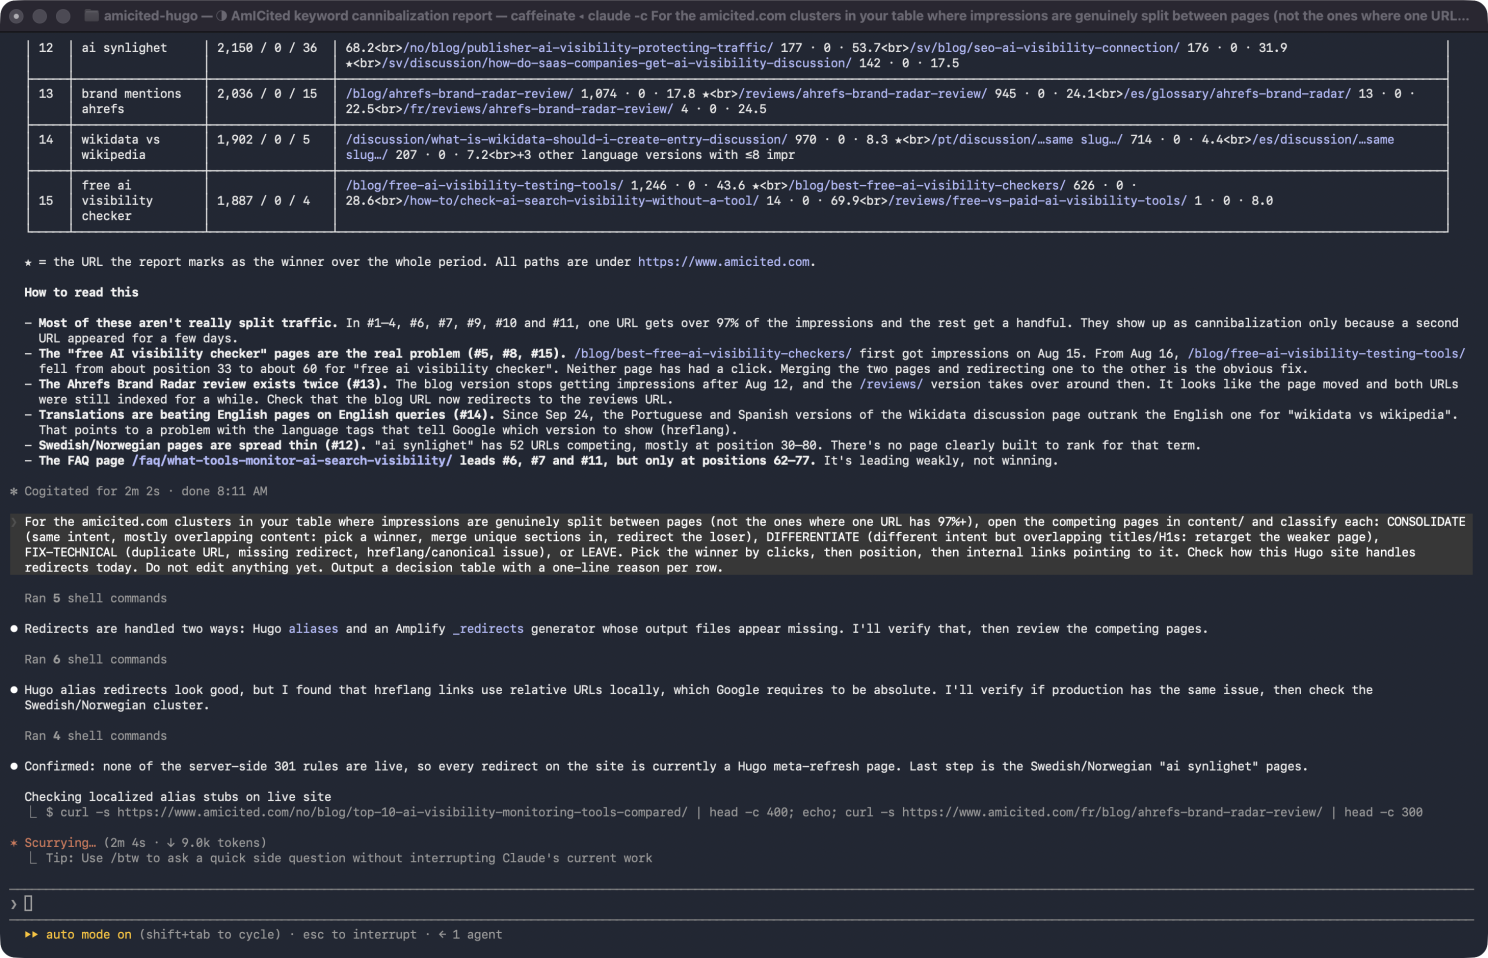
De los quince grupos, uno necesitaba una fusión, uno necesitaba una reorientación, dos necesitaban una corrección técnica y el resto no necesitaba nada. Esa proporción es la razón principal por la que nunca dejaría que un agente saltara directamente de “aquí hay un informe de canibalización” a “aquí están las páginas que eliminé”.
Tres Hallazgos Que No Pedí
1. Mis reglas de redirección 301 habían dejado de funcionar silenciosamente dos meses antes. Mi sitio tiene un script que genera reglas 301 reales para que Amplify las sirva. Claude Code notó que el archivo de salida no existía, rastreó el historial de git y descubrió que había sido eliminado cinco semanas antes dentro de un commit de “actualización de contenido” que tocó más de 21 000 archivos, daño colateral de una sincronización masiva, no una decisión intencionada. Confirmó en el sitio en vivo que ninguna de las reglas estaba activa (una URL movida devolvía un 404 donde debería haber una redirección). Desde entonces, cada “redirección” en el sitio había sido en realidad un alias de Hugo: una página con estado 200 y una meta-refresh, no un 301 real.
2. Eso no era solo teoría. La URL antigua de una página que había movido en julio seguía apareciendo por sí sola en Search Console, 188 impresiones y contando, dos meses y medio después del movimiento. Un stub con meta-refresh que Google sigue indexando de todos modos es exactamente cómo se ve una configuración de alias rota en la práctica.
3. Detectó su propio error. En el paso 1, había señalado un par de páginas como un probable problema de hreflang, ya que una versión traducida estaba superando a la original en inglés. En el paso 2, obtuvo el HTML en vivo, verificó que las etiquetas hreflang fueran absolutas y recíprocas como Google requiere, y reportó que esto corregía lo que había dicho la primera vez. El hallazgo pasó de CORREGIR a DEJAR. Prefiero obtener eso a una respuesta incorrecta y segura que permanezca sin cuestionar en un informe.

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Paso 3: Aplicar la Corrección en 16 Idiomas
Aprobado. Aplica la tabla de decisiones en esta rama, no confirmes. 1) CONSOLIDAR […] sin inventar hechos ni añadir guiones largos, luego elimina la perdedora en todos los idiomas en los que exista, añade su URL antigua a los alias de la ganadora en cada idioma correspondiente, y reorienta todos los enlaces internos a la perdedora en content/. 2) DIFERENCIAR […] en todos los idiomas, y añade un enlace contextual a la ganadora. 3) CORREGIR-TÉCNICO: revisa el historial de git para ver si la eliminación de static/_redirects fue deliberada. Si fue accidental, regenera las reglas […] Si fue deliberada, no las restaures, solo dímelo.
Verificó los datos antes de fusionar nada. La página que se retiraba tenía secciones que la ganadora no tenía: una mención de una herramienta de la competencia, una función de clasificación de productos y un resumen de pruebas gratuitas. Antes de trasladar cualquiera de eso, Claude Code consultó los sitios en vivo de los proveedores para verificar que siguiera siendo preciso.
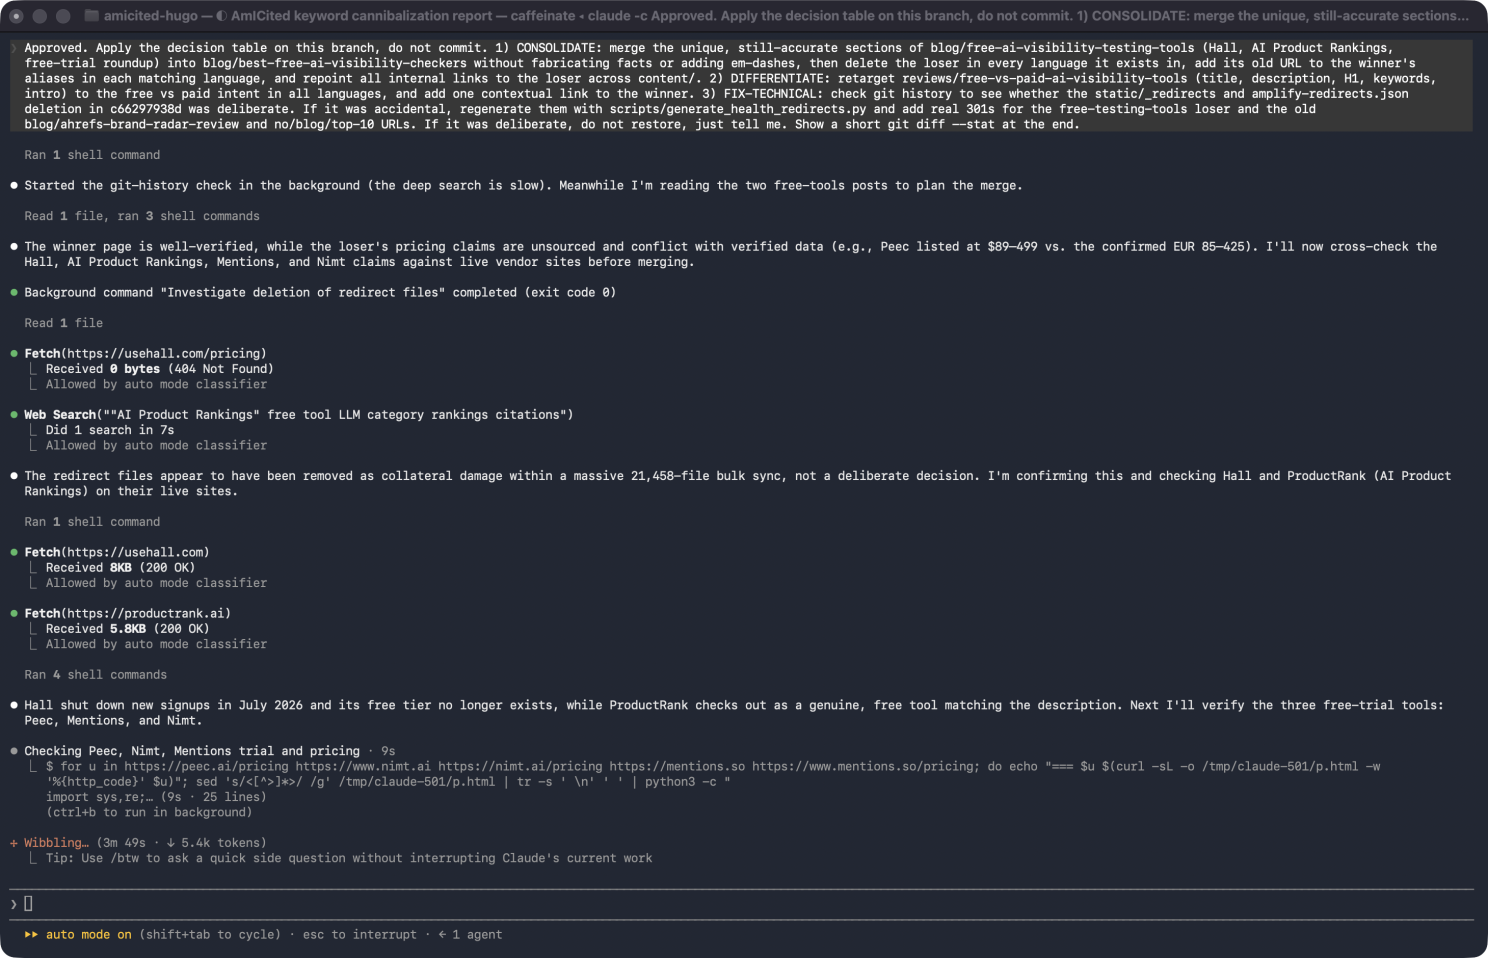
Una de las herramientas mencionadas resultó haber sido adquirida y cerrada a nuevos registros semanas antes, por lo que eso se convirtió en una corrección en lugar de algo copiado como un hecho vigente. La afirmación de precios de la página retirada para otra herramienta también entraba en conflicto con la cifra ya verificada en la página ganadora, por lo que la cifra verificada se mantuvo y la desactualizada no llegó a la fusión.
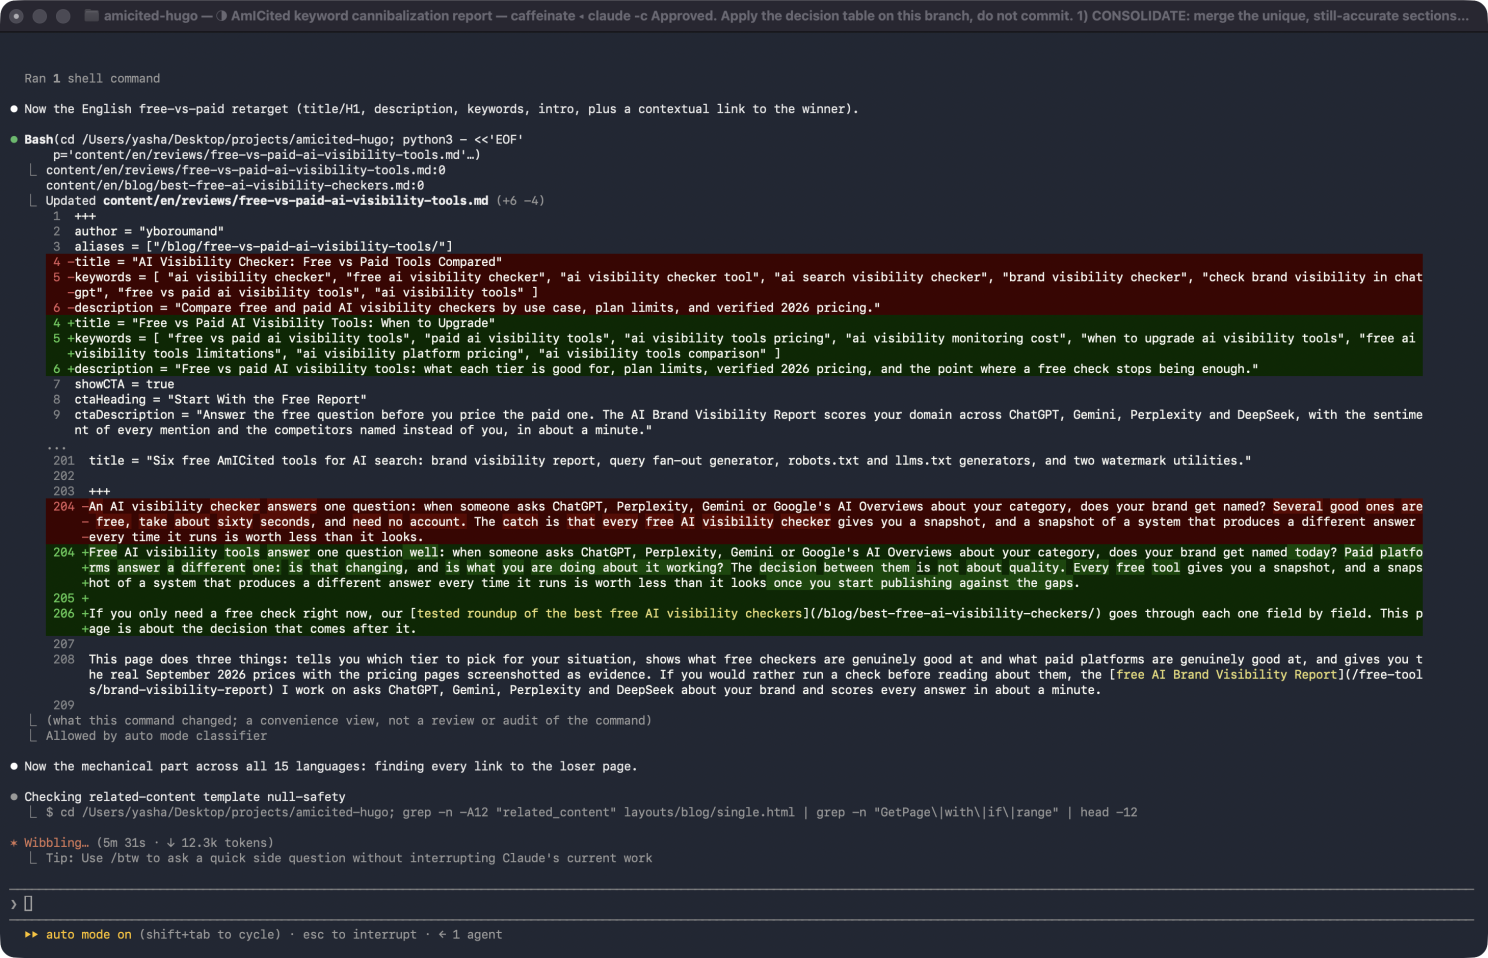
Para el caso CORREGIR-TÉCNICO, verificó si la eliminación de la redirección había sido deliberada antes de tocar nada. Confirmando que fue accidental (el commit masivo que la eliminó tocó miles de archivos no relacionados sin mencionar redirecciones), regeneró las reglas y añadió redirecciones 301 reales para las páginas afectadas por la fusión y la URL movida que seguía mostrando impresiones bajo su dirección antigua. Para CONSOLIDAR y DIFERENCIAR, repitió el mismo cambio en todos los idiomas en los que existían las páginas afectadas, no solo en inglés, y luego ejecutó una compilación completa de producción para confirmar que nada se rompiera.
Lo Que Sigue
Después de publicar nuevo contenido, ese no es el final del trabajo, es solo el comienzo. Saber exactamente qué URLs están compitiendo silenciosamente entre sí, cuáles necesitan fusionarse y cuáles solo necesitan una corrección técnica es lo que evita que ese contenido trabaje en su contra. Nada de esta pasada está en vivo aún; la verificación a los 28 días, para ver si el recuento de consultas canibalizadas realmente disminuye, es el siguiente paso.
Si quieres ver este tipo de informe de canibalización en tu propio dominio, reserva una llamada y lo revisaremos juntos.