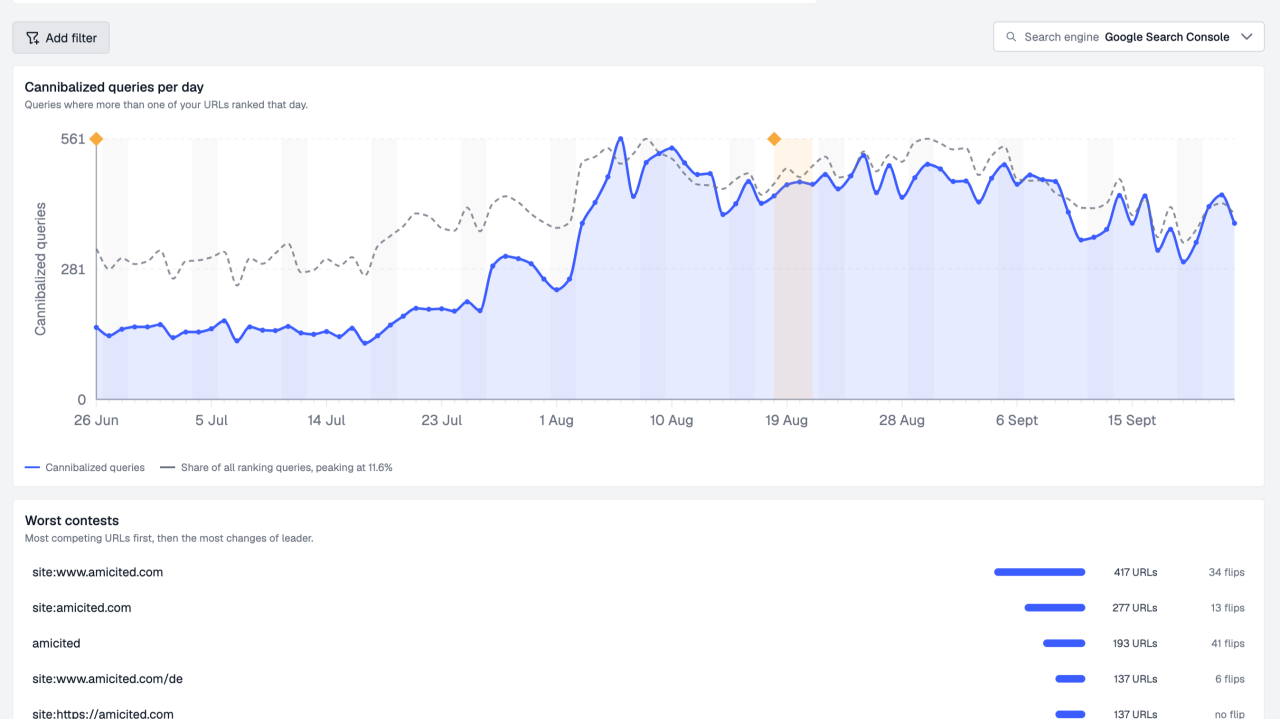
Ze 140 do 561 skanibalizowanych zapytań dziennie
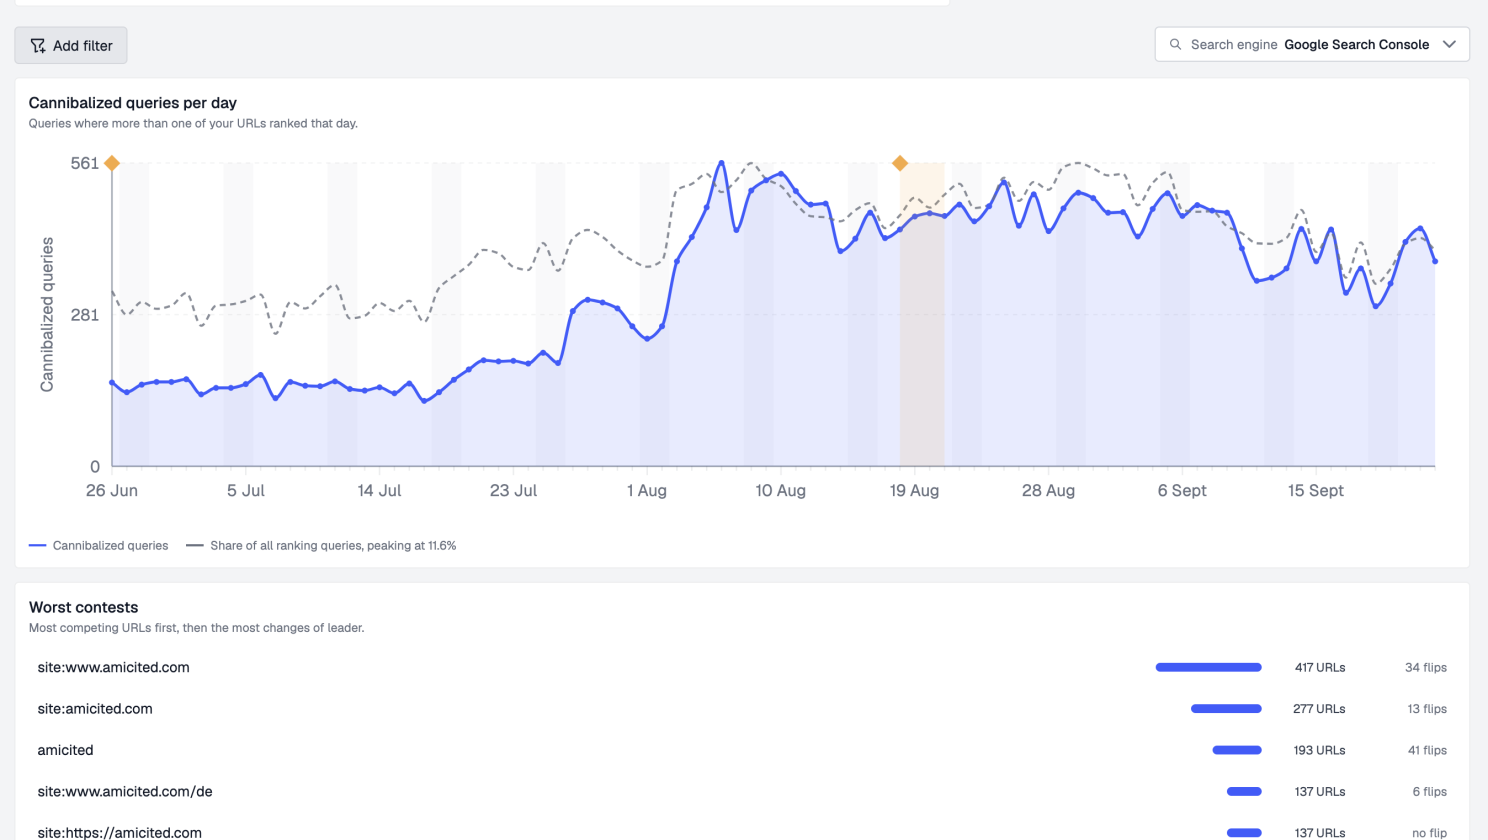
Między końcem czerwca a połową sierpnia liczba zapytań, w przypadku których dwa lub więcej adresów URL amicited.com pojawiało się w wynikach tego samego dnia, wzrosła z około 140 dziennie do szczytu 561. W najgorszym momencie skanibalizowane zapytania stanowiły 11,6% wszystkich zapytań, dla których strona była pozycjonowana.
Dlatego skierowałem Claude Code na repozytorium Hugo strony, podłączyłem je do serwera MCP AmICited SEO i poprosiłem o znalezienie kanibalizacji słów kluczowych, podjęcie decyzji o działaniu w każdym przypadku i zastosowanie poprawek we wszystkich 16 językach, w jakich strona jest dostępna.
Oto kompletna metoda: prompty, których użyłem, co agent faktycznie wywołał i zrobił, oraz trzy rzeczy, które odkrył, a o które nigdy nie pytałem. Żadne z tego nie jest jeszcze wdrożone — traktujcie to jako prezentację procesu, a nie post z wynikami. Ponowna kontrola po 28 dniach nastąpi później.
Kanibalizacja słów kluczowych występuje, gdy dwie lub więcej stron na tej samej stronie internetowej konkuruje o to samo zapytanie, przez co Google ciągle zmienia, którą wyświetlić, i żadna nie radzi sobie tak dobrze, jak zrobiłaby to pojedyncza silna strona. To wewnętrzna konkurencja między własnymi adresami URL i jedno z zadań SEO, w którym Claude Code naprawdę się sprawdza: dane są w Search Console, poprawki w repozytorium, a agent może operować na obu jednocześnie. (Nie myl tego z kanibalizacją treści przez AI, gdzie odpowiedź wygenerowana przez sztuczną inteligencję przejmuje kliknięcie, które normalnie należałoby do Twojej strony.) Jeśli chcesz pełnego wyjaśnienia, opisaliśmy osobno, jak identyfikować i naprawiać problemy z kanibalizacją słów kluczowych.
Konfiguracja
- Repozytorium: moje repozytorium strony Hugo, 500+ angielskich wpisów na blogu, każdy przetłumaczony na 15 innych języków.
- Dane: serwer MCP AmICited, który udostępnia raporty SEO oparte na Google Search Console, w tym kanibalizację, jako narzędzia, które Claude Code może bezpośrednio wywoływać.
- Agent: Claude Code (Opus 5.5) działający w trybie automatycznym na nowej gałęzi
seo/cannibalization-oct-2026. Nic nie zostaje zatwierdzone bez mojego wcześniejszego przejrzenia diffa.
Podłączenie serwera MCP to jednorazowy krok OAuth: uruchom /mcp, wybierz serwer, zatwierdź obszar roboczy w przeglądarce, a Claude Code będzie mógł go od tej pory wywoływać.
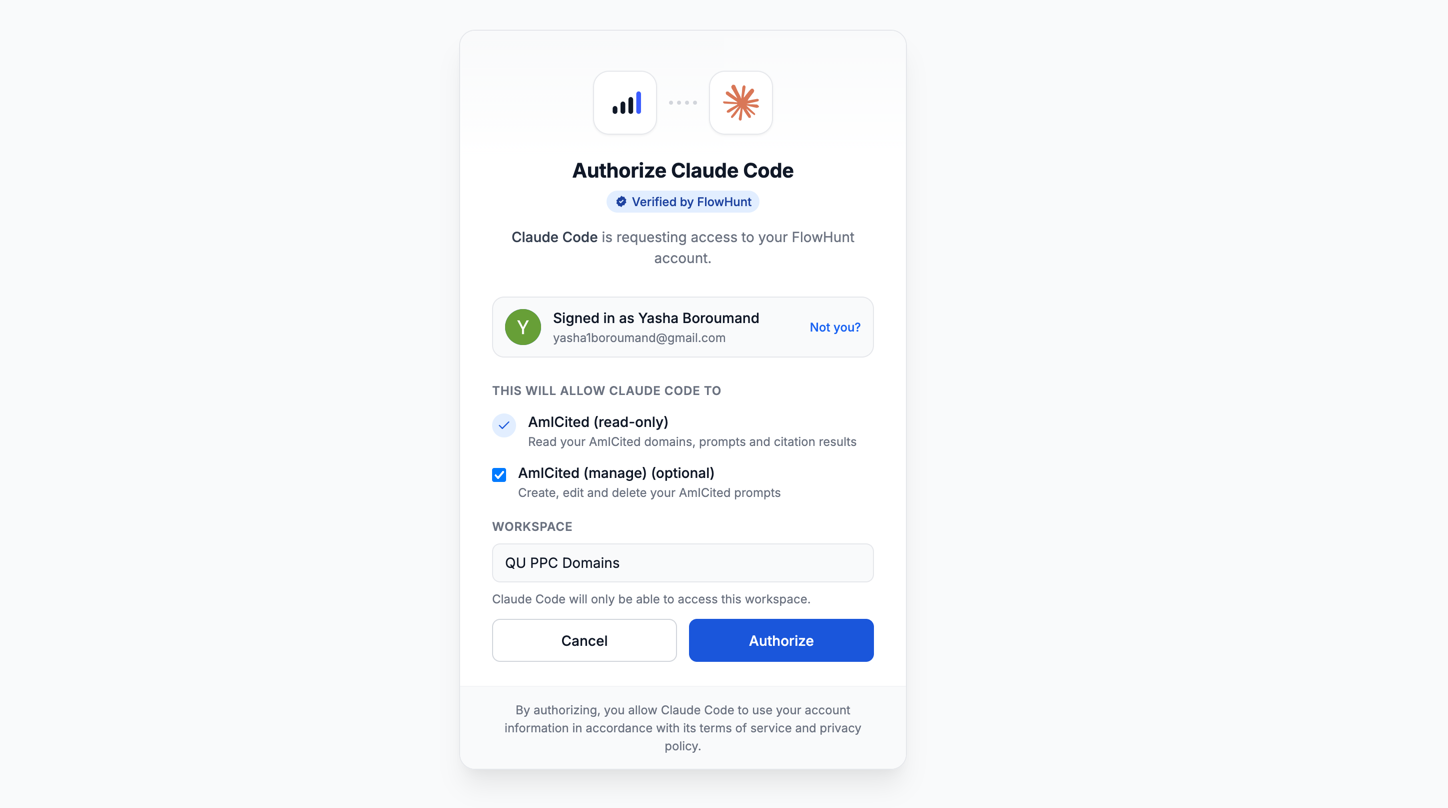
Jedna ważna rzecz, którą warto wiedzieć od razu: mój obszar roboczy AmICited zawiera kilka domen. Każdy prompt, który napisałem, wyraźnie wymieniał amicited.com, a pierwszy z nich prosił Claude Code o poinformowanie mnie, który identyfikator domeny wybrał. Pomiń ten krok, a zaufasz agentowi, że zgadnie prawidłowo.

Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Krok 1: Znajdź kanibalizację, odrzuć szum
Użyj serwera MCP AmICited, aby pobrać raport kanibalizacji słów kluczowych tylko dla domeny amicited.com (obszar roboczy ma kilka domen — wybierz tę dla amicited.com i powiedz mi, którego ID domeny/projektu użyłeś). Użyj danych Google Search Console z ostatnich 90 dni. Najpierw wypisz narzędzia MCP, które wywołujesz. Wyeliminuj szum: zapytania z operatorami wyszukiwania (site:, inurl:), czyste zapytania brandowe/nawigacyjne (“amicited”, “am i cited”) oraz zapytania poniżej 50 wyświetleń. Pokaż 15 najlepszych prawdziwych klastrów kanibalizacji jako tabelę […] Nie edytuj żadnych plików.
Filtr szumu istnieje, ponieważ tak naprawdę wygląda surowy raport. Lista “Najgorszych pojedynków” na moim panelu była prowadzona przez site:www.amicited.com (417 URLi), site:amicited.com (277 URLi) i gołe zapytanie brandowe amicited (193 URLi). To nie jest kanibalizacja. To ja — i prawdopodobnie mój własny zespół — bezpośrednio wyszukujący stronę. Każde narzędzie, które liczy to jako klaster kanibalizacji, liczy coś złego.
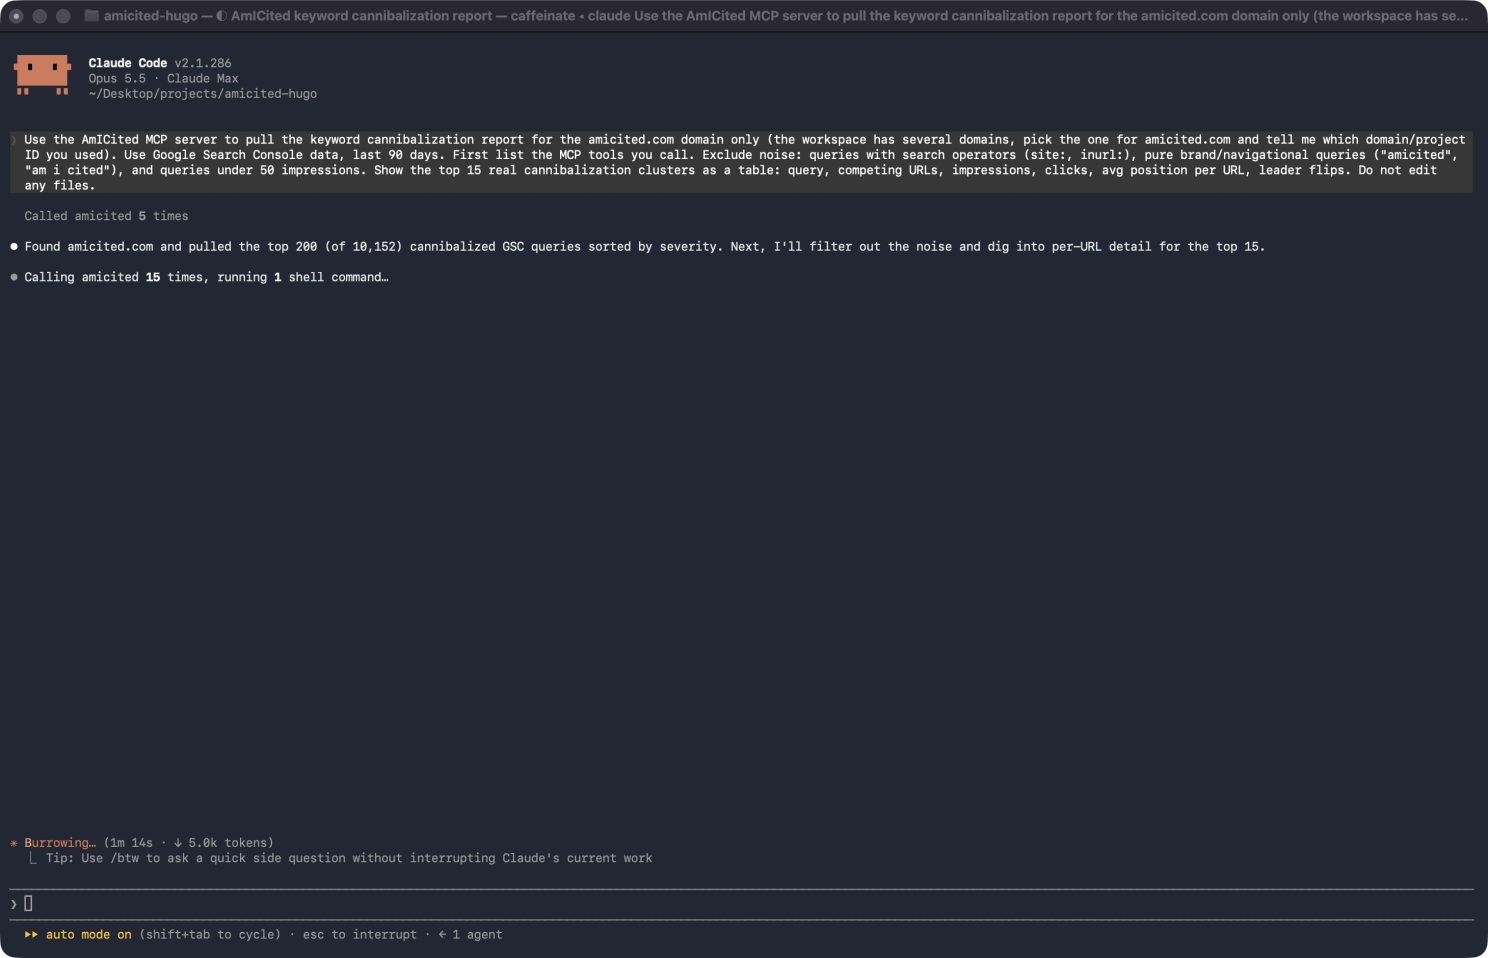
Co zrobił, w kolejności:
list_domains, aby znaleźć amicited.com wśród domen w obszarze roboczym (i zgłosić ID domeny, którego użył).search_tools, ponieważ narzędzia do kanibalizacji nie znajdowały się na jego domyślnej liście narzędzi, więc wyszukał je według opisu.describe_tool, dwukrotnie, aby odczytać schematy wejściowe dwóch narzędzi do zapytań o kanibalizację przed ich wywołaniem.- Narzędzie listy klastrów, raz: 200 najlepszych zapytań według ważności z ponad 10 000 skanibalizowanych zapytań w 90-dniowym oknie.
- Narzędzie szczegółów dla każdego zapytania, 15 razy, raz na klaster, pobierając konkurujące URL-e i ich dzienne pozycje. Jedna odpowiedź była zbyt duża, aby wyświetlić ją w treści, więc zapisał wynik na dysku i podsumował go za pomocą
jq.
Następnie filtrował. Około 30 z 200 najlepszych to zapytania z site:. Z własnej inicjatywy dodał dwa dodatkowe filtry i poinformował mnie o tym: długie zapytania przypominające prompty z tysiącami wyświetleń i zerową liczbą kliknięć (wyglądają jak dosłownie skopiowane prompty narzędzi śledzących AI, a nie prawdziwi ludzie szukający) oraz kilka zapytań przypominających kod, które wyglądały jak ruch botów.
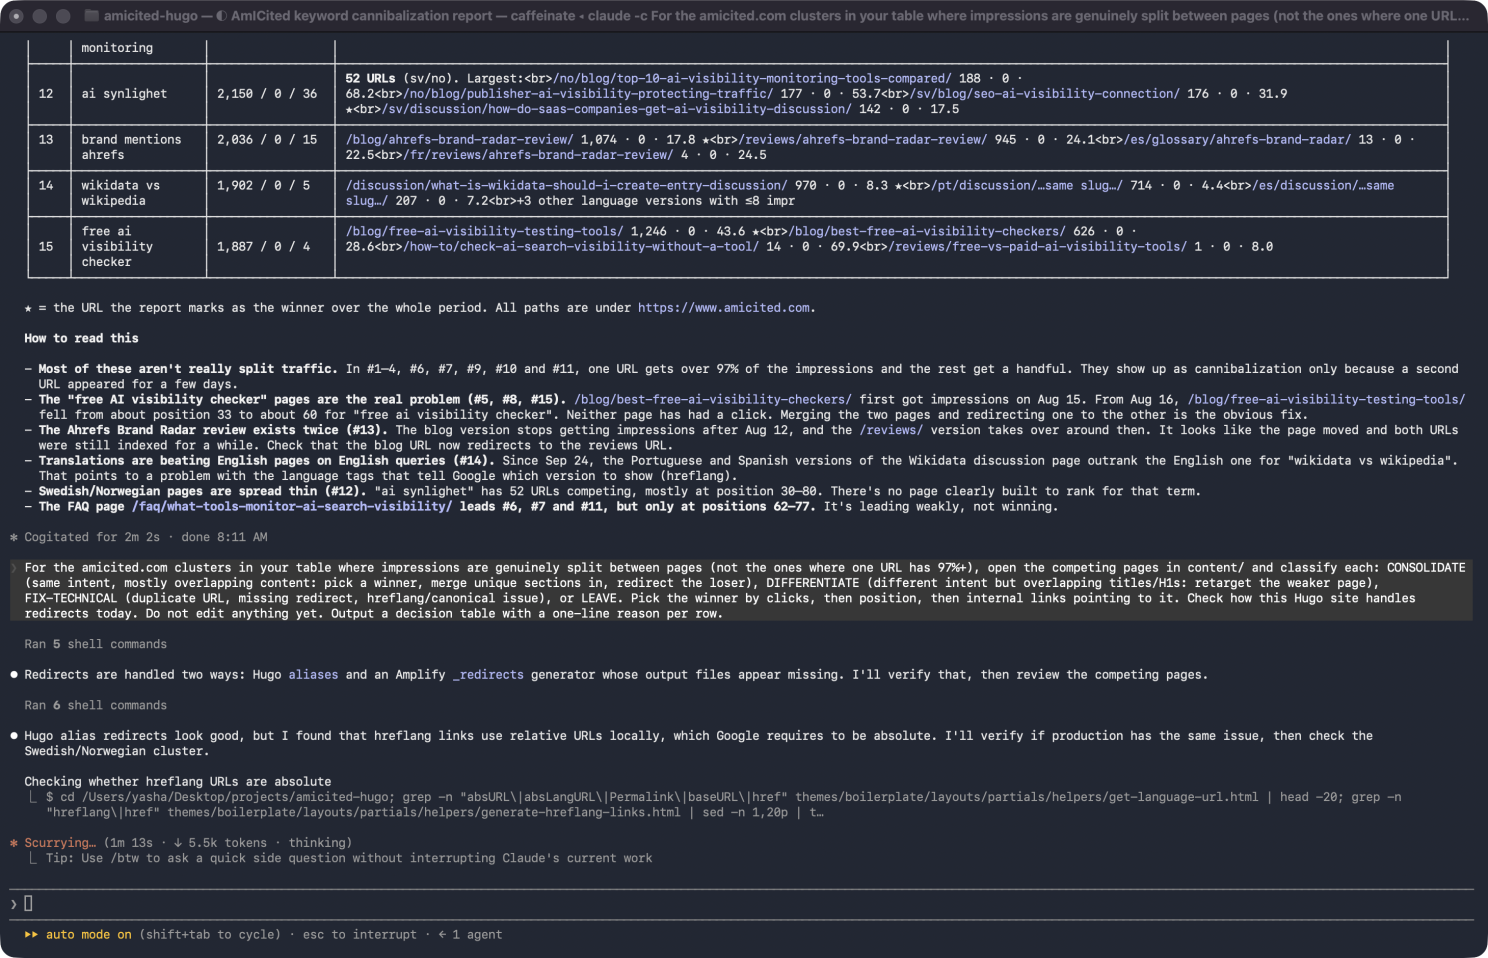
Najbardziej przydatna linia w wynikach nie dotyczyła samej tabeli. Brzmiała tak:
Większość z nich to nie jest prawdziwy podział ruchu. W dziewięciu z piętnastu najlepszych klastrów jeden URL zdobywa ponad 97% wyświetleń, a reszta dostaje ich garstkę.
Dziewięć z piętnastu “najlepszych” klastrów kanibalizacji to jedna strona wykonująca praktycznie całą pracę, z drugim URL-em, który pojawił się na kilka dni i nic więcej. Raport posortowany wyłącznie według ważności ci tego nie pokaże. Odczytanie podziału na poszczególne URL-e — tak.
Krok 2: Najpierw diagnoza, potem poprawka
Dla klastrów z Twojej tabeli, w których wyświetlenia są rzeczywiście podzielone między strony (nie tych, gdzie jeden URL ma 97%+), otwórz konkurujące strony w katalogu content/ i sklasyfikuj każdą: KONSOLIDUJ, ZRÓŻNICUJ, NAPRAW-TECHNICZNIE lub ZOSTAW. Wybierz zwycięzcę według kliknięć, potem pozycji, a następnie linków wewnętrznych do niego prowadzących. Sprawdź, jak ta strona Hugo obsługuje dziś przekierowania. Nie edytuj jeszcze niczego. Wypisz tabelę decyzyjną z jednoliniowym uzasadnieniem dla każdego wiersza.
Ten krok w ogóle nie wymagał wywołań MCP. Chodziło o około 20 poleceń powłoki: odczytanie konkurujących plików Markdown, policzenie linków wewnętrznych do każdej strony, odczytanie szablonów motywu i uruchomienie curl wobec live strony, aby zobaczyć, co przekierowania i tagi hreflang faktycznie zwracają w produkcji, a nie tylko w repozytorium.
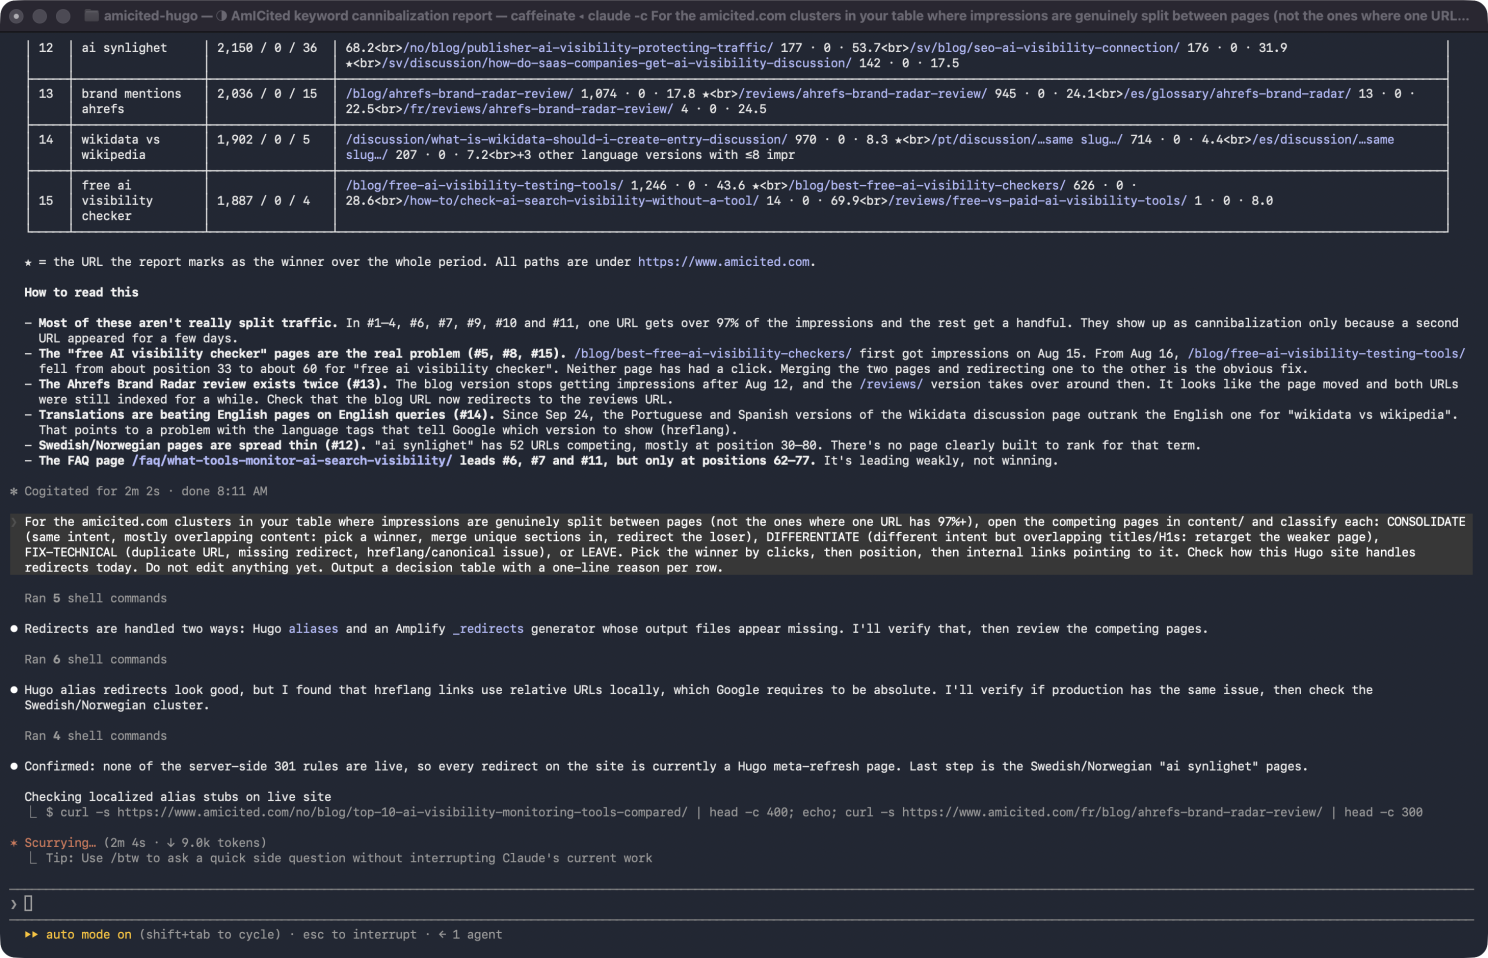
Z piętnastu klastrów jeden wymagał scalenia, jeden wymagał zmiany targetowania, dwa wymagały naprawy technicznej, a reszta nie wymagała niczego. Taki stosunek to główny powód, dla którego nigdy nie pozwoliłbym agentowi przejść bezpośrednio od “oto raport kanibalizacji” do “oto strony, które usunąłem”.
Trzy odkrycia, o które nie prosiłem
1. Moje reguły przekierowań 301 przestały działać dwa miesiące wcześniej. Moja strona ma skrypt generujący prawdziwe reguły 301 dla Amplify. Claude Code zauważył, że plik wyjściowy nie istnieje, prześledził historię git i odkrył, że został usunięty pięć tygodni wcześniej w ramach commitu “update content”, który dotknął ponad 21 000 plików — efekt uboczny masowej synchronizacji, a nie świadoma decyzja. Potwierdził na live stronie, że żadna z reguł nie była aktywna (przeniesiony URL zwracał 404 tam, gdzie powinno być przekierowanie). Od tamtej pory każde “przekierowanie” na stronie było w rzeczywistości aliasem Hugo: stroną ze statusem 200 z meta odświeżaniem, a nie prawdziwym przekierowaniem 301.
2. To nie było tylko teoretyczne. Stary URL strony, którą przeniosłem w lipcu, wciąż pojawiał się samodzielnie w Search Console — 188 wyświetleń i licznik wciąż rósł, dwa i pół miesiąca po przenosinach. Stub z meta odświeżaniem, który Google mimo wszystko dalej indeksuje — właśnie tak w praktyce wygląda zepsuta konfiguracja aliasu.
3. Wychwycił własny błąd. W kroku 1 oznaczył jedną parę stron jako prawdopodobny problem z hreflang, ponieważ przetłumaczona wersja wyprzedzała angielski oryginał. W kroku 2 pobrał live HTML, sprawdził, czy tagi hreflang są absolutne i wzajemne, tak jak wymaga tego Google, i zgłosił, że to koryguje to, co powiedział za pierwszym razem. Znalezisko zostało przeniesione z NAPRAW do ZOSTAW. Wolę to dostać niż pewną siebie błędną odpowiedź, która pozostaje niepodważona w raporcie.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Krok 3: Poprawki w 16 językach
Zatwierdzone. Zastosuj tabelę decyzyjną na tej gałęzi, nie zatwierdzaj. 1) KONSOLIDUJ […] bez zmyślania faktów lub dodawania półpauz, następnie usuń przegrywającego we wszystkich językach, w jakich istnieje, dodaj jego stary URL do aliasów zwycięzcy w każdym odpowiadającym języku i przekieruj wszystkie linki wewnętrzne do przegrywającego w content/. 2) ZRÓŻNICUJ […] we wszystkich językach i dodaj jeden kontekstowy link do zwycięzcy. 3) NAPRAW-TECHNICZNIE: sprawdź historię git, aby ustalić, czy usunięcie static/_redirects było celowe. Jeśli było przypadkowe, wygeneruj je ponownie […] Jeśli było celowe, nie przywracaj, tylko mnie poinformuj.
Zweryfikował fakty przed scaleniem czegokolwiek. Strona wycofywana miała sekcje, których zwycięzca nie posiadał: wzmiankę o konkurencyjnym narzędziu, funkcję rankingu produktów oraz zestawienie bezpłatnych okresów próbnych. Przed przeniesieniem któregokolwiek z tych elementów Claude Code pobrał live strony dostawców, aby zweryfikować, czy informacje są wciąż aktualne.
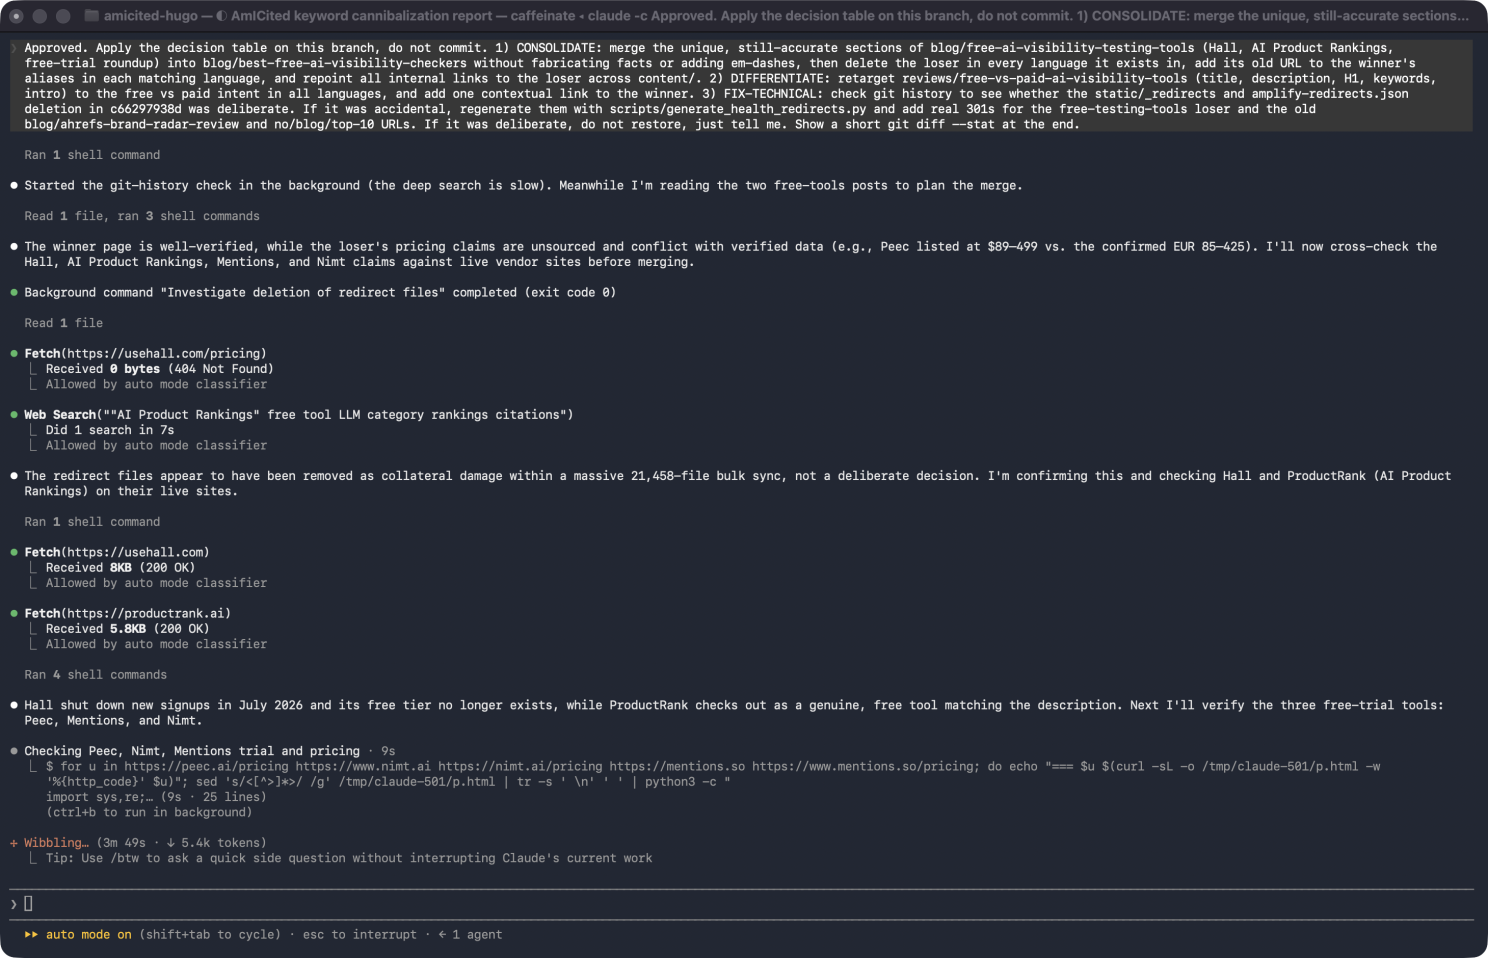
Jedno z wymienionych narzędzi okazało się zostać przejęte i zamknięte dla nowych rejestracji kilka tygodni wcześniej, więc trafiło to jako korekta, a nie jako skopiowany aktualny fakt. Twierdzenie o cenie na wycofywanej stronie dla innego narzędzia również było sprzeczne z liczbą już zweryfikowaną na stronie zwycięskiej, więc zweryfikowana wartość pozostała, a nieaktualna nie trafiła do scalenia.
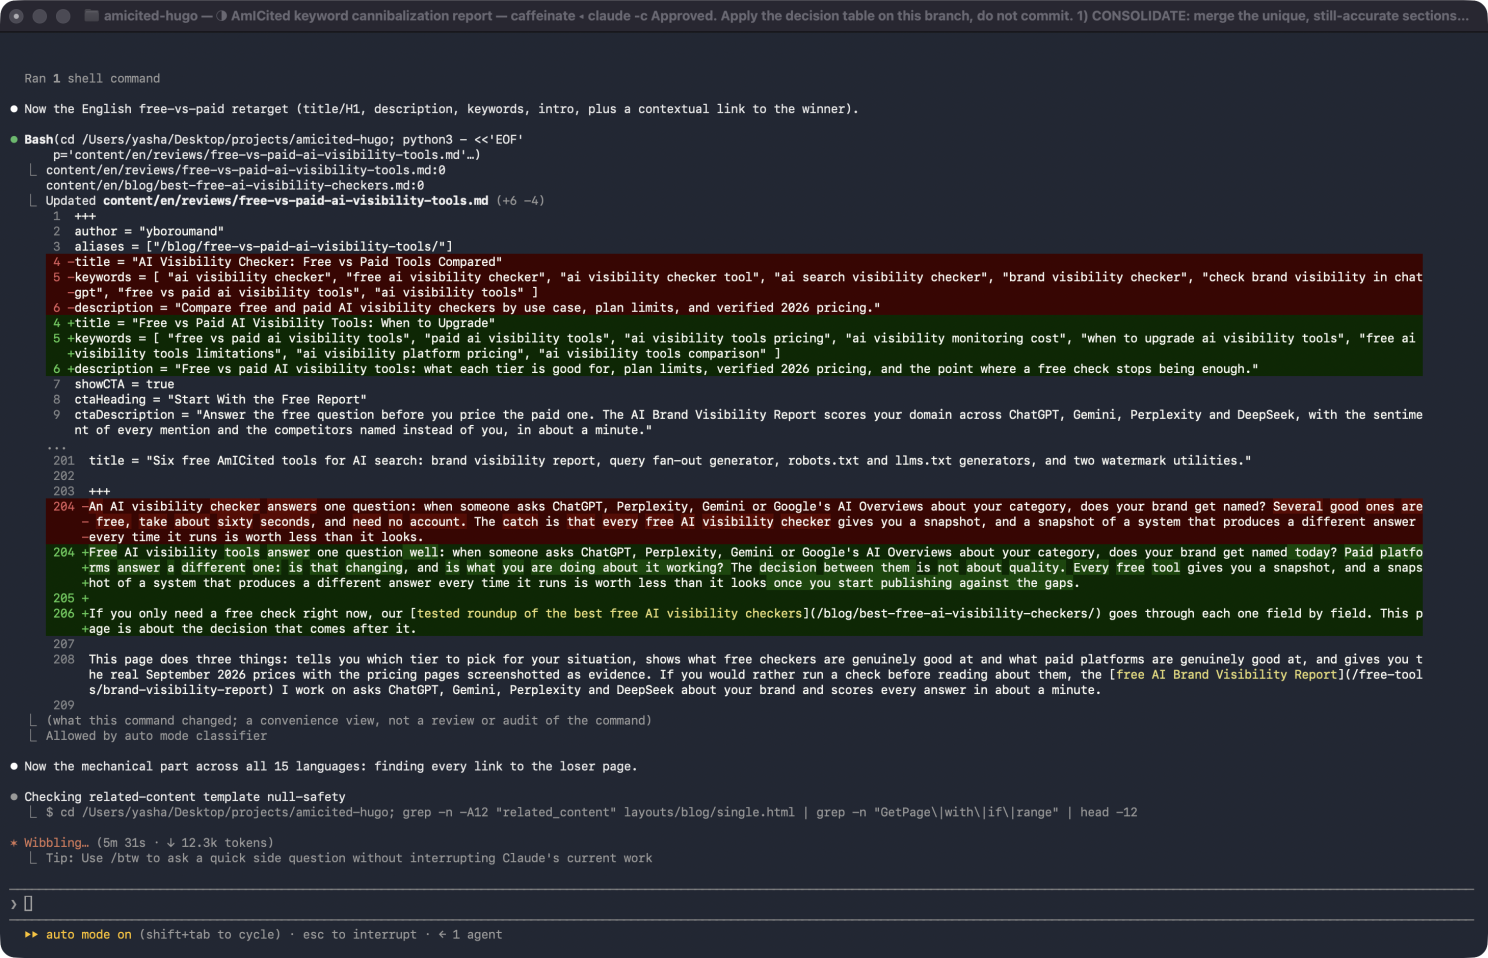
W przypadku NAPRAW-TECHNICZNIE sprawdził przed jakimikolwiek działaniami, czy usunięcie przekierowań było celowe. Potwierdziwszy, że było przypadkowe (masowy commit, który je usunął, dotknął tysięcy niezwiązanych plików bez wzmianki o przekierowaniach), wygenerował reguły na nowo i dodał prawdziwe przekierowania 301 dla stron dotkniętych scaleniem oraz przeniesionego URL-a, który wciąż zbierał wyświetlenia pod starym adresem. Dla KONSOLIDUJ i ZRÓŻNICUJ powtórzył tę samą zmianę we wszystkich językach, w jakich istniały dane strony, nie tylko w angielskim, a następnie uruchomił pełną kompilację produkcyjną, aby potwierdzić, że nic się nie zepsuło.
Co dalej
Po opublikowaniu nowej treści to nie koniec pracy — to dopiero początek. Wiedza o tym, które adresy URL po cichu ze sobą konkurują, które wymagają scalenia, a które potrzebują jedynie naprawy technicznej, to właśnie to, co zapobiega działaniu treści na własną niekorzyść. Nic z tej sesji nie jest jeszcze opublikowane; ponowna kontrola po 28 dniach, aby sprawdzić, czy liczba skanibalizowanych zapytań faktycznie spadnie, to kolejny krok.
Jeśli chcesz zobaczyć tego typu raport kanibalizacji na własnej domenie, umów się na rozmowę — omówimy to krok po kroku.