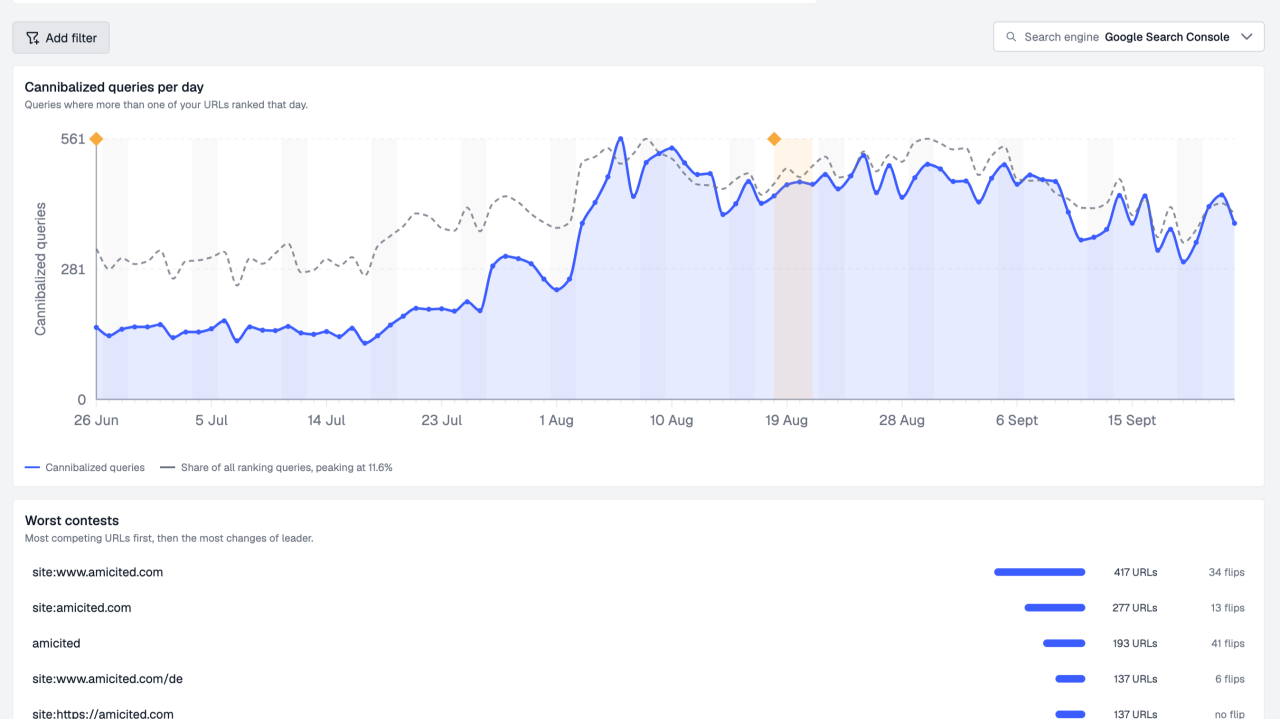
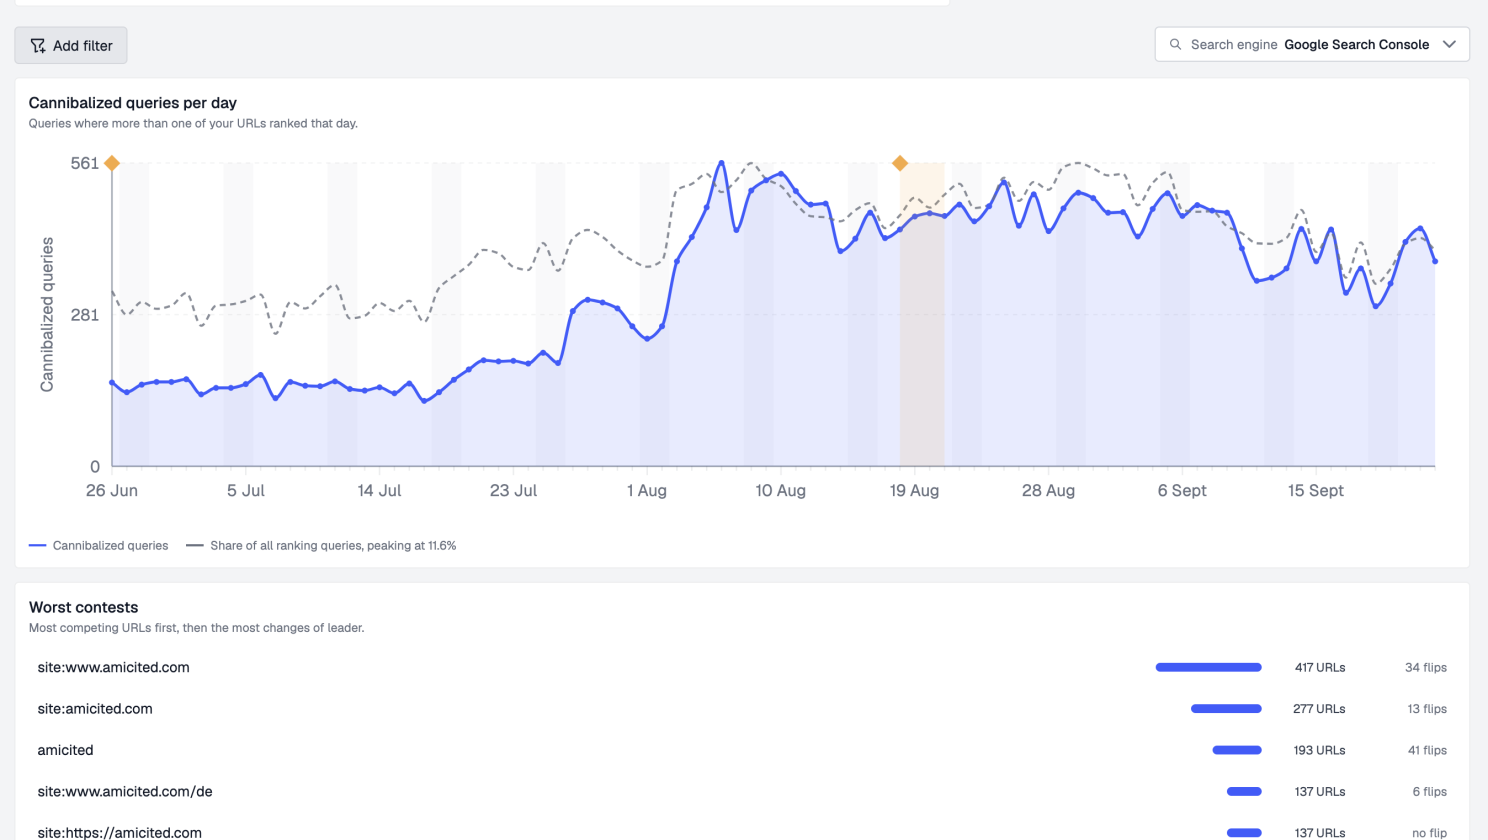
Från 140 till 561 kannibaliserade sökfrågor per dag
Mellan slutet av juni och mitten av augusti steg antalet sökfrågor där två eller flera amicited.com-URL:er rankade samma dag från cirka 140 per dag till en topp på 561. Som värst utgjorde kannibaliserade sökfrågor 11,6 % av allt webbplatsen rankade för.
Så jag riktade Claude Code mot webbplatsens Hugo-repo, kopplade det till AmICited SEO MCP-servern och bad det hitta keyword-kannibaliseringen, bestämma vad som skulle göras åt varje fall och tillämpa åtgärden på alla 16 språk webbplatsen levereras på.
Det här är metoden från början till slut: promptarna jag använde, vad agenten faktiskt anropade och gjorde, och de tre sakerna den hittade som jag aldrig frågade om. Ingenting är publicerat ännu, så betrakta detta som en genomgång av processen, inte ett resultatinlägg. 28-dagarskontrollen kommer senare.
Keyword-kannibalisering är när två eller flera sidor på samma webbplats konkurrerar om samma sökfråga, så Google växlar mellan vilken sida som visas och ingen av dem rankar lika bra som en enda stark sida skulle göra. Det är intern konkurrens mellan dina egna URL:er, och det är en av SEO-uppgifterna där Claude Code verkligen visar sitt värde: datan finns i Search Console, åtgärden finns i repot, och en agent kan hantera båda samtidigt. (Förväxla det inte med AI-innehållskannibalisering, där ett AI-genererat svar tar klicket din sida annars skulle ha fått.) Om du vill ha en fullständig genomgång har vi skrivit om hur man identifierar och åtgärdar problem med keyword-kannibalisering separat.
Uppsättningen
- Repo: mitt Hugo-webbplatssrepo, 500+ engelska blogginlägg, varje översatt till 15 andra språk.
- Data: AmICited MCP-servern, som exponerar SEO-rapporter baserade på Google Search Console, inklusive kannibalisering, som verktyg Claude Code kan anropa direkt.
- Agent: Claude Code (Opus 5.5) som körs i automatiskt läge, på en ny branch,
seo/cannibalization-oct-2026. Ingenting committas utan att jag läser diffen först.
Att ansluta MCP-servern är ett engångssteg med OAuth: kör /mcp, välj servern, godkänn arbetsytan i webbläsaren, och Claude Code kan anropa den från och med då.
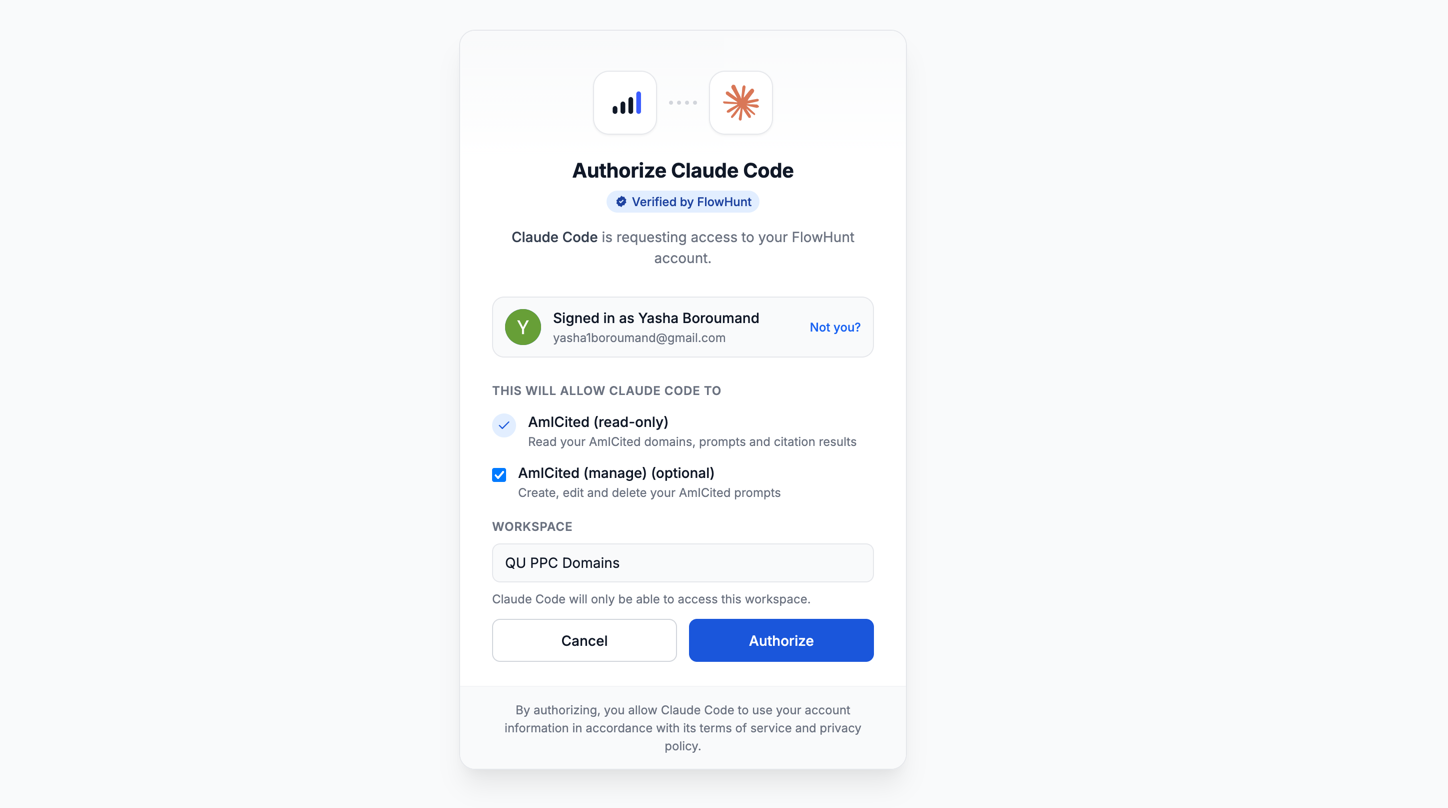
En sak värd att veta på förhand: min AmICited-arbetsyta har flera domäner i sig. Varje prompt jag skrev namngav amicited.com explicit, och den första bad Claude Code berätta vilket domän-ID den valde. Hoppa över det steget och du litar på att agenten gissar rätt.
Steg 1: Hitta kannibalisering, sålla bort bruset
Använd AmICited MCP-servern för att hämta keyword-kannibaliseringsrapporten för endast domänen amicited.com (arbetsytan har flera domäner, välj den för amicited.com och berätta vilket domän-/projekt-ID du använde). Använd Google Search Console-data, senaste 90 dagarna. Lista först de MCP-verktyg du anropar. Exkludera brus: sökfrågor med sökoperatorer (site:, inurl:), rena varumärkes-/navigationsfrågor (“amicited”, “am i cited”) och sökfrågor under 50 visningar. Visa de 15 främsta verkliga kannibaliseringsklustren som en tabell […] Redigera inga filer.
Brusfiltret finns på grund av hur rårapporten faktiskt ser ut. Listan “Värsta tävlingar” på min instrumentpanel leddes av site:www.amicited.com (417 URL:er), site:amicited.com (277 URL:er) och den rena varumärkesfrågan amicited (193 URL:er). Det är inte kannibalisering. Det är jag, och förmodligen mitt eget team, som söker direkt på webbplatsen. Alla verktyg som räknar det som ett kannibaliseringskluster räknar fel sak.
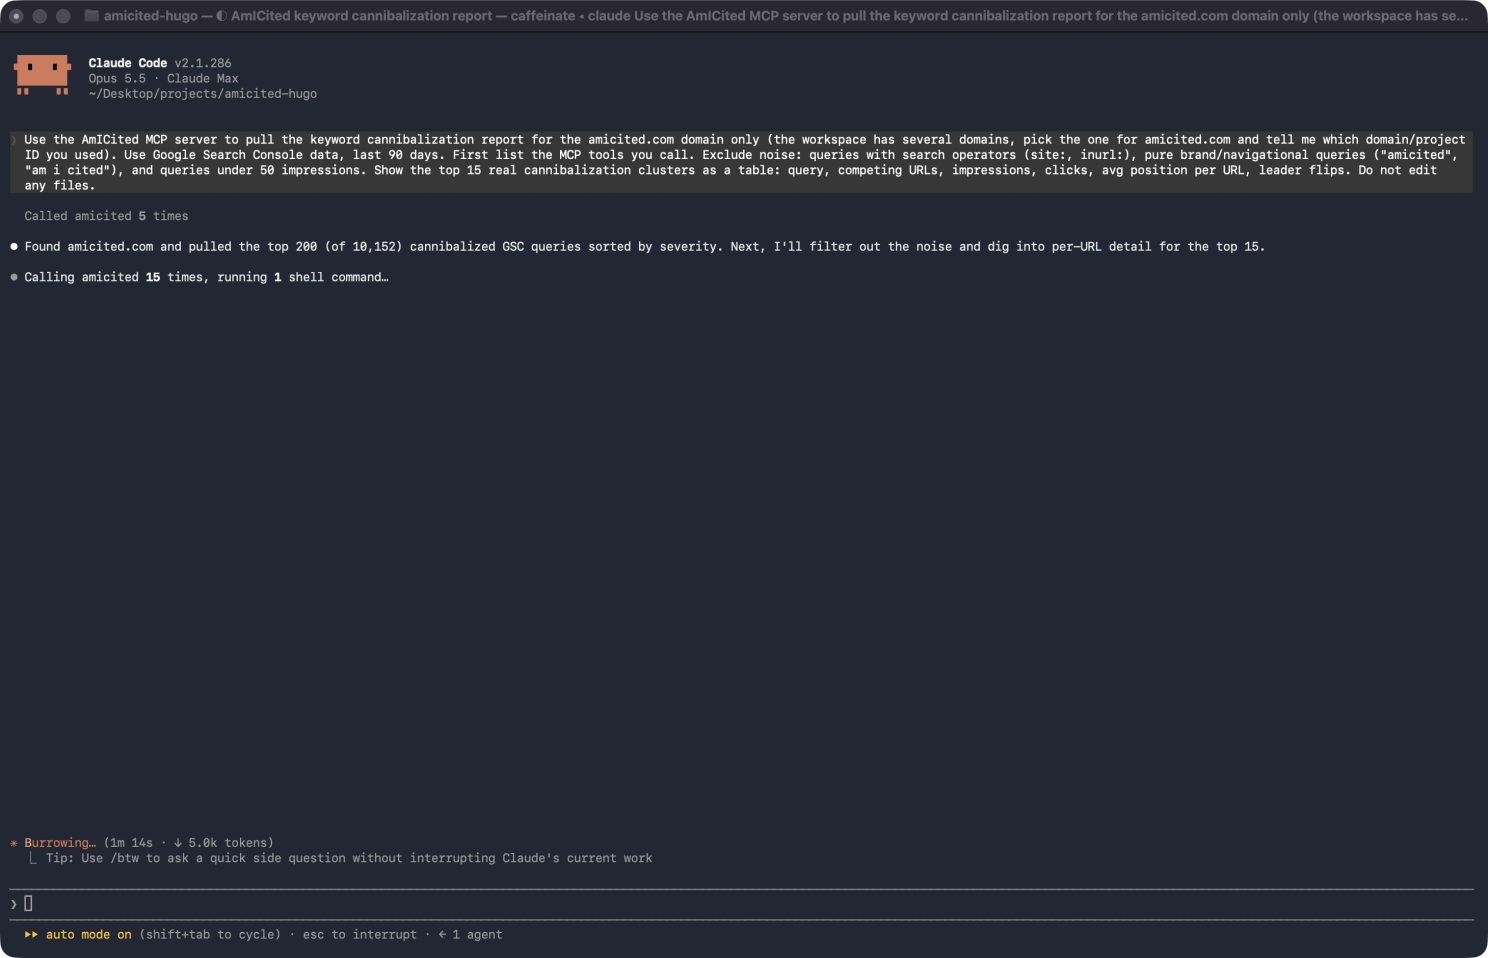
Vad den gjorde, i ordning:
list_domainsför att hitta amicited.com bland domänerna i arbetsytan (och rapportera tillbaka vilket domän-ID den använde).search_toolseftersom kannibaliseringsverktygen inte fanns i dess standardverktygslista, så den sökte efter dem via beskrivning.describe_tool, två gånger, för att läsa indatascheman för de två kannibaliseringsfrågeverktygen innan den anropade dem.- Klusterlistverktyget, en gång: de 200 främsta sökfrågorna efter allvarlighetsgrad, av över 10 000 kannibaliserade sökfrågor inom 90-dagarsfönstret.
- Detaljverktyget per sökfråga, 15 gånger, en gång per kluster, med hämtning av de konkurrerande URL:erna och deras dagliga positioner. Ett svar var för stort för att visas inline, så den sparade utdatan till disk och sammanfattade den med
jq.
Sedan filtrerade den. Cirka 30 av de 200 främsta var site:-frågor. På eget initiativ lade den till två ytterligare filter och berättade att den hade gjort det: långa, promptformade sökfrågor med tusentals visningar och noll klick (de liknar AI-spårningsprompter kopierade ordagrant, inte riktiga personer som söker), och en handfull kodliknande sökfrågor som såg ut som bottrafik.
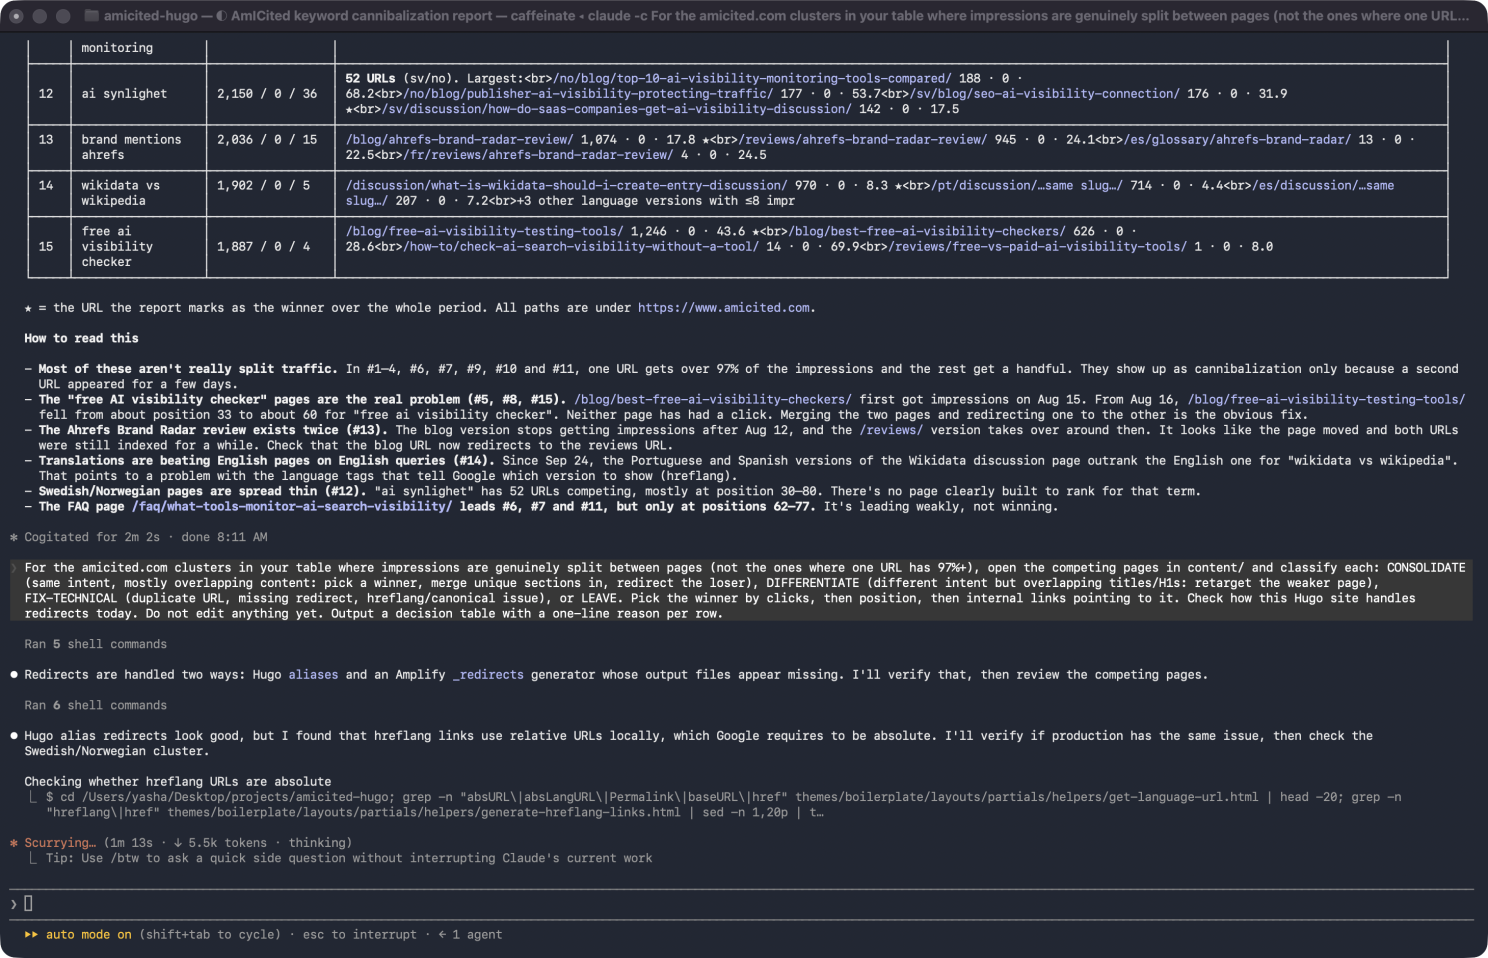
Den mest användbara raden i utdatan var inte själva tabellen. Det var detta:
De flesta av dessa är inte verkligt delad trafik. I nio av de femton främsta klustren får en URL över 97 % av visningarna och resten får en handfull.
Nio av de femton främsta “kannibaliserings”-klustren var en sida som gjorde i princip allt arbete, med en andra URL som hade dykt upp under några dagar och inget mer. En rapport sorterad enbart efter allvarlighetsgrad kommer inte att berätta det. Att läsa uppdelningen per URL gör det.
Steg 2: Diagnostisera innan du åtgärdar
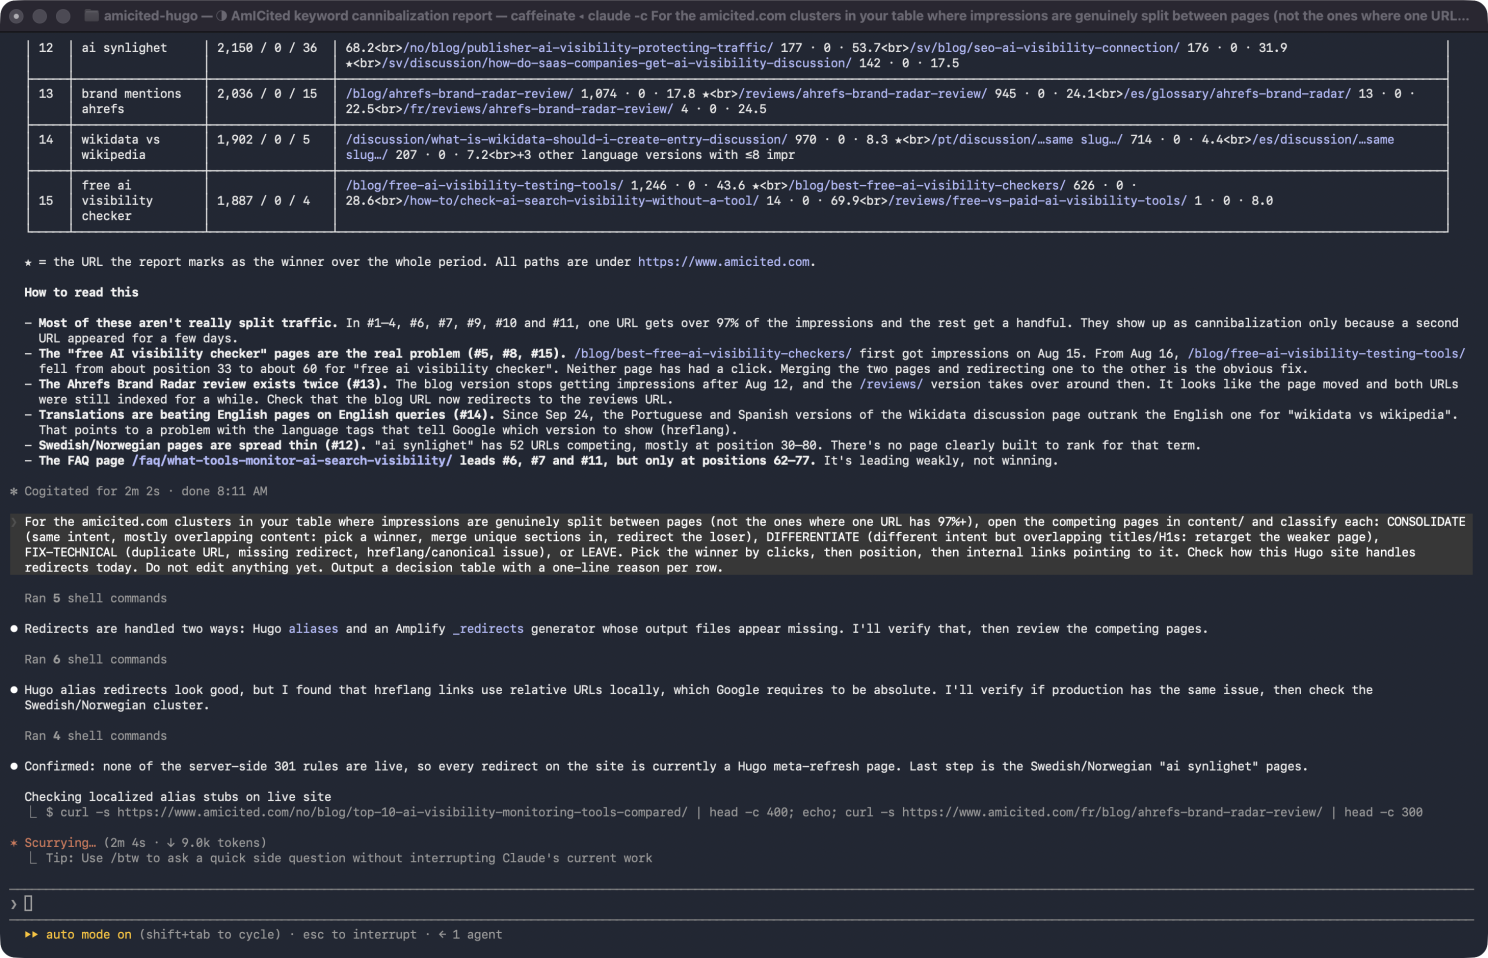
För klustren i din tabell där visningar är verkligt delade mellan sidor (inte de där en URL har 97 %+), öppna de konkurrerande sidorna i content/ och klassificera varje: CONSOLIDATE, DIFFERENTIATE, FIX-TECHNICAL eller LEAVE. Välj vinnare efter klick, sedan position, sedan interna länkar som pekar till den. Kontrollera hur denna Hugo-webbplats hanterar omdirigeringar idag. Redigera inget ännu. Skriv ut en beslutstabell med en rad motivering per rad.
Detta steg gjorde inga MCP-anrop alls. Det handlade om cirka 20 shell-kommandon: läsa de konkurrerande Markdown-filerna, räkna interna länkar till varje sida, läsa temats mallar och köra curl mot livewebbplatsen för att se vad omdirigeringarna och hreflang-taggarna faktiskt returnerade i produktion, inte bara i repot.
Av de femton klustren behövde ett en sammanslagning, ett behövde ompositioneras, två behövde en teknisk åtgärd och resten behövde inget. Den andelen är huvudorsaken till att jag aldrig skulle låta en agent gå direkt från “här är en kannibaliseringsrapport” till “här är sidorna jag tog bort.”
Tre fynd jag inte bad om
1. Mina 301-omdirigeringsregler hade tyst slutat fungera två månader tidigare. Min webbplats har ett skript som genererar riktiga 301-regler för Amplify att leverera. Claude Code märkte att utdatafilen inte fanns, gick tillbaka genom git-historiken och fann att den hade raderats fem veckor tidigare inuti en “uppdatera innehåll”-commit som berörde över 21 000 filer – kollateralskada från en massynkronisering, inte ett beslut någon fattade medvetet. Den bekräftade på livewebbplatsen att inga av reglerna var aktiva (en flyttad URL returnerade en 404 där en omdirigering borde ha funnits). Sedan dess hade varje “omdirigering” på webbplatsen faktiskt varit ett Hugo-alias: en sida med status 200 och en meta-uppdatering, inte en riktig 301.
2. Det var inte bara teoretiskt. Den gamla URL:en för en sida jag hade flyttat i juli dök fortfarande upp på egen hand i Search Console – 188 visningar och räknande, två och en halv månad efter flytten. En meta-uppdateringsstub som Google fortsätter indexera är precis vad en trasig alias-installation ser ut som i praktiken.
3. Den upptäckte sitt eget misstag. I steg 1 hade den flaggat ett sidpar som ett troligt hreflang-problem, eftersom en översatt version rankade högre än den engelska originalversionen. I steg 2 hämtade den live-HTML-koden, kontrollerade att hreflang-taggarna var absoluta och ömsesidiga som Google kräver, och rapporterade att detta korrigerade vad den hade sagt första gången. Fyndet flyttades från FIX till LEAVE. Jag får mycket hellre det än ett självsäkert felaktigt svar som står oemotsagt i en rapport.

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Steg 3: Tillämpa åtgärden på 16 språk
Godkänt. Tillämpa beslutstabellen på denna branch, committa inte. 1) CONSOLIDATE […] utan att fabricera fakta eller lägga till tankstreck, ta sedan bort förloraren på alla språk den finns på, lägg till dess gamla URL i vinnarens alias på varje matchande språk, och peka om alla interna länkar till förloraren i content/. 2) DIFFERENTIATE […] på alla språk, och lägg till en kontextuell länk till vinnaren. 3) FIX-TECHNICAL: kontrollera git-historiken för att se om borttagningen av static/_redirects var avsiktlig. Om den var oavsiktlig, återskapa dem […] Om den var avsiktlig, återställ inte, berätta bara för mig.
Den faktakontrollerade innan den slog samman något. Sidan som skulle pensioneras hade avsnitt som vinnaren saknade: ett omnämnande av ett konkurrerande verktyg, en produktrankningsfunktion och en sammanställning av gratis provperioder. Innan något av detta fördes vidare hämtade Claude Code leverantörernas livewebbplatser för att verifiera att det fortfarande var korrekt.
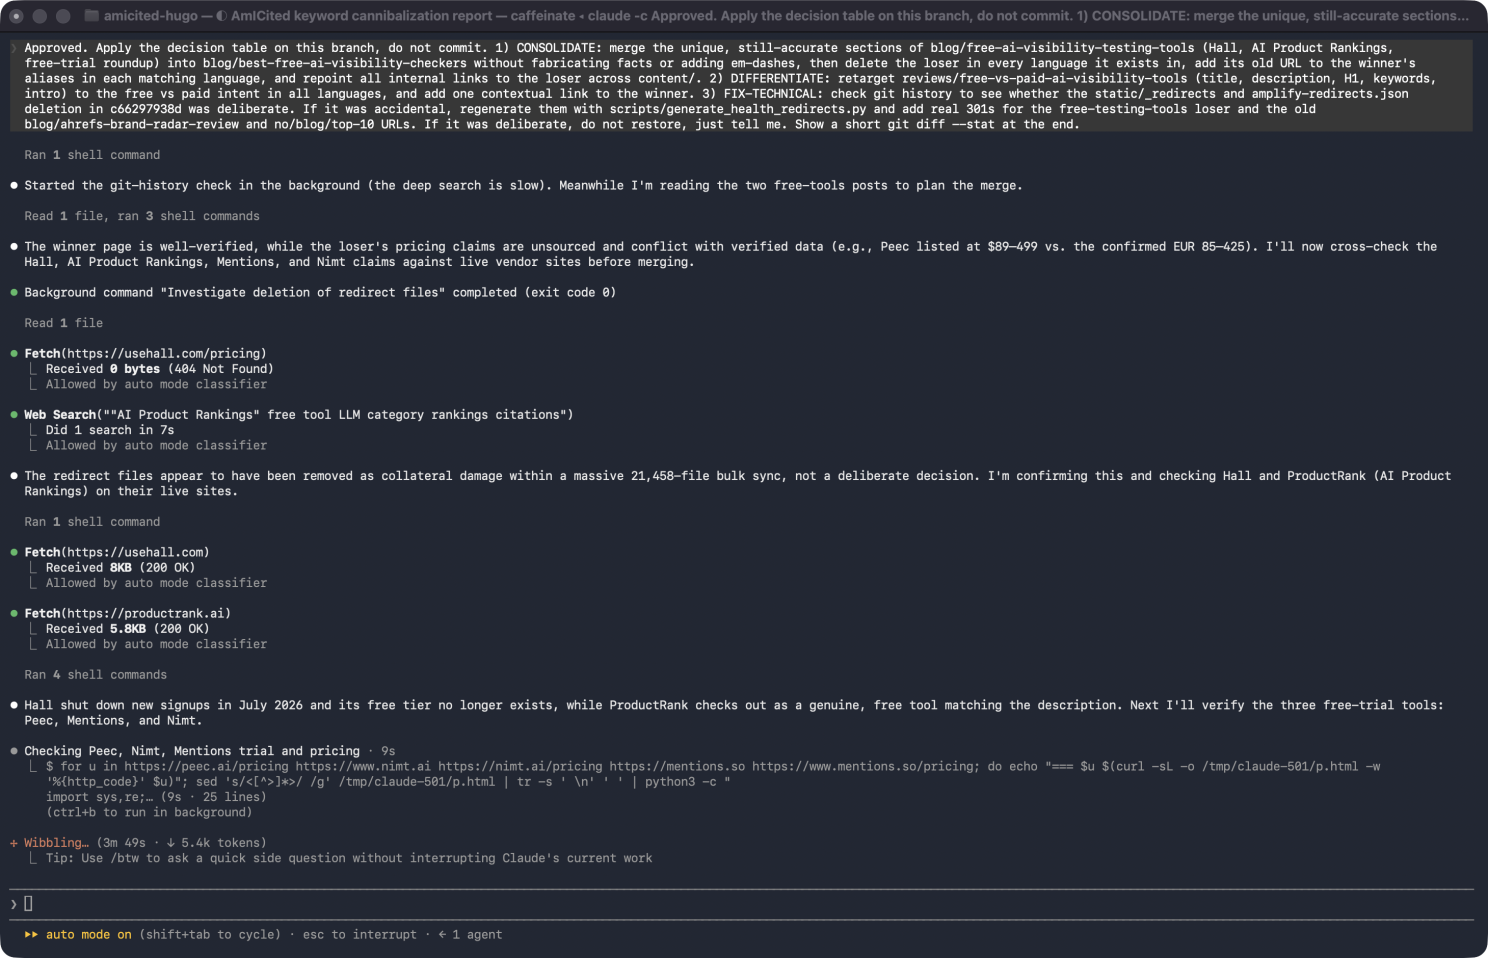
Ett av de namngivna verktygen visade sig ha blivit uppköpt och stängt för nya registreringar veckor tidigare, så det blev en korrigering istället för något som kopierades vidare som aktuell fakta. Den pensionerade sidans prispåstående för ett annat verktyg stod också i konflikt med siffran som redan verifierats på vinnarsidan, så den verifierade siffran behölls och den inaktuella togs inte med i sammanslagningen.
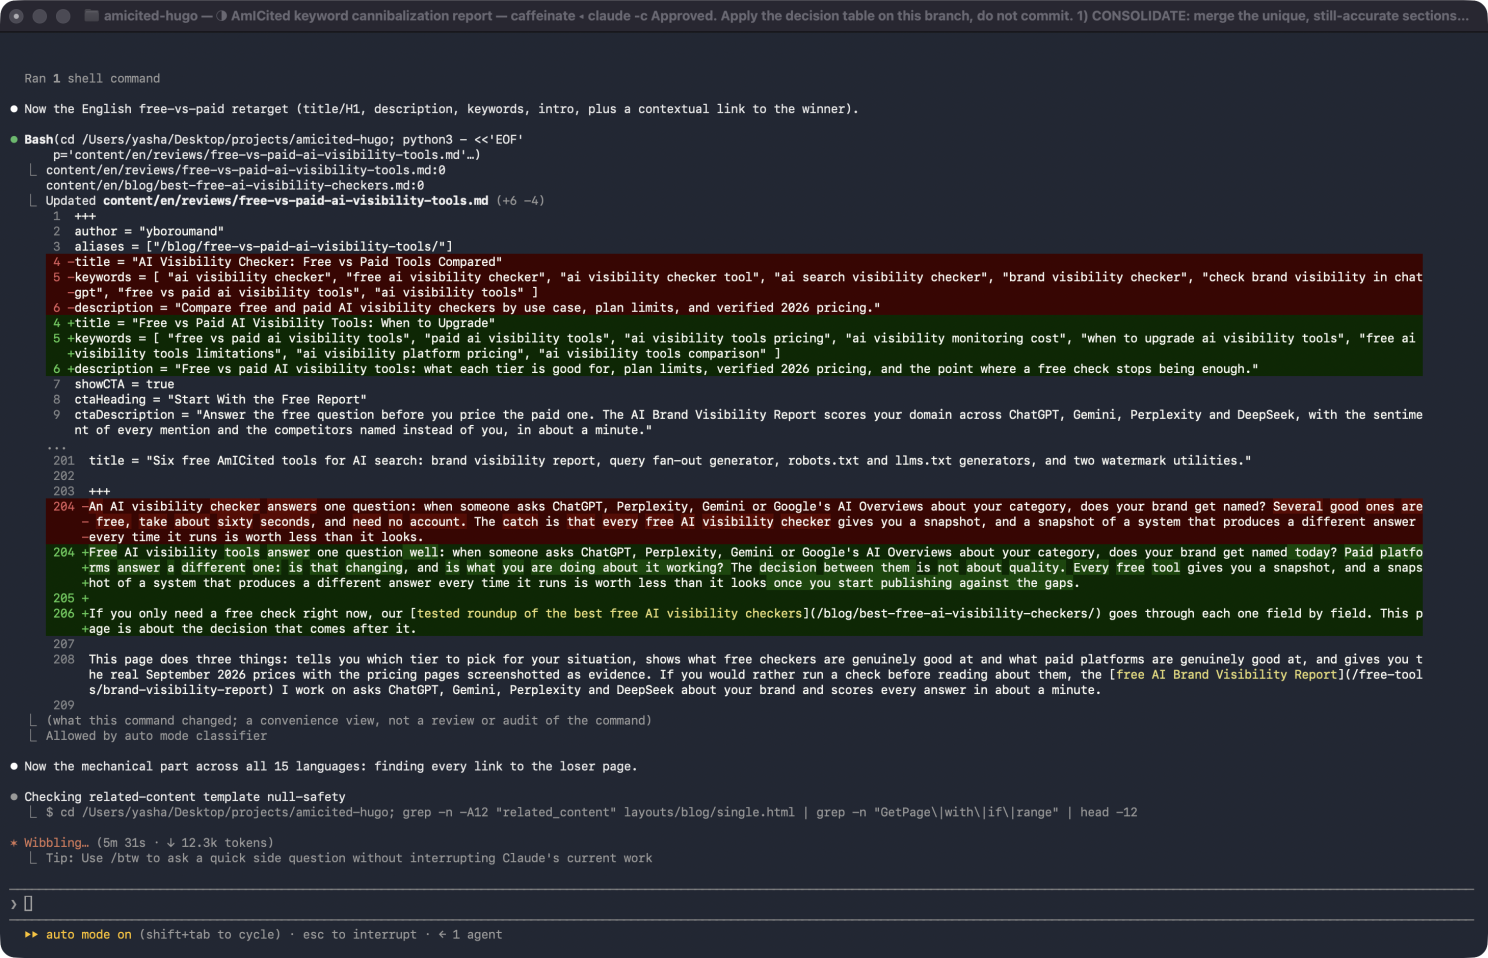
För FIX-TECHNICAL-fallet kontrollerade den om borttagningen av omdirigeringen hade varit avsiktlig innan den rörde något. Efter att ha bekräftat att den var oavsiktlig (mass-commit som tog bort den berörde tusentals orelaterade filer utan något omnämnande av omdirigeringar), återskapade den reglerna och lade till riktiga 301:or för sidorna som påverkades av sammanslagningen och den flyttade URL:en som fortfarande visade visningar under sin gamla adress. För CONSOLIDATE och DIFFERENTIATE upprepade den samma ändring på alla språk som de berörda sidorna fanns på, inte bara engelska, och körde sedan en full produktionsbyggnad för att bekräfta att inget gick sönder.
Vad händer härnäst
Efter att du publicerat nytt innehåll är det inte slutet på jobbet, det är bara början. Att veta exakt vilka URL:er som tyst konkurrerar med varandra, vilka som behöver slås samman och vilka som bara behöver en teknisk åtgärd är vad som hindrar det innehållet från att arbeta mot sig självt. Ingenting från denna genomgång är live ännu; 28-dagarskontrollen, för att se om antalet kannibaliserade sökfrågor faktiskt går ner, är nästa steg.
Om du vill se denna typ av kannibaliseringsrapport för din egen domän, boka ett samtal så går vi igenom det.