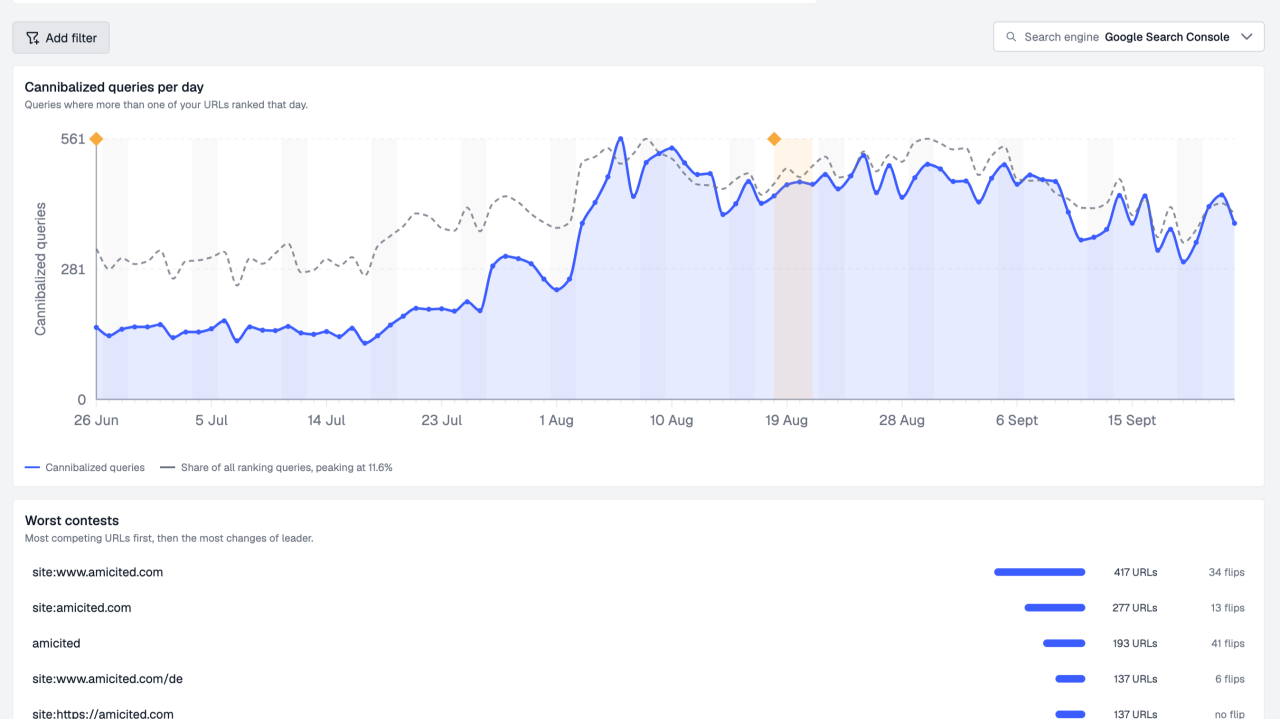
De la 140 la 561 de interogări canibalizate pe zi
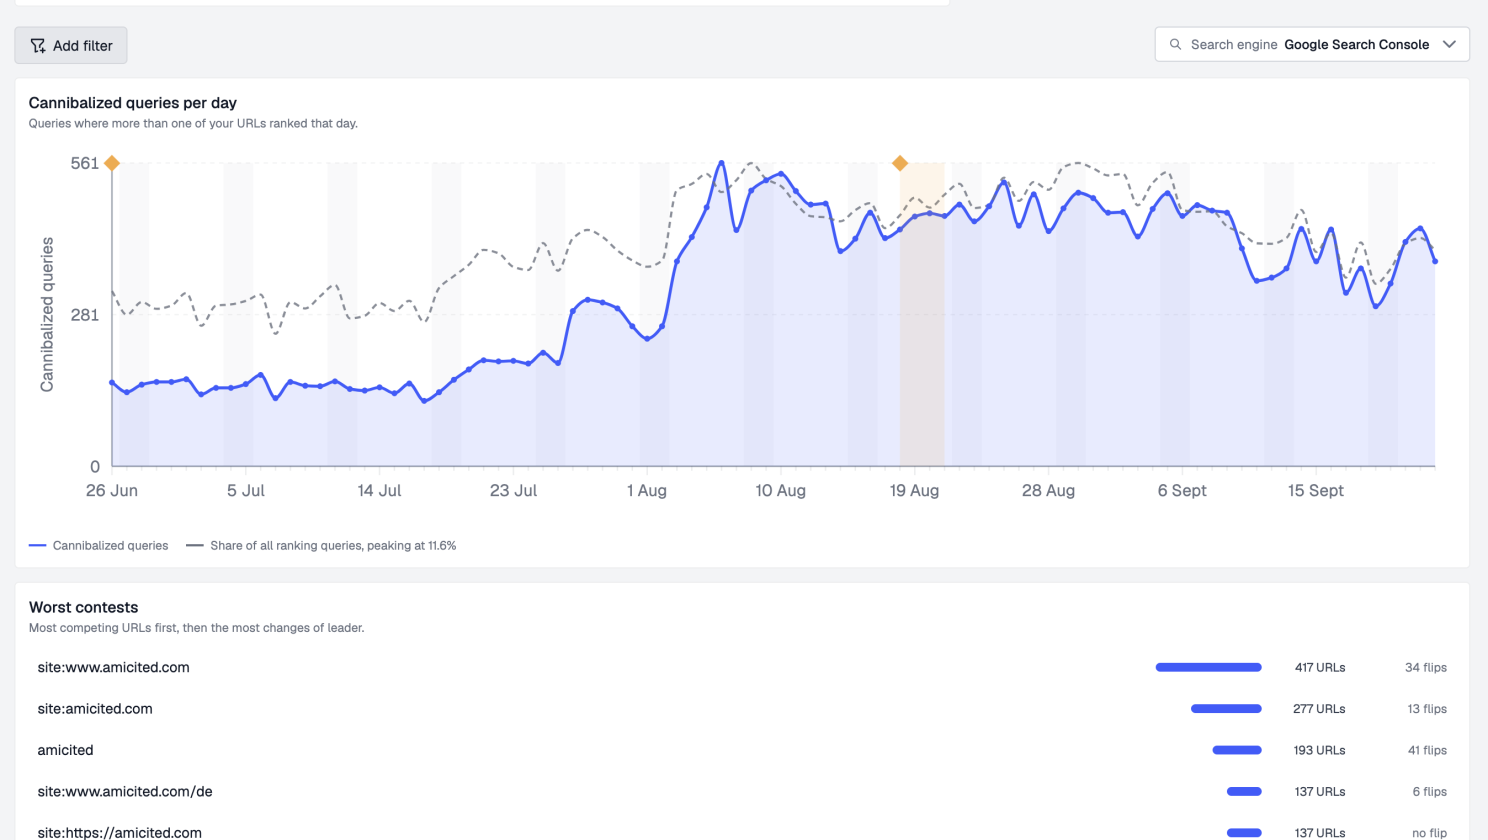
Între sfârșitul lui iunie și jumătatea lui august, numărul de interogări pentru care două sau mai multe URL-uri de pe amicited.com s-au clasat în aceeași zi a crescut de la aproximativ 140 pe zi la un vârf de 561. În cel mai rău moment, interogările canibalizate reprezentau 11,6% din tot ce se clasa site-ul.
Așa că am îndreptat Claude Code către depozitul Hugo al site-ului, l-am conectat la serverul MCP AmICited SEO și i-am cerut să găsească canibalizarea de cuvinte cheie, să decidă ce să facă cu fiecare caz și să aplice remedierea în toate cele 16 limbi în care site-ul este disponibil.
Aceasta este metoda de la cap la coadă: prompturile pe care le-am folosit, ce a apelat și făcut efectiv agentul și cele trei lucruri pe care le-a scos la iveală și despre care nu întrebasem niciodată. Nimic nu este încă publicat, așa că privește asta ca pe o prezentare a procesului, nu ca pe un articol de rezultate. Verificarea la 28 de zile urmează mai târziu.
Canibalizarea de cuvinte cheie apare atunci când două sau mai multe pagini de pe același site concurează pentru aceeași interogare de căutare, astfel încât Google tot schimbă pe care o afișează și niciuna nu se clasează la fel de bine cum ar face-o o singură pagină puternică. Este concurență internă între propriile tale URL-uri și este una dintre sarcinile SEO în care Claude Code își merită existența: datele trăiesc în Search Console, remedierea trăiește în depozit, iar un agent le poate ține pe amândouă simultan. (Nu o confunda cu canibalizarea conținutului AI, unde un răspuns generat de AI preia click-ul pe care pagina ta l-ar fi câștigat.) Dacă vrei analiza completă, am scris separat cum să identifici și să repari problemele de canibalizare a cuvintelor cheie.
Configurarea
- Depozit: depozitul site-ului meu Hugo, 500+ articole de blog în engleză, fiecare tradus în alte 15 limbi.
- Date: serverul MCP AmICited, care expune rapoarte SEO bazate pe Google Search Console, inclusiv canibalizarea, ca instrumente pe care Claude Code le poate apela direct.
- Agent: Claude Code (Opus 5.5) rulând în mod automat, pe un branch nou,
seo/cannibalization-oct-2026. Nimic nu este comis fără să citesc diferența mai întâi.
Conectarea serverului MCP este un pas OAuth unic: rulezi /mcp, alegi serverul, aprobi workspace-ul în browser, iar Claude Code îl poate apela de atunci înainte.
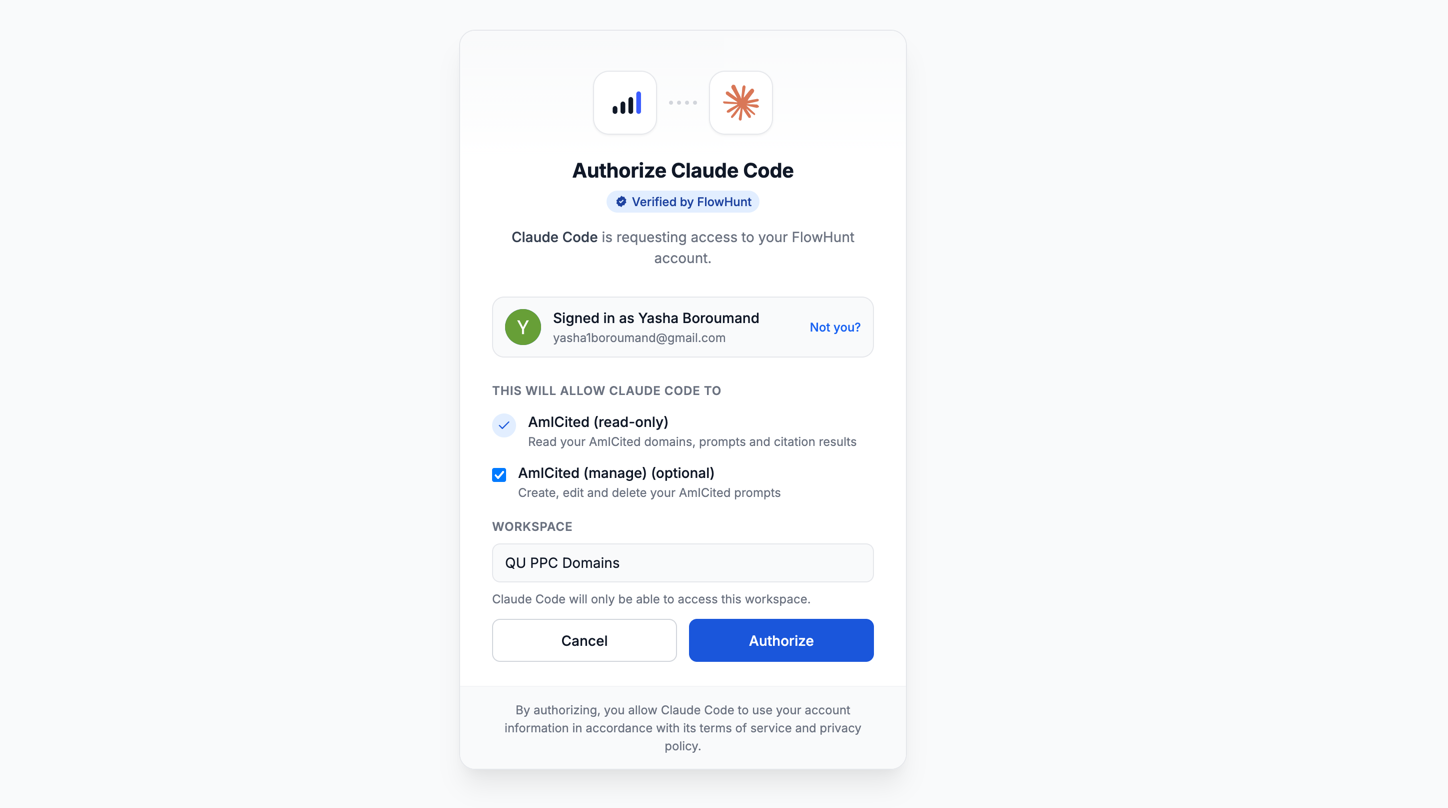
Un lucru util de știut de la început: workspace-ul meu AmICited are mai multe domenii. Fiecare prompt pe care l-am scris menționa amicited.com explicit, iar primul i-a cerut lui Claude Code să îmi spună ce ID de domeniu a ales. Sari peste acest pas și ai încredere că agentul ghicește corect.

Ready to Monitor Your AI Visibility?
Track how AI chatbots mention your brand across ChatGPT, Perplexity, and other platforms.
Pasul 1: Găsește canibalizarea, elimină zgomotul
Folosește serverul MCP AmICited pentru a extrage raportul de canibalizare a cuvintelor cheie doar pentru domeniul amicited.com (workspace-ul are mai multe domenii, alege-l pe cel pentru amicited.com și spune-mi ce ID de domeniu/proiect ai folosit). Folosește date din Google Search Console, ultimele 90 de zile. Mai întâi listează instrumentele MCP pe care le apelezi. Exclude zgomotul: interogări cu operatori de căutare (site:, inurl:), interogări pure de brand/navigaționale („amicited”, „am i cited”) și interogări sub 50 de impresii. Arată primele 15 clustere reale de canibalizare ca tabel […] Nu edita niciun fișier.
Filtrul de zgomot există din cauza modului în care arată raportul brut. Lista „Celor mai grave concursuri” din dashboard-ul meu era condusă de site:www.amicited.com (417 URL-uri), site:amicited.com (277 URL-uri) și interogarea de brand simplă amicited (193 URL-uri). Asta nu este canibalizare. Sunt eu, și probabil propria mea echipă, căutând site-ul direct. Orice instrument care numără asta ca un cluster de canibalizare numără lucrul greșit.
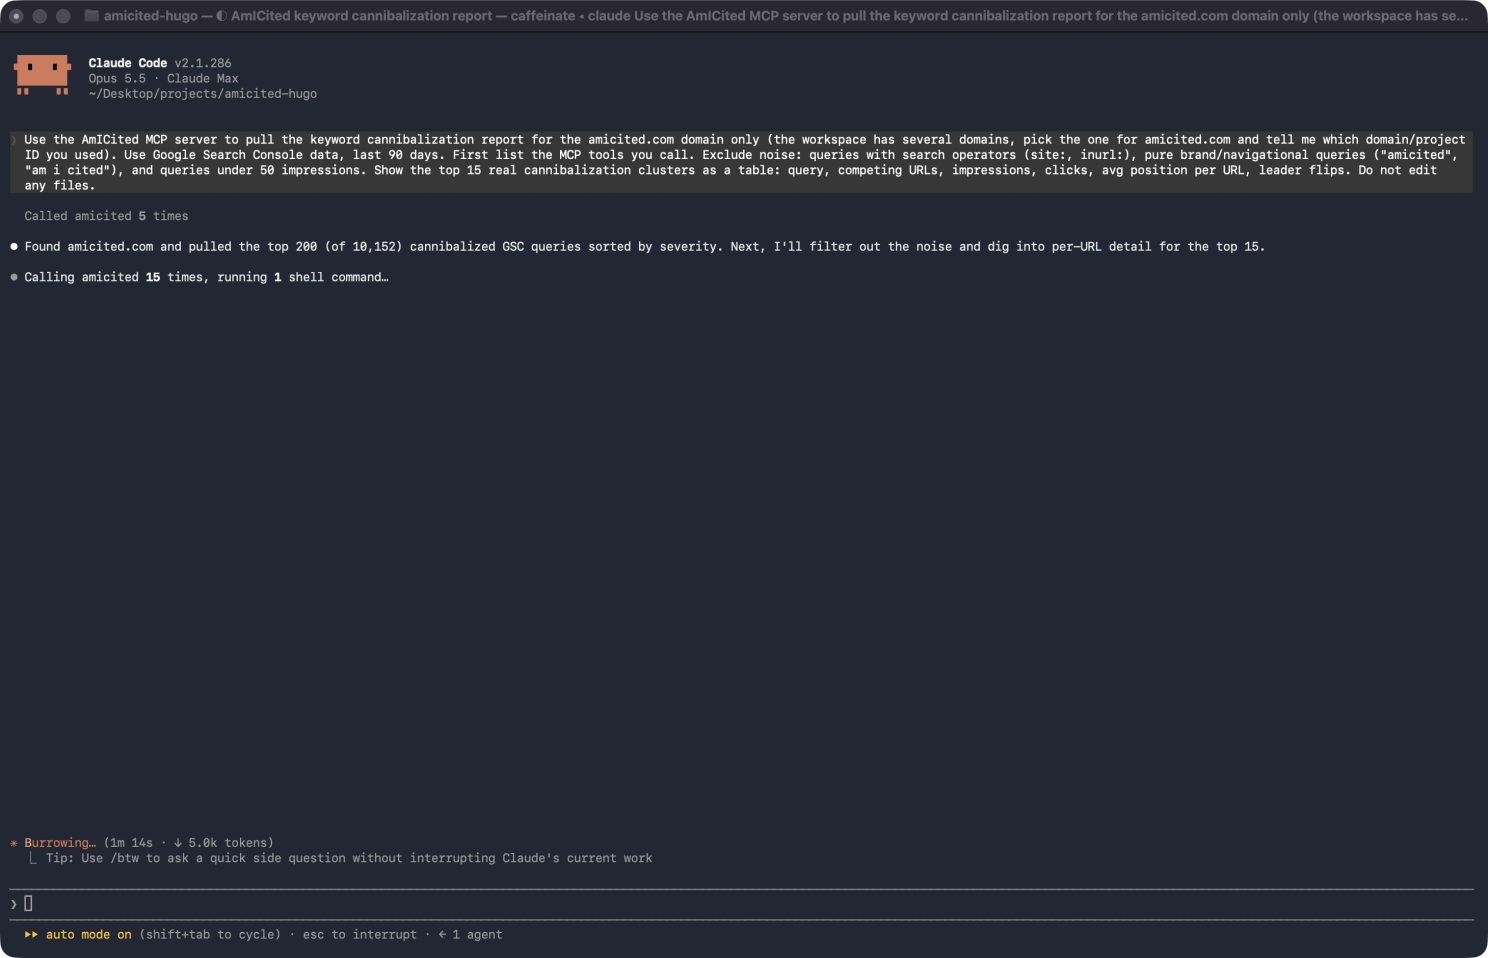
Ce a făcut, în ordine:
list_domains, pentru a găsi amicited.com printre domeniile din workspace (și a raporta ID-ul de domeniu folosit).search_tools, deoarece instrumentele de canibalizare nu erau în lista sa implicită de instrumente, așa că le-a căutat după descriere.describe_tool, de două ori, pentru a citi schemele de intrare pentru cele două instrumente de interogare a canibalizării înainte de a le apela.- Instrumentul de listare a clusterelor, o dată: primele 200 de interogări după severitate, din peste 10.000 de interogări canibalizate în fereastra de 90 de zile.
- Instrumentul de detalii per-interogare, de 15 ori, o dată per cluster, extrăgând URL-urile concurente și pozițiile lor zilnice. Un răspuns era prea mare pentru a fi afișat inline, așa că a salvat rezultatul pe disc și l-a rezumat cu
jq.
Apoi a filtrat. Aproximativ 30 din primele 200 erau interogări de tip site:. Din proprie inițiativă, a adăugat încă două filtre și mi-a spus că a făcut-o: interogări lungi, cu formă de prompt, cu mii de impresii și zero click-uri (arătau ca prompturi de instrumente de urmărire AI copiate text, nu oameni reali căutând) și câteva interogări cu aspect de cod care păreau trafic de boți.
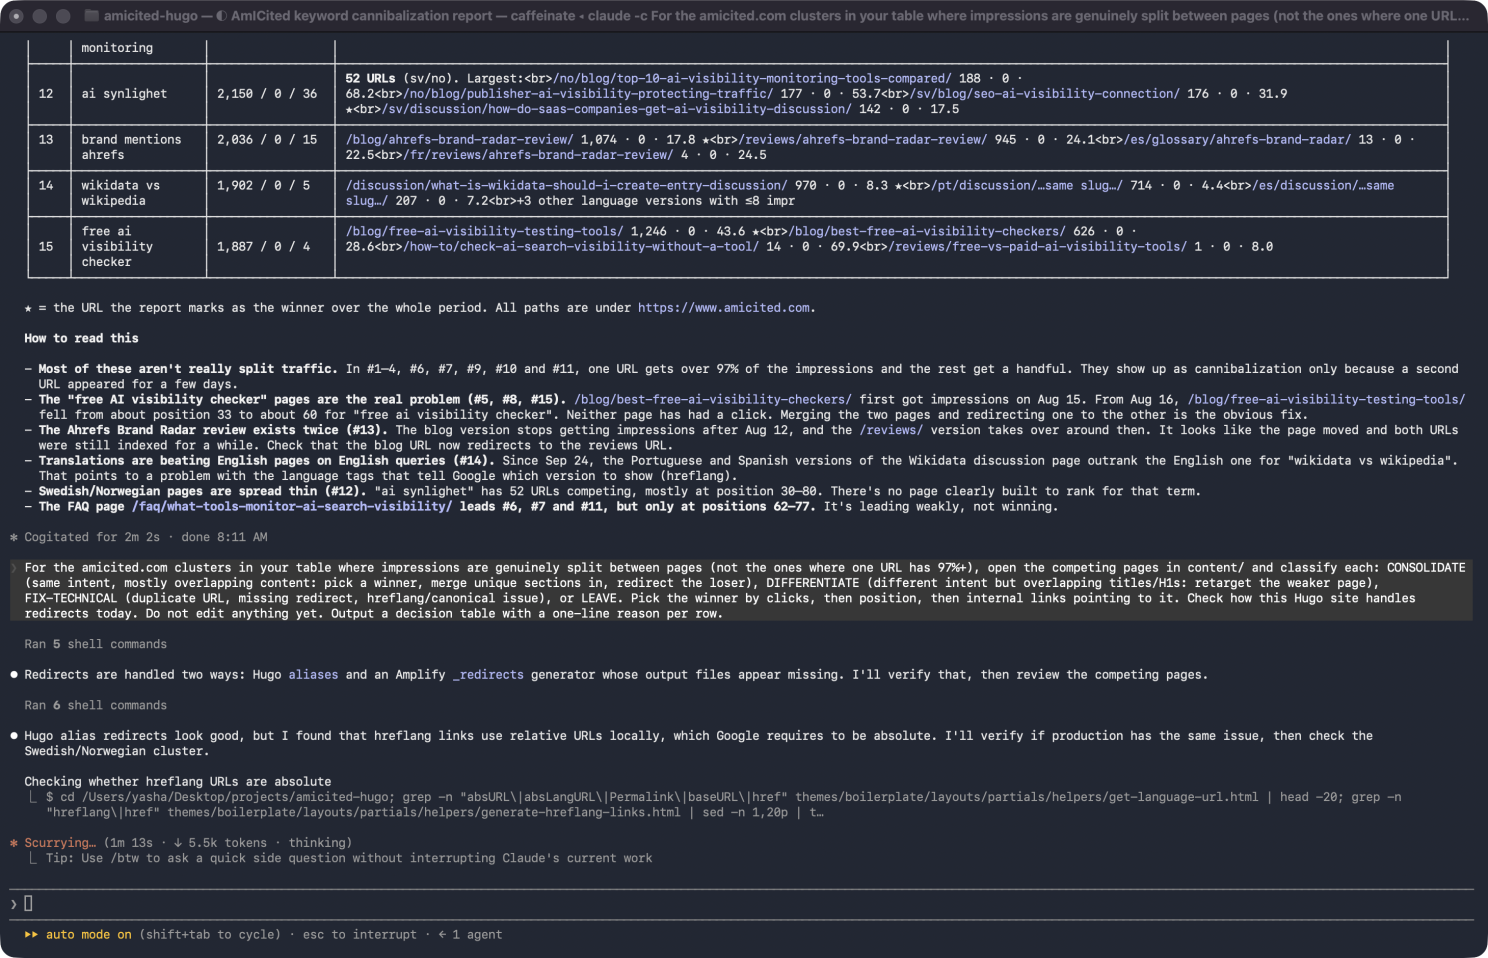
Cea mai utilă linie din rezultat nu era tabelul în sine. Era aceasta:
Cele mai multe dintre acestea nu sunt trafic divizat real. În nouă din primele cincisprezece clustere, un URL primește peste 97% din impresii, iar restul primesc o mână.
Nouă din primele cincisprezece clustere de „canibalizare” erau o singură pagină care făcea practic toată munca, cu un al doilea URL care apăruse pentru câteva zile și nimic mai mult. Un raport sortat pur după severitate nu îți va spune asta. Citirea divizării per-URL o face.
Pasul 2: Diagnostichează înainte de reparare
Pentru clusterele din tabelul tău unde impresiile sunt divizate real între pagini (nu cele unde un URL are 97%+), deschide paginile concurente în content/ și clasifică fiecare: CONSOLIDEAZĂ, DIFERENȚIAZĂ, REPARĂ-TEHNIC sau LASĂ. Alege câștigătorul după click-uri, apoi poziție, apoi linkuri interne care punctează către el. Verifică cum gestionează acest site Hugo redirecționările astăzi. Nu edita încă nimic. Afișează un tabel de decizii cu un motiv de o linie per rând.
Acest pas nu a făcut deloc apeluri MCP. A fost vorba de aproximativ 20 de comenzi shell: citirea fișierelor Markdown concurente, numărarea linkurilor interne către fiecare pagină, citirea șabloanelor temei și rularea curl împotriva site-ului live pentru a vedea ce returnau redirecționările și tag-urile hreflang în producție, nu doar în depozit.
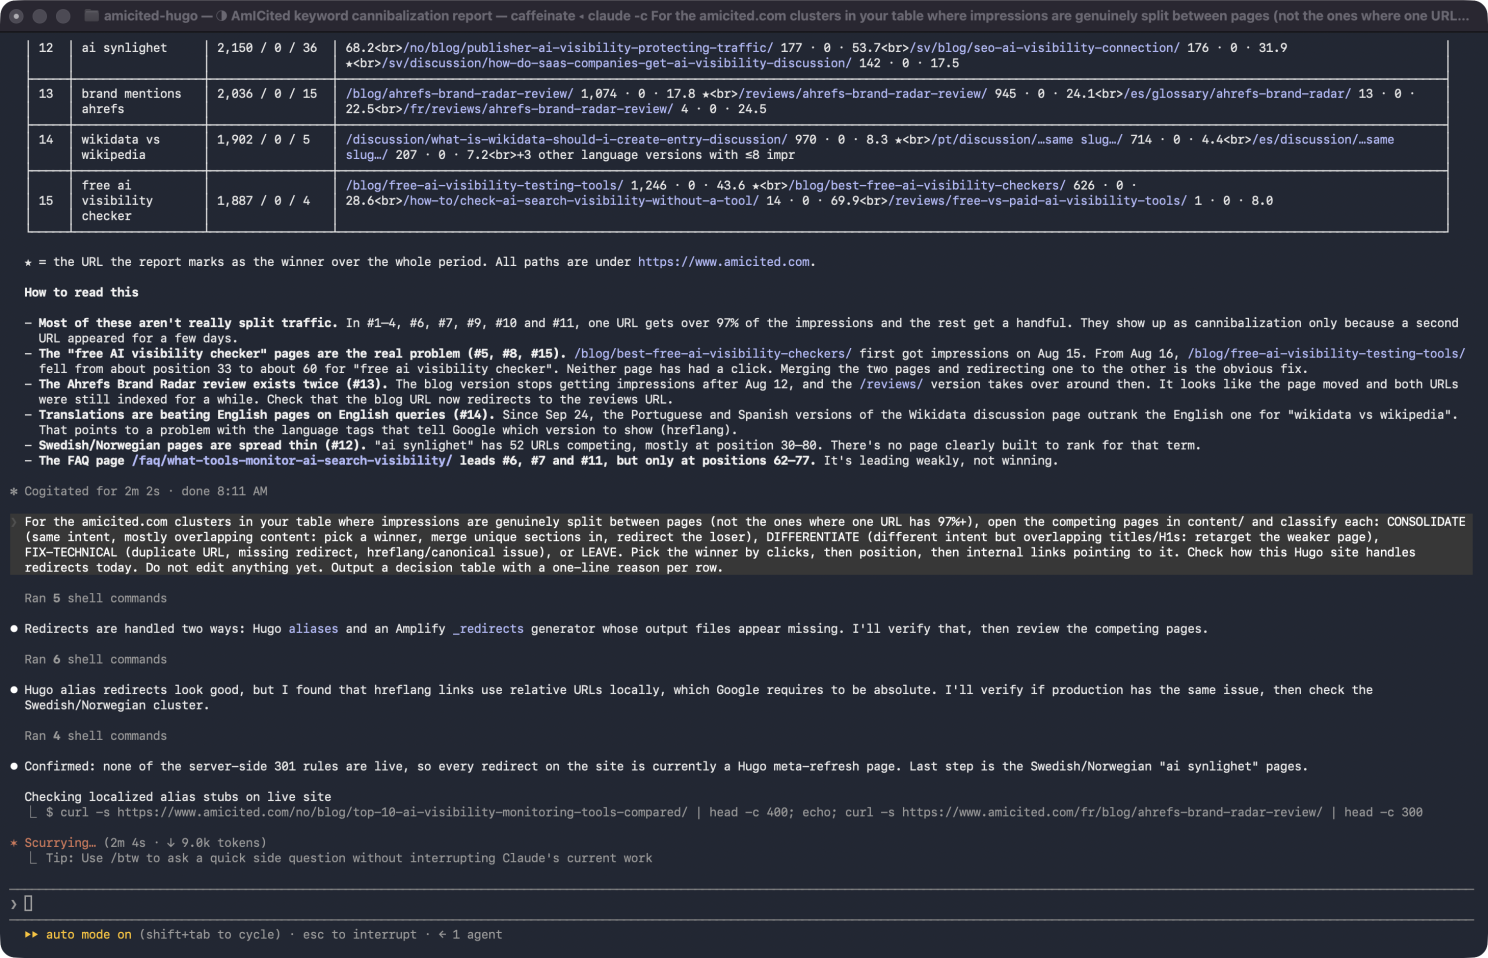
Din cele cincisprezece clustere, unul necesita o fuziune, unul necesita o reorientare, două necesitau o reparație tehnică, iar restul nu necesitau nimic. Acest raport este motivul principal pentru care nu aș lăsa niciodată un agent să sară direct de la „iată un raport de canibalizare” la „iată paginile pe care le-am șters”.
Trei descoperiri pe care nu le-am cerut
1. Regulile mele de redirecționare 301 încetaseră să mai funcționeze în tăcere cu două luni mai devreme. Site-ul meu are un script care generează reguli 301 reale pentru Amplify. Claude Code a observat că fișierul de ieșire nu exista, a mers înapoi prin istoricul git și a descoperit că fusese șters cu cinci săptămâni mai devreme într-un commit de „actualizare conținut” care a atins peste 21.000 de fișiere, daune colaterale de la o sincronizare în masă, nu o decizie luată intenționat de cineva. A confirmat pe site-ul live că niciuna dintre reguli nu era activă (un URL mutat returna un 404 acolo unde ar fi trebuit să fie o redirecționare). De atunci, fiecare „redirecționare” de pe site fusese de fapt un alias Hugo: o pagină cu cod 200 și meta reîmprospătare, nu un 301 real.
2. Asta nu era doar teoretic. URL-ul vechi al unei pagini pe care o mutasem în iulie încă apărea pe cont propriu în Search Console, 188 de impresii și în creștere, la două luni și jumătate după mutare. Un stub cu meta reîmprospătare pe care Google continuă să îl indexeze oricum este exact cum arată o configurație de alias stricată în practică.
3. Și-a prins propria greșeală. În pasul 1, semnalase o pereche de pagini ca posibilă problemă hreflang, deoarece o versiune tradusă devansa originalul în engleză. În pasul 2, a preluat HTML-ul live, a verificat că tag-urile hreflang erau absolute și reciproce așa cum cere Google și a raportat că asta corecta ceea ce spusese prima dată. Constatarea s-a mutat de la REPARĂ la LASĂ. Prefer mult să primesc asta decât un răspuns greșit încrezător care rămâne necontestat într-un raport.
Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Pasul 3: Aplică remedierea în 16 limbi
Aprobat. Aplică tabelul de decizii pe acest branch, nu face commit. 1) CONSOLIDEAZĂ […] fără a inventa fapte sau a adăuga linii de dialog, apoi șterge pierzătorul în fiecare limbă în care există, adaugă URL-ul său vechi în aliases-ul câștigătorului în fiecare limbă corespunzătoare și reorientează toate linkurile interne către pierzător din content/. 2) DIFERENȚIAZĂ […] în toate limbile și adaugă un link contextual către câștigător. 3) REPARĂ-TEHNIC: verifică istoricul git pentru a vedea dacă ștergerea static/_redirects a fost deliberată. Dacă a fost accidentală, regenerază-le […] Dacă a fost deliberată, nu restaura, doar spune-mi.
A verificat corectitudinea faptelor înainte de a fuziona ceva. Pagina care era retrasă avea secțiuni pe care câștigătorul nu le avea: o mențiune a unui instrument concurent, o funcție de clasare a produselor și o listă de perioade de încercare gratuită. Înainte de a transfera orice mai departe, Claude Code a preluat site-urile live ale furnizorilor pentru a verifica dacă informațiile erau încă corecte.
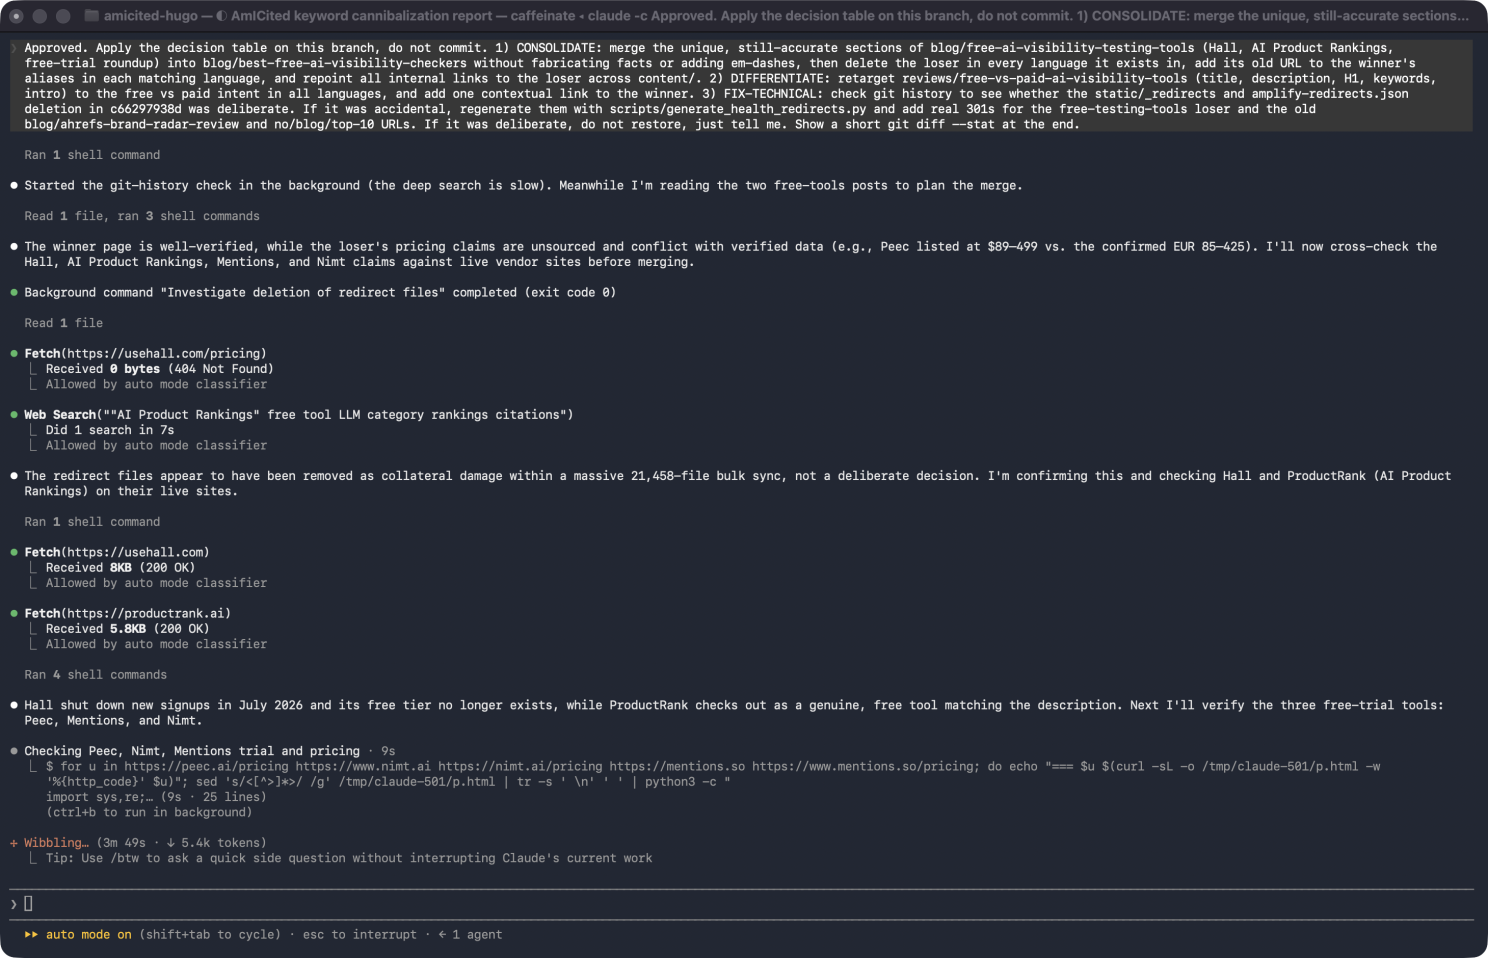
Unul dintre instrumentele menționate s-a dovedit a fi fost achiziționat și închis pentru înscrieri noi cu săptămâni în urmă, așa că asta a devenit o corecție în loc de ceva copiat înainte ca fapt curent. Afirmația de preț a paginii retrase pentru un alt instrument era, de asemenea, în conflict cu cifra deja verificată pe pagina câștigătoare, așa că cifra verificată a rămas și cea învechită nu a intrat în fuziune.
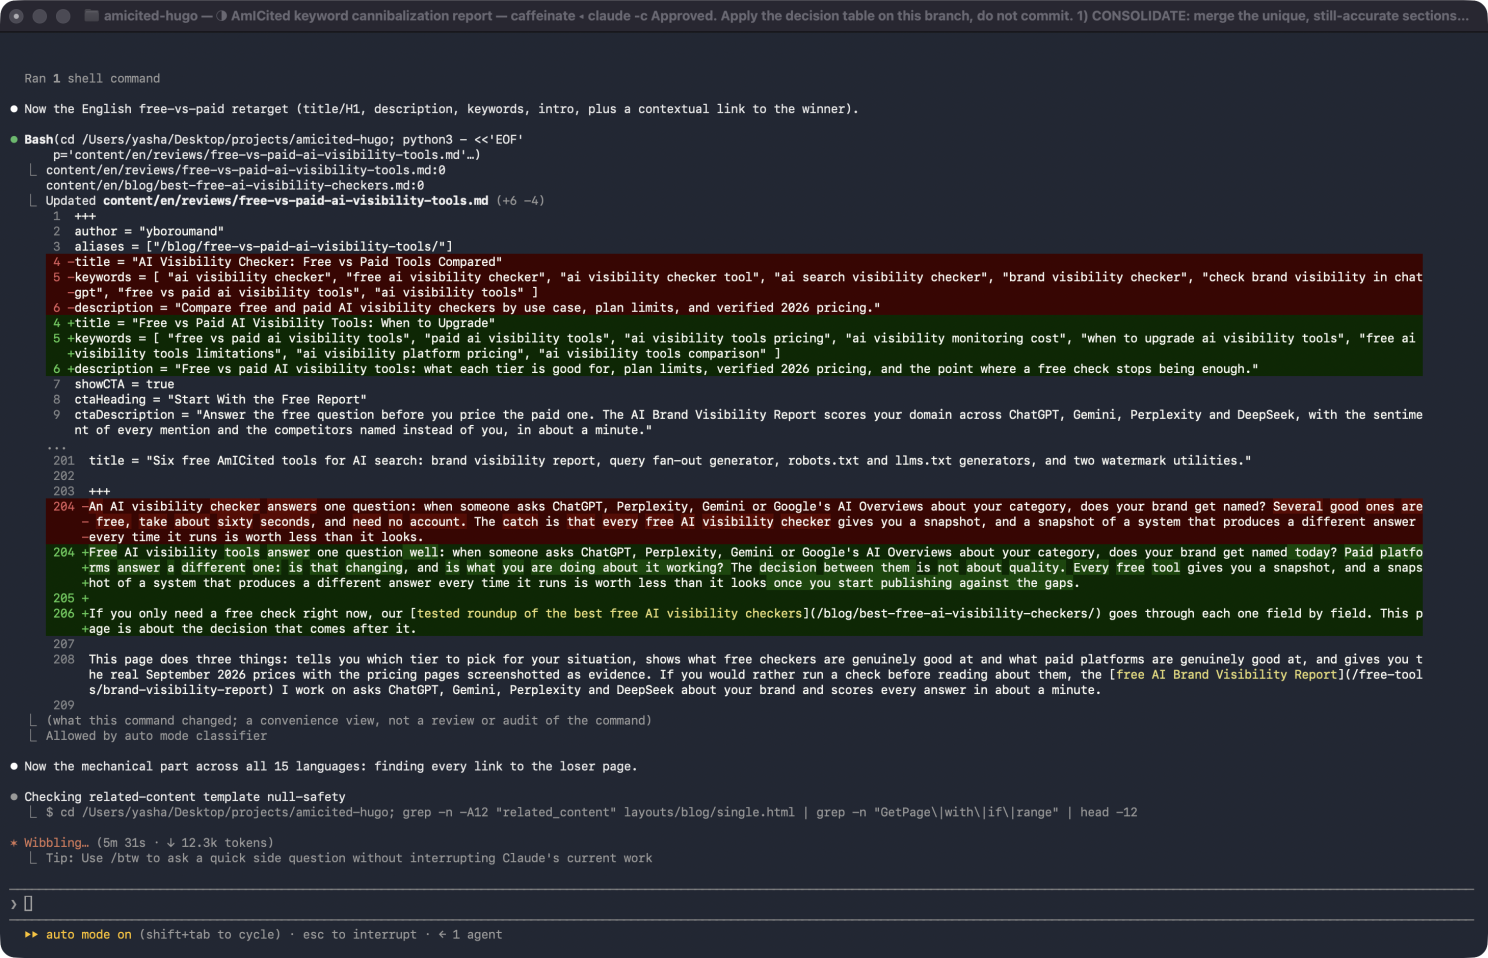
Pentru cazul REPARĂ-TEHNIC, a verificat dacă ștergerea redirecționării fusese deliberată înainte de a atinge ceva. Confirmând că fusese accidentală (commit-ul masiv care a eliminat-o a atins mii de fișiere neînrudite, fără nicio mențiune despre redirecționări), a regenerat regulile și a adăugat 301-uri reale pentru paginile afectate de fuziune și pentru URL-ul mutat care încă arăta impresii sub adresa sa veche. Pentru CONSOLIDEAZĂ și DIFERENȚIAZĂ, a repetat aceeași modificare în fiecare limbă în care paginile afectate existau, nu doar în engleză, apoi a rulat o construcție completă de producție pentru a confirma că nimic nu s-a stricat.
Ce urmează
După ce publici conținut nou, asta nu este sfârșitul treburii, ci doar începutul. Să știi exact care URL-uri concurează în tăcere între ele, care trebuie fuzionate și care au nevoie doar de o reparație tehnică este ceea ce împiedică acel conținut să lucreze împotriva sa. Nimic din această trecere nu este încă live; verificarea la 28 de zile, pentru a vedea dacă numărul de interogări canibalizate scade efectiv, este următoarea.
Dacă vrei să vezi acest tip de raport de canibalizare pe propriul tău domeniu, programează un apel și vom trece prin el împreună.