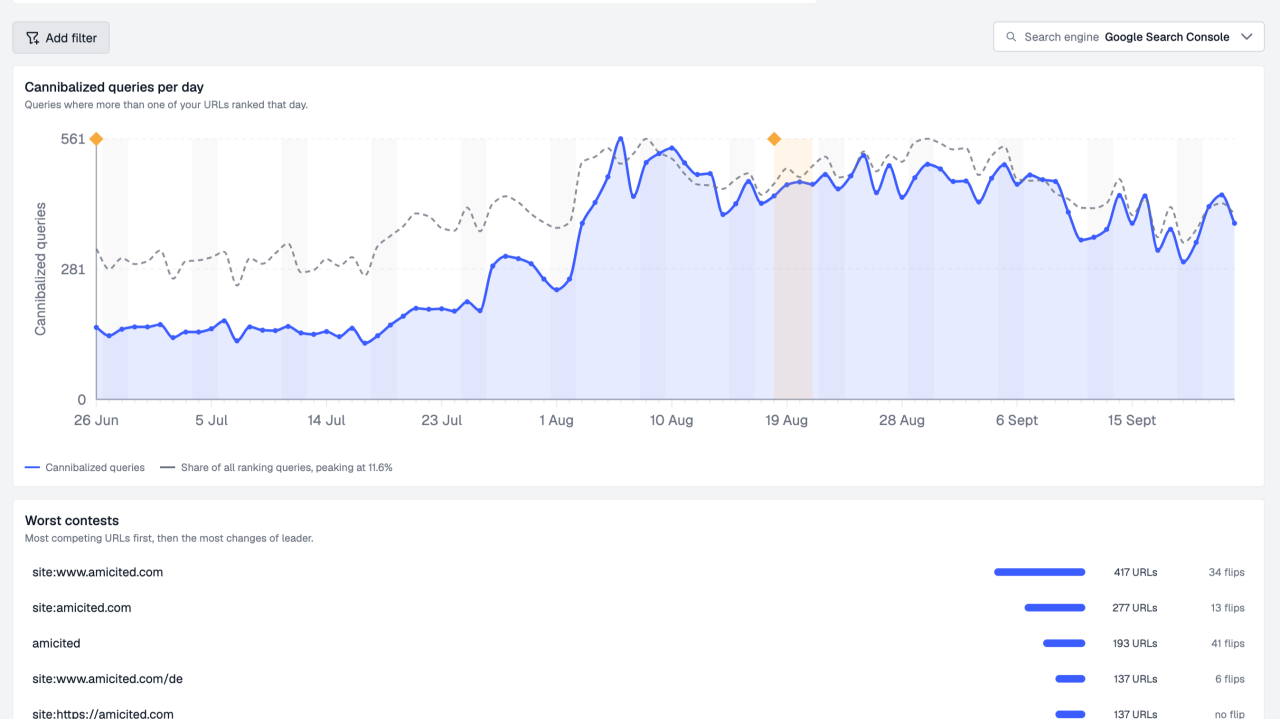
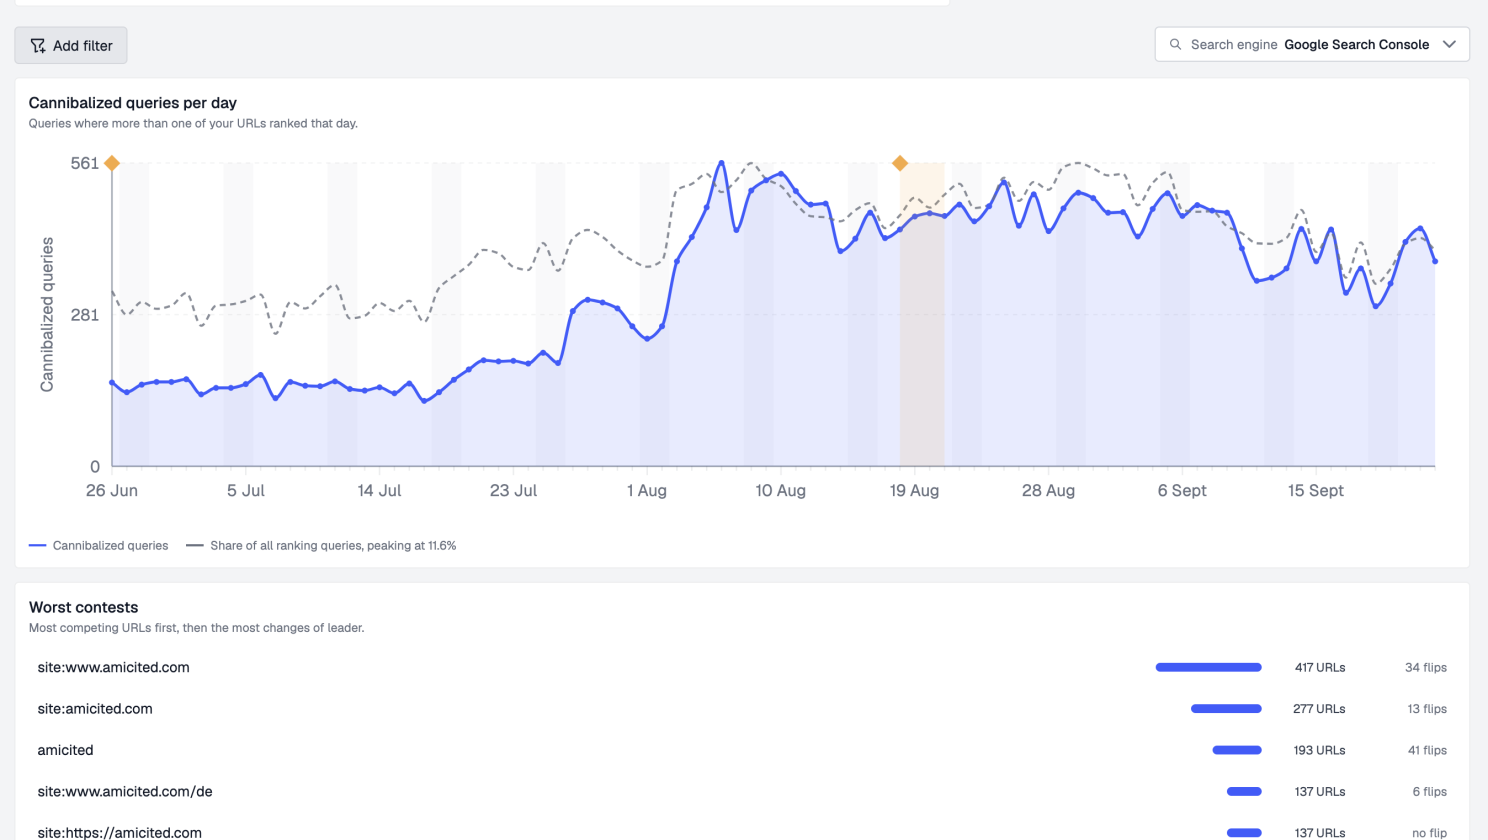
De 140 a 561 Consultas Canibalizadas por Dia
Entre o final de junho e meados de agosto, o número de consultas onde duas ou mais URLs do amicited.com ranqueavam no mesmo dia subiu de cerca de 140 por dia para um pico de 561. No pior momento, consultas canibalizadas representavam 11,6% de tudo para que o site ranqueava.
Então apontei o Claude Code para o repositório Hugo do site, conectei-o ao servidor MCP de SEO AmICited e pedi para encontrar a canibalização de palavras-chave, decidir o que fazer em cada caso e aplicar a correção em todos os 16 idiomas que o site oferece.
Este é o método completo: os prompts que usei, o que o agente realmente chamou e fez, e as três coisas que ele descobriu que eu nunca perguntei. Nada disso está implantado ainda, então considere isto uma demonstração do processo, não um post de resultados. A reavaliação de 28 dias vem depois.
Canibalização de palavras-chave é quando duas ou mais páginas no mesmo site competem pela mesma consulta de pesquisa, então o Google fica alternando qual delas exibir e nenhuma ranqueia tão bem quanto uma única página forte conseguiria. É competição interna entre suas próprias URLs, e é um dos trabalhos de SEO onde o Claude Code mostra seu valor: os dados estão no Search Console, a correção está no repositório, e um agente pode lidar com ambos ao mesmo tempo. (Não confunda com canibalização de conteúdo por IA, onde uma resposta gerada por IA rouba o clique que sua página teria conquistado.) Se você quiser a análise completa, escrevemos sobre como identificar e corrigir problemas de canibalização de palavras-chave separadamente.
A Configuração
- Repositório: o repositório do meu site Hugo, com mais de 500 posts de blog em inglês, cada um traduzido para outros 15 idiomas.
- Dados: o servidor MCP AmICited, que expõe relatórios de SEO baseados no Google Search Console, incluindo canibalização, como ferramentas que o Claude Code pode chamar diretamente.
- Agente: Claude Code (Opus 5.5) rodando em modo automático, em um branch novo,
seo/cannibalization-oct-2026. Nada é commitado sem eu ler o diff primeiro.
Conectar o servidor MCP é uma etapa única de OAuth: execute /mcp, escolha o servidor, aprove o workspace no navegador, e o Claude Code pode chamá-lo a partir de então.
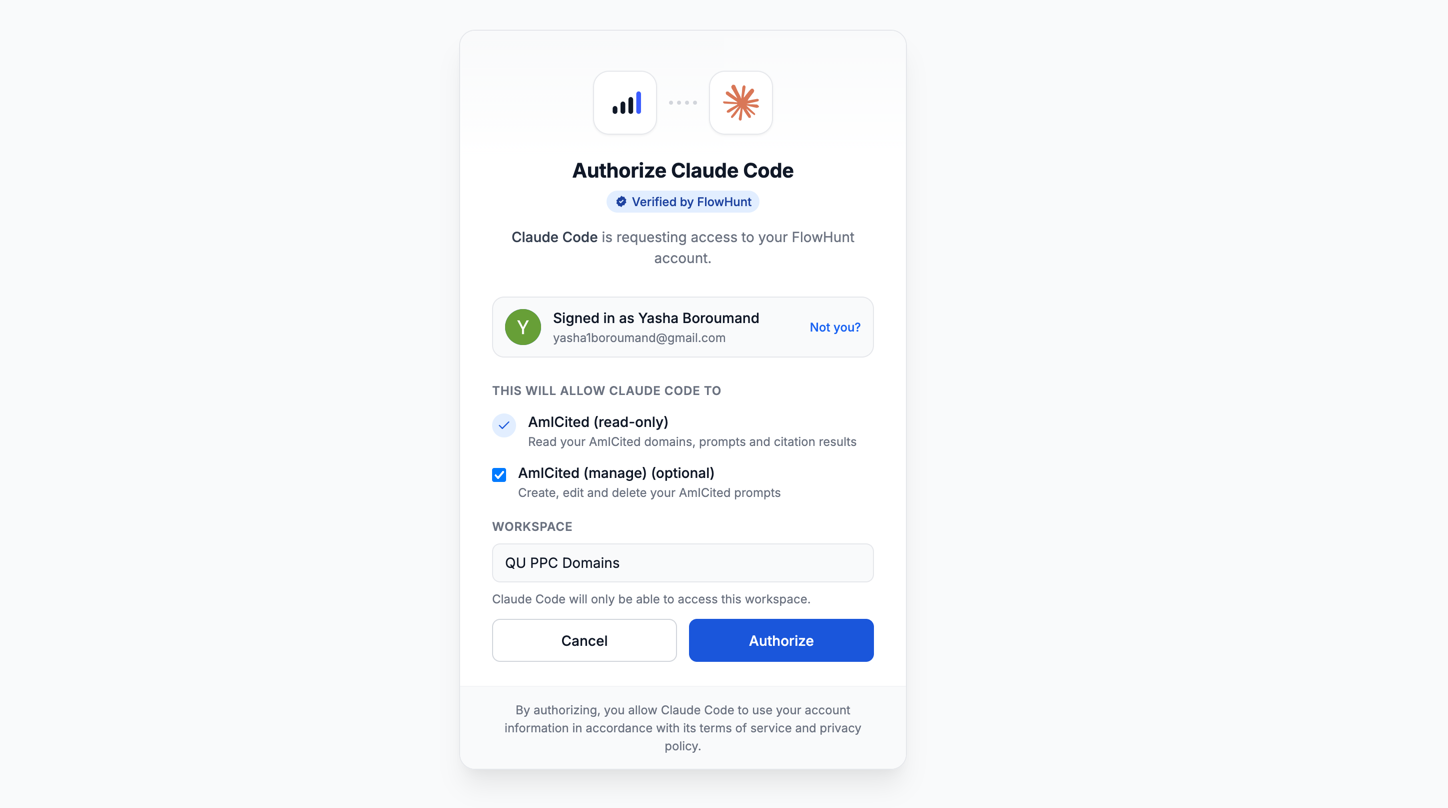
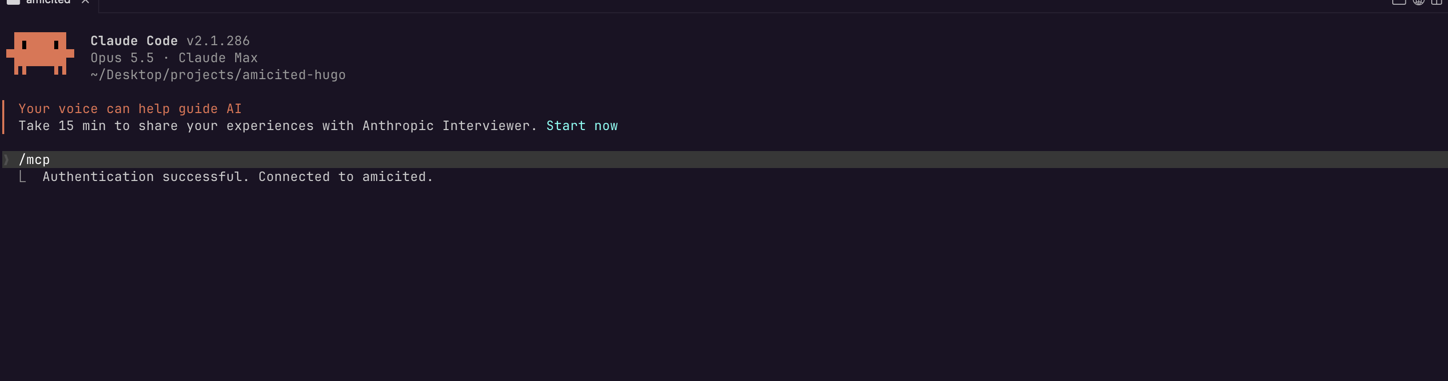
Uma coisa que vale a pena saber de antemão: meu workspace AmICited tem vários domínios. Cada prompt que escrevi nomeava amicited.com explicitamente, e o primeiro pediu ao Claude Code para me dizer qual ID de domínio ele escolheu. Pule essa etapa e você estará confiando que o agente adivinhe corretamente.
Passo 1: Encontrar a Canibalização, Filtrar o Ruído
Use o servidor MCP AmICited para extrair o relatório de canibalização de palavras-chave apenas para o domínio amicited.com (o workspace tem vários domínios, escolha o do amicited.com e me diga qual ID de domínio/projeto você usou). Use dados do Google Search Console, últimos 90 dias. Primeiro liste as ferramentas MCP que você chama. Exclua ruído: consultas com operadores de pesquisa (site:, inurl:), consultas puramente de marca/navegacionais (“amicited”, “am i cited”) e consultas com menos de 50 impressões. Mostre os 15 principais clusters reais de canibalização como uma tabela […] Não edite nenhum arquivo.
O filtro de ruído existe por causa da aparência real do relatório bruto. A lista de “Piores confrontos” no meu painel era liderada por site:www.amicited.com (417 URLs), site:amicited.com (277 URLs) e a consulta de marca pura amicited (193 URLs). Isso não é canibalização. Isso sou eu, e provavelmente minha própria equipe, pesquisando o site diretamente. Qualquer ferramenta que conta isso como um cluster de canibalização está contando a coisa errada.
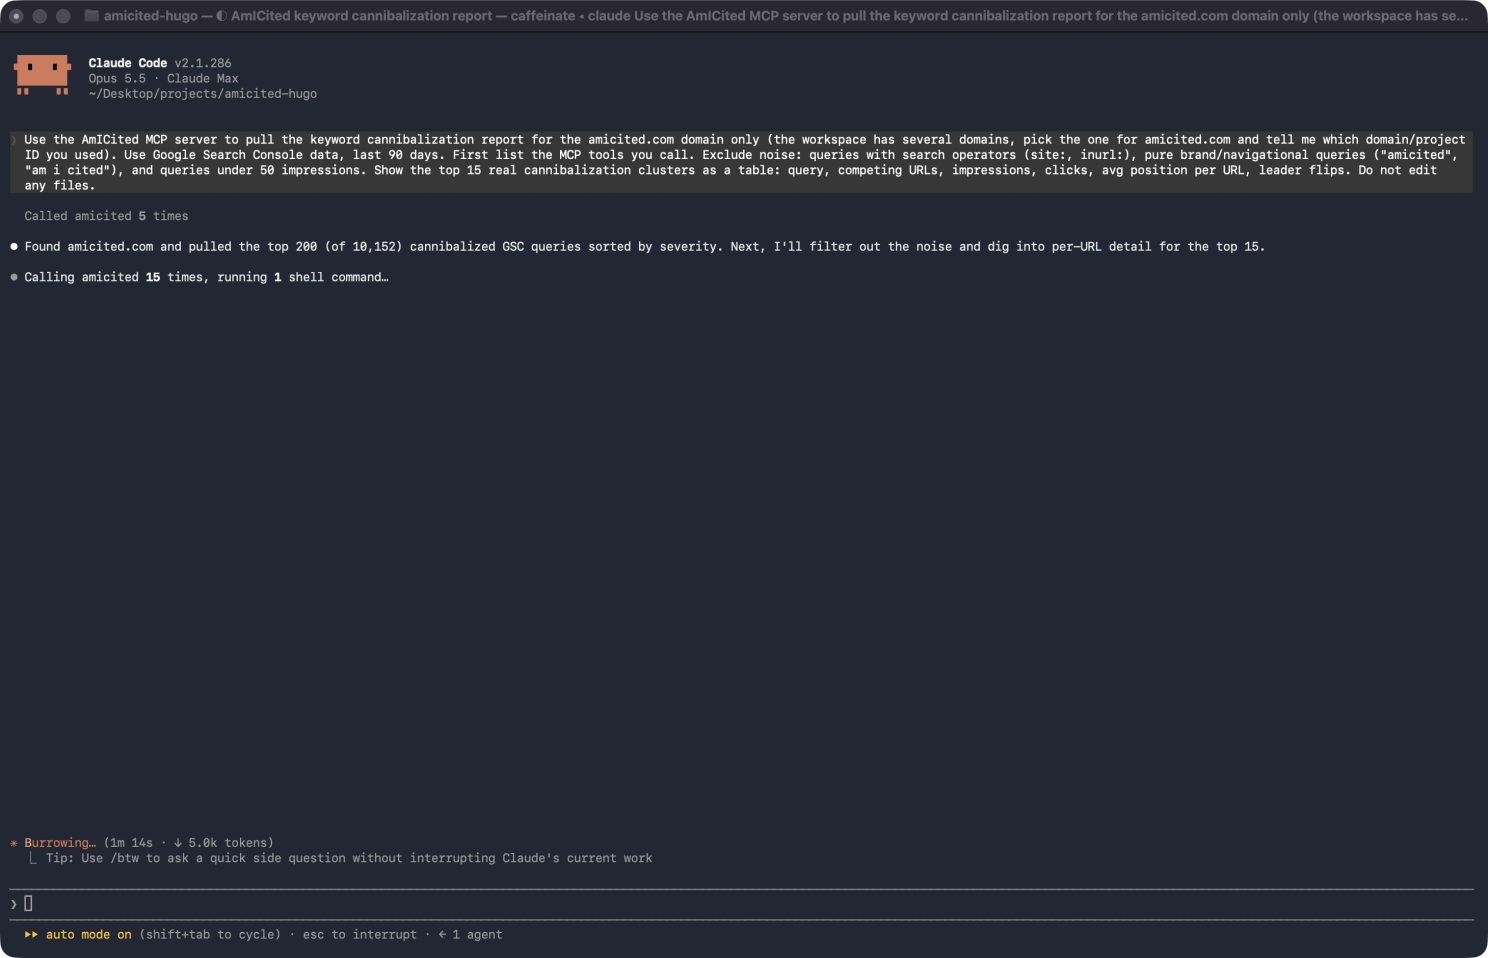
O que ele fez, em ordem:
list_domains, para encontrar amicited.com entre os domínios no workspace (e reportar o ID de domínio que usou).search_tools, porque as ferramentas de canibalização não estavam em sua lista de ferramentas padrão, então ele as procurou por descrição.describe_tool, duas vezes, para ler os esquemas de entrada das duas ferramentas de consulta de canibalização antes de chamá-las.- A ferramenta de lista de clusters, uma vez: as 200 principais consultas por gravidade, de mais de 10.000 consultas canibalizadas na janela de 90 dias.
- A ferramenta de detalhes por consulta, 15 vezes, uma por cluster, extraindo as URLs concorrentes e suas posições diárias. Uma resposta era grande demais para exibir inline, então ele salvou a saída em disco e a resumiu com
jq.
Então ele filtrou. Cerca de 30 das 200 principais eram consultas site:. Por iniciativa própria, ele adicionou mais dois filtros e me disse que havia feito isso: consultas longas em formato de prompt com milhares de impressões e zero cliques (pareciam prompts de ferramentas de rastreamento de IA copiados literalmente, não pessoas reais pesquisando), e algumas consultas com aparência de código que pareciam tráfego de bot.
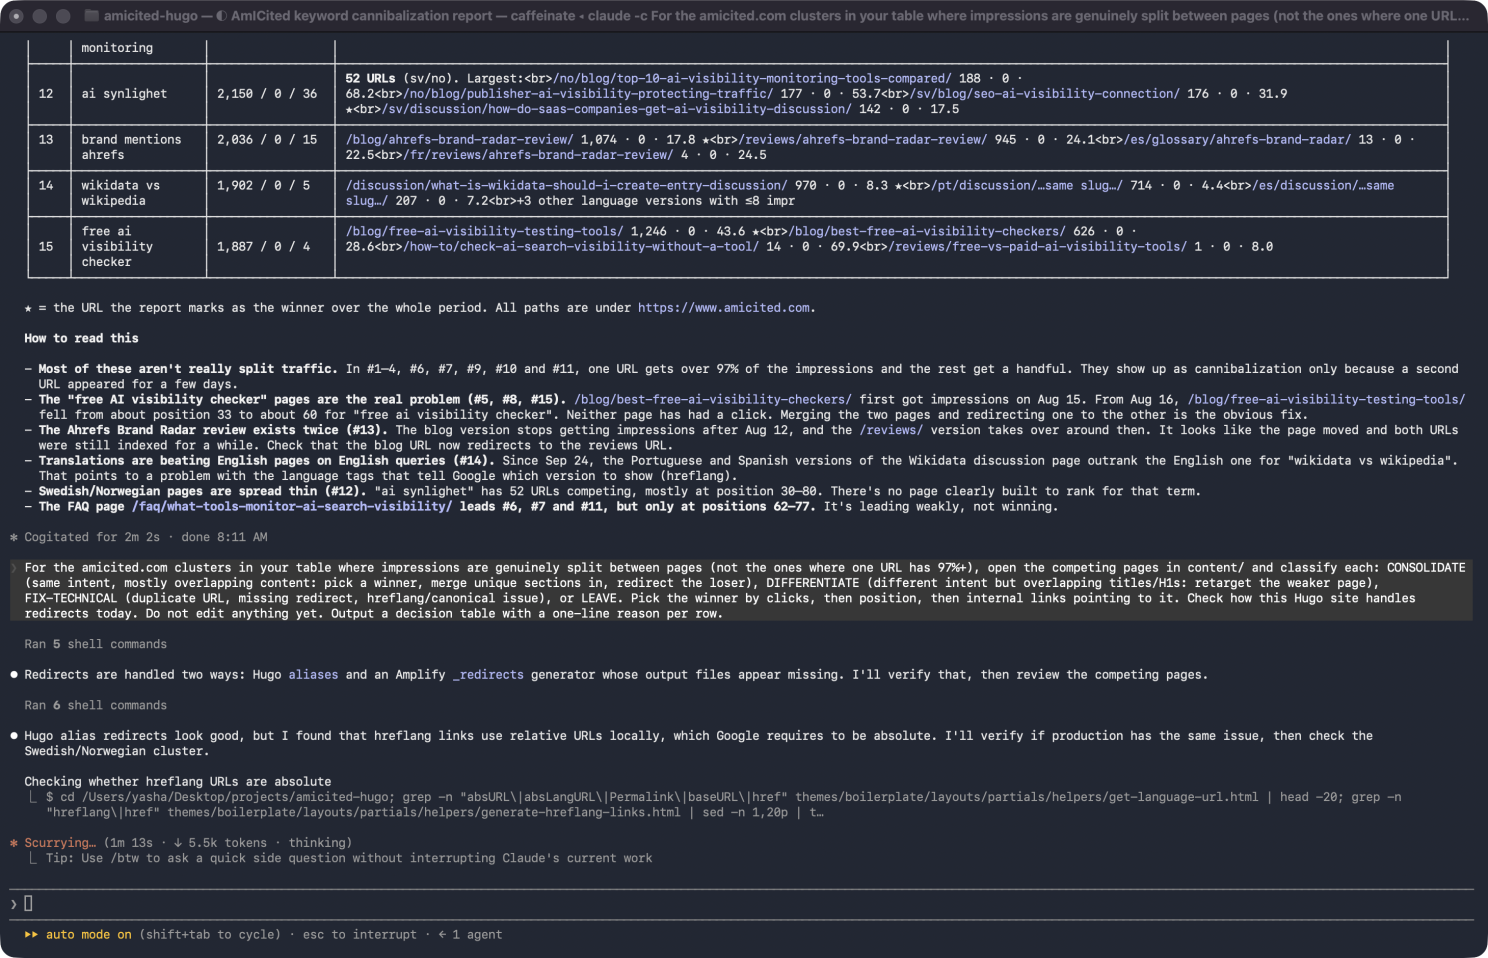
A linha mais útil na saída não era a tabela em si. Era esta:
A maioria destes não é realmente tráfego dividido. Em nove dos quinze principais clusters, uma URL recebe mais de 97% das impressões e o restante recebe algumas.
Nove dos quinze principais clusters de “canibalização” eram uma página fazendo essencialmente todo o trabalho, com uma segunda URL que tinha aparecido por alguns dias e nada mais. Um relatório classificado puramente por gravidade não vai te dizer isso. Ler a divisão por URL, sim.
Passo 2: Diagnosticar Antes de Corrigir
Para os clusters em sua tabela onde as impressões são genuinamente divididas entre páginas (não aquelas onde uma URL tem 97%+), abra as páginas concorrentes em content/ e classifique cada uma: CONSOLIDAR, DIFERENCIAR, CORRIGIR-TÉCNICO ou DEIXAR. Escolha a vencedora por cliques, depois posição, depois links internos apontando para ela. Verifique como este site Hugo lida com redirecionamentos hoje. Não edite nada ainda. Produza uma tabela de decisão com um motivo de uma linha por linha.
Este passo não fez chamadas MCP. Foram cerca de 20 comandos shell: ler os arquivos Markdown concorrentes, contar links internos para cada página, ler os templates do tema e executar curl contra o site ao vivo para ver o que os redirecionamentos e tags hreflang realmente retornavam em produção, não apenas no repositório.
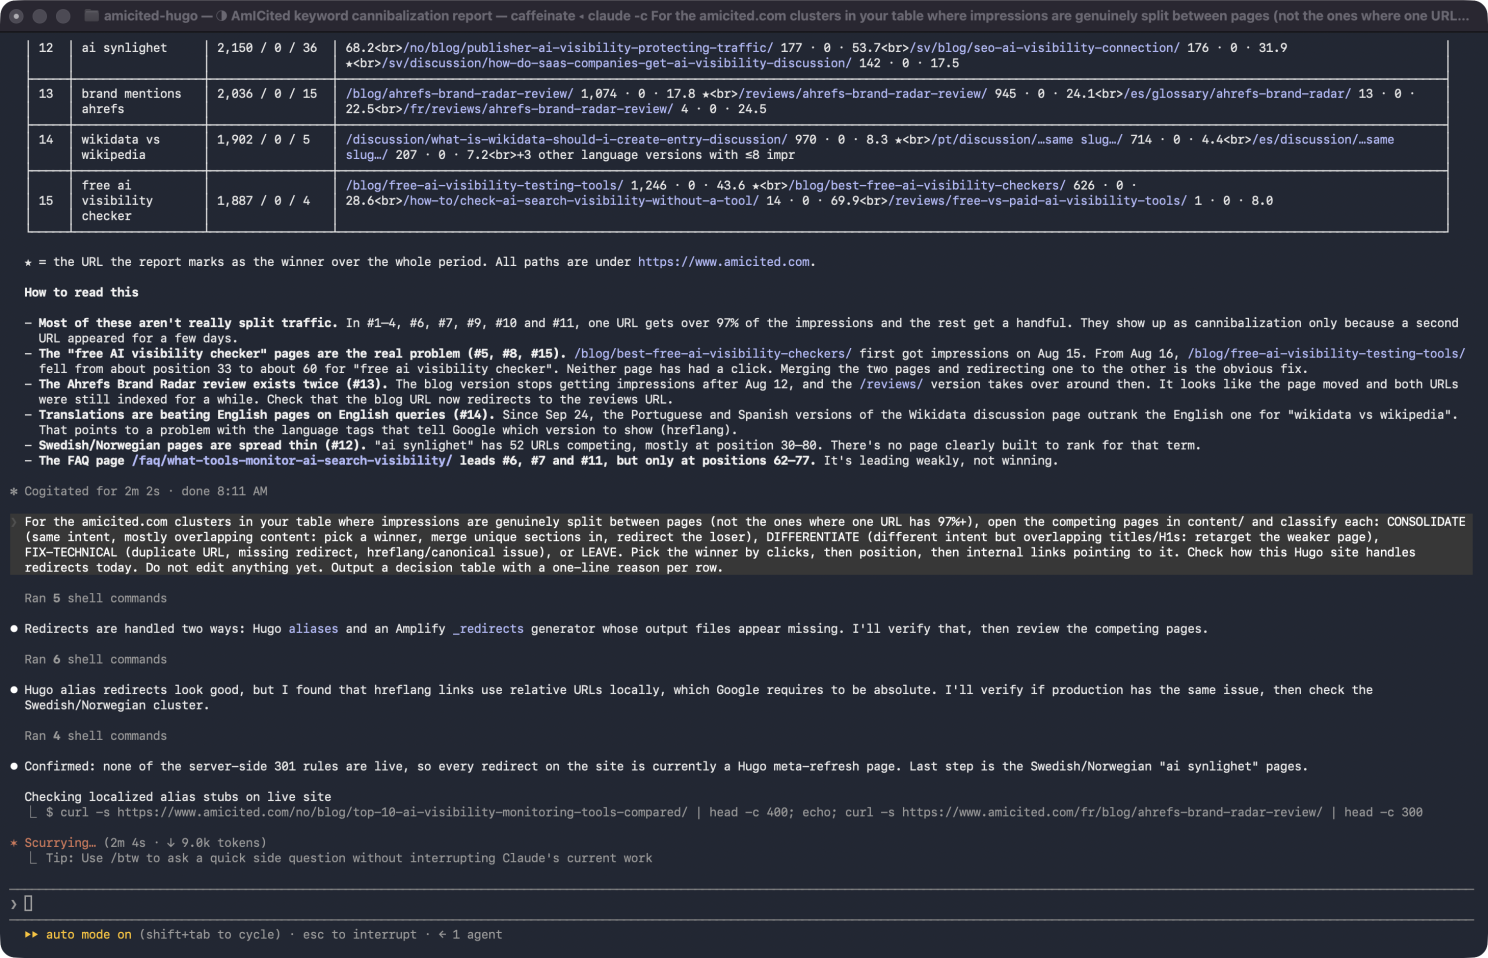
Dos quinze clusters, um precisava de mesclagem, um precisava de redirecionamento, dois precisavam de correção técnica, e o resto não precisava de nada. Essa proporção é a principal razão pela qual eu nunca deixaria um agente pular direto de “aqui está um relatório de canibalização” para “aqui estão as páginas que deletei.”
Três Descobertas Que Eu Não Pedi
1. Minhas regras de redirecionamento 301 haviam parado de funcionar silenciosamente dois meses antes. Meu site tem um script que gera regras 301 reais para o Amplify servir. O Claude Code notou que o arquivo de saída não existia, percorreu o histórico do git e descobriu que ele havia sido deletado cinco semanas antes dentro de um commit de “atualização de conteúdo” que afetou mais de 21.000 arquivos, dano colateral de uma sincronização em massa, não uma decisão tomada por alguém de propósito. Ele confirmou no site ao vivo que nenhuma das regras estava ativa (uma URL movida retornava 404 onde deveria haver um redirecionamento). Desde então, todo “redirecionamento” no site era na verdade um alias do Hugo: uma página com status 200 e meta refresh, não um 301 real.
2. Isso não era apenas teórico. A URL antiga de uma página que eu havia movido em julho ainda estava aparecendo por conta própria no Search Console, 188 impressões e contando, dois meses e meio após a mudança. Um stub com meta refresh que o Google continua indexando de qualquer maneira é exatamente a aparência de uma configuração de alias quebrada na prática.
3. Ele percebeu seu próprio erro. No passo 1, ele havia sinalizado um par de páginas como um provável problema de hreflang, já que uma versão traduzida estava superando o original em inglês. No passo 2, ele buscou o HTML ao vivo, verificou se as tags hreflang eram absolutas e recíprocas como o Google exige, e reportou que isso corrigia o que ele havia dito da primeira vez. A descoberta passou de CORRIGIR para DEIXAR. Prefiro muito mais isso do que uma resposta errada e confiante que fica sem contestação em um relatório.

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Passo 3: Aplicar a Correção em 16 Idiomas
Aprovado. Aplique a tabela de decisão neste branch, não faça commit. 1) CONSOLIDAR […] sem inventar fatos ou adicionar travessões, depois delete a perdedora em todos os idiomas em que ela existe, adicione sua URL antiga aos aliases da vencedora em cada idioma correspondente, e redirecione todos os links internos para a perdedora em content/. 2) DIFERENCIAR […] em todos os idiomas, e adicione um link contextual para a vencedora. 3) CORRIGIR-TÉCNICO: verifique o histórico do git para saber se a exclusão do static/_redirects foi deliberada. Se foi acidental, regenere-os […] Se foi deliberada, não restaure, apenas me informe.
Ele verificou os fatos antes de mesclar qualquer coisa. A página sendo aposentada tinha seções que a vencedora não tinha: uma menção a uma ferramenta concorrente, um recurso de classificação de produtos e uma compilação de testes gratuitos. Antes de transferir qualquer coisa, o Claude Code buscou os sites ativos dos fornecedores para verificar se ainda estava preciso.
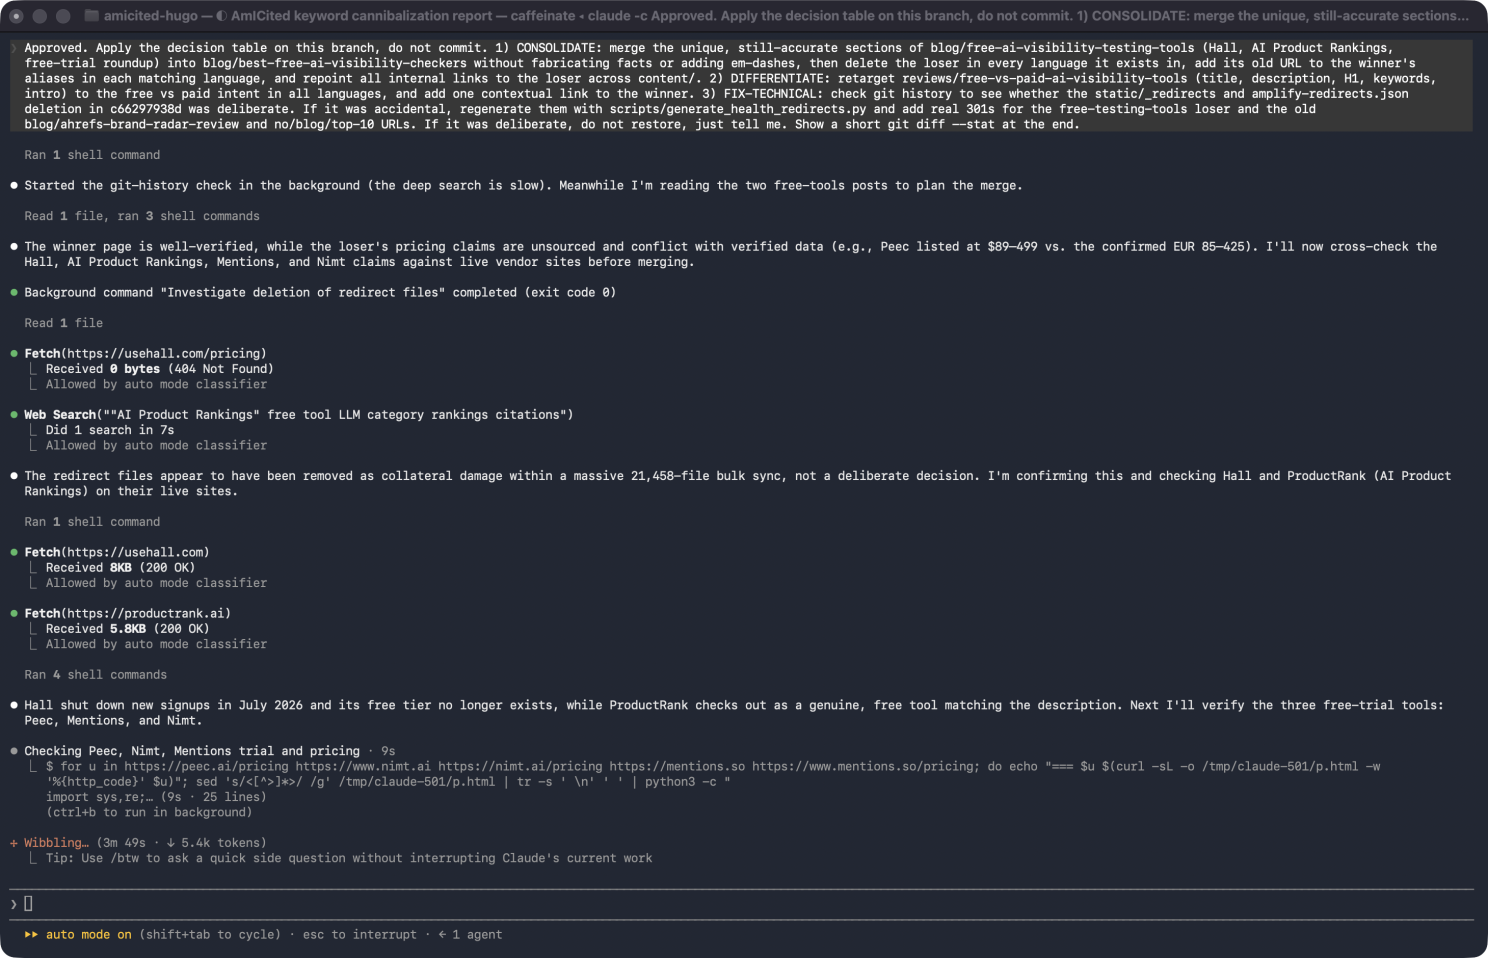
Uma das ferramentas mencionadas acabou tendo sido adquirida e fechada para novos cadastros semanas antes, então isso se tornou uma correção em vez de algo copiado como fato atual. A afirmação de preço da página aposentada para outra ferramenta também entrava em conflito com o número já verificado na página vencedora, então o valor verificado permaneceu e o desatualizado não entrou na mesclagem.
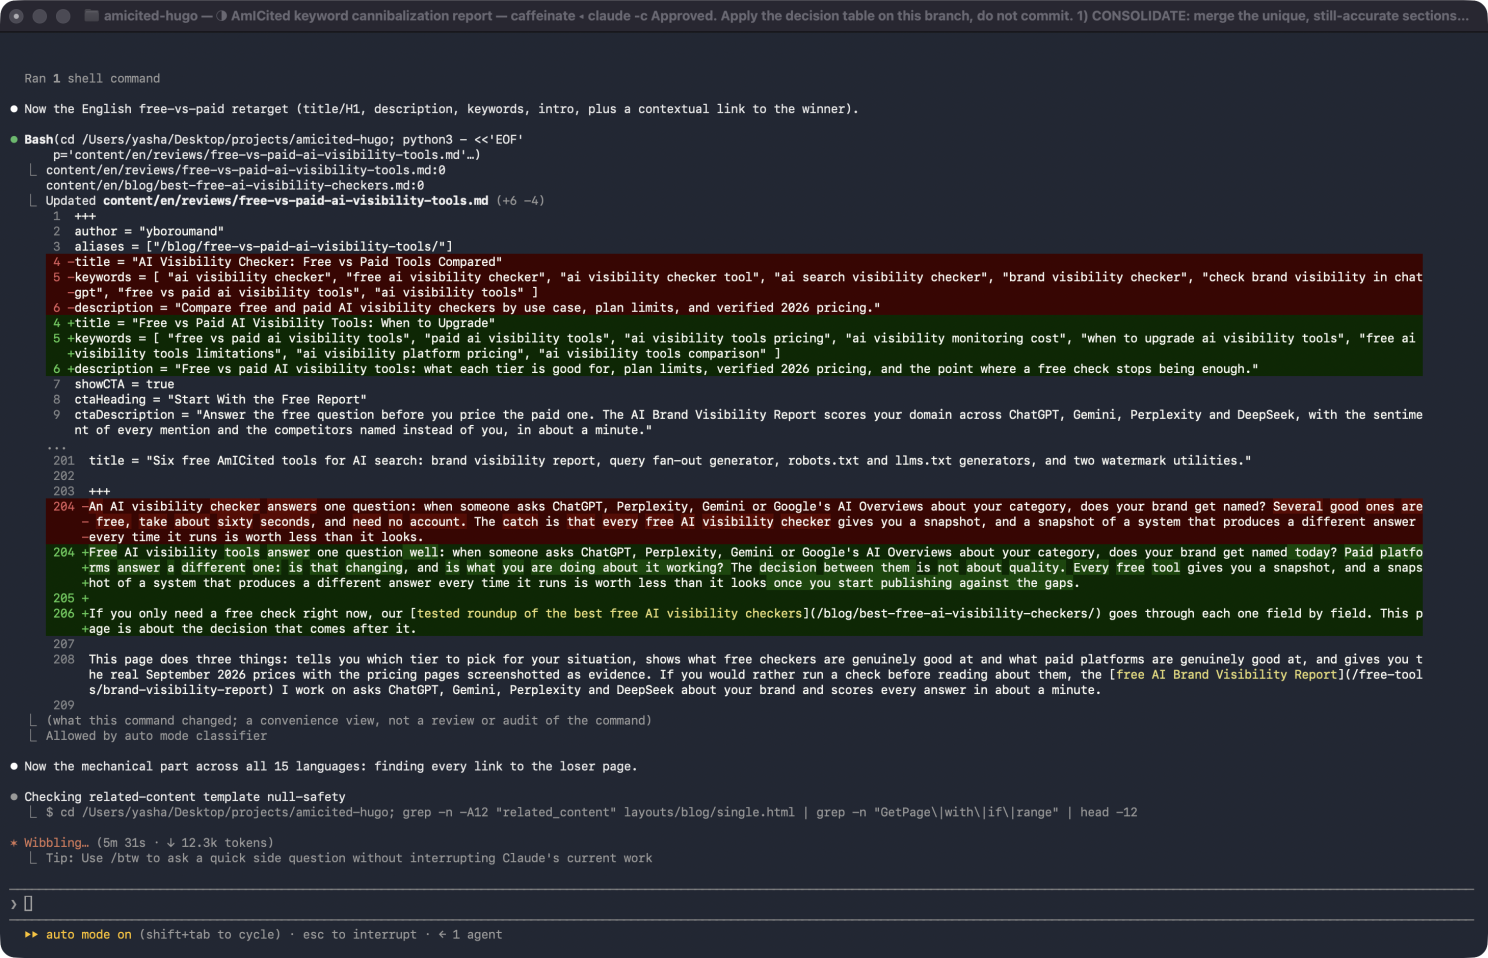
Para o caso CORRIGIR-TÉCNICO, ele verificou se a exclusão do redirecionamento havia sido deliberada antes de tocar em qualquer coisa. Confirmando que foi acidental (o commit em massa que o removeu afetou milhares de arquivos não relacionados sem menção a redirecionamentos), ele regenerou as regras e adicionou 301s reais para as páginas afetadas pela mesclagem e para a URL movida que ainda aparecia com impressões sob seu endereço antigo. Para CONSOLIDAR e DIFERENCIAR, ele repetiu a mesma alteração em todos os idiomas em que as páginas afetadas existiam, não apenas em inglês, depois executou uma build completa de produção para confirmar que nada quebrou.
O Que Vem a Seguir
Depois que você publica novo conteúdo, esse não é o fim do trabalho, é apenas o começo. Saber exatamente quais URLs estão competindo silenciosamente entre si, quais precisam ser mescladas e quais precisam apenas de uma correção técnica é o que impede que esse conteúdo trabalhe contra si mesmo. Nada desta passagem está ao vivo ainda; a reavaliação de 28 dias, para ver se a contagem de consultas canibalizadas realmente diminui, é o próximo passo.
Se você quiser ver esse tipo de relatório de canibalização no seu próprio domínio, agende uma chamada e vamos analisar juntos.