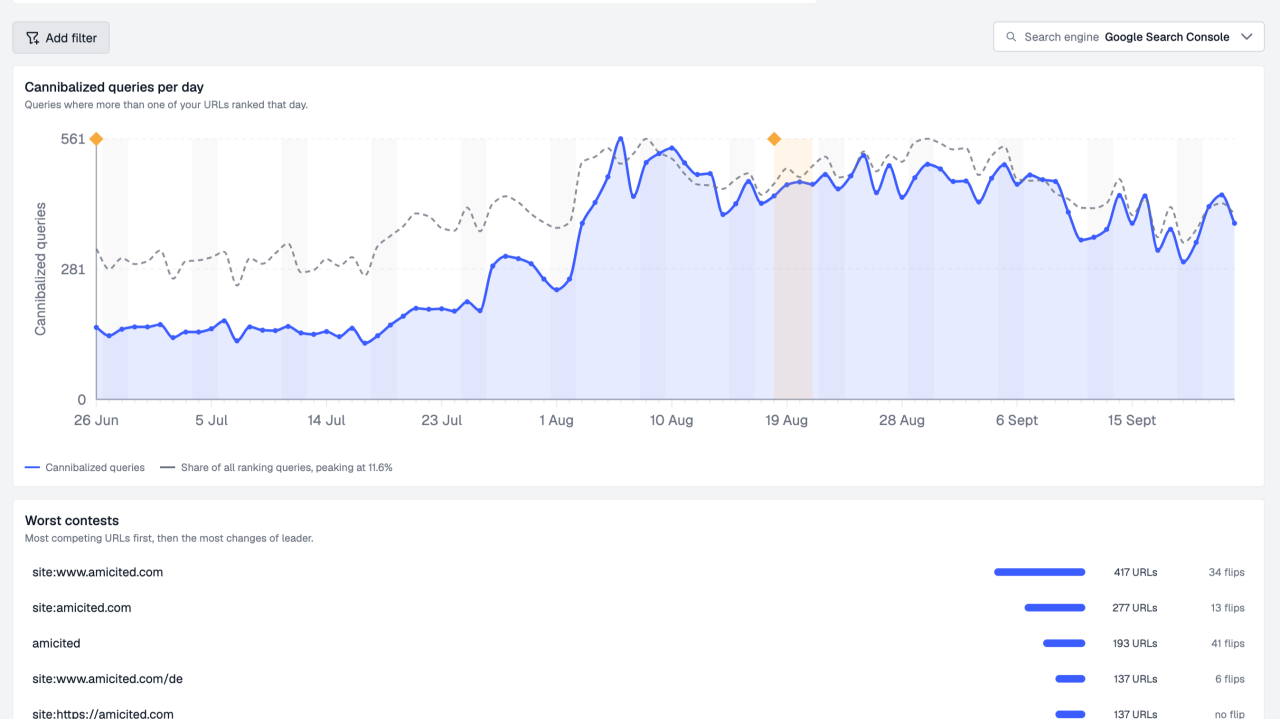
De 140 à 561 requêtes cannibalisées par jour
Entre fin juin et mi-août, le nombre de requêtes pour lesquelles deux URLs d’amicited.com ou plus apparaissaient le même jour est passé d’environ 140 par jour à un pic de 561. Au pire moment, les requêtes cannibalisées représentaient 11,6 % de l’ensemble des requêtes pour lesquelles le site était classé.
J’ai donc pointé Claude Code vers le dépôt Hugo du site, je l’ai connecté au serveur MCP SEO AmICited, et je lui ai demandé de détecter la cannibalisation de mots-clés, de décider quoi faire pour chaque cas, et d’appliquer la correction dans les 16 langues du site.
Voici la méthode de bout en bout : les invites que j’ai utilisées, ce que l’agent a réellement appelé et fait, et les trois choses qu’il a remontées sans que je les demande. Rien de tout cela n’est encore déployé, considérez donc ceci comme une présentation du processus, pas un article de résultats. La revérification à 28 jours viendra plus tard.
La cannibalisation de mots-clés se produit lorsque deux pages ou plus d’un même site sont en compétition pour la même requête de recherche, ce qui fait que Google alterne entre elles et qu’aucune ne se classe aussi bien qu’une seule page forte le ferait. C’est une compétition interne entre vos propres URLs, et c’est l’un des travaux SEO où Claude Code montre toute sa valeur : les données vivent dans Search Console, la correction vit dans le dépôt, et un agent peut gérer les deux simultanément. (À ne pas confondre avec la cannibalisation de contenu IA, où une réponse générée par IA prend le clic que votre page aurait autrement obtenu.) Si vous voulez une analyse complète, nous avons rédigé un article sur comment identifier et corriger les problèmes de cannibalisation de mots-clés séparément.
La configuration
- Dépôt : le dépôt de mon site Hugo, plus de 500 articles de blog en anglais, chacun traduit dans 15 autres langues.
- Données : le serveur MCP AmICited, qui expose les rapports SEO basés sur Google Search Console, y compris la cannibalisation, sous forme d’outils que Claude Code peut appeler directement.
- Agent : Claude Code (Opus 5.5) en mode automatique, sur une nouvelle branche,
seo/cannibalization-oct-2026. Rien n’est commité sans que j’aie lu le diff au préalable.
La connexion du serveur MCP est une étape OAuth unique : exécutez /mcp, choisissez le serveur, approuvez l’espace de travail dans le navigateur, et Claude Code peut l’appeler par la suite.
Une chose à savoir d’emblée : mon espace de travail AmICited contient plusieurs domaines. Chaque invite que j’ai écrite nommait amicited.com explicitement, et la première demandait à Claude Code de me dire quel ID de domaine il avait choisi. Sautez cette étape et vous faites confiance à l’agent pour deviner correctement.
Étape 1 : Détecter la cannibalisation, filtrer le bruit
Utilisez le serveur MCP AmICited pour extraire le rapport de cannibalisation de mots-clés pour le domaine amicited.com uniquement (l’espace de travail contient plusieurs domaines, choisissez celui pour amicited.com et dites-moi quel ID de domaine/projet vous avez utilisé). Utilisez les données Google Search Console, 90 derniers jours. Listez d’abord les outils MCP que vous appelez. Excluez le bruit : les requêtes avec des opérateurs de recherche (site:, inurl:), les requêtes de marque pure/de navigation (« amicited », « am i cited »), et les requêtes de moins de 50 impressions. Affichez les 15 principaux clusters de cannibalisation réelle sous forme de tableau […] Ne modifiez aucun fichier.
Le filtre anti-bruit existe à cause de ce à quoi ressemble réellement le rapport brut. La liste des « Pires conflits » sur mon tableau de bord était dominée par site:www.amicited.com (417 URLs), site:amicited.com (277 URLs) et la requête de marque nue amicited (193 URLs). Ce n’est pas de la cannibalisation. C’est moi, et probablement ma propre équipe, qui cherchons le site directement. Tout outil qui compte cela comme un cluster de cannibalisation compte la mauvaise chose.
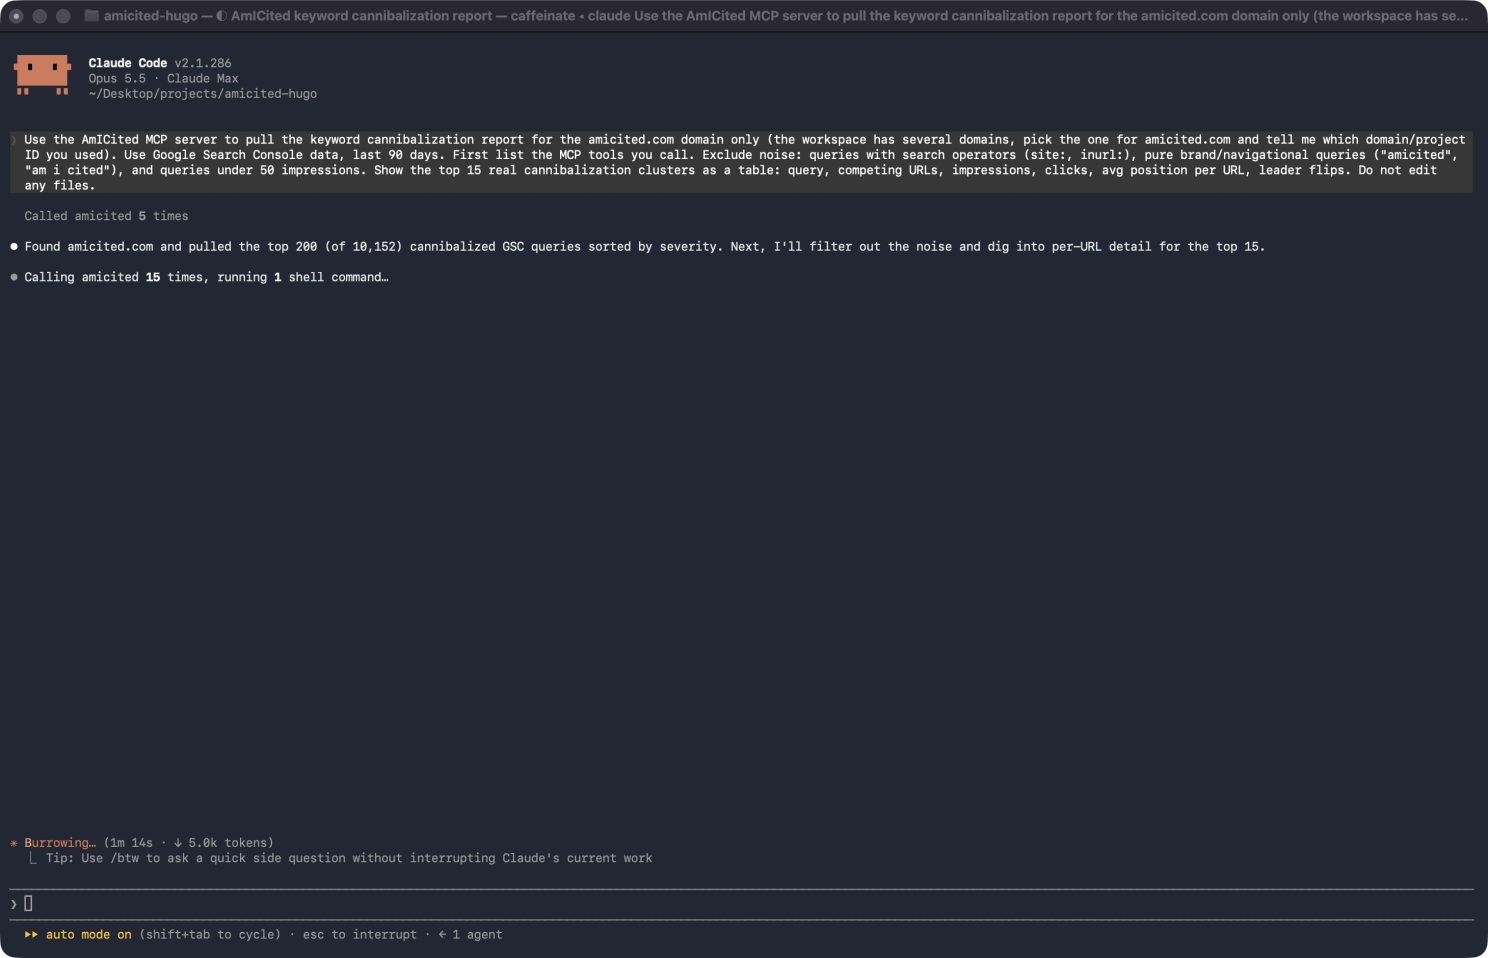
Ce qu’il a fait, dans l’ordre :
list_domains, pour trouver amicited.com parmi les domaines de l’espace de travail (et signaler l’ID de domaine utilisé).search_tools, car les outils de cannibalisation n’étaient pas dans sa liste d’outils par défaut, il les a donc recherchés par description.describe_tool, deux fois, pour lire les schémas d’entrée des deux outils de requête de cannibalisation avant de les appeler.- L’outil de liste de clusters, une fois : les 200 premières requêtes par sévérité, sur plus de 10 000 requêtes cannibalisées dans la fenêtre de 90 jours.
- L’outil de détail par requête, 15 fois, une fois par cluster, extrayant les URLs concurrentes et leurs positions quotidiennes. Une réponse était trop volumineuse pour être affichée en ligne, il a donc sauvegardé la sortie sur le disque et l’a résumée avec
jq.
Puis il a filtré. Environ 30 des 200 premières étaient des requêtes site:. De sa propre initiative, il a ajouté deux filtres supplémentaires et m’a informé qu’il l’avait fait : les longues requêtes en forme d’invites avec des milliers d’impressions et zéro clic (elles ressemblent à des invites d’outils de suivi IA copiées textuellement, pas à de vraies recherches), et quelques requêtes ressemblant à du code qui semblaient être du trafic de robots.
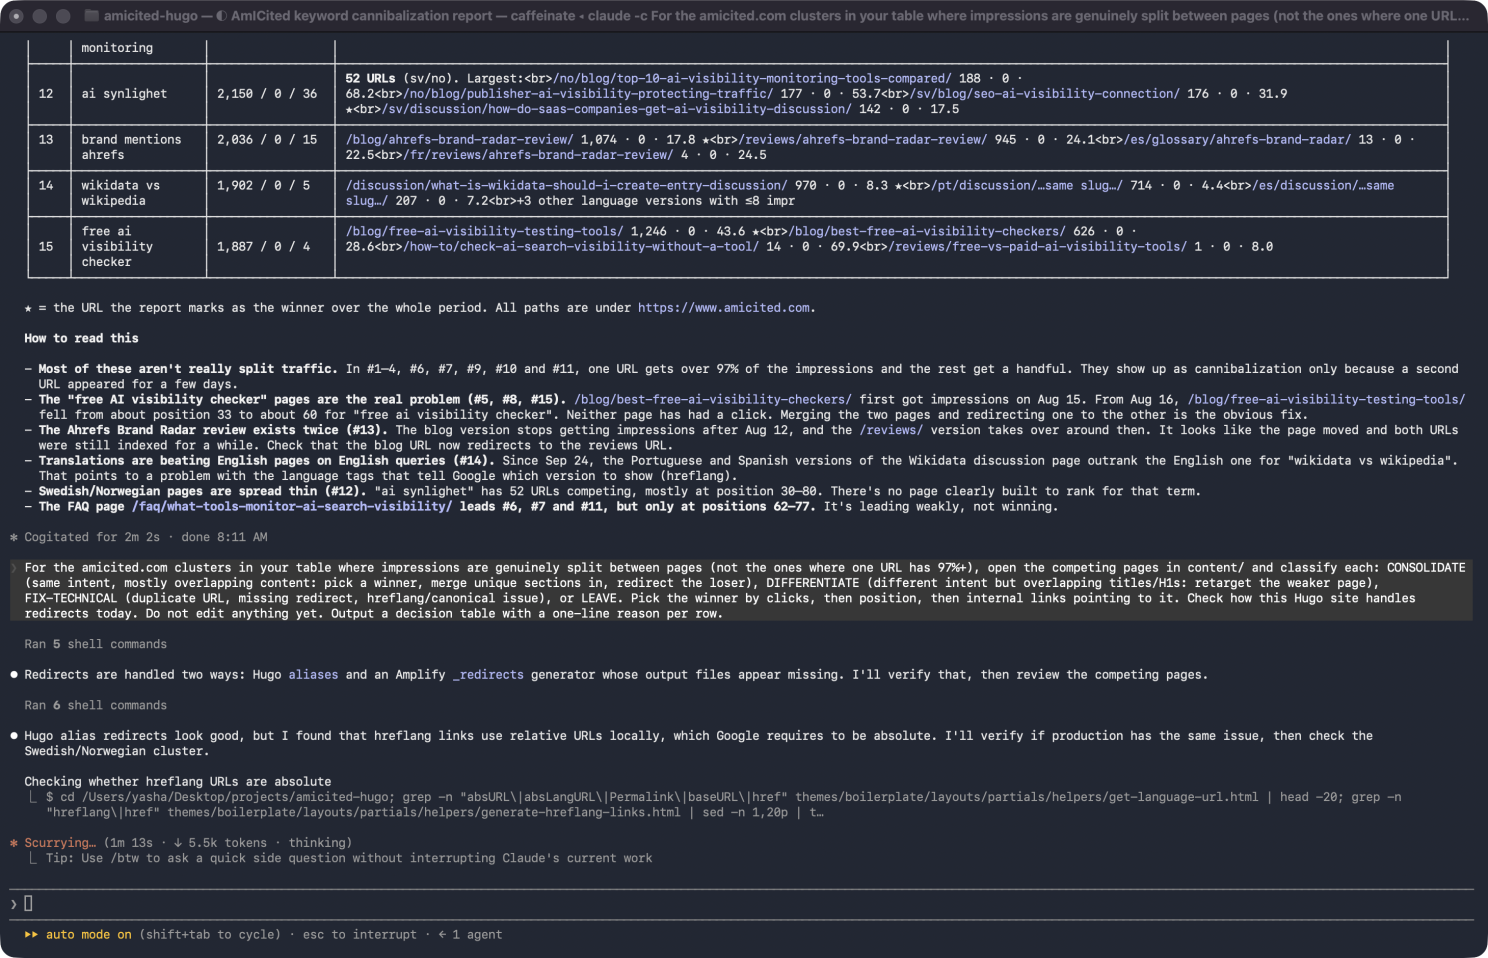
La ligne la plus utile dans la sortie n’était pas le tableau lui-même. C’était celle-ci :
La plupart de ceux-ci ne sont pas vraiment du trafic partagé. Dans neuf des quinze premiers clusters, une URL obtient plus de 97 % des impressions et les autres n’en obtiennent qu’une poignée.
Neuf des quinze principaux clusters de « cannibalisation » étaient une seule page faisant essentiellement tout le travail, avec une seconde URL apparue pendant quelques jours et rien de plus. Un rapport trié uniquement par sévérité ne vous le dira pas. La lecture de la répartition par URL, oui.
Étape 2 : Diagnostiquer avant de corriger
Pour les clusters de votre tableau où les impressions sont réellement partagées entre les pages (pas celles où une URL a 97 % ou plus), ouvrez les pages concurrentes dans content/ et classifiez chacune : CONSOLIDER, DIFFÉRENCIER, CORRECTION-TECHNIQUE, ou LAISSER. Choisissez le gagnant par les clics, puis la position, puis les liens internes pointant vers lui. Vérifiez comment ce site Hugo gère les redirections aujourd’hui. Ne modifiez rien encore. Produisez un tableau de décision avec une raison d’une ligne par ligne.
Cette étape n’a fait aucun appel MCP. Elle a consisté en environ 20 commandes shell : lire les fichiers Markdown concurrents, compter les liens internes vers chaque page, lire les modèles du thème, et exécuter curl sur le site en direct pour voir ce que les redirections et balises hreflang retournaient réellement en production, pas seulement dans le dépôt.
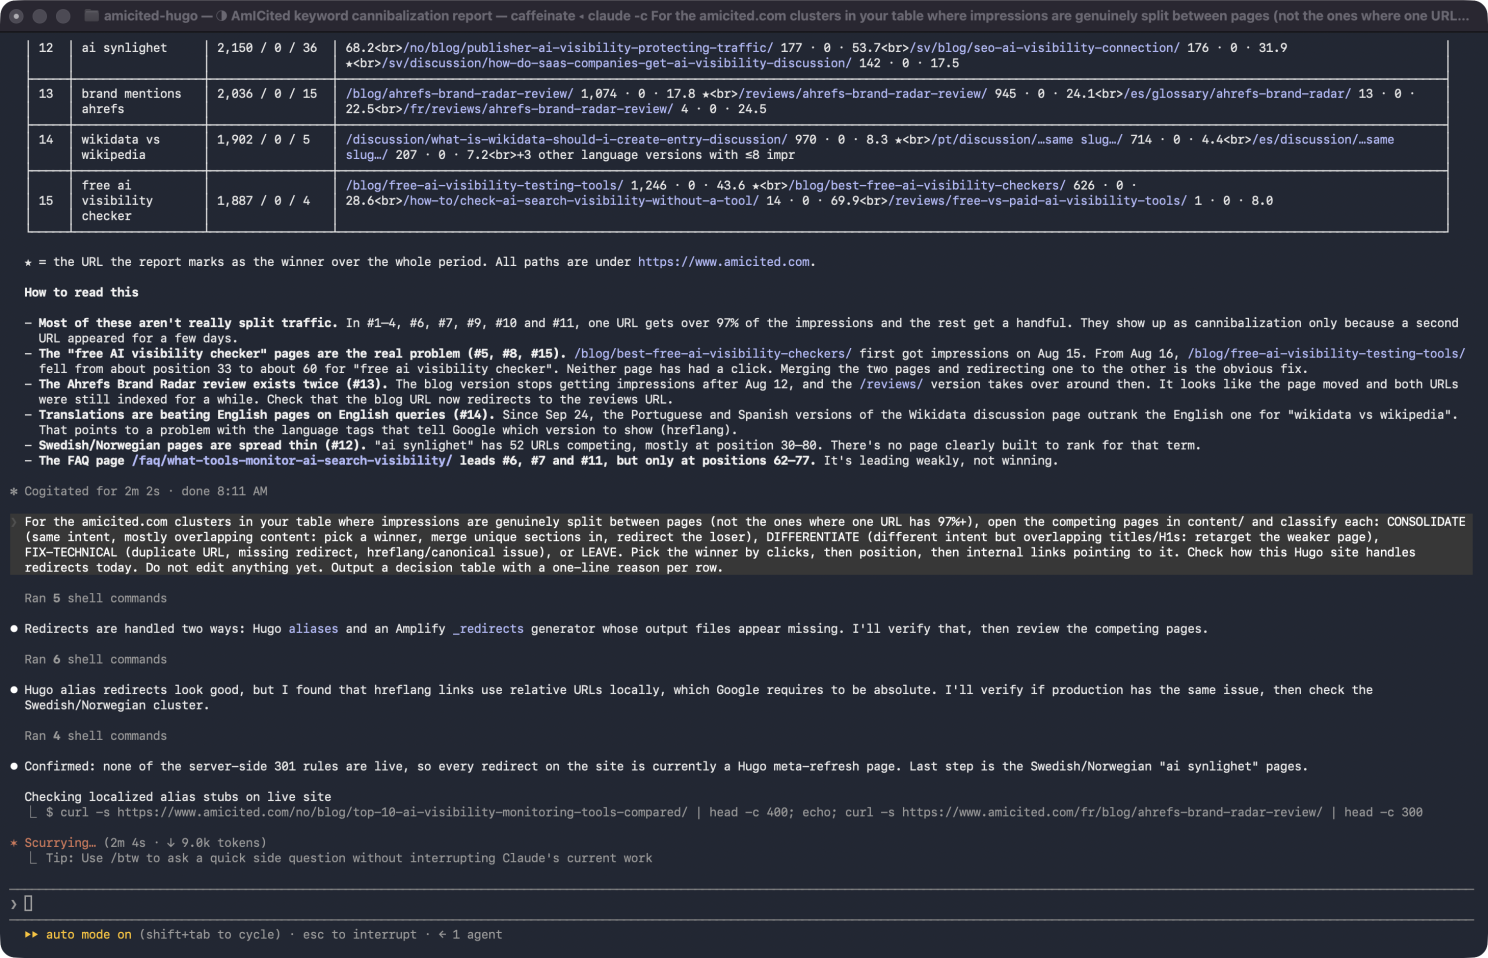
Parmi les quinze clusters, un nécessitait une fusion, un nécessitait un recentrage, deux nécessitaient une correction technique, et les autres ne nécessitaient rien. Ce ratio est la principale raison pour laquelle je ne laisserais jamais un agent passer directement de « voici un rapport de cannibalisation » à « voici les pages que j’ai supprimées ».
Trois découvertes que je n’avais pas demandées
1. Mes règles de redirection 301 avaient silencieusement cessé de fonctionner deux mois plus tôt. Mon site dispose d’un script qui génère des règles 301 réelles pour Amplify. Claude Code a remarqué que le fichier de sortie n’existait pas, a remonté l’historique git, et a découvert qu’il avait été supprimé cinq semaines plus tôt dans un commit « update content » qui touchait plus de 21 000 fichiers, un dommage collatéral d’une synchronisation en masse, pas une décision délibérée. Il a confirmé sur le site en direct qu’aucune des règles n’était active (une URL déplacée retournait une 404 là où une redirection aurait dû se trouver). Depuis lors, chaque « redirection » sur le site était en réalité un alias Hugo : une page avec code 200 et une méta-refresh, pas une vraie 301.
2. Ce n’était pas qu’une théorie. L’ancienne URL d’une page que j’avais déplacée en juillet continuait d’apparaître dans Search Console, 188 impressions et comptant, deux mois et demi après le déplacement. Un stub avec méta-refresh que Google continue d’indexer malgré tout, c’est exactement à quoi ressemble une configuration d’alias cassée en pratique.
3. Il a corrigé sa propre erreur. À l’étape 1, il avait signalé une paire de pages comme un probable problème hreflang, car une version traduite surclassait l’originale anglaise. À l’étape 2, il a récupéré le HTML en direct, vérifié que les balises hreflang étaient absolues et réciproques comme l’exige Google, et a signalé que cela corrigeait ce qu’il avait dit la première fois. La constatation est passée de CORRECTION à LAISSER. Je préfère largement cela à une réponse fausse mais confiante qui reste incontestée dans un rapport.

Stay Updated on AI Visibility Trends
Get the latest insights on AI mentions, brand monitoring, and optimization strategies.
Étape 3 : Appliquer la correction en 16 langues
Approuvé. Appliquez le tableau de décision sur cette branche, ne commitez pas. 1) CONSOLIDER […] sans inventer de faits ni ajouter de tirets cadratins, puis supprimez le perdant dans chaque langue où il existe, ajoutez son ancienne URL aux alias du gagnant dans chaque langue correspondante, et redirigez tous les liens internes vers le perdant dans content/. 2) DIFFÉRENCIER […] dans toutes les langues, et ajoutez un lien contextuel vers le gagnant. 3) CORRECTION-TECHNIQUE : vérifiez l’historique git pour voir si la suppression de static/_redirects était délibérée. Si elle était accidentelle, régénérez-les […] Si elle était délibérée, ne restaurez pas, dites-le-moi simplement.
Il a vérifié les faits avant de fusionner quoi que ce soit. La page retirée avait des sections que la gagnante n’avait pas : une mention d’un outil concurrent, une fonctionnalité de classement de produits et un récapitulatif d’essais gratuits. Avant de reporter quoi que ce soit, Claude Code a récupéré les sites en direct des fournisseurs pour vérifier que c’était toujours exact.
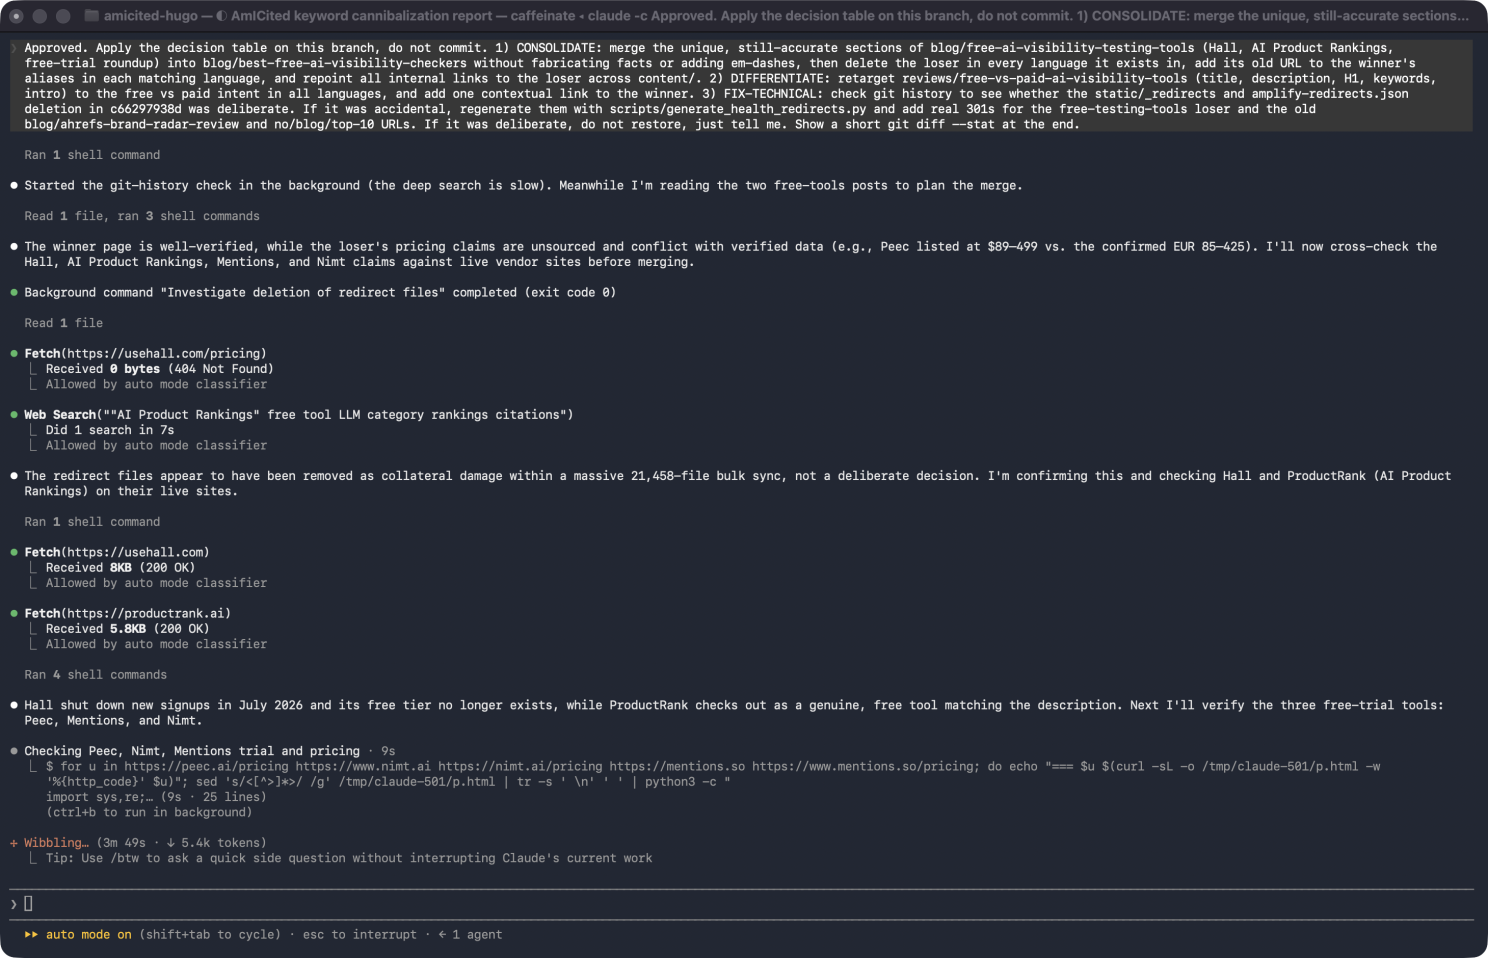
L’un des outils nommés s’est avéré avoir été acquis et fermé aux nouveaux inscrits des semaines plus tôt, ce qui est donc devenu une correction plutôt que d’être recopié comme un fait actuel. L’affirmation tarifaire de la page retirée pour un autre outil était également en contradiction avec le chiffre déjà vérifié sur la page gagnante, donc le chiffre vérifié est resté et l’information obsolète n’a pas été intégrée à la fusion.
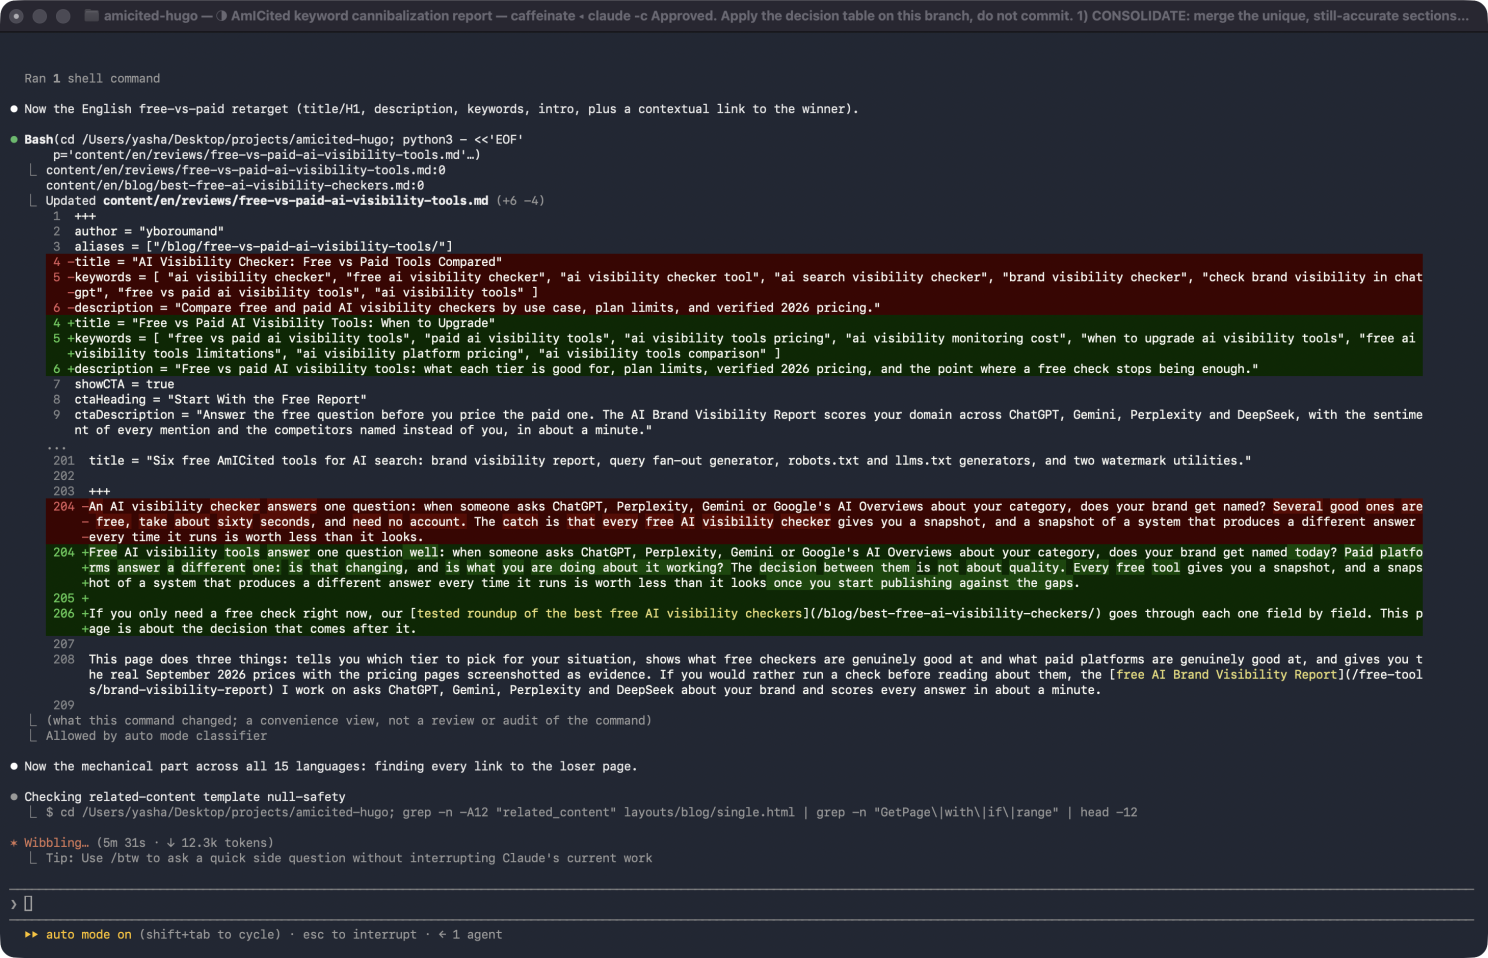
Pour le cas CORRECTION-TECHNIQUE, il a vérifié si la suppression des redirections avait été délibérée avant de toucher à quoi que ce soit. Confirmant qu’elle était accidentelle (le commit en masse qui l’a supprimée touchait des milliers de fichiers sans rapport et ne mentionnait aucune redirection), il a régénéré les règles et ajouté de vraies 301 pour les pages affectées par la fusion et l’URL déplacée qui recevait encore des impressions sous son ancienne adresse. Pour CONSOLIDER et DIFFÉRENCIER, il a répété la même modification dans chaque langue où les pages affectées existaient, pas seulement en anglais, puis a exécuté une construction de production complète pour confirmer que rien n’était cassé.
La suite
Après avoir publié du nouveau contenu, ce n’est pas la fin du travail, ce n’est que le début. Savoir exactement quelles URLs sont discrètement en compétition les unes avec les autres, lesquelles doivent être fusionnées et lesquelles ont simplement besoin d’une correction technique est ce qui permet à ce contenu de ne pas travailler contre lui-même. Rien de ce passage n’est encore en ligne ; la revérification à 28 jours, pour voir si le nombre de requêtes cannibalisées redescend réellement, est la prochaine étape.
Si vous souhaitez voir ce type de rapport de cannibalisation pour votre propre domaine, réservez un appel et nous en discuterons ensemble.