


Jak korzystać z mapy semantycznej domen
Przewodnik po mapie semantycznej domen na pulpicie AmICited

Mapa semantyczna domen zamienia tysiące luźnych punktów danych — pytań, podzapytań, tytułów cytowanych stron — w jeden obraz przestrzeni tematycznej, o którą konkurujesz w walce o uwagę AI.
Czym jest mapa semantyczna i dlaczego ma znaczenie dla widoczności w AI?
Mapa semantyczna to wizualny układ elementów tekstowych — słów, fraz lub tytułów — rozmieszczonych tak, że elementy o podobnym znaczeniu znajdują się blisko siebie, a niepowiązane oddalone są od siebie. Powstaje z wykorzystaniem technik wyszukiwania semantycznego : każdy fragment tekstu jest przekształcany w reprezentację liczbową (embedding), która oddaje jego znaczenie, a elementy o podobnych embeddingach są umieszczane blisko siebie. Wynikiem nie jest przypadkowy rozrzut punktów — to topologia Twojej dziedziny tematycznej, w której gęste obszary oznaczają intensywnie omawiane tematy, a rzadkie krawędzie — nisze lub tematy dopiero się kształtujące.
Ma to znaczenie dla optymalizacji pod silniki generatywne , ponieważ silniki odpowiedzi AI nie rankingują stron tak, jak robi to tradycyjne wyszukiwanie — one syntetyzują odpowiedź, sięgając po dziesiątki powiązanych podzapytań i źródeł, a następnie decydując, co zacytować. Gdy ChatGPT, Perplexity, Gemini czy Google AI Overviews przetwarzają pytanie, nie dopasowują wyłącznie dosłownych słów, które śledzisz — rozwijają to pytanie w chmurę powiązanych zapytań „rozszerzających” (fan-out), pobierają treści dla każdego z nich i zszywają wyniki w odpowiedź. Jeśli Twoje treści pokrywają wyłącznie dokładne pytanie, a nie otaczającą je chmurę podtematów, które AI faktycznie bada, możesz być niewidoczny w finalnej odpowiedzi, mimo że rankingujesz na frazę główną.
W tym miejscu klastrowanie semantyczne staje się praktycznym narzędziem diagnostycznym, a nie abstrakcyjnym pojęciem. Grupując Twoje śledzone pytania, zapytania rozszerzające generowane przez silniki AI na ich podstawie oraz tytuły cytowanych stron na jednej mapie przestrzennej, możesz od razu zobaczyć, które tematy cieszą się dużą aktywnością badawczą AI, w których z nich faktycznie jesteś obecny, a które są całkowicie zdominowane przez konkurencję. To zasadniczo różni się od listy słów kluczowych: mapa semantyczna pokazuje relacje, a nie tylko wolumen, więc luka tematyczna jest widoczna jako realna luka na obrazie, a nie brakujący wiersz w arkuszu kalkulacyjnym.
Praktyczną korzyścią jest forma analizy luk w treści , oparta na tym, co modele AI faktycznie badają w Twojej dziedzinie, a nie na tym, co zakładasz, że badają. Zamiast zgadywać, jakie artykuły napisać w następnej kolejności, możesz wskazać konkretny klaster na mapie, zobaczyć, że dominują w nim tytuły konkurencji, a Twoich brakuje, i potraktować ten klaster jako brief treściowy.
Gdzie to znaleźć
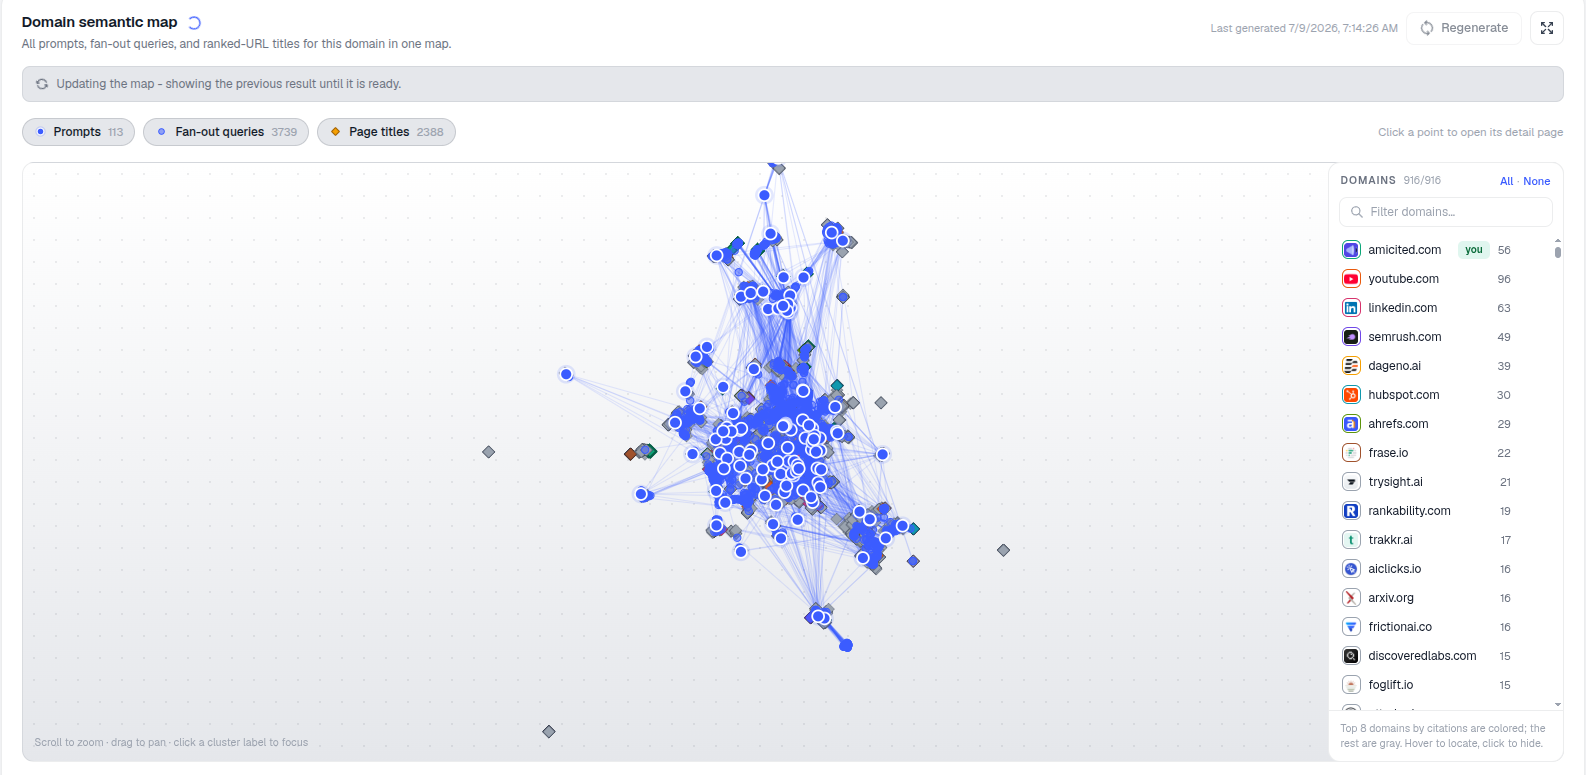
Przewiń w dół pulpitu do karty Mapa semantyczna domen. Nagłówek pokazuje, kiedy została ostatnio wygenerowana, plus przycisk Generuj ponownie i ikonę pełnego ekranu do pracy z mapą w pełnym rozmiarze. Jeśli podstawowe dane zmieniły się niedawno — na przykład po aktualizacji zestawu pytań lub nowym indeksowaniu — możesz zobaczyć „Aktualizacja mapy — wyświetlany jest poprzedni wynik do czasu jej gotowości.” Mapa jest generowana na podstawie danych śledzonych w Twoim koncie, więc odzwierciedla Twoją rzeczywistą listę pytań, a nie ogólny szablon.
Na co patrzysz
Każdy punkt to jeden element, a jego typ jest pokazany przez przełączniki nad mapą:
- Pytania (Prompts) — pytania, które aktywnie śledzisz, ten sam zestaw, który napędza wyniki Twojego trackera pozycji w AI w innych miejscach pulpitu.
- Zapytania rozszerzające (Fan-out queries) — liczne podzapytania, na które silniki AI rozbijają pytanie podczas badania odpowiedzi. Pojedyncze śledzone pytanie może rozwinąć się w kulisach w kilkanaście lub więcej takich zapytań; obserwowanie ich rozmieszczenia to najbliższy możliwy wgląd w to, jak model faktycznie interpretuje Twoje pytanie.
- Tytuły stron — tytuły adresów URL cytowanych jako źródła w odpowiedziach AI, zarówno z Twojej domeny, jak i od konkurencji.
Punkty znajdujące się blisko siebie są podobne semantycznie — mówią o tym samym temacie bazowym, nawet jeśli różni się słownictwo. Linie łączące punkty pokazują wyraźne relacje (na przykład pytanie połączone z wygenerowanymi z niego zapytaniami rozszerzającymi). Gęste klastry oznaczają tematy z dużą aktywnością badawczą AI — miejsca, w których modele zadają wiele powiązanych pytań i sięgają po wiele źródeł. Samotne punkty na krawędziach to tematy niszowe lub poboczne, które nie mają jeszcze wiele otaczającej je aktywności — co może oznaczać albo niewykorzystaną niszę, albo temat po prostu nieistotny z punktu widzenia tego, jak silniki AI postrzegają Twoją przestrzeń.
Kolor odgrywa tu również szczególną rolę: 8 domen najczęściej cytowanych jest pokolorowanych, a pozostałe są szare, dzięki czemu od razu widać, które źródła dominują w danym klastrze, bez konieczności klikania każdego punktu z osobna. Notatka taka jak „Pominięto N cytowanych stron, których nie można było pobrać lub odczytać” pojawi się również, gdy ma to zastosowanie, informując, ile stron źródłowych system próbował pobrać, ale nie mógł — przydatny kontekst, gdy klaster wygląda na rzadszy, niż byś się spodziewał.
Jak to eksplorować
- Włączaj i wyłączaj warstwy (Pytania / Zapytania rozszerzające / Tytuły stron), aby skupić się na jednym typie elementów naraz — na przykład ukryj pytania i zapytania rozszerzające, aby zobaczyć czystą mapę tego, kto i gdzie jest cytowany.
- Przewijaj, aby przybliżać, przeciągaj, aby przesuwać, a kliknij etykietę klastra, aby skupić się na regionie — wskazówka na mapie wyjaśnia to, i jest to najszybszy sposób przejścia od widoku z lotu ptaka na całą przestrzeń tematyczną do pojedynczego podtematu.
- Kliknij dowolny punkt, aby otworzyć jego stronę szczegółów — w przypadku pytania jest to pełny widok jego wydajności, dzięki czemu możesz przejść bezpośrednio od „ten klaster wygląda słabo” do leżących u jego podstaw danych widoczności w wyszukiwaniu AI dla konkretnego pytania.
- Użyj listy domen po prawej stronie, aby pokolorować i zlokalizować konkretne domeny na mapie — przydatne, gdy chcesz prześledzić dokładnie, gdzie dany konkurent pojawia się w całej przestrzeni tematycznej (opisane w osobnym przewodniku).
Ponieważ mapa łączy Twoje własne śledzone pytania z zapytaniami wyprowadzanymi z nich przez silniki AI oraz tytułami tego, kto faktycznie jest cytowany, funkcjonuje ona jako żywy podgląd udziału w głosie na poziomie tematu, a nie pojedynczego pytania — nie pytasz już tylko „czy zostałem zacytowany za to konkretne pytanie”, lecz „kto jest właścicielem całej tej okolicy powiązanych pytań”.
Co mierzy
Mapa semantyczna domen nie generuje pojedynczego wyniku tak, jak robi to wskaźnik cytowań czy indeks widoczności. Zamiast tego jest przestrzenną reprezentacją trzech rzeczy naraz: zakresu Twojego śledzonego zestawu pytań, głębokości aktywności rozszerzającej generowanej przez silniki AI wokół Twoich tematów oraz obecności konkurencyjnej — poprzez cytowane tytuły stron — we wszystkim tym razem. Odczytane łącznie, te trzy warstwy odpowiadają na pytanie, na które płaska tabela metryk nie potrafi odpowiedzieć: nie tylko jak często jesteś cytowany, ale gdzie, w odniesieniu do rzeczywistego kształtu rozmowy, jaką silniki AI prowadzą na temat Twojej przestrzeni.
Klaster gęsty od zapytań rozszerzających i tytułów stron z trzech lub czterech pokolorowanych domen konkurencji, bez żadnych Twoich tytułów, to bezpośredni sygnał luki cytowań — temat, który modele AI intensywnie badają, ale nigdy nie znajdują powodu, by Cię zacytować. I odwrotnie, klaster, w którym Twoje tytuły są dobrze reprezentowane obok konkurencji, potwierdza, że jesteś wiarygodnym źródłem w tym temacie — przynajmniej w oczach systemów wyszukiwania stojących za tymi silnikami AI.
Jak z tego korzystać
- Znajdź klastry tematyczne, w których gromadzi się wiele zapytań rozszerzających — to tematy, którymi silniki AI interesują się najbardziej w Twojej przestrzeni, i te najbardziej warte priorytetyzacji w Twoim planie treści.
- Znajdź luki, w których grupują się tytuły stron konkurencji, ale Twoich brakuje — każda z nich to konkretna, a nie hipotetyczna okazja do tworzenia treści, ponieważ opiera się na tytułach, które faktycznie zostały zacytowane.
- Generuj ponownie po większych zmianach treści — nowej stronie filarowej, partii opublikowanych artykułów, przebudowanym katalogu produktów — aby zobaczyć, jak zmienia się Twój ślad na mapie i czy wcześniej puste klastry zaczynają wypełniać się Twoimi tytułami.
- Zestawiaj z listą domen, aby sprawdzić, czy ten sam jeden lub dwóch konkurentów dominuje w każdej znalezionej luce, czy też różne domeny wygrywają różne klastry — to zmienia, czy walczysz z jednym zadomowionym graczem, czy z kilkoma niszowymi.
- Łącz z danymi o wydajności pytań, klikając punkt na mapie — mapa mówi Ci, gdzie jest luka, a strona szczegółów danego pytania lub domeny mówi Ci, dlaczego ją przegrywasz.
Traktuj mapę jako warstwę diagnostyczną nadrzędną wobec Twoich indywidualnych raportów pytań: to tutaj decydujesz, co naprawić, zanim zagłębisz się w to, jak. Gdy już zidentyfikujesz klaster, w którym jesteś nieobecny, naturalnym kolejnym krokiem jest ustrukturyzowany proces analizy luk , aby zamienić tę wizualną lukę na priorytetyzowaną listę briefów, a także sprawdzenie, jak zbudowane są strony, które już posiadasz — przydatnym uzupełnieniem, gdy już wiesz, które klastry są celem, jest lektura o tym, jak strukturyzować treść, aby modele AI mogły ją faktycznie cytować . Dla agencji zarządzających tym procesem dla wielu pytań lub wielu domen klienckich, połączenie mapy semantycznej z przepływem pracy dla agencji w AmICited zamienia jednorazową analizę luk w ciągły podgląd tego, czy Twoja inwestycja w treść faktycznie zmniejsza dystans do konkurentów, którzy obecnie są właścicielami tych klastrów.
Najczęściej zadawane pytania
Nanosi Twoje śledzone prompt'y, zapytania fan-out, które silniki AI z nich wyprowadzają, oraz tytuły stron, które zostały zacytowane jako źródła, wszystkie umieszczone według znaczenia, tak aby powiązane tematy grupowały się razem. Zamienia tysiące luźnych punktów danych w jeden obraz przestrzeni tematycznej, w której konkurujesz o uwagę AI.
Top 8 domen pod względem liczby cytowań jest pokolorowanych, abyś mógł natychmiast zidentyfikować, które źródła dominują w danym klastrze, podczas gdy wszystkie pozostałe domeny są szare. Pozwala to na pierwszy rzut oka dostrzec, czy gęsty klaster należy do kilku znanych konkurentów, czy jest rozproszony między wieloma mniejszymi źródłami.
Włącz warstwę Tytuły stron i poszukaj klastrów, w których gęsto występują tytuły konkurencji, ale nie ma żadnych Twoich. To bezpośrednia, oparta na dowodach szansa treściowa, ponieważ opiera się na tytułach faktycznie cytowanych przez silniki AI, a nie na hipotetycznej luce wywnioskowanej z listy słów kluczowych.
Odśwież ją po większych zmianach treści, takich jak publikacja nowej strony filarowej, partii artykułów lub restrukturyzacja katalogu produktów, aby sprawdzić, czy Twój ślad się zwiększył i czy poprzednio puste klastry zawierają teraz Twoje tytuły. Nagłówek pokazuje, kiedy mapa została ostatnio wygenerowana, więc wiesz, jak aktualny jest widok.
Więcej samouczków w tej sekcji
 Jak czytać swój Wynik Widoczności
Dowiedz się, co mierzy Wynik Widoczności na górze pulpitu AmICited, jak działają wskaźnik i podział według …
Przeczytaj przewodnik →
 Jak sprawdzić swój Share of Voice
Znajdź swój Share of Voice na pulpicie AmICited, zrozum, czym różni się od Wyniku Widoczności, i wykorzystaj …
Przeczytaj przewodnik →
 Jak sprawdzić widoczność według platformy AI
Przeczytaj zestawienie według platform obok wskaźnika Wyniku Widoczności w AmICited, aby zobaczyć, jak Twoje …
Przeczytaj przewodnik →
Gotowy, aby zastosować to w praktyce?
Bezpłatne sprawdzenie · 7-dniowy okres próbny · wymagana karta kredytowa