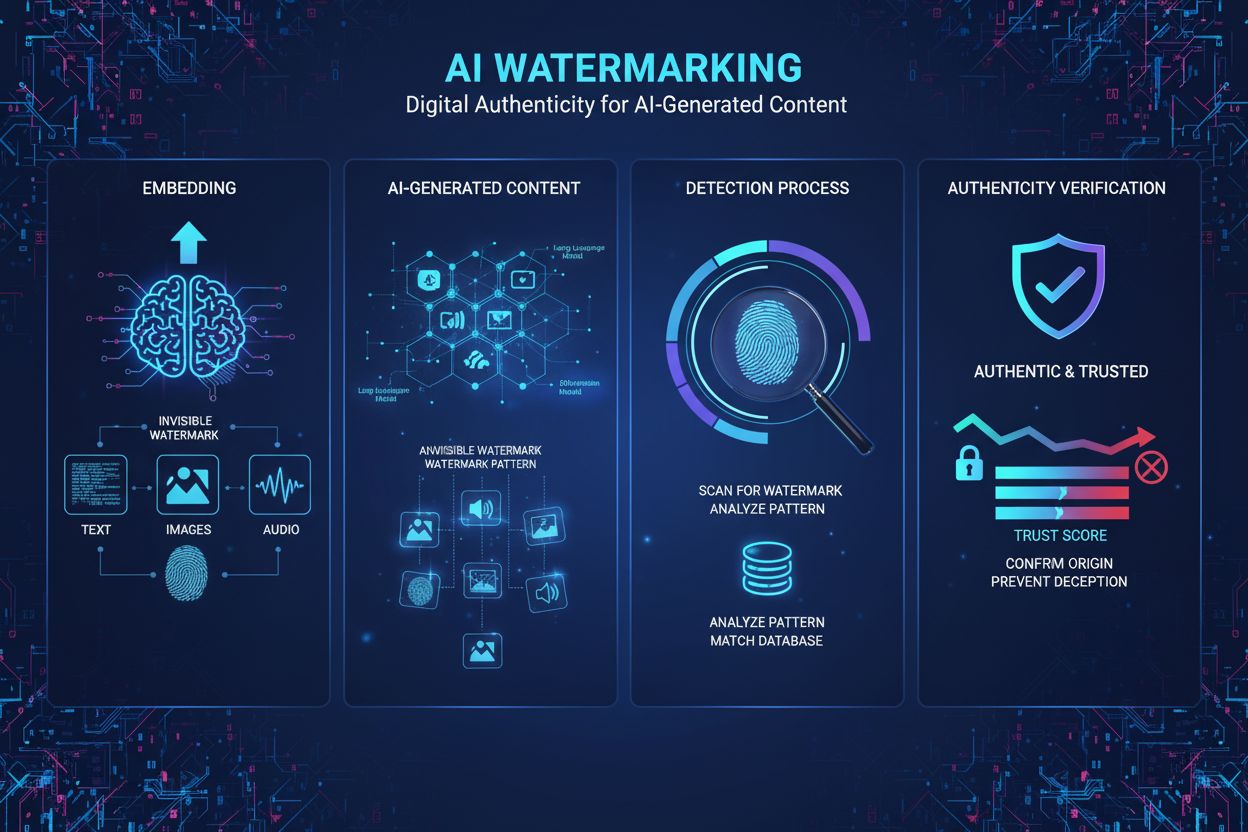
Una marca de agua de texto con IA es una señal introducida deliberadamente en el texto generado. Para un editor, la pregunta útil es concreta: ¿podemos reconocer más adelante la salida de un sistema de generación que nosotros controlamos?
SynthID Text responde a esa pregunta. No determina si un artículo cualquiera lo escribió una IA. Su detector comprueba la presencia de un patrón estadístico configurado, y una prueba fallida deja sin resolver el origen del texto. El repositorio de referencia de SynthID describe tanto la generación como la detección de la marca de agua.
Esta guía recorre un ejemplo local en Python y después examina los casos más difíciles: múltiples marcas de agua, la reescritura con una nueva marca de agua y la comprobación de un texto cuando se desconocen las claves originales.
Qué cambia realmente una marca de agua de texto
Un modelo de lenguaje asigna probabilidades a los posibles tokens siguientes. Los tokens pueden representar palabras, partes de palabras o signos de puntuación. Una marca de agua generativa cambia el modo en que se selecciona el siguiente token. Las elecciones resultantes llevan consigo una evidencia que un detector puede medir más adelante.
SynthID utiliza un proceso llamado muestreo por torneo. Los tokens candidatos compiten bajo funciones de puntuación seudoraleatorias. El contexto reciente de tokens y las claves de la marca de agua determinan las puntuaciones. Repetir la selección a través de varias capas favorece los tokens con un patrón estadístico medible. El detector reconstruye estas puntuaciones a partir del texto finalizado. No necesita ejecutar el modelo de lenguaje original. Consulta el artículo de investigación sobre SynthID.
1. Predecir los posibles tokens siguientes
El modelo de lenguaje produce una distribución sobre su vocabulario.2. Aplicar la marca de agua configurada
Las funciones de puntuación con clave influyen en la selección de tokens durante la generación.3. Publicar texto normal
La señal estadística viaja en la secuencia de tokens seleccionada.4. Reconstruir y puntuar
El detector usa una tokenización compatible y la configuración correspondiente para buscar esa señal.Los pasajes más largos suelen aportar más evidencia. Una salida muy predecible deja menos tokens alternativos disponibles para marcar. Más capas pueden ayudar, pero el artículo señala rendimientos decrecientes a medida que las capas consumen la variación disponible en la selección de tokens.
Las marcas de agua estadísticas y los caracteres ocultos son cosas distintas
Antes de elegir un detector, identifica la señal que pretendes encontrar.
| Método | ¿Qué transporta la señal? | ¿Qué deberías comprobar? |
|---|---|---|
| SynthID Text | Elecciones estadísticas de tokens realizadas durante la generación | Evidencia bajo una configuración de marca de agua correspondiente |
| Marcador de caracteres ocultos | Caracteres específicos insertados en una cadena | La secuencia de caracteres y su codificación documentada |
| Metadatos del documento | Campos asociados a un documento o contenedor | Los metadatos, su origen y cualquier firma |
| Clasificador de escritura por IA | Patrones aprendidos de textos de ejemplo | La generalización y los falsos positivos en el público objetivo |
Un escáner de Unicode no puede sustituir a un detector de SynthID. Encontrar un carácter inusual tampoco demuestra la autoría de una IA. Nuestra introducción a las herramientas gratuitas de AmICited analiza las señales de marca de agua basadas en caracteres y sus límites. El experimento que sigue se refiere a las marcas de agua estadísticas.
Genera texto con marca de agua en Python
El repositorio de Google es una referencia de investigación y aconseja explícitamente no usar sus subclases de modelo en producción. Remite a la implementación de Hugging Face Transformers. La referencia también ofrece enfoques de detección de media, media ponderada y bayesiana entrenada. Notas de uso del repositorio
El ejemplo siguiente usa Python 3.13, Transformers 4.57.1 y PyTorch 2.8.0. Son versiones de ejemplo reproducibles, no una afirmación de que sean las más recientes. Se ejecuta en CPU y descarga el modelo público distilbert/distilgpt2 en el primer uso. Ese modelo pequeño mantiene el experimento accesible; su calidad de escritura no es representativa de los asistentes actuales.
Crea un entorno aislado:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Guarda los bloques de Python de esta guía, en orden, en watermark_demo.py. Empieza con la generación:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Public demonstration keys. Never use these as a private production mark.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Keep the continuation; the supplied prompt was not watermarked.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
La generación debe exponer una canalización de muestreo compatible. Pasar una respuesta ya terminada desde una API alojada a esta configuración no puede marcarla de forma retroactiva. Un modelo distinto tendría que generar una nueva versión.
En producción, crea claves aleatorias únicas y mantén la configuración en privado. Conserva la revisión del tokenizador, la revisión del modelo, la versión de la configuración y el detector asociado. Una rotación de claves crea una nueva configuración; conserva la antigua configuración de detección si aún necesitas reconocer salidas anteriores. Guía de implementación de Google
Cómo calcula la evidencia la detección de marcas de agua
La detección empieza tokenizando el texto candidato y reconstruyendo una puntuación para cada ventana de tokens elegible y cada capa de la marca de agua. En la implementación usada aquí, estas puntuaciones binarias se llaman valores g. Las promediamos tras excluir los contextos repetidos y las posiciones iguales o posteriores al token de fin de secuencia. Los cuatro primeros tokens de una continuación no forman por sí solos una ventana completa de cinco tokens.
La siguiente función usa los métodos de puntuación y enmascaramiento de Transformers. Acepta una secuencia sin relleno a la vez y devuelve una media bruta, no una probabilidad de autoría.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Boolean indexing retains the layer dimension.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
La comprobación directa por ID de token aísla la generación de la serialización del texto. La segunda comprobación ejercita la ruta que ve un detector después de la publicación. Evalúa tu propia canalización real de publicación y extracción de texto, porque puede modificar la entrada.
Una puntuación de 0,60 no significa una probabilidad del 60 % de que el texto lo haya escrito una IA. Esta función no tiene un umbral de decisión calibrado. Un pasaje corto puede puntuar alto por azar. Informa de un resultado no concluyente cuando la evidencia sea insuficiente.
Para tener un detector útil, recopila texto humano representativo, salida del modelo sin marca de agua y salida con marca de agua. Mantén los datos de calibración separados de los datos de evaluación final. Elige un umbral para una tasa de falsos positivos aceptable, evalúa las tasas de detección en muestras reservadas y desglosa los resultados por idioma, longitud y tipo de contenido. Un único par marcado/sin marcar solo comprueba que el ejemplo se ejecuta.
Como alternativa entrenada, Hugging Face ofrece un detector bayesiano y un flujo de trabajo para entrenar detectores. Un detector entrenado para claves no relacionadas no es un sustituto directo de tu detector. Un punto de control inicializado aleatoriamente o de demostración no demuestra exactitud de detección.

Mantente al día de las tendencias de visibilidad en IA
Recibe las últimas novedades sobre menciones en IA, monitorización de marca y estrategias de optimización.
¿Puedes detectar CUALQUIER marca de agua de SynthID sin sus claves?
El enfoque de detección publicado requiere una configuración correspondiente. También necesitas una tokenización compatible. Saber que un proveedor usa el algoritmo SynthID no te da su configuración, y el repositorio público no es un detector para la salida de cualquier proveedor.
Google describe detectores privados, detectores expuestos a través de una API y detectores distribuidos públicamente. Un proveedor podría ofrecer verificación sin revelar su configuración privada. Detección y verificabilidad
Para nuestro propio sistema, podemos comprobar un registro de configuraciones conocidas. Añade este ejemplo para comparar las claves correctas con claves de demostración no relacionadas:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Ejecuta el archivo completo con python watermark_demo.py. Esta comparación produce evidencia para dos configuraciones conocidas. No puede descubrir una clave desconocida arbitraria y, de forma intencionada, no etiqueta ninguna de las dos puntuaciones como detección.
Comprobar muchas configuraciones también implica realizar muchas pruebas estadísticas. Si cada prueba permite falsos positivos, aceptar cualquier positivo puede aumentar la tasa global de falsos positivos. Calibra el procedimiento de búsqueda completo. Cuando las pruebas individuales aporten valores p válidos, una opción conservadora es dividir el margen total de falsos positivos entre el número de pruebas. No apliques esa aritmética directamente a la puntuación bruta mean_g.
Si ninguna configuración conocida coincide, el resultado adecuado es “No se ha detectado ninguna marca de agua compatible”. Las posibilidades siguen incluyendo la escritura humana, la salida de IA sin marca de agua, una marca de agua desconocida y un pasaje editado cuya señal sea demasiado débil.
¿Puede el mismo texto llevar varias marcas de agua de SynthID?
Hay dos diseños distintos que considerar.
Varias capas en una sola configuración
SynthID ya admite una lista de claves. En el ejemplo, 30 claves crean 30 capas dentro de una marca de agua configurada. El detector combina su evidencia. Esas claves no representan automáticamente 30 autores u organizaciones atribuibles por separado. Configuración de la marca de agua
Marcas de plataforma y de cliente detectables de forma independiente
Supón que quieres que un detector de toda la plataforma y otro específico de un cliente reconozcan el mismo pasaje. Asignar grupos de capas a esos fines es una opción de diseño experimental, no una garantía documentada de la biblioteca.
Concatenar simplemente dos listas de claves no demuestra que ambos detectores originales sigan funcionando. Cada detector necesitaría una evaluación sobre el proceso de generación combinado, incluida su posición en la secuencia de capas. Mide la tasa de detección de cada marca, las coincidencias cruzadas con otros clientes y el comportamiento tras las ediciones. Se trata de una propuesta de ingeniería que requiere experimentos, no de la afirmación de que SynthID ofrezca atribución independiente a varios propietarios de serie.
Si un servicio central solo necesita identificar a un cliente, un diseño más sencillo es una configuración por cliente con un registro interno. Ese diseño sigue necesitando calibración en todo el registro. No ofrece una marca separada de toda la plataforma que pueda comprobarse sin buscar entre las configuraciones de los clientes.
¿Puedes sustituir una marca de agua existente?
SynthID no almacena un campo como watermark_id en el texto. No hay ningún valor de metadatos que sobrescribir. La señal original está distribuida entre las elecciones de tokens.
Si reescribes un pasaje usando un segundo generador con marca de agua, el nuevo proceso de generación introduce su propia señal. El efecto sobre la señal anterior depende de la secuencia de tokens resultante. Google informa de que las ediciones leves pueden preservar la detectabilidad, mientras que una reescritura o traducción exhaustiva puede reducir sustancialmente la confianza. Límites documentados de las transformaciones
De ello se deduce que una segunda marca de agua no garantiza el borrado de la primera. Ambas señales pueden seguir siendo detectables, o una o las dos pueden quedar por debajo de sus umbrales de detección. Esto es una inferencia sobre un flujo de trabajo combinado; la documentación citada no establece una tasa de supervivencia para cada par de marcas de agua.
Una primera configuración desconocida crea un límite práctico. Nuestro propio detector puede evaluar nuestra marca, pero no puede demostrar que la marca original haya desaparecido. Eso requiere acceso al detector correspondiente original. Incluso un resultado negativo significa que el detector no encontró suficiente evidencia con sus ajustes, no que se hayan eliminado todos los rastros.
Cómo probar marcas de agua que se solapan
Antes de afirmar que las marcas coexisten o que una sustituye a otra, usa una matriz de pruebas. Las entradas siguientes describen experimentos que hay que realizar, no resultados medidos.
| Grupo de muestras | Detector A | Detector B | Qué comprueba la comparación |
|---|---|---|---|
| Texto humano y texto de IA sin marca de agua | Ejecutar | Ejecutar | Falsos positivos de referencia |
| Texto generado solo con A | Ejecutar | Ejecutar | Detección de A y coincidencias accidentales con B |
| Texto generado solo con B | Ejecutar | Ejecutar | Detección de B y coincidencias accidentales con A |
| Texto generado con una configuración combinada experimental | Ejecutar | Ejecutar | Si cada marca prevista es detectable |
| Un texto A reescrito bajo B | Ejecutar | Ejecutar | Supervivencia de A y detección de B tras la reescritura |
| Extractos cortos y versiones editadas de cada grupo | Ejecutar | Ejecutar | Sensibilidad al flujo de trabajo de publicación |
Usa indicaciones reservadas e informa de las longitudes de texto utilizables, el número de muestras, las versiones de los detectores, los umbrales y las tasas de falsos positivos. Incluye la incertidumbre en torno a las tasas informadas. Repite la evaluación cuando cambies claves, tokenización, versiones del modelo o ajustes de generación. Hasta que existan esas comprobaciones, describe la coexistencia y la sustitución como no verificadas.
Qué significa esto para los editores y la visibilidad en IA
La detección de marcas de agua y el monitoreo de citas de IA responden a preguntas distintas. Una prueba de marca de agua pregunta si un pasaje lleva evidencia de una configuración de generación concreta. El monitoreo de citas comprueba qué fuentes aparecen en las respuestas de la IA.
No presentes una marca de agua ausente como prueba de autoría humana, ni una marca de agua detectada como prueba de que se citó un sitio web concreto. Para los flujos de trabajo editoriales, conserva los registros de generación y la atribución editorial junto a cualquier detector estadístico. Cada uno aporta evidencia que los demás no aportan.
 LinkedIn