Et AI-tekstvandmærke er et signal, der bevidst indføres i genereret tekst. For en udgiver er det relevante spørgsmål specifikt: kan vi senere genkende output fra et genereringssystem, som vi selv kontrollerer?
SynthID Text besvarer det spørgsmål. Det afgør ikke, om en vilkårlig artikel er skrevet af AI. Dets detektor tester for et konfigureret statistisk mønster, og en mislykket test efterlader tekstens oprindelse uafklaret. SynthID-reference-repositoriet beskriver både generering og detektion af vandmærker.
Denne guide gennemgår et lokalt Python-eksempel og undersøger derefter de sværere tilfælde: flere vandmærker, genskrivning med et nyt vandmærke og kontrol af tekst, når de oprindelige nøgler er ukendte.
Hvad et tekstvandmærke faktisk ændrer
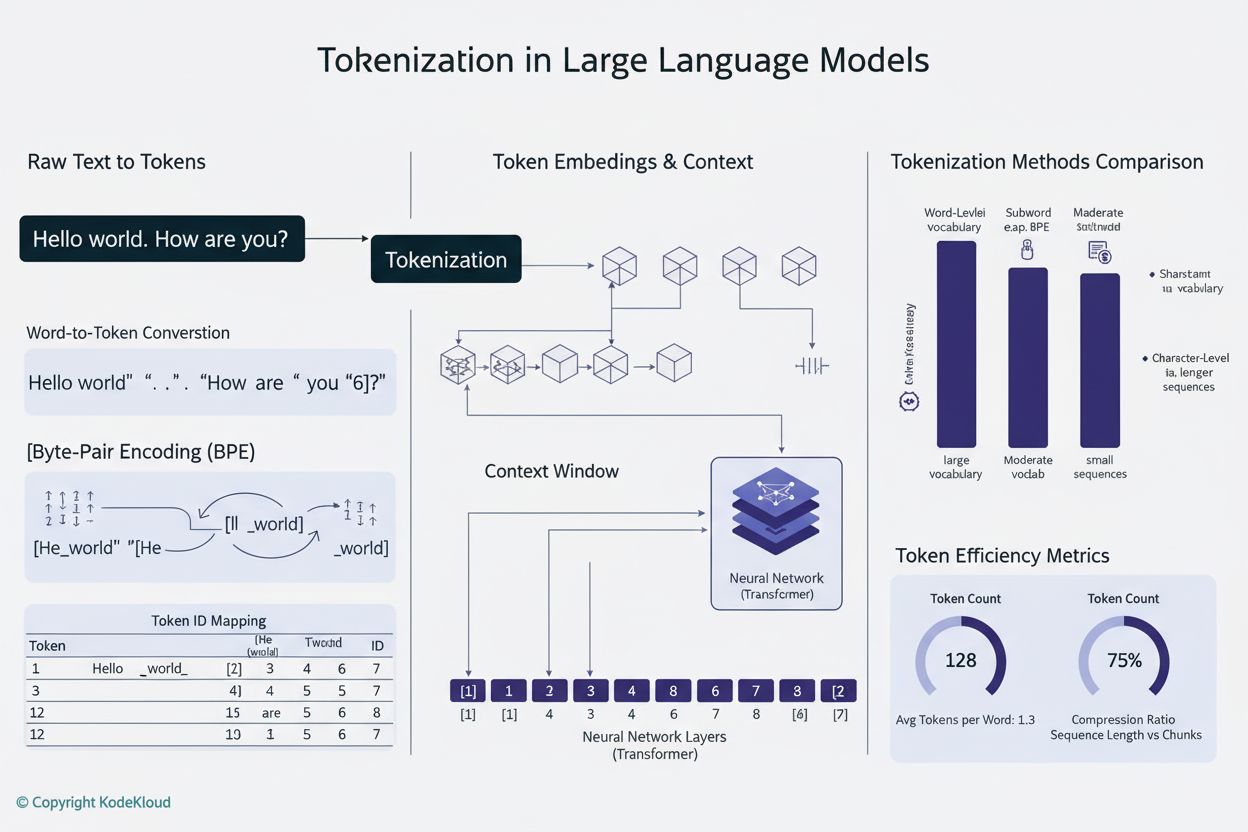
En sprogmodel tildeler sandsynligheder til mulige næste tokens. Tokens kan repræsentere ord, dele af ord eller tegnsætning. Et generativt vandmærke ændrer, hvordan det næste token vælges. De resulterende valg bærer bevis, som en detektor senere kan måle.
SynthID bruger en proces kaldet tournament sampling. Kandidat-tokens konkurrerer under pseudorandomiske scoringsfunktioner. Den nyeste token-kontekst og vandmærkets nøgler bestemmer scorerne. Gentagelse af udvælgelsen gennem flere lag favoriserer tokens med et målbart statistisk mønster. Detektoren rekonstruerer disse scorer ud fra den færdige tekst. Den behøver ikke at køre den oprindelige sprogmodel. Se SynthID-forskningsartiklen.
1. Forudsig mulige næste tokens
Sprogmodellen producerer en fordeling over sit ordforråd.2. Anvend det konfigurerede vandmærke
Nøglebaserede scoringsfunktioner påvirker token-udvælgelsen under genereringen.3. Publicér almindelig tekst
Det statistiske signal følger med i den valgte token-sekvens.4. Rekonstruér og scor
Detektoren bruger kompatibel tokenisering og den matchende konfiguration til at lede efter signalet.Længere passager giver generelt mere bevis. Meget forudsigeligt output efterlader færre alternative tokens til rådighed for vandmærkning. Flere lag kan hjælpe, men artiklen rapporterer om aftagende udbytte, efterhånden som lagene opbruger den tilgængelige variation i token-udvælgelsen.
Statistiske vandmærker og skjulte tegn er forskellige
Før du vælger en detektor, skal du identificere det signal, du har til hensigt at finde.
| Metode | Hvad bærer signalet? | Hvad bør du teste? |
|---|---|---|
| SynthID Text | Statistiske token-valg foretaget under genereringen | Bevis under en matchende vandmærkekonfiguration |
| Markør med skjulte tegn | Specifikke tegn indsat i en streng | Tegnsekvensen og dens dokumenterede kodning |
| Dokumentmetadata | Felter knyttet til et dokument eller en container | Metadataen, dens oprindelse og en eventuel signatur |
| AI-skriveklassifikator | Mønstre lært fra eksempeltekster | Generalisering og falske positiver på den tiltænkte målgruppe |
En Unicode-scanner kan ikke erstatte en SynthID-detektor. At finde et usædvanligt tegn fastslår heller ikke AI-forfatterskab. Vores introduktion til AmICiteds gratis værktøjer diskuterer tegnbaserede vandmærkesignaler og deres begrænsninger. Eksperimentet nedenfor handler om statistisk vandmærkning.

Klar til at overvåge din AI-synlighed?
Følg, hvordan AI-chatbots nævner dit brand i ChatGPT, Perplexity og andre platforme.
Generér vandmærket tekst i Python
Googles repositorium er en forskningsreference og fraråder udtrykkeligt at bruge dets model-underklasser i produktion. Det henviser til implementeringen i Hugging Face Transformers. Referencen tilbyder også detektionstilgange baseret på gennemsnit, vægtet gennemsnit og trænet Bayesiansk detektion. Bemærkninger om brug af repositoriet
Følgende eksempel bruger Python 3.13, Transformers 4.57.1 og PyTorch 2.8.0. Det er reproducerbare eksempelversioner, ikke en påstand om, at de er de nyeste udgivelser. Det kører på CPU og downloader den offentlige distilbert/distilgpt2-model ved første brug. Den lille model holder eksperimentet tilgængeligt; dens skrivekvalitet er ikke repræsentativ for nutidige assistenter.
Opret et isoleret miljø:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Gem Python-blokkene i denne guide i rækkefølge i watermark_demo.py. Start med generering:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Public demonstration keys. Never use these as a private production mark.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Keep the continuation; the supplied prompt was not watermarked.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
Genereringen skal eksponere en kompatibel sampling-pipeline. At føre et færdigt svar fra en hostet API ind i denne konfiguration kan ikke efterfølgende mærke det. En separat model ville skulle generere en ny version.
I produktion bør du oprette unikke tilfældige nøgler og holde konfigurationen privat. Behold tokenizer-revisionen, modelrevisionen, konfigurationsversionen og den tilhørende detektor. En nøglerotation skaber en ny konfiguration; behold den gamle detektionskonfiguration, hvis du stadig har brug for at genkende ældre output. Googles implementeringsvejledning
Sådan beregner vandmærkedetektion bevis
Detektionen begynder med at tokenisere den tekst, der undersøges, og rekonstruere en score for hvert gyldigt token-vindue og vandmærkelag. I implementeringen, der bruges her, kaldes disse binære scorer for g-værdier. Vi tager gennemsnittet af dem efter at have udelukket gentagne kontekster og positioner ved eller efter end-of-sequence-tokenet. De første fire tokens i en fortsættelse udgør ikke i sig selv et komplet vindue på fem tokens.
Følgende funktion bruger Transformers’ scorings- og maskeringsmetoder. Den accepterer én upaddet sekvens ad gangen og returnerer et rå gennemsnit, ikke en sandsynlighed for forfatterskab.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Boolean indexing retains the layer dimension.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
Den direkte token-ID-kontrol isolerer genereringen fra tekstserialiseringen. Den anden kontrol afprøver den vej, en detektor ser efter publicering. Evaluer din faktiske pipeline til publicering og tekstudtræk, fordi den kan ændre inputtet.
En score på 0,60 betyder ikke en 60 % sandsynlighed for, at AI har skrevet teksten. Denne funktion har ingen kalibreret beslutningstærskel. En kort passage kan opnå en høj score ved tilfældighed. Rapportér et uafklaret resultat, når beviset er utilstrækkeligt.
For at få en brugbar detektor skal du indsamle repræsentativ menneskelig tekst, uvandmærket modeloutput og vandmærket output. Hold kalibreringsdata adskilt fra de endelige evalueringsdata. Vælg en tærskel for en acceptabel falsk-positiv-rate, evaluer detektionsrater på tilbageholdte prøver, og opdel resultaterne efter sprog, længde og indholdstype. Et enkelt par med mærket/umærket tekst kontrollerer kun, at eksemplet kan køre.
Som et trænet alternativ leverer Hugging Face en Bayesiansk detektor og et workflow til træning af detektorer. En detektor, der er trænet på urelaterede nøgler, er ikke en direkte erstatning for din detektor. Et tilfældigt initialiseret checkpoint eller democheckpoint dokumenterer ikke detektionsnøjagtighed.
Hold dig opdateret om tendenser inden for AI-synlighed
Få de nyeste indsigter om AI-omtaler, brandovervågning og optimeringsstrategier.
Kan du opdage ET HVERT SynthID-vandmærke uden dets nøgler?
Den offentliggjorte detektionstilgang kræver en matchende konfiguration. Du har også brug for kompatibel tokenisering. At vide, at en udbyder bruger SynthID-algoritmen, giver dig ikke dennes konfiguration, og det offentlige repositorium er ikke en detektor for enhver udbyders output.
Google beskriver private detektorer, detektorer eksponeret via en API og offentligt distribuerede detektorer. En udbyder kan tilbyde verifikation uden at afsløre sin private konfiguration. Detektion og verificerbarhed
For vores eget system kan vi tjekke et register over kendte konfigurationer. Tilføj dette eksempel for at sammenligne de korrekte nøgler med urelaterede demonstrationsnøgler:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Kør den samlede fil med python watermark_demo.py. Denne sammenligning producerer bevis for to kendte konfigurationer. Den kan ikke opdage en vilkårlig ukendt nøgle, og den mærker bevidst ikke nogen af scorerne som en detektion.
At tjekke mange konfigurationer betyder også at udføre mange statistiske tests. Hvis hver test tillader falske positiver, kan det at acceptere enhver positiv øge den samlede falsk-positiv-rate. Kalibrér hele søgeproceduren. Hvor individuelle tests giver gyldige p-værdier, er en konservativ mulighed at dividere den samlede tilladte falsk-positiv-mængde med antallet af tests. Anvend ikke den aritmetik direkte på den rå mean_g-score.
Hvis ingen kendt konfiguration matcher, er det passende resultat “Der blev ikke fundet noget understøttet vandmærke.” Mulighederne omfatter stadig menneskelig skrivning, uvandmærket AI-output, et ukendt vandmærke og en redigeret passage, hvis signal er for svagt.
Kan den samme tekst bære flere SynthID-vandmærker?
Der er to forskellige designs at overveje.
Flere lag i én konfiguration
SynthID understøtter allerede en liste af nøgler. I eksemplet skaber 30 nøgler 30 lag inden for ét konfigureret vandmærke. Detektoren kombinerer deres bevis. Disse nøgler repræsenterer ikke automatisk 30 separat tilskrivbare forfattere eller organisationer. Vandmærkekonfiguration
Uafhængigt detekterbare platform- og kundemærker
Antag, at du ønsker, at en platformsdækkende detektor og en separat kundespecifik detektor skal genkende den samme passage. At allokere grupper af lag til disse formål er en eksperimentel designmulighed, ikke en dokumenteret garanti i biblioteket.
At sammenkæde to nøglelister demonstrerer ikke, at begge oprindelige detektorer stadig fungerer. Hver detektor ville skulle evalueres på den kombinerede genereringsproces, herunder dens position i lagsekvensen. Mål hvert mærkes detektionsrate, krydsmatch mod andre kunder og adfærd efter redigeringer. Dette er et ingeniørforslag, der kræver eksperimenter, snarere end en påstand om, at SynthID leverer uafhængig tilskrivning til flere ejere ud af boksen.
Hvis en central tjeneste kun skal identificere en kunde, er et enklere design én konfiguration pr. kunde med et internt register. Det design kræver stadig kalibrering på tværs af hele registeret. Det giver ikke et separat platformsdækkende mærke, som kan tjekkes uden at gennemsøge kundekonfigurationer.
Kan du erstatte et eksisterende vandmærke?
SynthID gemmer ikke et felt som watermark_id i teksten. Der er ingen metadataværdi at overskrive. Det oprindelige signal er fordelt over token-valgene.
Hvis du genskriver en passage ved hjælp af en anden vandmærket generator, indfører den nye genereringsproces sit eget signal. Effekten på det tidligere signal afhænger af den resulterende token-sekvens. Google rapporterer, at milde redigeringer kan bevare detekterbarheden, mens grundig genskrivning eller oversættelse kan reducere sikkerheden betydeligt. Dokumenterede grænser for transformationer
Det følger, at et andet vandmærke ikke garanterer sletning af det første. Begge signaler kan forblive detekterbare, eller et eller begge kan falde under deres detektionstærskler. Dette er en slutning om et kombineret workflow; den citerede dokumentation fastslår ikke en overlevelsesrate for hvert par af vandmærker.
En ukendt første konfiguration skaber en praktisk begrænsning. Vores egen detektor kan evaluere vores mærke, men den kan ikke fastslå, at det oprindelige mærke er forsvundet. Det kræver adgang til den oprindelige matchende detektor. Selv et negativt resultat betyder, at detektoren ikke fandt tilstrækkeligt bevis under sine indstillinger – ikke bevis for, at hvert eneste spor er fjernet.
Sådan tester du overlappende vandmærker
Før du hævder, at mærker eksisterer side om side, eller at det ene erstatter det andet, bør du bruge en testmatrix. Posterne nedenfor beskriver eksperimenter, der skal udføres, ikke målte resultater.
| Prøvegruppe | Detektor A | Detektor B | Hvad sammenligningen kontrollerer |
|---|---|---|---|
| Menneskelig og uvandmærket AI-tekst | Kør | Kør | Baseline for falske positiver |
| Tekst genereret kun med A | Kør | Kør | A-detektion og tilfældige B-match |
| Tekst genereret kun med B | Kør | Kør | B-detektion og tilfældige A-match |
| Tekst genereret med en eksperimentel kombineret konfiguration | Kør | Kør | Om hvert tilsigtet mærke kan detekteres |
| A-tekst genskrevet under B | Kør | Kør | A’s overlevelse og B-detektion efter genskrivning |
| Korte uddrag og redigerede versioner af hver gruppe | Kør | Kør | Følsomhed over for publiceringsworkflowet |
Brug tilbageholdte prompts, og rapportér brugbare tekstlængder, antal prøver, detektorversioner, tærskler og falsk-positiv-rater. Medtag usikkerhed omkring de rapporterede rater. Gentag evalueringen, når du ændrer nøgler, tokenisering, modelversioner eller genereringsindstillinger. Indtil disse kontroller findes, bør sameksistens og erstatning beskrives som uverificeret.
Hvad betyder det for udgivere og AI-synlighed
Vandmærkedetektion og AI-citationsovervågning besvarer forskellige spørgsmål. En vandmærketest spørger, om en passage bærer bevis for en bestemt genereringskonfiguration. Citationsovervågning tjekker, hvilke kilder der optræder i AI-svar.
Præsentér ikke et manglende vandmærke som bevis for menneskeligt forfatterskab, eller et detekteret vandmærke som bevis for, at et bestemt website blev citeret. Behold i publiceringsworkflows genereringslogfiler og redaktionel tilskrivning side om side med enhver statistisk detektor. Hver af dem giver bevis, som de andre ikke giver.
 LinkedIn