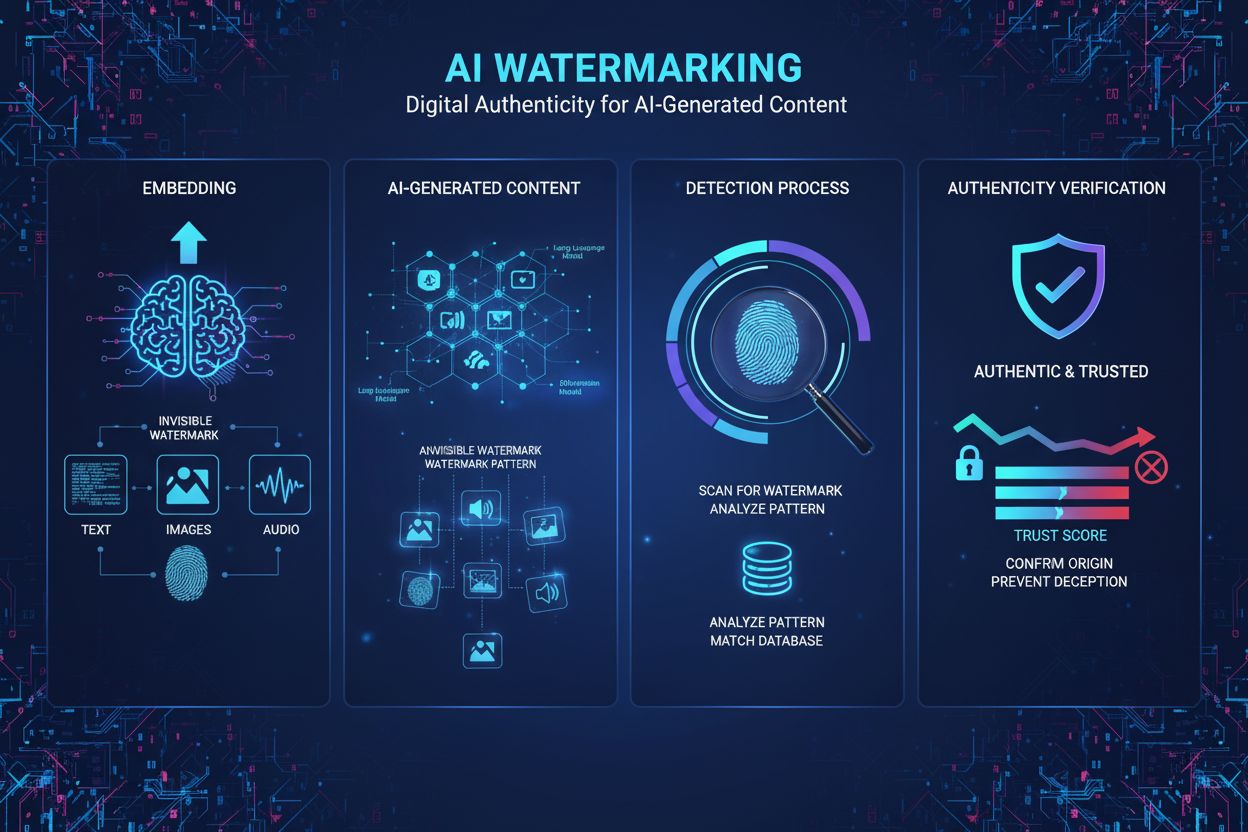
Ein KI-Text-Wasserzeichen ist ein Signal, das absichtlich in erzeugten Text eingebracht wird. Für einen Publisher ist die entscheidende Frage konkret: Können wir später die Ausgabe eines Generierungssystems erkennen, das wir selbst kontrollieren?
SynthID Text beantwortet genau diese Frage. Es stellt nicht fest, ob ein beliebiger Artikel von KI geschrieben wurde. Sein Detektor prüft auf ein konfiguriertes statistisches Muster, und ein erfolgloser Test lässt die Herkunft des Textes offen. Das SynthID-Referenz-Repository beschreibt sowohl die Erzeugung als auch die Erkennung von Wasserzeichen.
Dieser Leitfaden führt durch ein lokales Python-Beispiel und betrachtet anschließend die schwierigeren Fälle: mehrere Wasserzeichen, das Neuschreiben mit einem neuen Wasserzeichen und die Prüfung von Text, wenn die ursprünglichen Schlüssel unbekannt sind.
Was ein Text-Wasserzeichen tatsächlich verändert
Ein Sprachmodell weist möglichen nächsten Tokens Wahrscheinlichkeiten zu. Tokens können Wörter, Wortteile oder Satzzeichen repräsentieren. Ein generatives Wasserzeichen verändert, wie das nächste Token ausgewählt wird. Die daraus entstehenden Entscheidungen tragen einen Beleg in sich, den ein Detektor später messen kann.
SynthID verwendet ein Verfahren namens Tournament Sampling. Kandidaten-Tokens konkurrieren unter pseudozufälligen Bewertungsfunktionen. Der aktuelle Token-Kontext und die Wasserzeichen-Schlüssel bestimmen die Bewertungen. Die wiederholte Auswahl über mehrere Ebenen hinweg bevorzugt Tokens mit einem messbaren statistischen Muster. Der Detektor rekonstruiert diese Bewertungen aus dem fertigen Text. Er muss das ursprüngliche Sprachmodell nicht ausführen. Siehe das SynthID-Forschungspapier.
1. Mögliche nächste Tokens vorhersagen
Das Sprachmodell erzeugt eine Verteilung über sein Vokabular.2. Das konfigurierte Wasserzeichen anwenden
Schlüsselbasierte Bewertungsfunktionen beeinflussen die Token-Auswahl während der Generierung.3. Gewöhnlichen Text veröffentlichen
Das statistische Signal reist in der ausgewählten Token-Sequenz mit.4. Rekonstruieren und bewerten
Der Detektor nutzt eine kompatible Tokenisierung und die passende Konfiguration, um nach diesem Signal zu suchen.Längere Passagen liefern in der Regel mehr Belege. Hochgradig vorhersagbare Ausgaben lassen weniger alternative Tokens für das Wasserzeichen übrig. Mehr Ebenen können helfen, doch das Paper berichtet von abnehmendem Nutzen, da die Ebenen die verfügbare Variation bei der Token-Auswahl aufbrauchen.
Statistische Wasserzeichen und versteckte Zeichen sind etwas anderes
Bevor Sie einen Detektor auswählen, bestimmen Sie das Signal, das Sie finden wollen.
| Methode | Was trägt das Signal? | Was sollten Sie testen? |
|---|---|---|
| SynthID Text | Statistische Token-Entscheidungen während der Generierung | Belege unter einer passenden Wasserzeichen-Konfiguration |
| Markierung durch versteckte Zeichen | Bestimmte, in eine Zeichenkette eingefügte Zeichen | Die Zeichensequenz und ihre dokumentierte Kodierung |
| Dokument-Metadaten | Felder, die an ein Dokument oder einen Container angehängt sind | Die Metadaten, ihre Herkunft und eine etwaige Signatur |
| KI-Schreibstil-Klassifikator | Muster, die aus Beispieltexten gelernt wurden | Generalisierung und Falsch-Positive bei der Zielgruppe |
Ein Unicode-Scanner kann einen SynthID-Detektor nicht ersetzen. Das Auffinden eines ungewöhnlichen Zeichens belegt ebenfalls keine KI-Autorschaft. Unsere Einführung in die kostenlosen Tools von AmICited behandelt zeichenbasierte Wasserzeichen-Signale und ihre Grenzen. Das folgende Experiment betrifft statistische Wasserzeichen.

Bereit, Ihre KI-Sichtbarkeit zu überwachen?
Verfolgen Sie, wie KI-Chatbots Ihre Marke in ChatGPT, Perplexity und anderen Plattformen erwähnen.
Wasserzeichen-Text in Python erzeugen
Das Google-Repository ist eine Forschungsreferenz und rät ausdrücklich davon ab, seine Modell-Unterklassen in der Produktion zu verwenden. Es verweist auf die Implementierung in Hugging Face Transformers. Die Referenz bietet außerdem Mittelwert-, gewichteten Mittelwert- und trainierte Bayes’sche Erkennungsansätze. Nutzungshinweise des Repositorys
Das folgende Beispiel verwendet Python 3.13, Transformers 4.57.1 und PyTorch 2.8.0. Dies sind reproduzierbare Beispielversionen, keine Behauptung, dass es sich um die neuesten Releases handelt. Es läuft auf der CPU und lädt beim ersten Gebrauch das öffentliche Modell distilbert/distilgpt2 herunter. Dieses kleine Modell hält das Experiment zugänglich; seine Schreibqualität ist nicht repräsentativ für aktuelle Assistenten.
Erstellen Sie eine isolierte Umgebung:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Speichern Sie die Python-Blöcke aus diesem Leitfaden in der angegebenen Reihenfolge in watermark_demo.py. Beginnen Sie mit der Generierung:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Public demonstration keys. Never use these as a private production mark.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Keep the continuation; the supplied prompt was not watermarked.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
Die Generierung muss eine kompatible Sampling-Pipeline offenlegen. Eine fertige Antwort von einer gehosteten API in diese Konfiguration einzuspeisen, kann sie nicht nachträglich markieren. Ein separates Modell müsste eine neue Version erzeugen.
Erstellen Sie in der Produktion eindeutige Zufallsschlüssel und halten Sie die Konfiguration geheim. Bewahren Sie die Tokenizer-Revision, die Modell-Revision, die Konfigurationsversion und den zugehörigen Detektor auf. Eine Schlüsselrotation erzeugt eine neue Konfiguration; behalten Sie die alte Erkennungskonfiguration, wenn Sie ältere Ausgaben weiterhin erkennen müssen. Googles Implementierungshinweise
Wie die Wasserzeichen-Erkennung Belege berechnet
Die Erkennung beginnt damit, den Kandidatentext zu tokenisieren und für jedes zulässige Token-Fenster und jede Wasserzeichen-Ebene einen Wert zu rekonstruieren. In der hier verwendeten Implementierung heißen diese binären Werte g-Werte. Wir mitteln sie, nachdem wir wiederholte Kontexte sowie Positionen beim oder nach dem End-of-Sequence-Token ausgeschlossen haben. Die ersten vier Tokens einer Fortsetzung bilden für sich allein kein vollständiges Fenster aus fünf Tokens.
Die folgende Funktion verwendet die Bewertungs- und Maskierungsmethoden von Transformers. Sie akzeptiert jeweils eine ungepolsterte Sequenz und liefert einen rohen Mittelwert, keine Autorschafts-Wahrscheinlichkeit.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Boolean indexing retains the layer dimension.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
Die direkte Prüfung anhand der Token-IDs trennt die Generierung von der Text-Serialisierung. Die zweite Prüfung durchläuft den Pfad, den ein Detektor nach der Veröffentlichung sieht. Bewerten Sie Ihre tatsächliche Veröffentlichungs- und Textextraktions-Pipeline, denn sie kann die Eingabe verändern.
Ein Wert von 0,60 bedeutet keine 60-prozentige Wahrscheinlichkeit, dass KI den Text geschrieben hat. Diese Funktion hat keine kalibrierte Entscheidungsschwelle. Eine kurze Passage kann durch Zufall einen hohen Wert erzielen. Melden Sie ein nicht schlüssiges Ergebnis, wenn die Belege nicht ausreichen.
Für einen brauchbaren Detektor sammeln Sie repräsentativen menschlichen Text, Ausgaben von Modellen ohne Wasserzeichen und Ausgaben mit Wasserzeichen. Halten Sie Kalibrierungsdaten von den endgültigen Evaluationsdaten getrennt. Wählen Sie eine Schwelle für eine akzeptable Falsch-Positiv-Rate, bewerten Sie die Erkennungsraten an zurückgehaltenen Stichproben und schlüsseln Sie die Ergebnisse nach Sprache, Länge und Inhaltstyp auf. Ein einzelnes Paar aus markiertem und unmarkiertem Text prüft nur, ob das Beispiel läuft.
Als trainierte Alternative bietet Hugging Face einen Bayes’schen Detektor und einen Workflow zum Trainieren von Detektoren. Ein für andere Schlüssel trainierter Detektor ist kein direkter Ersatz für Ihren Detektor. Ein zufällig initialisierter Checkpoint oder ein Demo-Checkpoint belegt keine Erkennungsgenauigkeit.
Bleiben Sie bei KI-Sichtbarkeits-Trends auf dem Laufenden
Erhalten Sie die neuesten Erkenntnisse zu KI-Erwähnungen, Markenüberwachung und Optimierungsstrategien.
Kann man JEDES SynthID-Wasserzeichen ohne seine Schlüssel erkennen?
Der veröffentlichte Erkennungsansatz erfordert eine passende Konfiguration. Außerdem benötigen Sie eine kompatible Tokenisierung. Zu wissen, dass ein Anbieter den SynthID-Algorithmus verwendet, verschafft Ihnen nicht dessen Konfiguration, und das öffentliche Repository ist kein Detektor für die Ausgabe jedes Anbieters.
Google beschreibt private Detektoren, über eine API bereitgestellte Detektoren und öffentlich verteilte Detektoren. Ein Anbieter könnte eine Verifizierung anbieten, ohne seine private Konfiguration offenzulegen. Erkennung und Verifizierbarkeit
Für unser eigenes System können wir ein Register bekannter Konfigurationen prüfen. Fügen Sie dieses Beispiel hinzu, um die korrekten Schlüssel mit nicht zusammenhängenden Demonstrationsschlüsseln zu vergleichen:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Führen Sie die zusammengesetzte Datei mit python watermark_demo.py aus. Dieser Vergleich liefert Belege für zwei bekannte Konfigurationen. Er kann keinen beliebigen unbekannten Schlüssel entdecken und kennzeichnet bewusst keinen der beiden Werte als Erkennung.
Viele Konfigurationen zu prüfen bedeutet auch, viele statistische Tests durchzuführen. Wenn jeder Test Falsch-Positive zulässt, kann die Akzeptanz eines beliebigen positiven Ergebnisses die Gesamt-Falsch-Positiv-Rate erhöhen. Kalibrieren Sie das gesamte Suchverfahren. Wo einzelne Tests gültige p-Werte liefern, besteht eine konservative Option darin, das gesamte Falsch-Positiv-Budget durch die Anzahl der Tests zu teilen. Wenden Sie diese Rechnung nicht direkt auf den rohen mean_g-Wert an.
Wenn keine bekannte Konfiguration passt, lautet das angemessene Ergebnis “Kein unterstütztes Wasserzeichen erkannt”. Die Möglichkeiten umfassen weiterhin menschliches Schreiben, KI-Ausgaben ohne Wasserzeichen, ein unbekanntes Wasserzeichen und eine bearbeitete Passage, deren Signal zu schwach ist.
Kann derselbe Text mehrere SynthID-Wasserzeichen tragen?
Es sind zwei unterschiedliche Designs zu betrachten.
Mehrere Ebenen in einer Konfiguration
SynthID unterstützt bereits eine Liste von Schlüsseln. Im Beispiel erzeugen 30 Schlüssel 30 Ebenen innerhalb eines konfigurierten Wasserzeichens. Der Detektor kombiniert ihre Belege. Diese Schlüssel repräsentieren nicht automatisch 30 getrennt zuordenbare Autoren oder Organisationen. Wasserzeichen-Konfiguration
Unabhängig erkennbare Plattform- und Kundenmarkierungen
Angenommen, Sie möchten, dass ein plattformweiter Detektor und ein separater kundenspezifischer Detektor dieselbe Passage erkennen. Gruppen von Ebenen für diese Zwecke zuzuweisen, ist eine experimentelle Designoption, keine dokumentierte Garantie der Bibliothek.
Zwei Schlüssellisten einfach aneinanderzuhängen belegt nicht, dass beide ursprünglichen Detektoren weiterhin funktionieren. Jeder Detektor müsste anhand des kombinierten Generierungsprozesses evaluiert werden, einschließlich seiner Position in der Ebenenfolge. Messen Sie die Erkennungsrate jeder Markierung, Querübereinstimmungen mit anderen Kunden und das Verhalten nach Bearbeitungen. Dies ist ein technischer Vorschlag, der Experimente erfordert, und nicht die Behauptung, dass SynthID von Haus aus eine unabhängige Zuordnung zu mehreren Eigentümern bietet.
Wenn ein zentraler Dienst nur einen Kunden identifizieren muss, ist ein einfacheres Design eine Konfiguration pro Kunde mit einem internen Register. Dieses Design erfordert dennoch eine Kalibrierung über das gesamte Register. Es bietet keine separate plattformweite Markierung, die ohne Durchsuchen der Kundenkonfigurationen geprüft werden kann.
Kann man ein vorhandenes Wasserzeichen ersetzen?
SynthID speichert kein Feld wie watermark_id im Text. Es gibt keinen Metadatenwert, der überschrieben werden könnte. Das ursprüngliche Signal ist über die Token-Entscheidungen verteilt.
Wenn Sie eine Passage mit einem zweiten Generator mit Wasserzeichen neu schreiben, bringt der neue Generierungsprozess sein eigenes Signal ein. Die Wirkung auf das frühere Signal hängt von der resultierenden Token-Sequenz ab. Google berichtet, dass milde Bearbeitungen die Erkennbarkeit erhalten können, während gründliches Umschreiben oder Übersetzen die Konfidenz erheblich senken kann. Dokumentierte Grenzen der Transformation
Daraus folgt, dass ein zweites Wasserzeichen nicht garantiert, dass das erste gelöscht wird. Beide Signale können erkennbar bleiben, oder eines oder beide können unter ihre Erkennungsschwellen fallen. Dies ist eine Schlussfolgerung über einen kombinierten Workflow; die zitierte Dokumentation belegt keine Überlebensrate für jedes Paar von Wasserzeichen.
Eine unbekannte erste Konfiguration setzt eine praktische Grenze. Unser eigener Detektor kann unsere Markierung bewerten, aber er kann nicht belegen, dass die ursprüngliche Markierung verschwunden ist. Dafür ist der Zugang zum ursprünglichen passenden Detektor nötig. Selbst ein negatives Ergebnis bedeutet, dass der Detektor unter seinen Einstellungen nicht genügend Belege gefunden hat, nicht dass jede Spur entfernt wurde.
Wie man überlappende Wasserzeichen testet
Bevor Sie behaupten, dass Markierungen koexistieren oder dass eine die andere ersetzt, verwenden Sie eine Testmatrix. Die folgenden Einträge beschreiben durchzuführende Experimente, keine gemessenen Ergebnisse.
| Stichprobengruppe | Detektor A | Detektor B | Was der Vergleich prüft |
|---|---|---|---|
| Menschlicher Text und KI-Text ohne Wasserzeichen | Ausführen | Ausführen | Basiswert für Falsch-Positive |
| Nur mit A erzeugter Text | Ausführen | Ausführen | Erkennung durch A und versehentliche Treffer von B |
| Nur mit B erzeugter Text | Ausführen | Ausführen | Erkennung durch B und versehentliche Treffer von A |
| Text, der mit einer experimentellen kombinierten Konfiguration erzeugt wurde | Ausführen | Ausführen | Ob jede beabsichtigte Markierung erkennbar ist |
| Ein unter B neu geschriebener Text | Ausführen | Ausführen | Überleben von A und Erkennung durch B nach dem Umschreiben |
| Kurze Auszüge und bearbeitete Versionen jeder Gruppe | Ausführen | Ausführen | Empfindlichkeit gegenüber dem Veröffentlichungs-Workflow |
Verwenden Sie zurückgehaltene Prompts und berichten Sie nutzbare Textlängen, Stichprobenumfänge, Detektorversionen, Schwellenwerte und Falsch-Positiv-Raten. Geben Sie die Unsicherheit um die berichteten Raten an. Wiederholen Sie die Evaluation, wenn Sie Schlüssel, Tokenisierung, Modellversionen oder Generierungseinstellungen ändern. Solange diese Prüfungen fehlen, beschreiben Sie Koexistenz und Ersetzung als unbestätigt.
Was das für Publisher und KI-Sichtbarkeit bedeutet
Wasserzeichen-Erkennung und KI-Zitat-Monitoring beantworten unterschiedliche Fragen. Ein Wasserzeichen-Test fragt, ob eine Passage Belege für eine bestimmte Generierungskonfiguration enthält. Zitat-Monitoring prüft, welche Quellen in KI-Antworten erscheinen.
Stellen Sie ein fehlendes Wasserzeichen nicht als Beweis für menschliche Autorschaft dar, und ein erkanntes Wasserzeichen nicht als Beweis dafür, dass eine bestimmte Website zitiert wurde. Bewahren Sie für Veröffentlichungs-Workflows Generierungsprotokolle und redaktionelle Zuordnungen neben jedem statistischen Detektor auf. Jede Quelle liefert Belege, die die anderen nicht liefern.
 LinkedIn