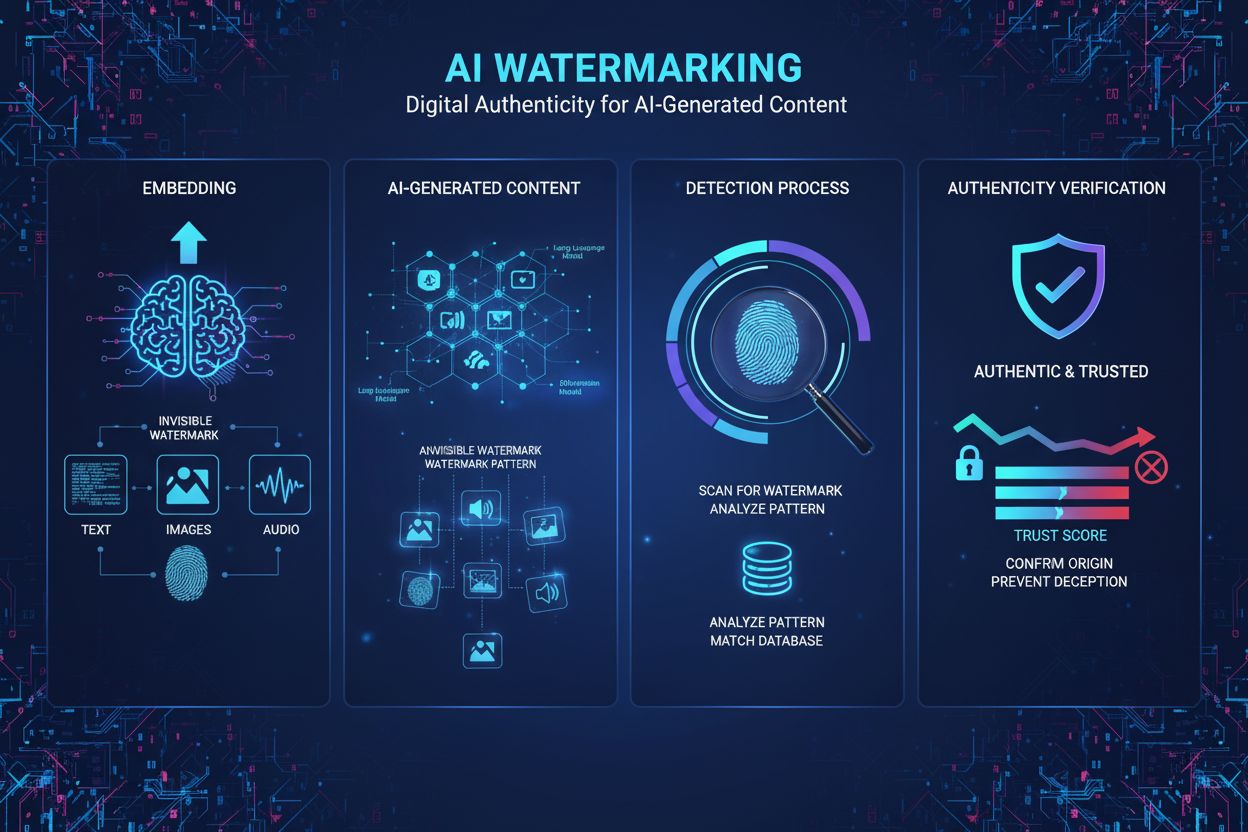
Un filigrane de texte IA est un signal introduit délibérément dans un texte généré. Pour un éditeur, la question utile est précise : pouvons-nous reconnaître plus tard la sortie d’un système de génération que nous contrôlons ?
SynthID Text répond à cette question. Il ne détermine pas si un article quelconque a été écrit par une IA. Son détecteur teste la présence d’un motif statistique configuré, et un test infructueux laisse l’origine du texte non résolue. Le dépôt de référence SynthID décrit à la fois la génération et la détection du filigrane.
Ce guide parcourt un exemple Python local, puis examine les cas plus difficiles : filigranes multiples, réécriture avec un nouveau filigrane et vérification d’un texte lorsque les clés d’origine sont inconnues.
Ce qu’un filigrane de texte change réellement
Un modèle de langage attribue des probabilités aux jetons suivants possibles. Les jetons peuvent représenter des mots, des parties de mots ou de la ponctuation. Un filigrane génératif modifie la manière dont le jeton suivant est sélectionné. Les choix qui en résultent portent des preuves qu’un détecteur peut mesurer plus tard.
SynthID utilise un processus appelé échantillonnage par tournoi. Les jetons candidats s’affrontent selon des fonctions de notation pseudo-aléatoires. Le contexte récent des jetons et les clés du filigrane déterminent les scores. La répétition de la sélection sur plusieurs couches favorise les jetons présentant un motif statistique mesurable. Le détecteur reconstruit ces scores à partir du texte finalisé. Il n’a pas besoin d’exécuter le modèle de langage d’origine. Voir l’ article de recherche SynthID.
1. Prédire les jetons suivants possibles
Le modèle de langage produit une distribution sur son vocabulaire.2. Appliquer le filigrane configuré
Les fonctions de notation à clé influencent la sélection des jetons pendant la génération.3. Publier un texte ordinaire
Le signal statistique circule dans la séquence de jetons sélectionnée.4. Reconstruire et noter
Le détecteur utilise une tokenisation compatible et la configuration correspondante pour rechercher ce signal.Les passages plus longs fournissent généralement davantage de preuves. Une sortie hautement prévisible laisse moins de jetons alternatifs disponibles pour le filigrane. Davantage de couches peut aider, mais l’article signale des rendements décroissants à mesure que les couches consomment la variation disponible dans la sélection des jetons.
Les filigranes statistiques et les caractères cachés sont différents
Avant de choisir un détecteur, identifiez le signal que vous souhaitez trouver.
| Méthode | Qu’est-ce qui porte le signal ? | Que devez-vous tester ? |
|---|---|---|
| SynthID Text | Choix statistiques de jetons effectués pendant la génération | Preuves sous une configuration de filigrane correspondante |
| Marqueur à caractères cachés | Caractères spécifiques insérés dans une chaîne | La séquence de caractères et son encodage documenté |
| Métadonnées du document | Champs attachés à un document ou à un conteneur | Les métadonnées, leur origine et toute signature |
| Classificateur d’écriture IA | Motifs appris à partir de textes d’exemple | La généralisation et les faux positifs sur le public visé |
Un scanner Unicode ne peut pas remplacer un détecteur SynthID. Trouver un caractère inhabituel n’établit pas non plus la paternité d’une IA. Notre introduction aux outils gratuits d’AmICited traite des signaux de filigrane basés sur les caractères et de leurs limites. L’expérience ci-dessous concerne le filigrane statistique.
Générer un texte filigrané en Python
Le dépôt de Google est une référence de recherche et déconseille explicitement d’utiliser ses sous-classes de modèle en production. Il renvoie à l’implémentation dans Hugging Face Transformers. La référence fournit également des approches de détection par moyenne, moyenne pondérée et bayésienne entraînée. Notes d’utilisation du dépôt
L’exemple suivant utilise Python 3.13, Transformers 4.57.1 et PyTorch 2.8.0. Ce sont des versions d’exemple reproductibles, et non l’affirmation qu’il s’agit des dernières versions publiées. Il s’exécute sur CPU et télécharge le modèle public distilbert/distilgpt2 lors de la première utilisation. Ce petit modèle rend l’expérience accessible ; sa qualité d’écriture n’est pas représentative des assistants actuels.
Créez un environnement isolé :
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Enregistrez les blocs Python de ce guide, dans l’ordre, dans watermark_demo.py. Commencez par la génération :
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Clés de démonstration publiques. Ne les utilisez jamais comme marque privée de production.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Conserver la suite ; l'invite fournie n'a pas été filigranée.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
La génération doit exposer un pipeline d’échantillonnage compatible. Transmettre une réponse finalisée d’une API hébergée à cette configuration ne peut pas la marquer rétroactivement. Un modèle distinct devrait générer une nouvelle version.
En production, créez des clés aléatoires uniques et gardez la configuration privée. Conservez la révision du tokenizer, la révision du modèle, la version de la configuration et le détecteur associé. Une rotation de clés crée une nouvelle configuration ; conservez l’ancienne configuration de détection si vous devez encore reconnaître des sorties plus anciennes. Recommandations d’implémentation de Google
Comment la détection de filigrane calcule les preuves
La détection commence par la tokenisation du texte candidat et la reconstruction d’un score pour chaque fenêtre de jetons éligible et chaque couche du filigrane. Dans l’implémentation utilisée ici, ces scores binaires sont appelés valeurs g. Nous en faisons la moyenne après avoir exclu les contextes répétés et les positions situées à ou après le jeton de fin de séquence. Les quatre premiers jetons d’une suite ne forment pas à eux seuls une fenêtre complète de cinq jetons.
La fonction suivante utilise les méthodes de notation et de masquage de Transformers. Elle accepte une séquence sans padding à la fois et renvoie une moyenne brute, et non une probabilité de paternité.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # L'indexation booléenne conserve la dimension de couche.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
La vérification directe par ID de jetons isole la génération de la sérialisation du texte. La seconde vérification exerce le chemin qu’un détecteur voit après publication. Évaluez votre propre pipeline de publication et d’extraction de texte, car il peut modifier l’entrée.
Un score de 0,60 ne signifie pas une probabilité de 60 % que l’IA ait écrit le texte. Cette fonction n’a pas de seuil de décision calibré. Un court passage peut obtenir un score élevé par hasard. Indiquez un résultat non concluant lorsque les preuves sont insuffisantes.
Pour obtenir un détecteur utile, collectez des textes humains représentatifs, des sorties de modèle non filigranées et des sorties filigranées. Gardez les données de calibration séparées des données d’évaluation finale. Choisissez un seuil pour un taux de faux positifs acceptable, évaluez les taux de détection sur des échantillons mis de côté et décomposez les résultats par langue, longueur et type de contenu. Une seule paire filigrané/non filigrané vérifie uniquement que l’exemple fonctionne.
Comme alternative entraînée, Hugging Face fournit un détecteur bayésien et un flux de travail d’entraînement de détecteur. Un détecteur entraîné sur des clés sans rapport n’est pas un remplacement direct de votre détecteur. Un point de contrôle initialisé aléatoirement ou de démonstration n’établit pas la précision de détection.

Restez informé des tendances de la visibilité IA
Recevez les dernières analyses sur les mentions par l'IA, la surveillance de marque et les stratégies d'optimisation.
Peut-on détecter N’IMPORTE QUEL filigrane SynthID sans ses clés ?
L’approche de détection publiée nécessite une configuration correspondante. Vous avez aussi besoin d’une tokenisation compatible. Savoir qu’un fournisseur utilise l’algorithme SynthID ne vous donne pas sa configuration, et le dépôt public n’est pas un détecteur pour la sortie de tous les fournisseurs.
Google décrit des détecteurs privés, des détecteurs exposés via une API et des détecteurs distribués publiquement. Un fournisseur pourrait proposer une vérification sans divulguer sa configuration privée. Détection et vérifiabilité
Pour notre propre système, nous pouvons consulter un registre de configurations connues. Ajoutez cet exemple pour comparer les bonnes clés avec des clés de démonstration sans rapport :
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Exécutez le fichier assemblé avec python watermark_demo.py. Cette comparaison produit des preuves pour deux configurations connues. Elle ne peut pas découvrir une clé inconnue arbitraire et elle n’étiquette intentionnellement aucun des deux scores comme une détection.
Vérifier de nombreuses configurations signifie aussi effectuer de nombreux tests statistiques. Si chaque test autorise des faux positifs, accepter n’importe quel résultat positif peut augmenter le taux global de faux positifs. Calibrez la procédure de recherche complète. Lorsque les tests individuels fournissent des valeurs p valides, une option conservatrice consiste à diviser la tolérance totale de faux positifs par le nombre de tests. N’appliquez pas ce calcul directement au score brut mean_g.
Si aucune configuration connue ne correspond, le résultat approprié est « Aucun filigrane pris en charge détecté ». Les possibilités incluent encore une écriture humaine, une sortie IA non filigranée, un filigrane inconnu et un passage modifié dont le signal est trop faible.
Un même texte peut-il porter plusieurs filigranes SynthID ?
Deux conceptions différentes sont à envisager.
Plusieurs couches dans une seule configuration
SynthID prend déjà en charge une liste de clés. Dans l’exemple, 30 clés créent 30 couches au sein d’un filigrane configuré. Le détecteur combine leurs preuves. Ces clés ne représentent pas automatiquement 30 auteurs ou organisations attribuables séparément. Configuration du filigrane
Marques de plateforme et de client détectables indépendamment
Supposons que vous souhaitiez qu’un détecteur à l’échelle de la plateforme et un détecteur distinct propre à un client reconnaissent le même passage. L’attribution de groupes de couches à ces usages est une option de conception expérimentale, et non une garantie documentée de la bibliothèque.
Le simple fait de concaténer deux listes de clés ne démontre pas que les deux détecteurs d’origine fonctionnent encore. Chaque détecteur devrait être évalué sur le processus de génération combiné, y compris sa position dans la séquence de couches. Mesurez le taux de détection de chaque marque, les correspondances croisées avec d’autres clients et le comportement après modification. Il s’agit d’une proposition d’ingénierie qui nécessite des expériences, et non d’une affirmation que SynthID fournit une attribution multi-propriétaires indépendante d’emblée.
Si un service central doit seulement identifier un client, une conception plus simple consiste en une configuration par client avec un registre interne. Cette conception nécessite tout de même une calibration sur l’ensemble du registre. Elle ne fournit pas de marque distincte à l’échelle de la plateforme qui puisse être vérifiée sans parcourir les configurations des clients.
Peut-on remplacer un filigrane existant ?
SynthID ne stocke pas de champ tel que watermark_id dans le texte. Il n’y a aucune valeur de métadonnée à écraser. Le signal d’origine est réparti sur l’ensemble des choix de jetons.
Si vous réécrivez un passage à l’aide d’un second générateur filigrané, le nouveau processus de génération introduit son propre signal. L’effet sur le signal antérieur dépend de la séquence de jetons obtenue. Google indique que des modifications légères peuvent préserver la détectabilité, tandis qu’une réécriture ou une traduction approfondie peut réduire considérablement la confiance. Limites documentées des transformations
Il s’ensuit qu’un second filigrane ne garantit pas l’effacement du premier. Les deux signaux peuvent rester détectables, ou l’un des deux, voire les deux, peuvent passer sous leurs seuils de détection. Il s’agit d’une inférence concernant un flux de travail combiné ; la documentation citée n’établit pas de taux de survie pour chaque paire de filigranes.
Une première configuration inconnue crée une limite pratique. Notre propre détecteur peut évaluer notre marque, mais il ne peut pas établir que la marque d’origine a disparu. Cela nécessite l’accès au détecteur correspondant d’origine. Même un résultat négatif signifie que le détecteur n’a pas trouvé suffisamment de preuves selon ses paramètres, et non la preuve que toute trace a été supprimée.
Comment tester des filigranes qui se chevauchent
Avant d’affirmer que des marques coexistent ou que l’une en remplace une autre, utilisez une matrice de tests. Les entrées ci-dessous décrivent des expériences à réaliser, et non des résultats mesurés.
| Groupe d’échantillons | Détecteur A | Détecteur B | Ce que la comparaison vérifie |
|---|---|---|---|
| Texte humain et texte IA non filigrané | Exécuter | Exécuter | Faux positifs de référence |
| Texte généré avec A uniquement | Exécuter | Exécuter | Détection de A et correspondances accidentelles avec B |
| Texte généré avec B uniquement | Exécuter | Exécuter | Détection de B et correspondances accidentelles avec A |
| Texte généré avec une configuration combinée expérimentale | Exécuter | Exécuter | Si chaque marque prévue est détectable |
| Un texte réécrit sous B | Exécuter | Exécuter | Survie de A et détection de B après réécriture |
| Extraits courts et versions modifiées de chaque groupe | Exécuter | Exécuter | Sensibilité au flux de travail de publication |
Utilisez des invites mises de côté et rapportez les longueurs de texte utilisables, le nombre d’échantillons, les versions des détecteurs, les seuils et les taux de faux positifs. Incluez l’incertitude autour des taux rapportés. Répétez l’évaluation lorsque vous changez les clés, la tokenisation, les versions de modèle ou les paramètres de génération. Tant que ces vérifications n’existent pas, décrivez la coexistence et le remplacement comme non vérifiés.
Ce que cela signifie pour les éditeurs et la visibilité dans l’IA
La détection de filigrane et la surveillance des citations IA répondent à des questions différentes. Un test de filigrane demande si un passage porte la preuve d’une configuration de génération particulière. La surveillance des citations vérifie quelles sources apparaissent dans les réponses IA.
Ne présentez pas un filigrane absent comme la preuve d’une paternité humaine, ni un filigrane détecté comme la preuve qu’un site web particulier a été cité. Pour les flux de travail de publication, conservez les enregistrements de génération et l’attribution éditoriale aux côtés de tout détecteur statistique. Chacun fournit des preuves que les autres ne fournissent pas.
 LinkedIn