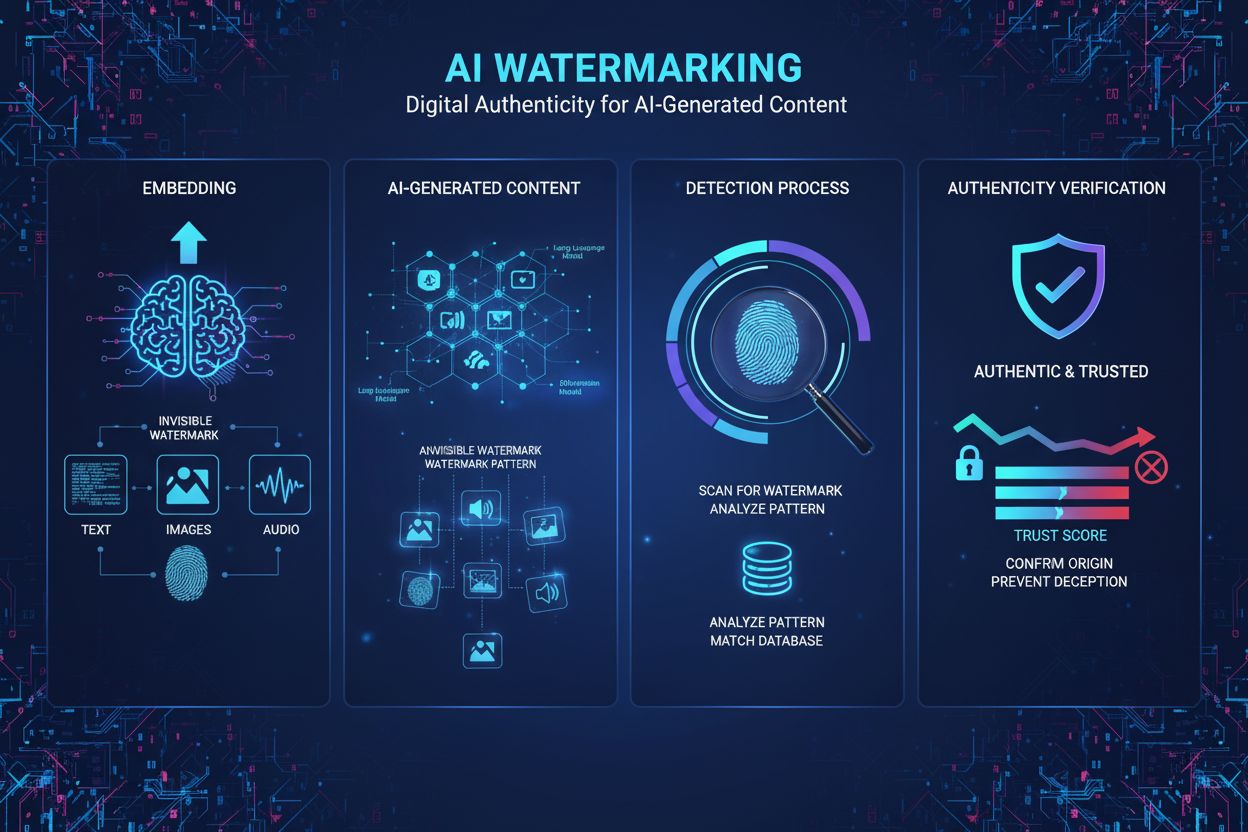
Uma marca d’água de texto com IA é um sinal introduzido deliberadamente em um texto gerado. Para um publisher, a pergunta útil é específica: conseguimos reconhecer mais tarde a saída de um sistema de geração que nós controlamos?
O SynthID Text responde a essa pergunta. Ele não determina se um artigo qualquer foi escrito por IA. Seu detector testa um padrão estatístico configurado, e um teste sem sucesso deixa a origem do texto indefinida. O repositório de referência do SynthID descreve tanto a geração quanto a detecção da marca d’água.
Este guia percorre um exemplo local em Python e, em seguida, examina os casos mais difíceis: múltiplas marcas d’água, reescrita com uma nova marca d’água e verificação de texto quando as chaves originais são desconhecidas.
O que uma marca d’água de texto realmente altera
Um modelo de linguagem atribui probabilidades aos possíveis próximos tokens. Tokens podem representar palavras, partes de palavras ou pontuação. Uma marca d’água generativa altera como o próximo token é selecionado. As escolhas resultantes carregam evidências que um detector pode medir depois.
O SynthID usa um processo chamado amostragem por torneio (tournament sampling). Os tokens candidatos competem sob funções de pontuação pseudorrandômicas. O contexto recente de tokens e as chaves da marca d’água determinam as pontuações. Repetir a seleção ao longo de várias camadas favorece tokens com um padrão estatístico mensurável. O detector reconstrói essas pontuações a partir do texto finalizado. Ele não precisa executar o modelo de linguagem original. Veja o artigo de pesquisa do SynthID.
1. Prever os possíveis próximos tokens
O modelo de linguagem produz uma distribuição sobre seu vocabulário.2. Aplicar a marca d'água configurada
Funções de pontuação com chave influenciam a seleção de tokens durante a geração.3. Publicar texto comum
O sinal estatístico viaja na sequência de tokens selecionada.4. Reconstruir e pontuar
O detector usa uma tokenização compatível e a configuração correspondente para procurar esse sinal.Passagens mais longas geralmente fornecem mais evidências. Saídas altamente previsíveis deixam menos tokens alternativos disponíveis para a marca d’água. Mais camadas podem ajudar, mas o artigo relata retornos decrescentes à medida que as camadas consomem a variação disponível na seleção de tokens.
Marcas d’água estatísticas e caracteres ocultos são coisas diferentes
Antes de escolher um detector, identifique o sinal que você pretende encontrar.
| Método | O que carrega o sinal? | O que você deve testar? |
|---|---|---|
| SynthID Text | Escolhas estatísticas de tokens feitas durante a geração | Evidência sob uma configuração de marca d’água correspondente |
| Marcador de caracteres ocultos | Caracteres específicos inseridos em uma string | A sequência de caracteres e sua codificação documentada |
| Metadados do documento | Campos anexados a um documento ou contêiner | Os metadados, sua origem e qualquer assinatura |
| Classificador de escrita por IA | Padrões aprendidos a partir de textos de exemplo | Generalização e falsos positivos no público-alvo |
Um scanner de Unicode não substitui um detector do SynthID. Encontrar um caractere incomum também não estabelece autoria por IA. Nossa introdução às ferramentas gratuitas do AmICited discute sinais de marca d’água baseados em caracteres e seus limites. O experimento abaixo trata de marca d’água estatística.
Gerar texto com marca d’água em Python
O repositório do Google é uma referência de pesquisa e recomenda explicitamente não usar suas subclasses de modelo em produção. Ele aponta para a implementação no Hugging Face Transformers. A referência também oferece abordagens de detecção por média, média ponderada e bayesiana treinada. Notas de uso do repositório
O exemplo a seguir usa Python 3.13, Transformers 4.57.1 e PyTorch 2.8.0. Essas são versões de exemplo reproduzíveis, não uma afirmação de que sejam as versões mais recentes. Ele roda em CPU e baixa o modelo público distilbert/distilgpt2 no primeiro uso. Esse modelo pequeno mantém o experimento acessível; sua qualidade de escrita não é representativa dos assistentes atuais.
Crie um ambiente isolado:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Salve os blocos Python deste guia, na ordem, em watermark_demo.py. Comece pela geração:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Public demonstration keys. Never use these as a private production mark.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Keep the continuation; the supplied prompt was not watermarked.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
A geração precisa expor um pipeline de amostragem compatível. Passar uma resposta já finalizada de uma API hospedada para essa configuração não pode marcá-la retroativamente. Seria necessário um modelo separado para gerar uma nova versão.
Em produção, crie chaves aleatórias exclusivas e mantenha a configuração privada. Guarde a revisão do tokenizador, a revisão do modelo, a versão da configuração e o detector associado. Uma rotação de chaves cria uma nova configuração; mantenha a configuração de detecção antiga se ainda precisar reconhecer saídas mais antigas. Orientações de implementação do Google
Como a detecção de marca d’água calcula evidências
A detecção começa tokenizando o texto candidato e reconstruindo uma pontuação para cada janela de tokens elegível e cada camada da marca d’água. Na implementação usada aqui, essas pontuações binárias são chamadas de valores g. Fazemos a média delas após excluir contextos repetidos e posições iguais ou posteriores ao token de fim de sequência. Os primeiros quatro tokens de uma continuação não formam, por si sós, uma janela completa de cinco tokens.
A função a seguir usa os métodos de pontuação e mascaramento do Transformers. Ela aceita uma sequência sem padding por vez e retorna uma média bruta, não uma probabilidade de autoria.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Boolean indexing retains the layer dimension.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
A verificação direta dos IDs dos tokens isola a geração da serialização do texto. A segunda verificação exercita o caminho que um detector vê após a publicação. Avalie seu pipeline real de publicação e extração de texto, porque ele pode alterar a entrada.
Uma pontuação de 0,60 não significa 60% de probabilidade de que a IA escreveu o texto. Essa função não tem um limiar de decisão calibrado. Uma passagem curta pode obter uma pontuação alta por acaso. Relate um resultado inconclusivo quando as evidências forem insuficientes.
Para ter um detector útil, colete textos humanos representativos, saídas de modelo sem marca d’água e saídas com marca d’água. Mantenha os dados de calibração separados dos dados de avaliação final. Escolha um limiar para uma taxa aceitável de falsos positivos, avalie as taxas de detecção em amostras reservadas e detalhe os resultados por idioma, comprimento e tipo de conteúdo. Um único par marcado/não marcado apenas verifica se o exemplo executa.
Como alternativa treinada, o Hugging Face fornece um detector bayesiano e um fluxo de trabalho de treinamento de detector. Um detector treinado para chaves não relacionadas não substitui diretamente o seu detector. Um checkpoint inicializado aleatoriamente ou de demonstração não estabelece precisão de detecção.

Fique a par das tendências de visibilidade em IA
Receba as últimas novidades sobre menções em IA, monitorização de marca e estratégias de otimização.
É possível detectar QUALQUER marca d’água do SynthID sem suas chaves?
A abordagem de detecção publicada exige uma configuração correspondente. Você também precisa de uma tokenização compatível. Saber que um provedor usa o algoritmo SynthID não lhe dá sua configuração, e o repositório público não é um detector para a saída de todos os provedores.
O Google descreve detectores privados, detectores expostos por meio de uma API e detectores distribuídos publicamente. Um provedor poderia oferecer verificação sem divulgar sua configuração privada. Detecção e verificabilidade
Para o nosso próprio sistema, podemos consultar um registro de configurações conhecidas. Anexe este exemplo para comparar as chaves corretas com chaves de demonstração não relacionadas:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Execute o arquivo montado com python watermark_demo.py. Essa comparação produz evidências para duas configurações conhecidas. Ela não consegue descobrir uma chave desconhecida arbitrária e, intencionalmente, não rotula nenhuma das pontuações como detecção.
Verificar muitas configurações também significa realizar muitos testes estatísticos. Se cada teste permite falsos positivos, aceitar qualquer positivo pode aumentar a taxa geral de falsos positivos. Calibre o procedimento de busca completo. Quando testes individuais fornecem p-valores válidos, uma opção conservadora é dividir a margem total de falsos positivos pelo número de testes. Não aplique essa aritmética diretamente à pontuação bruta mean_g.
Se nenhuma configuração conhecida corresponder, o resultado adequado é “Nenhuma marca d’água suportada detectada”. As possibilidades ainda incluem escrita humana, saída de IA sem marca d’água, uma marca d’água desconhecida e uma passagem editada cujo sinal é fraco demais.
O mesmo texto pode carregar múltiplas marcas d’água do SynthID?
Há dois projetos diferentes a considerar.
Múltiplas camadas em uma única configuração
O SynthID já suporta uma lista de chaves. No exemplo, 30 chaves criam 30 camadas dentro de uma marca d’água configurada. O detector combina as evidências delas. Essas chaves não representam automaticamente 30 autores ou organizações atribuíveis separadamente. Configuração da marca d’água
Marcas de plataforma e de cliente detectáveis de forma independente
Suponha que você queira um detector de toda a plataforma e um detector separado específico de cliente reconhecendo a mesma passagem. Alocar grupos de camadas para esses propósitos é uma opção de projeto experimental, não uma garantia documentada da biblioteca.
Simplesmente concatenar duas listas de chaves não demonstra que os dois detectores originais ainda funcionam. Cada detector precisaria ser avaliado sobre o processo de geração combinado, incluindo sua posição na sequência de camadas. Meça a taxa de detecção de cada marca, as correspondências cruzadas com outros clientes e o comportamento após edições. Esta é uma proposta de engenharia que precisa de experimentos, e não uma afirmação de que o SynthID oferece atribuição independente a múltiplos proprietários logo de saída.
Se um serviço central só precisa identificar um cliente, um projeto mais simples é uma configuração por cliente com um registro interno. Esse projeto ainda precisa de calibração em todo o registro. Ele não fornece uma marca separada de toda a plataforma que possa ser verificada sem buscar nas configurações de clientes.
É possível substituir uma marca d’água existente?
O SynthID não armazena um campo como watermark_id no texto. Não há valor de metadado a sobrescrever. O sinal original está distribuído pelas escolhas de tokens.
Se você reescrever uma passagem usando um segundo gerador com marca d’água, o novo processo de geração introduz seu próprio sinal. O efeito sobre o sinal anterior depende da sequência de tokens resultante. O Google relata que edições leves podem preservar a detectabilidade, enquanto uma reescrita completa ou uma tradução podem reduzir substancialmente a confiança. Limites documentados de transformação
Segue-se que uma segunda marca d’água não garante o apagamento da primeira. Ambos os sinais podem permanecer detectáveis, ou um ou ambos podem ficar abaixo de seus limiares de detecção. Esta é uma inferência sobre um fluxo de trabalho combinado; a documentação citada não estabelece uma taxa de sobrevivência para cada par de marcas d’água.
Uma primeira configuração desconhecida cria um limite prático. Nosso próprio detector pode avaliar nossa marca, mas não pode estabelecer que a marca original desapareceu. Isso exige acesso ao detector correspondente original. Até um resultado negativo significa que o detector não encontrou evidências suficientes com suas configurações, e não prova de que todo vestígio foi removido.
Como testar marcas d’água sobrepostas
Antes de afirmar que marcas coexistem ou que uma substitui a outra, use uma matriz de testes. As entradas abaixo descrevem experimentos a executar, não resultados medidos.
| Grupo de amostras | Detector A | Detector B | O que a comparação verifica |
|---|---|---|---|
| Texto humano e texto de IA sem marca d’água | Executar | Executar | Falsos positivos de linha de base |
| Texto gerado apenas com A | Executar | Executar | Detecção de A e correspondências acidentais com B |
| Texto gerado apenas com B | Executar | Executar | Detecção de B e correspondências acidentais com A |
| Texto gerado com uma configuração combinada experimental | Executar | Executar | Se cada marca pretendida é detectável |
| Texto A reescrito sob B | Executar | Executar | Sobrevivência de A e detecção de B após a reescrita |
| Trechos curtos e versões editadas de cada grupo | Executar | Executar | Sensibilidade ao fluxo de trabalho de publicação |
Use prompts reservados e informe os comprimentos de texto utilizáveis, as contagens de amostras, as versões dos detectores, os limiares e as taxas de falsos positivos. Inclua a incerteza em torno das taxas relatadas. Repita a avaliação quando você alterar chaves, tokenização, versões de modelo ou configurações de geração. Até que essas verificações existam, descreva a coexistência e a substituição como não verificadas.
O que isso significa para publishers e visibilidade em IA
A detecção de marca d’água e o monitoramento de citações por IA respondem a perguntas diferentes. Um teste de marca d’água pergunta se uma passagem carrega evidências de uma configuração de geração específica. O monitoramento de citações verifica quais fontes aparecem nas respostas de IA.
Não apresente uma marca d’água ausente como prova de autoria humana, nem uma marca d’água detectada como prova de que um site específico foi citado. Para fluxos de trabalho de publicação, mantenha registros de geração e atribuição editorial junto de qualquer detector estatístico. Cada um fornece evidências que os outros não fornecem.
 LinkedIn