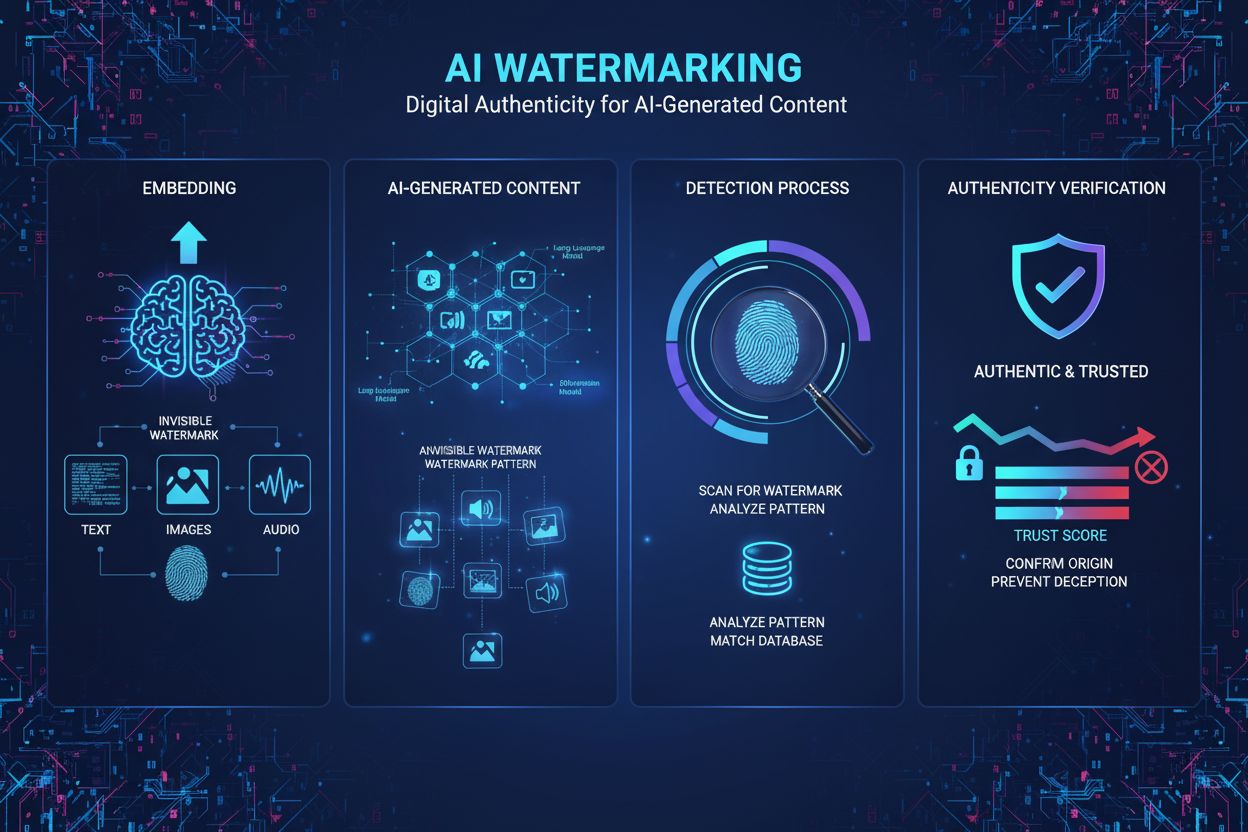
Znak wodny tekstu AI to sygnał celowo wprowadzony do wygenerowanego tekstu. Dla wydawcy użyteczne pytanie jest konkretne: czy potrafimy później rozpoznać wynik działania systemu generującego, który kontrolujemy?
SynthID Text odpowiada na to pytanie. Nie rozstrzyga, czy dowolny artykuł napisała AI. Jego detektor sprawdza skonfigurowany wzorzec statystyczny, a nieudany test pozostawia pochodzenie tekstu nierozstrzygnięte. Repozytorium referencyjne SynthID opisuje zarówno generowanie znaku wodnego, jak i jego wykrywanie.
Ten przewodnik przechodzi przez lokalny przykład w Pythonie, a następnie analizuje trudniejsze przypadki: wiele znaków wodnych, przepisywanie z nowym znakiem wodnym oraz sprawdzanie tekstu, gdy oryginalne klucze są nieznane.
Co tak naprawdę zmienia znak wodny w tekście
Model językowy przypisuje prawdopodobieństwa możliwym kolejnym tokenom. Tokeny mogą reprezentować słowa, części słów lub znaki interpunkcyjne. Generatywny znak wodny zmienia sposób wyboru kolejnego tokenu. Wynikające z tego wybory niosą dowód, który detektor może później zmierzyć.
SynthID wykorzystuje proces zwany próbkowaniem turniejowym. Kandydujące tokeny konkurują ze sobą w ramach pseudolosowych funkcji oceniających. O wyniku decyduje ostatni kontekst tokenów oraz klucze znaku wodnego. Powtarzanie wyboru przez kilka warstw faworyzuje tokeny o mierzalnym wzorcu statystycznym. Detektor odtwarza te wyniki na podstawie gotowego tekstu. Nie musi uruchamiać oryginalnego modelu językowego. Zobacz pracę badawczą o SynthID.
1. Przewidź możliwe kolejne tokeny
Model językowy tworzy rozkład prawdopodobieństwa na swoim słowniku.2. Zastosuj skonfigurowany znak wodny
Funkcje oceniające oparte na kluczach wpływają na wybór tokenów podczas generowania.3. Opublikuj zwykły tekst
Sygnał statystyczny podróżuje w wybranej sekwencji tokenów.4. Odtwórz i oceń
Detektor używa zgodnej tokenizacji i pasującej konfiguracji, aby szukać tego sygnału.Dłuższe fragmenty zazwyczaj dostarczają więcej dowodów. Wysoce przewidywalne dane wyjściowe pozostawiają mniej alternatywnych tokenów dostępnych dla znaku wodnego. Więcej warstw może pomóc, ale praca badawcza opisuje malejące korzyści, gdy warstwy wyczerpują dostępną zmienność w wyborze tokenów.
Znaki wodne statystyczne i ukryte znaki to coś innego
Zanim wybierzesz detektor, ustal, jakiego sygnału zamierzasz szukać.
| Metoda | Co przenosi sygnał? | Co należy przetestować? |
|---|---|---|
| SynthID Text | Statystyczne wybory tokenów dokonane podczas generowania | Dowód przy pasującej konfiguracji znaku wodnego |
| Znacznik ukrytych znaków | Konkretne znaki wstawione do ciągu tekstowego | Sekwencja znaków i jej udokumentowane kodowanie |
| Metadane dokumentu | Pola dołączone do dokumentu lub kontenera | Metadane, ich pochodzenie i ewentualny podpis |
| Klasyfikator tekstu pisanego przez AI | Wzorce wyuczone na przykładowych tekstach | Generalizacja i fałszywe trafienia w docelowej grupie odbiorców |
Skaner Unicode nie może zastąpić detektora SynthID. Znalezienie nietypowego znaku również nie dowodzi autorstwa AI. Nasze wprowadzenie do darmowych narzędzi AmICited omawia znaki wodne oparte na znakach i ich ograniczenia. Poniższy eksperyment dotyczy znakowania wodnego statystycznego.

Gotowy, by monitorować swoją widoczność w AI?
Śledź, jak chatboty AI wspominają Twoją markę w ChatGPT, Perplexity i innych platformach.
Wygeneruj tekst ze znakiem wodnym w Pythonie
Repozytorium Google jest materiałem referencyjnym i wyraźnie odradza używanie swoich podklas modelu w środowisku produkcyjnym. Wskazuje na implementację w Hugging Face Transformers. Materiał referencyjny udostępnia także podejścia detekcyjne oparte na średniej, średniej ważonej i wytrenowanym detektorze bayesowskim. Uwagi o korzystaniu z repozytorium
Poniższy przykład używa Pythona 3.13, Transformers 4.57.1 i PyTorch 2.8.0. To odtwarzalne wersje przykładowe, a nie twierdzenie, że są to najnowsze wydania. Działa na CPU i przy pierwszym użyciu pobiera publiczny model distilbert/distilgpt2. Ten mały model utrzymuje eksperyment w zasięgu; jakość jego pisania nie jest reprezentatywna dla obecnych asystentów.
Utwórz izolowane środowisko:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Zapisz bloki Pythona z tego przewodnika, po kolei, w pliku watermark_demo.py. Zacznij od generowania:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Public demonstration keys. Never use these as a private production mark.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Keep the continuation; the supplied prompt was not watermarked.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
Generowanie musi ujawniać zgodny potok próbkowania. Przekazanie gotowej odpowiedzi z hostowanego API do tej konfiguracji nie może oznaczyć jej wstecznie. Osobny model musiałby wygenerować nową wersję.
W środowisku produkcyjnym utwórz unikalne losowe klucze i zachowaj konfigurację w tajemnicy. Zachowaj wersję tokenizera, wersję modelu, wersję konfiguracji i powiązany detektor. Rotacja kluczy tworzy nową konfigurację; zachowaj starą konfigurację wykrywania, jeśli nadal musisz rozpoznawać starsze dane wyjściowe. Wskazówki Google dotyczące implementacji
Jak wykrywanie znaku wodnego oblicza dowód
Wykrywanie zaczyna się od tokenizacji tekstu kandydującego i odtworzenia wyniku dla każdego kwalifikującego się okna tokenów i każdej warstwy znaku wodnego. W wykorzystywanej tu implementacji te binarne wyniki nazywane są wartościami g. Uśredniamy je po wykluczeniu powtarzających się kontekstów oraz pozycji na tokenie końca sekwencji lub po nim. Pierwsze cztery tokeny kontynuacji same nie tworzą kompletnego okna pięciu tokenów.
Poniższa funkcja korzysta z metod oceniania i maskowania w Transformers. Przyjmuje jedną sekwencję bez dopełnienia naraz i zwraca surową średnią, a nie prawdopodobieństwo autorstwa.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Boolean indexing retains the layer dimension.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
Bezpośrednie sprawdzenie identyfikatorów tokenów oddziela generowanie od serializacji tekstu. Drugie sprawdzenie ćwiczy ścieżkę, którą detektor widzi po publikacji. Oceń swój rzeczywisty potok publikowania i wyodrębniania tekstu, ponieważ może on zmienić dane wejściowe.
Wynik 0,60 nie oznacza 60% prawdopodobieństwa, że tekst napisała AI. Ta funkcja nie ma skalibrowanego progu decyzyjnego. Krótki fragment może przypadkowo uzyskać wysoki wynik. Zgłoś wynik nierozstrzygający, gdy dowody są niewystarczające.
Aby uzyskać użyteczny detektor, zbierz reprezentatywny tekst ludzki, dane wyjściowe modelu bez znaku wodnego oraz dane wyjściowe ze znakiem wodnym. Trzymaj dane kalibracyjne oddzielnie od danych do finalnej oceny. Wybierz próg dla akceptowalnego odsetka fałszywych trafień, oceń wskaźniki wykrywalności na próbkach odłożonych, a wyniki rozbij według języka, długości i typu treści. Pojedyncza para oznaczony/nieoznaczony sprawdza tylko, że przykład działa.
Jako wytrenowaną alternatywę Hugging Face udostępnia detektor bayesowski oraz proces trenowania detektora. Detektor wytrenowany dla niepowiązanych kluczy nie jest zamiennikiem Twojego detektora. Losowo zainicjowany punkt kontrolny lub punkt demonstracyjny nie potwierdza dokładności wykrywania.
Bądź na bieżąco z trendami widoczności w AI
Otrzymuj najnowsze analizy dotyczące wzmianek w AI, monitoringu marki i strategii optymalizacji.
Czy można wykryć DOWOLNY znak wodny SynthID bez jego kluczy?
Opublikowane podejście do wykrywania wymaga pasującej konfiguracji. Potrzebna jest też zgodna tokenizacja. Sama wiedza, że dostawca używa algorytmu SynthID, nie daje jego konfiguracji, a publiczne repozytorium nie jest detektorem dla danych wyjściowych każdego dostawcy.
Google opisuje detektory prywatne, detektory udostępniane przez API oraz detektory rozpowszechniane publicznie. Dostawca mógłby zaoferować weryfikację bez ujawniania swojej prywatnej konfiguracji. Wykrywanie i weryfikowalność
W naszym własnym systemie możemy sprawdzić rejestr znanych konfiguracji. Dołącz ten przykład, aby porównać poprawne klucze z niepowiązanymi kluczami demonstracyjnymi:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Uruchom złożony plik poleceniem python watermark_demo.py. To porównanie daje dowody dla dwóch znanych konfiguracji. Nie potrafi odkryć dowolnego nieznanego klucza i celowo nie oznacza żadnego z wyników jako wykrycia.
Sprawdzanie wielu konfiguracji oznacza również przeprowadzanie wielu testów statystycznych. Jeśli każdy test dopuszcza fałszywe trafienia, zaakceptowanie dowolnego wyniku pozytywnego może zwiększyć ogólny odsetek fałszywych trafień. Skalibruj całą procedurę wyszukiwania. Tam, gdzie pojedyncze testy dają poprawne wartości p, konserwatywną opcją jest podzielenie całkowitego dopuszczalnego odsetka fałszywych trafień przez liczbę testów. Nie stosuj tej arytmetyki bezpośrednio do surowego wyniku mean_g.
Jeśli żadna znana konfiguracja nie pasuje, właściwym wynikiem jest „Nie wykryto obsługiwanego znaku wodnego”. Możliwości nadal obejmują pisanie przez człowieka, dane wyjściowe AI bez znaku wodnego, nieznany znak wodny oraz edytowany fragment, którego sygnał jest zbyt słaby.
Czy ten sam tekst może nieść wiele znaków wodnych SynthID?
Rozważamy dwa różne rozwiązania.
Wiele warstw w jednej konfiguracji
SynthID już obsługuje listę kluczy. W przykładzie 30 kluczy tworzy 30 warstw w ramach jednego skonfigurowanego znaku wodnego. Detektor łączy ich dowody. Te klucze nie reprezentują automatycznie 30 osobno przypisywalnych autorów lub organizacji. Konfiguracja znaku wodnego
Niezależnie wykrywalne oznaczenia platformy i klienta
Załóżmy, że chcesz, aby detektor obejmujący całą platformę oraz osobny detektor dla konkretnego klienta rozpoznawały ten sam fragment. Przydzielenie grup warstw do tych celów jest opcją projektową eksperymentalną, a nie udokumentowaną gwarancją biblioteki.
Samo połączenie dwóch list kluczy nie dowodzi, że oba oryginalne detektory nadal działają. Każdy detektor wymagałby oceny na połączonym procesie generowania, w tym pod kątem swojej pozycji w sekwencji warstw. Zmierz wskaźnik wykrywalności każdego oznaczenia, trafienia krzyżowe względem innych klientów oraz zachowanie po edycjach. To propozycja inżynieryjna wymagająca eksperymentów, a nie twierdzenie, że SynthID zapewnia niezależne przypisanie wielu właścicieli od razu.
Jeśli usługa centralna musi jedynie zidentyfikować klienta, prostszym rozwiązaniem jest jedna konfiguracja na klienta z wewnętrznym rejestrem. To rozwiązanie nadal wymaga kalibracji w całym rejestrze. Nie zapewnia osobnego oznaczenia obejmującego całą platformę, które można sprawdzić bez przeszukiwania konfiguracji klientów.
Czy można zastąpić istniejący znak wodny?
SynthID nie przechowuje w tekście pola takiego jak watermark_id. Nie ma wartości metadanej, którą można nadpisać. Oryginalny sygnał jest rozproszony w wyborach tokenów.
Jeśli przepiszesz fragment przy użyciu drugiego generatora ze znakiem wodnym, nowy proces generowania wprowadza własny sygnał. Wpływ na wcześniejszy sygnał zależy od wynikowej sekwencji tokenów. Google podaje, że łagodne edycje mogą zachować wykrywalność, natomiast dokładne przepisanie lub tłumaczenie może znacznie obniżyć pewność. Udokumentowane ograniczenia transformacji
Wynika z tego, że drugi znak wodny nie gwarantuje usunięcia pierwszego. Oba sygnały mogą pozostać wykrywalne albo jeden lub oba mogą spaść poniżej swoich progów wykrywania. To wnioskowanie o połączonym procesie pracy; przywołana dokumentacja nie ustala wskaźnika przetrwania dla każdej pary znaków wodnych.
Nieznana pierwsza konfiguracja tworzy praktyczne ograniczenie. Nasz własny detektor może ocenić nasze oznaczenie, ale nie może ustalić, że oryginalne oznaczenie zniknęło. Wymaga to dostępu do oryginalnego pasującego detektora. Nawet wynik negatywny oznacza, że detektor nie znalazł wystarczających dowodów przy swoich ustawieniach, a nie dowód, że usunięto każdy ślad.
Jak testować nakładające się znaki wodne
Zanim stwierdzisz, że oznaczenia współistnieją albo że jedno zastępuje drugie, użyj macierzy testowej. Poniższe pozycje opisują eksperymenty do przeprowadzenia, a nie zmierzone wyniki.
| Grupa próbek | Detektor A | Detektor B | Co sprawdza porównanie |
|---|---|---|---|
| Tekst ludzki i tekst AI bez znaku wodnego | Uruchom | Uruchom | Bazowy poziom fałszywych trafień |
| Tekst wygenerowany tylko z A | Uruchom | Uruchom | Wykrycie A i przypadkowe trafienia B |
| Tekst wygenerowany tylko z B | Uruchom | Uruchom | Wykrycie B i przypadkowe trafienia A |
| Tekst wygenerowany z eksperymentalną konfiguracją połączoną | Uruchom | Uruchom | Czy każde zamierzone oznaczenie jest wykrywalne |
| Tekst przepisany pod B | Uruchom | Uruchom | Przetrwanie A i wykrycie B po przepisaniu |
| Krótkie wyjątki i edytowane wersje każdej grupy | Uruchom | Uruchom | Wrażliwość na potok publikowania |
Używaj odłożonych promptów i podawaj użyteczne długości tekstu, liczebność próbek, wersje detektorów, progi oraz odsetki fałszywych trafień. Podaj niepewność wokół raportowanych wskaźników. Powtarzaj ocenę, gdy zmieniasz klucze, tokenizację, wersje modelu lub ustawienia generowania. Dopóki takie kontrole nie istnieją, opisuj współistnienie i zastępowanie jako niezweryfikowane.
Co to oznacza dla wydawców i widoczności w AI
Wykrywanie znaków wodnych i monitorowanie cytowań AI odpowiadają na różne pytania. Test znaku wodnego pyta, czy fragment niesie dowód konkretnej konfiguracji generowania. Monitorowanie cytowań sprawdza, które źródła pojawiają się w odpowiedziach AI.
Nie przedstawiaj braku znaku wodnego jako dowodu autorstwa człowieka ani wykrytego znaku wodnego jako dowodu, że cytowano konkretną witrynę. W procesach publikowania przechowuj zapisy generowania i przypisanie redakcyjne obok dowolnego detektora statystycznego. Każdy z nich dostarcza dowodów, których nie dają pozostałe.
 LinkedIn