Un watermark de text AI este un semnal introdus în mod deliberat în textul generat. Pentru un editor, întrebarea utilă este specifică: putem recunoaște mai târziu rezultatul unui sistem de generare pe care îl controlăm?
SynthID Text răspunde la această întrebare. Nu stabilește dacă un articol oarecare a fost scris de AI. Detectorul său testează un tipar statistic configurat, iar un test nereușit lasă originea textului nerezolvată. Repozitoriul de referință SynthID descrie atât generarea watermark-ului, cât și detectarea lui.
Acest ghid parcurge un exemplu Python local, apoi examinează cazurile mai dificile: mai multe watermark-uri, rescrierea cu un watermark nou și verificarea textului atunci când cheile originale sunt necunoscute.
Ce schimbă de fapt un watermark de text
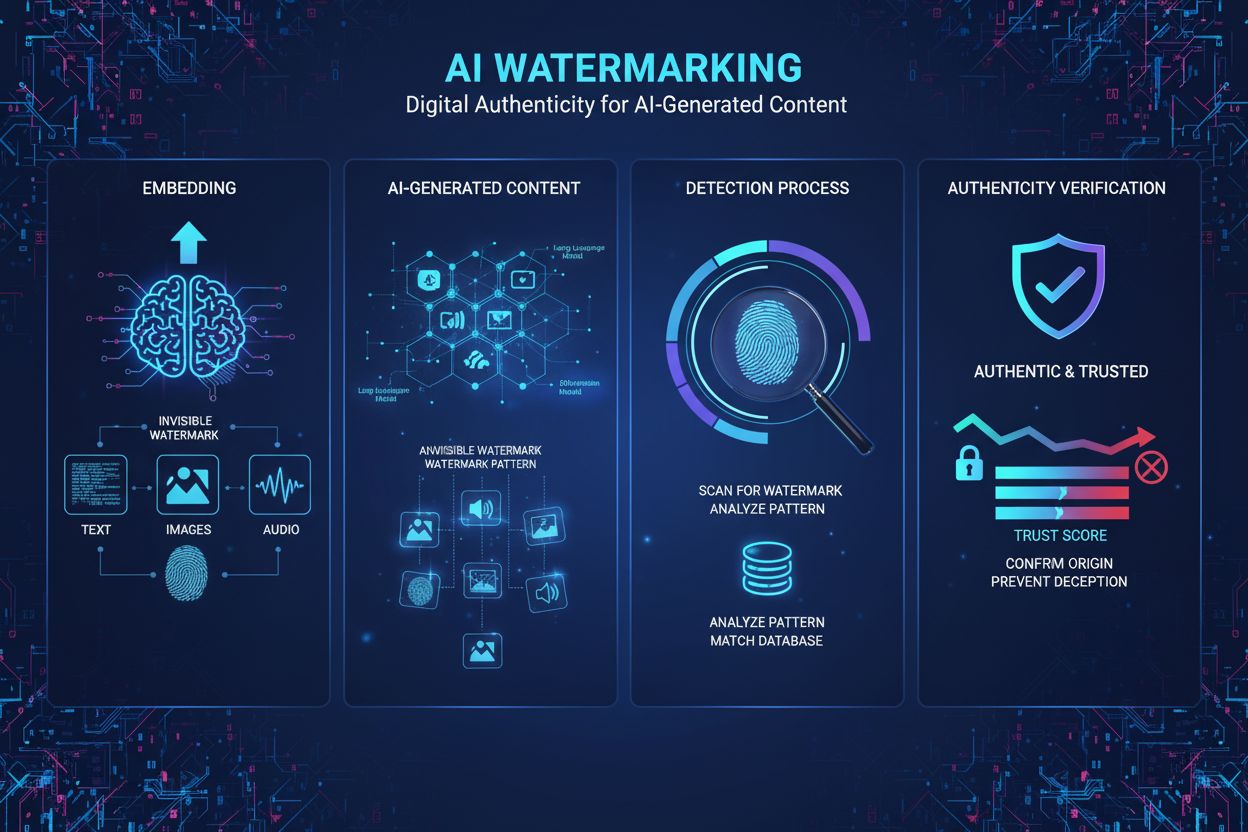
Un model de limbaj atribuie probabilități posibililor tokeni următori. Tokenii pot reprezenta cuvinte, părți de cuvinte sau semne de punctuație. Un watermark generativ schimbă modul în care este selectat tokenul următor. Alegerile rezultate poartă dovezi pe care un detector le poate măsura ulterior.
SynthID folosește un proces numit eșantionare prin turneu. Tokenii candidați concurează sub funcții de punctaj pseudorandom. Contextul recent al tokenilor și cheile watermark-ului determină scorurile. Repetarea selecției prin mai multe straturi favorizează tokenii cu un tipar statistic măsurabil. Detectorul reconstruiește aceste scoruri din textul finalizat. Nu are nevoie să ruleze modelul de limbaj original. Vezi lucrarea de cercetare SynthID.
1. Prezice posibilii tokeni următori
Modelul de limbaj produce o distribuție peste vocabularul său.2. Aplică watermark-ul configurat
Funcțiile de punctaj cu chei influențează selectarea tokenilor în timpul generării.3. Publică text obișnuit
Semnalul statistic călătorește în secvența de tokeni selectată.4. Reconstruiește și punctează
Detectorul folosește o tokenizare compatibilă și configurația corespunzătoare pentru a căuta acel semnal.Pasajele mai lungi oferă în general mai multe dovezi. Un rezultat foarte previzibil lasă mai puțini tokeni alternativi disponibili pentru marcare. Mai multe straturi pot ajuta, dar lucrarea raportează randamente descrescătoare pe măsură ce straturile consumă variația disponibilă în selectarea tokenilor.
Watermark-urile statistice și caracterele ascunse sunt diferite
Înainte de a alege un detector, identifică semnalul pe care intenționezi să îl găsești.
| Metodă | Ce transportă semnalul? | Ce ar trebui să testezi? |
|---|---|---|
| SynthID Text | Alegeri statistice de tokeni făcute în timpul generării | Dovezi sub o configurație de watermark corespunzătoare |
| Marcaj cu caractere ascunse | Caractere specifice inserate într-un șir | Secvența de caractere și codificarea ei documentată |
| Metadate de document | Câmpuri atașate unui document sau container | Metadatele, originea lor și orice semnătură |
| Clasificator de scriere AI | Tipare învățate din texte exemplu | Generalizarea și pozitivele false pe publicul țintă |
Un scanner Unicode nu poate înlocui un detector SynthID. Găsirea unui caracter neobișnuit nu dovedește nici ea că textul a fost scris de AI. Introducerea noastră în instrumentele gratuite AmICited discută semnalele de watermark bazate pe caractere și limitele lor. Experimentul de mai jos privește marcarea statistică.

Ești gata să-ți monitorizezi vizibilitatea în AI?
Urmărește cum menționează chatboții AI brandul tău în ChatGPT, Perplexity și alte platforme.
Generează text cu watermark în Python
Repozitoriul Google este o referință de cercetare și recomandă explicit să nu folosești subclasele sale de model în producție. El indică implementarea din Hugging Face Transformers. Referința oferă de asemenea abordări de detectare prin medie, medie ponderată și Bayesian antrenat. Note de utilizare ale repozitoriului
Exemplul următor folosește Python 3.13, Transformers 4.57.1 și PyTorch 2.8.0. Acestea sunt versiuni de exemplu reproductibile, nu o afirmație că ar fi cele mai noi lansări. Rulează pe CPU și descarcă modelul public distilbert/distilgpt2 la prima utilizare. Acel model mic menține experimentul accesibil; calitatea scrierii sale nu este reprezentativă pentru asistenții actuali.
Creează un mediu izolat:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Salvează blocurile Python din acest ghid, în ordine, în watermark_demo.py. Începe cu generarea:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Public demonstration keys. Never use these as a private production mark.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Keep the continuation; the supplied prompt was not watermarked.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
Generarea trebuie să expună o conductă de eșantionare compatibilă. Trecerea unui răspuns finalizat dintr-un API găzduit în această configurație nu îl poate marca retroactiv. Un model separat ar trebui să genereze o versiune nouă.
În producție, creează chei aleatoare unice și păstrează configurația privată. Păstrează revizia tokenizer-ului, revizia modelului, versiunea configurației și detectorul asociat. O rotație de chei creează o configurație nouă; păstrează vechea configurație de detectare dacă mai ai nevoie să recunoști rezultate mai vechi. Ghidul de implementare al Google
Cum calculează detectarea watermark-ului dovezile
Detectarea începe prin tokenizarea textului candidat și reconstruirea unui scor pentru fiecare fereastră de tokeni eligibilă și fiecare strat de watermark. În implementarea folosită aici, aceste scoruri binare se numesc valori g. Le mediem după excluderea contextelor repetate și a pozițiilor de la tokenul de sfârșit de secvență sau de după acesta. Primii patru tokeni ai unei continuări nu formează singuri o fereastră completă de cinci tokeni.
Funcția următoare folosește metodele de punctare și mascare din Transformers. Acceptă câte o secvență fără padding odată și returnează o medie brută, nu o probabilitate de autorat.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Boolean indexing retains the layer dimension.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
Verificarea directă pe ID-urile de tokeni izolează generarea de serializarea textului. A doua verificare exersează calea pe care o vede un detector după publicare. Evaluează-ți conducta reală de publicare și de extragere a textului, pentru că poate modifica intrarea.
Un scor de 0,60 nu înseamnă o probabilitate de 60% ca textul să fie scris de AI. Această funcție nu are un prag de decizie calibrat. Un pasaj scurt poate obține un scor mare din întâmplare. Raportează un rezultat neconcludent atunci când dovezile sunt insuficiente.
Pentru un detector util, colectează text uman reprezentativ, rezultate de model nemarcate și rezultate marcate. Ține datele de calibrare separate de datele de evaluare finală. Alege un prag pentru o rată acceptabilă de pozitive false, evaluează ratele de detectare pe eșantioane reținute și descompune rezultatele pe limbă, lungime și tip de conținut. O singură pereche marcat/nemarcat verifică doar că exemplul rulează.
Pentru o alternativă antrenată, Hugging Face oferă un detector Bayesian și un flux de lucru pentru antrenarea detectorului. Un detector antrenat pentru chei fără legătură nu este un înlocuitor direct pentru detectorul tău. Un checkpoint inițializat aleator sau de demonstrație nu stabilește acuratețea detectării.
Rămâi la curent cu tendințele vizibilității în AI
Primește cele mai noi informații despre mențiunile în AI, monitorizarea brandului și strategiile de optimizare.
Poți detecta ORICE watermark SynthID fără cheile sale?
Abordarea de detectare publicată necesită o configurație corespunzătoare. Ai nevoie și de o tokenizare compatibilă. Faptul că un furnizor folosește algoritmul SynthID nu îți oferă configurația sa, iar repozitoriul public nu este un detector pentru rezultatele oricărui furnizor.
Google descrie detectoare private, detectoare expuse printr-un API și detectoare distribuite public. Un furnizor ar putea oferi verificare fără a-și dezvălui configurația privată. Detectare și verificabilitate
Pentru propriul nostru sistem, putem verifica un registru de configurații cunoscute. Adaugă acest exemplu pentru a compara cheile corecte cu chei de demonstrație fără legătură:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Rulează fișierul asamblat cu python watermark_demo.py. Această comparație produce dovezi pentru două configurații cunoscute. Nu poate descoperi o cheie arbitrară necunoscută și, în mod intenționat, nu etichetează niciunul dintre scoruri drept o detectare.
Verificarea multor configurații înseamnă și efectuarea multor teste statistice. Dacă fiecare test permite pozitive false, acceptarea oricărui rezultat pozitiv poate crește rata globală de pozitive false. Calibrează întreaga procedură de căutare. Acolo unde testele individuale oferă valori p valide, o opțiune conservatoare este să împarți alocația totală de pozitive false la numărul de teste. Nu aplica această aritmetică direct asupra scorului brut mean_g.
Dacă nicio configurație cunoscută nu se potrivește, rezultatul adecvat este „Nu s-a detectat niciun watermark acceptat.” Posibilitățile includ în continuare scrierea umană, rezultate AI nemarcate, un watermark necunoscut și un pasaj editat al cărui semnal este prea slab.
Poate același text să poarte mai multe watermark-uri SynthID?
Există două proiecte diferite de luat în considerare.
Mai multe straturi într-o singură configurație
SynthID suportă deja o listă de chei. În exemplu, 30 de chei creează 30 de straturi în cadrul unui singur watermark configurat. Detectorul le combină dovezile. Acele chei nu reprezintă automat 30 de autori sau organizații atribuibile separat. Configurarea watermark-ului
Mărci de platformă și de client detectabile independent
Să presupunem că vrei ca un detector la nivel de platformă și un detector separat, specific clientului, să recunoască același pasaj. Alocarea unor grupuri de straturi acestor scopuri este o opțiune de proiectare experimentală, nu o garanție documentată a bibliotecii.
Simpla concatenare a două liste de chei nu demonstrează că ambii detectori originali încă funcționează. Fiecare detector ar avea nevoie de evaluare pe procesul de generare combinat, inclusiv de poziția sa în secvența de straturi. Măsoară rata de detectare a fiecărei mărci, potrivirile încrucișate cu alți clienți și comportamentul după editări. Aceasta este o propunere de inginerie care necesită experimente, nu o afirmație că SynthID oferă din start atribuire independentă pentru mai mulți proprietari.
Dacă un serviciu central trebuie doar să identifice un client, un proiect mai simplu este o configurație per client, cu un registru intern. Acel proiect necesită totuși calibrare pe întregul registru. Nu oferă o marcă separată la nivel de platformă care să poată fi verificată fără a căuta prin configurațiile clienților.
Poți înlocui un watermark existent?
SynthID nu stochează în text un câmp precum watermark_id. Nu există o valoare de metadate care să fie suprascrisă. Semnalul original este distribuit între alegerile de tokeni.
Dacă rescrii un pasaj folosind un al doilea generator cu watermark, noul proces de generare introduce propriul semnal. Efectul asupra semnalului anterior depinde de secvența de tokeni rezultată. Google raportează că editările blânde pot păstra detectabilitatea, în timp ce rescrierea completă sau traducerea pot reduce substanțial încrederea. Limitele documentate ale transformărilor
Rezultă că un al doilea watermark nu garantează ștergerea primului. Ambele semnale pot rămâne detectabile, sau unul sau ambele pot coborî sub pragurile lor de detectare. Aceasta este o inferență despre un flux de lucru combinat; documentația citată nu stabilește o rată de supraviețuire pentru fiecare pereche de watermark-uri.
O primă configurație necunoscută creează o limită practică. Propriul nostru detector poate evalua marca noastră, dar nu poate stabili că marca originală a dispărut. Asta necesită acces la detectorul original corespunzător. Chiar și un rezultat negativ înseamnă că detectorul nu a găsit suficiente dovezi în setările sale, nu o dovadă că orice urmă a fost eliminată.
Cum să testezi watermark-uri suprapuse
Înainte de a afirma că mărcile coexistă sau că una o înlocuiește pe cealaltă, folosește o matrice de teste. Intrările de mai jos descriu experimente de realizat, nu rezultate măsurate.
| Grup de eșantioane | Detector A | Detector B | Ce verifică comparația |
|---|---|---|---|
| Text uman și text AI fără watermark | Rulează | Rulează | Pozitive false de referință |
| Text generat doar cu A | Rulează | Rulează | Detectarea A și potriviri accidentale cu B |
| Text generat doar cu B | Rulează | Rulează | Detectarea B și potriviri accidentale cu A |
| Text generat cu o configurație combinată experimentală | Rulează | Rulează | Dacă fiecare marcă intenționată este detectabilă |
| Un text rescris sub B | Rulează | Rulează | Supraviețuirea A și detectarea B după rescriere |
| Fragmente scurte și versiuni editate ale fiecărui grup | Rulează | Rulează | Sensibilitatea la fluxul de publicare |
Folosește prompturi reținute și raportează lungimile de text utilizabile, numărul de eșantioane, versiunile detectorului, pragurile și ratele de pozitive false. Include incertitudinea din jurul ratelor raportate. Repetă evaluarea când schimbi cheile, tokenizarea, versiunile de model sau setările de generare. Până când aceste verificări există, descrie coexistența și înlocuirea drept neverificate.
Ce înseamnă asta pentru editori și vizibilitatea AI
Detectarea watermark-ului și monitorizarea citărilor AI răspund la întrebări diferite. Un test de watermark întreabă dacă un pasaj poartă dovezi ale unei anumite configurații de generare. Monitorizarea citărilor verifică ce surse apar în răspunsurile AI.
Nu prezenta un watermark lipsă drept dovadă a autoratului uman și nici un watermark detectat drept dovadă că un anumit site a fost citat. Pentru fluxurile de lucru editoriale, păstrează înregistrările de generare și atribuirea editorială alături de orice detector statistic. Fiecare oferă dovezi pe care celelalte nu le oferă.
 LinkedIn