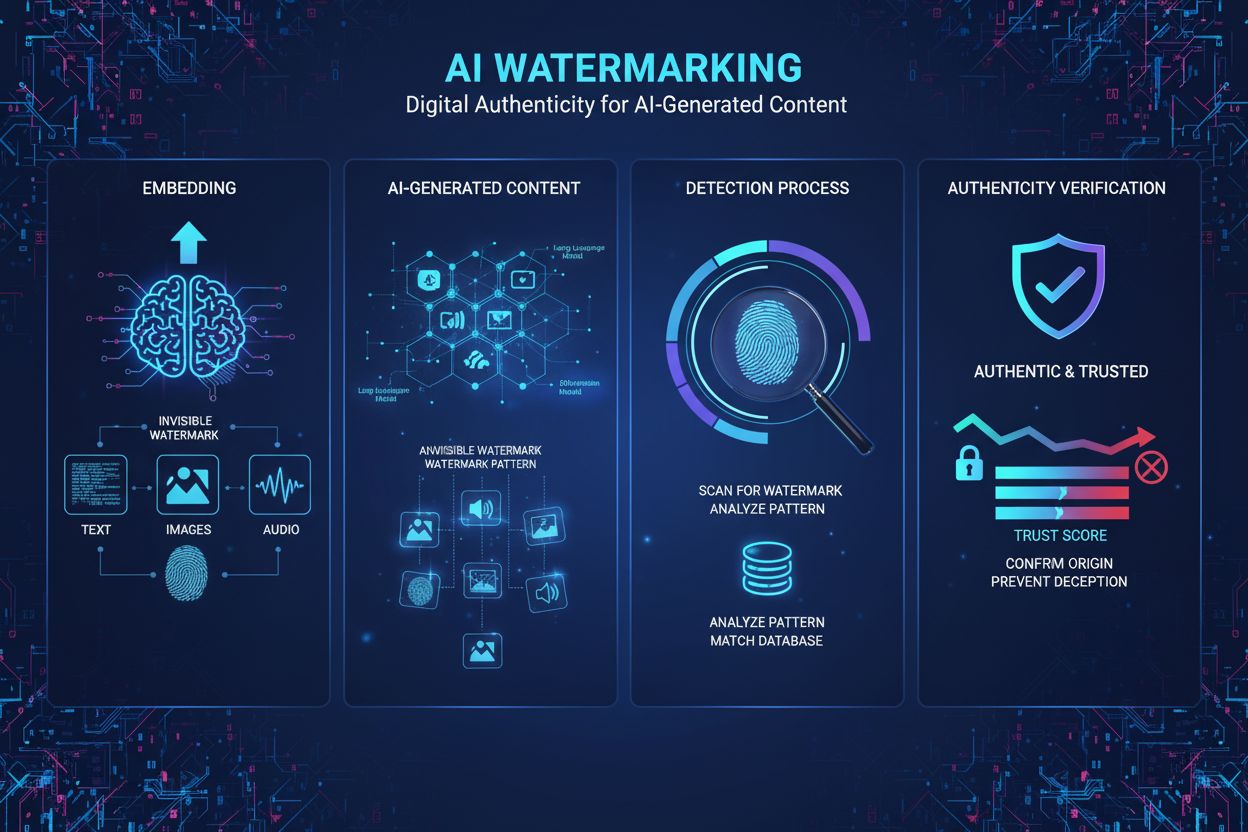
Un watermark del testo AI è un segnale introdotto deliberatamente nel testo generato. Per un editore, la domanda utile è specifica: possiamo riconoscere in seguito l’output di un sistema di generazione che controlliamo?
SynthID Text risponde a questa domanda. Non determina se un articolo qualsiasi sia stato scritto dall’AI. Il suo rilevatore verifica la presenza di un pattern statistico configurato, e un test non riuscito lascia irrisolta l’origine del testo. Il repository di riferimento di SynthID descrive sia la generazione sia il rilevamento del watermark.
Questa guida illustra un esempio Python locale, per poi esaminare i casi più difficili: watermark multipli, riscrittura con un nuovo watermark e verifica del testo quando le chiavi originali sono sconosciute.
Cosa cambia realmente un watermark del testo
Un modello linguistico assegna probabilità ai possibili token successivi. I token possono rappresentare parole, parti di parole o punteggiatura. Un watermark generativo modifica il modo in cui viene selezionato il token successivo. Le scelte che ne derivano portano con sé un’evidenza che un rilevatore può misurare in seguito.
SynthID utilizza un processo chiamato campionamento a torneo. I token candidati competono secondo funzioni di punteggio pseudocasuali. Il contesto recente dei token e le chiavi del watermark determinano i punteggi. Ripetere la selezione attraverso diversi livelli favorisce i token con un pattern statistico misurabile. Il rilevatore ricostruisce questi punteggi dal testo finito. Non ha bisogno di eseguire il modello linguistico originale. Vedi il paper di ricerca su SynthID.
1. Prevedi i possibili token successivi
Il modello linguistico produce una distribuzione sul suo vocabolario.2. Applica il watermark configurato
Le funzioni di punteggio con chiave influenzano la selezione dei token durante la generazione.3. Pubblica testo normale
Il segnale statistico viaggia nella sequenza di token selezionata.4. Ricostruisci e assegna il punteggio
Il rilevatore usa una tokenizzazione compatibile e la configurazione corrispondente per cercare quel segnale.I passaggi più lunghi forniscono in genere più evidenza. Un output altamente prevedibile lascia meno token alternativi disponibili per il watermarking. Più livelli possono aiutare, ma il paper riporta rendimenti decrescenti man mano che i livelli consumano la variazione disponibile nella selezione dei token.
I watermark statistici e i caratteri nascosti sono cose diverse
Prima di scegliere un rilevatore, identifica il segnale che intendi trovare.
| Metodo | Cosa porta il segnale? | Cosa dovresti testare? |
|---|---|---|
| SynthID Text | Scelte statistiche dei token effettuate durante la generazione | Evidenza sotto una configurazione di watermark corrispondente |
| Marcatore a caratteri nascosti | Caratteri specifici inseriti in una stringa | La sequenza di caratteri e la sua codifica documentata |
| Metadati del documento | Campi allegati a un documento o contenitore | I metadati, la loro origine e qualsiasi firma |
| Classificatore di scrittura AI | Pattern appresi da testi di esempio | Generalizzazione e falsi positivi sul pubblico previsto |
Un analizzatore Unicode non può sostituire un rilevatore SynthID. Trovare un carattere insolito non dimostra nemmeno la paternità AI. La nostra introduzione agli strumenti gratuiti di AmICited tratta i segnali watermark basati sui caratteri e i loro limiti. L’esperimento qui sotto riguarda il watermarking statistico.

Pronto a monitorare la tua visibilità nell'IA?
Scopri come i chatbot IA citano il tuo brand su ChatGPT, Perplexity e altre piattaforme.
Generare testo con watermark in Python
Il repository di Google è un riferimento di ricerca e sconsiglia esplicitamente di usare le sue sottoclassi di modello in produzione. Indica l’implementazione in Hugging Face Transformers. Il riferimento fornisce anche approcci di rilevamento con media, media ponderata e Bayesiano addestrato. Note d’uso del repository
L’esempio seguente usa Python 3.13, Transformers 4.57.1 e PyTorch 2.8.0. Queste sono versioni di esempio riproducibili, non un’affermazione che siano le release più recenti. Funziona su CPU e scarica il modello pubblico distilbert/distilgpt2 al primo utilizzo. Quel modello di piccole dimensioni mantiene l’esperimento accessibile; la sua qualità di scrittura non è rappresentativa degli assistenti attuali.
Crea un ambiente isolato:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Salva i blocchi Python di questa guida, nell’ordine, in watermark_demo.py. Inizia con la generazione:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Public demonstration keys. Never use these as a private production mark.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Keep the continuation; the supplied prompt was not watermarked.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
La generazione deve esporre una pipeline di campionamento compatibile. Passare una risposta già completata da un’API ospitata a questa configurazione non può marcarla retroattivamente. Un modello separato dovrebbe generare una nuova versione.
In produzione, crea chiavi casuali uniche e mantieni privata la configurazione. Conserva la revisione del tokenizer, la revisione del modello, la versione della configurazione e il rilevatore associato. Una rotazione delle chiavi crea una nuova configurazione; conserva la vecchia configurazione di rilevamento se hai ancora bisogno di riconoscere output precedenti. Linee guida di implementazione di Google
Come il rilevamento del watermark calcola l’evidenza
Il rilevamento inizia tokenizzando il testo candidato e ricostruendo un punteggio per ogni finestra di token idonea e ogni livello del watermark. Nell’implementazione usata qui, questi punteggi binari sono chiamati valori g. Ne calcoliamo la media dopo aver escluso i contesti ripetuti e le posizioni pari o successive al token di fine sequenza. I primi quattro token di un seguito non formano da soli una finestra completa di cinque token.
La funzione seguente usa i metodi di scoring e masking di Transformers. Accetta una sequenza non riempita alla volta e restituisce una media grezza, non una probabilità di paternità.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Boolean indexing retains the layer dimension.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
Il controllo diretto sugli ID dei token isola la generazione dalla serializzazione del testo. Il secondo controllo esercita il percorso che un rilevatore vede dopo la pubblicazione. Valuta la tua effettiva pipeline di pubblicazione ed estrazione del testo, perché può modificare l’input.
Un punteggio di 0,60 non significa una probabilità del 60% che il testo sia stato scritto dall’AI. Questa funzione non ha una soglia decisionale calibrata. Un passaggio breve può ottenere un punteggio alto per caso. Segnala un risultato non conclusivo quando l’evidenza è insufficiente.
Per un rilevatore utile, raccogli testo umano rappresentativo, output del modello non marcato e output con watermark. Tieni i dati di calibrazione separati dai dati di valutazione finale. Scegli una soglia per un tasso accettabile di falsi positivi, valuta i tassi di rilevamento su campioni tenuti da parte e scomponi i risultati per lingua, lunghezza e tipo di contenuto. Una singola coppia marcato/non marcato verifica solo che l’esempio funzioni.
Per un’alternativa addestrata, Hugging Face fornisce un rilevatore Bayesiano e un flusso di lavoro per l’addestramento del rilevatore. Un rilevatore addestrato per chiavi non correlate non è un sostituto immediato del tuo rilevatore. Un checkpoint inizializzato casualmente o dimostrativo non dimostra l’accuratezza del rilevamento.
Resta aggiornato sulle tendenze della visibilità IA
Ricevi le ultime analisi su citazioni nell'IA, monitoraggio del brand e strategie di ottimizzazione.
Puoi rilevare QUALSIASI watermark SynthID senza le sue chiavi?
L’approccio di rilevamento pubblicato richiede una configurazione corrispondente. Serve anche una tokenizzazione compatibile. Sapere che un fornitore usa l’algoritmo SynthID non ti dà la sua configurazione, e il repository pubblico non è un rilevatore per l’output di ogni fornitore.
Google descrive rilevatori privati, rilevatori esposti tramite API e rilevatori distribuiti pubblicamente. Un fornitore potrebbe offrire la verifica senza divulgare la sua configurazione privata. Rilevamento e verificabilità
Per il nostro sistema, possiamo controllare un registro di configurazioni note. Aggiungi questo esempio per confrontare le chiavi corrette con chiavi dimostrative non correlate:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Esegui il file così composto con python watermark_demo.py. Questo confronto produce evidenza per due configurazioni note. Non può scoprire una chiave arbitraria sconosciuta e, intenzionalmente, non etichetta nessuno dei due punteggi come rilevamento.
Controllare molte configurazioni significa anche eseguire molti test statistici. Se ogni test ammette falsi positivi, accettare qualsiasi risultato positivo può aumentare il tasso complessivo di falsi positivi. Calibra l’intera procedura di ricerca. Dove i singoli test forniscono p-value validi, un’opzione conservativa è dividere il margine totale di falsi positivi per il numero di test. Non applicare quell’aritmetica direttamente al punteggio grezzo mean_g.
Se nessuna configurazione nota corrisponde, il risultato appropriato è “Nessun watermark supportato rilevato”. Le possibilità includono comunque scrittura umana, output AI non marcato, un watermark sconosciuto e un passaggio modificato il cui segnale è troppo debole.
Lo stesso testo può portare più watermark SynthID?
Ci sono due progetti diversi da considerare.
Più livelli in un’unica configurazione
SynthID supporta già una lista di chiavi. Nell’esempio, 30 chiavi creano 30 livelli all’interno di un watermark configurato. Il rilevatore combina le loro evidenze. Quelle chiavi non rappresentano automaticamente 30 autori o organizzazioni attribuibili separatamente. Configurazione del watermark
Marchi di piattaforma e di cliente rilevabili in modo indipendente
Supponi di volere un rilevatore a livello di piattaforma e un rilevatore separato specifico per il cliente che riconoscano lo stesso passaggio. Assegnare gruppi di livelli a questi scopi è un’opzione di progettazione sperimentale, non una garanzia documentata della libreria.
Concatenare semplicemente due liste di chiavi non dimostra che entrambi i rilevatori originali funzionino ancora. Ogni rilevatore avrebbe bisogno di una valutazione sul processo di generazione combinato, inclusa la sua posizione nella sequenza dei livelli. Misura il tasso di rilevamento di ciascun marchio, le corrispondenze incrociate con altri clienti e il comportamento dopo le modifiche. Questa è una proposta ingegneristica che richiede esperimenti, non un’affermazione che SynthID fornisca di serie un’attribuzione indipendente multi-proprietario.
Se un servizio centrale ha solo bisogno di identificare un cliente, un progetto più semplice è una configurazione per cliente con un registro interno. Quel progetto richiede comunque una calibrazione su tutto il registro. Non fornisce un marchio separato a livello di piattaforma che possa essere verificato senza cercare tra le configurazioni dei clienti.
Puoi sostituire un watermark esistente?
SynthID non memorizza nel testo un campo come watermark_id. Non c’è alcun valore di metadati da sovrascrivere. Il segnale originale è distribuito tra le scelte dei token.
Se riscrivi un passaggio usando un secondo generatore con watermark, il nuovo processo di generazione introduce il proprio segnale. L’effetto sul segnale precedente dipende dalla sequenza di token risultante. Google riferisce che modifiche lievi possono preservare la rilevabilità, mentre una riscrittura accurata o una traduzione possono ridurre sostanzialmente la confidenza. Limiti documentati delle trasformazioni
Ne consegue che un secondo watermark non garantisce la cancellazione del primo. Entrambi i segnali possono restare rilevabili, oppure uno o entrambi possono scendere sotto le rispettive soglie di rilevamento. Questa è un’inferenza su un flusso di lavoro combinato; la documentazione citata non stabilisce un tasso di sopravvivenza per ogni coppia di watermark.
Una prima configurazione sconosciuta crea un limite pratico. Il nostro rilevatore può valutare il nostro marchio, ma non può stabilire che il marchio originale sia scomparso. Ciò richiede l’accesso al rilevatore corrispondente originale. Persino un risultato negativo significa che il rilevatore non ha trovato evidenza sufficiente con le sue impostazioni, non la prova che ogni traccia sia stata rimossa.
Come testare watermark sovrapposti
Prima di affermare che i marchi coesistono o che uno sostituisce l’altro, usa una matrice di test. Le voci seguenti descrivono esperimenti da eseguire, non esiti misurati.
| Gruppo di campioni | Rilevatore A | Rilevatore B | Cosa verifica il confronto |
|---|---|---|---|
| Testo umano e testo AI non marcato | Esegui | Esegui | Falsi positivi di base |
| Testo generato solo con A | Esegui | Esegui | Rilevamento di A e corrispondenze accidentali con B |
| Testo generato solo con B | Esegui | Esegui | Rilevamento di B e corrispondenze accidentali con A |
| Testo generato con una configurazione combinata sperimentale | Esegui | Esegui | Se ciascun marchio previsto è rilevabile |
| Testo A riscritto con B | Esegui | Esegui | Sopravvivenza di A e rilevamento di B dopo la riscrittura |
| Estratti brevi e versioni modificate di ciascun gruppo | Esegui | Esegui | Sensibilità al flusso di lavoro di pubblicazione |
Usa prompt tenuti da parte e riporta le lunghezze dei testi utilizzabili, il numero di campioni, le versioni dei rilevatori, le soglie e i tassi di falsi positivi. Includi l’incertezza attorno ai tassi riportati. Ripeti la valutazione quando cambi chiavi, tokenizzazione, versioni del modello o impostazioni di generazione. Finché quei controlli non esistono, descrivi coesistenza e sostituzione come non verificate.
Cosa significa tutto questo per gli editori e la visibilità AI
Il rilevamento del watermark e il monitoraggio delle citazioni AI rispondono a domande diverse. Un test del watermark chiede se un passaggio porta l’evidenza di una particolare configurazione di generazione. Il monitoraggio delle citazioni verifica quali fonti compaiono nelle risposte AI.
Non presentare un watermark mancante come prova di paternità umana, né un watermark rilevato come prova che un particolare sito web sia stato citato. Per i flussi di lavoro editoriali, conserva i registri di generazione e l’attribuzione editoriale accanto a qualsiasi rilevatore statistico. Ciascuno fornisce un’evidenza che gli altri non danno.
 LinkedIn