Et AI-tekstvannmerke er et signal som bevisst introduseres i generert tekst. For en utgiver er det nyttige spørsmålet spesifikt: kan vi senere gjenkjenne output fra et genereringssystem som vi selv kontrollerer?
SynthID Text svarer på det spørsmålet. Det avgjør ikke om en vilkårlig artikkel ble skrevet av AI. Detektoren tester for et konfigurert statistisk mønster, og en mislykket test lar tekstens opphav forbli uavklart. SynthID-referanserepositoriet beskriver både vannmerkgenerering og -deteksjon.
Denne guiden går gjennom et lokalt Python-eksempel, og undersøker deretter de vanskeligere tilfellene: flere vannmerker, omskriving med et nytt vannmerke, og kontroll av tekst når de opprinnelige nøklene er ukjente.
Hva et tekstvannmerke faktisk endrer
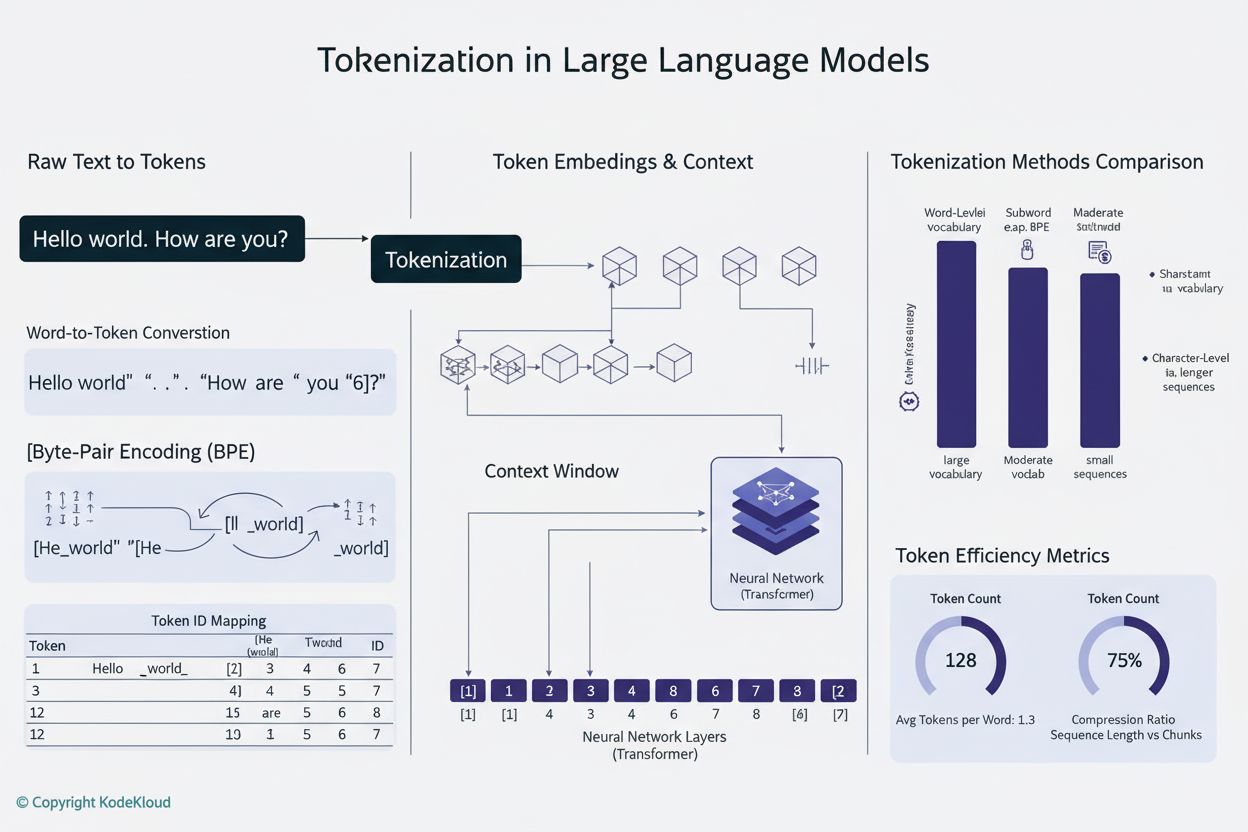
En språkmodell tilordner sannsynligheter til mulige neste tokens. Tokens kan representere ord, deler av ord eller tegnsetting. Et generativt vannmerke endrer hvordan neste token velges. De resulterende valgene bærer bevis som en detektor kan måle senere.
SynthID bruker en prosess som kalles turneringssampling. Kandidat-tokens konkurrerer under pseudotilfeldige skåringsfunksjoner. Nylig token-kontekst og vannmerkenøkler bestemmer skårene. Ved å gjenta utvalget gjennom flere lag favoriseres tokens med et målbart statistisk mønster. Detektoren rekonstruerer disse skårene fra den ferdige teksten. Den trenger ikke å kjøre den opprinnelige språkmodellen. Se SynthID-forskningsartikkelen.
1. Forutsi mulige neste tokens
Språkmodellen produserer en fordeling over vokabularet sitt.2. Bruk det konfigurerte vannmerket
Nøkkelstyrte skåringsfunksjoner påvirker token-utvalget under genereringen.3. Publiser vanlig tekst
Det statistiske signalet følger med i den valgte token-sekvensen.4. Rekonstruer og skår
Detektoren bruker kompatibel tokenisering og den matchende konfigurasjonen for å lete etter signalet.Lengre avsnitt gir generelt mer bevis. Svært forutsigbar output etterlater færre alternative tokens tilgjengelig for vannmerking. Flere lag kan hjelpe, men artikkelen rapporterer om avtagende utbytte etter hvert som lagene bruker opp variasjonen som er tilgjengelig i token-utvalget.
Statistiske vannmerker og skjulte tegn er forskjellige
Før du velger en detektor, identifiser signalet du har tenkt å finne.
| Metode | Hva bærer signalet? | Hva bør du teste? |
|---|---|---|
| SynthID Text | Statistiske token-valg gjort under genereringen | Bevis under en matchende vannmerkkonfigurasjon |
| Markør med skjulte tegn | Spesifikke tegn satt inn i en streng | Tegnsekvensen og dens dokumenterte koding |
| Dokumentmetadata | Felt knyttet til et dokument eller en beholder | Metadataene, deres opphav og eventuell signatur |
| AI-skriveklassifiserer | Mønstre lært fra eksempeltekster | Generalisering og falske positiver hos den tiltenkte målgruppen |
En Unicode-skanner kan ikke erstatte en SynthID-detektor. Å finne et uvanlig tegn fastslår heller ikke AI-forfatterskap. Vår introduksjon til AmICiteds gratisverktøy diskuterer tegnbaserte vannmerkesignaler og deres begrensninger. Eksperimentet nedenfor handler om statistisk vannmerking.

Klar til å overvåke AI-synligheten din?
Følg med på hvordan AI-chatboter nevner merkevaren din i ChatGPT, Perplexity og andre plattformer.
Generer vannmerket tekst i Python
Google-repositoriet er en forskningsreferanse og fraråder eksplisitt å bruke modellunderklassene i produksjon. Det viser til implementasjonen i Hugging Face Transformers. Referansen tilbyr også gjennomsnittlige, vektede gjennomsnittlige og trente bayesianske deteksjonstilnærminger. Bruksnotater for repositoriet
Følgende eksempel bruker Python 3.13, Transformers 4.57.1 og PyTorch 2.8.0. Dette er reproduserbare eksempelversjoner, ikke en påstand om at de er de nyeste utgivelsene. Det kjører på CPU og laster ned den offentlige distilbert/distilgpt2-modellen ved første bruk. Den lille modellen holder eksperimentet tilgjengelig; skrivekvaliteten er ikke representativ for dagens assistenter.
Opprett et isolert miljø:
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install "transformers==4.57.1" "torch==2.8.0"
Lagre Python-blokkene i denne guiden, i rekkefølge, i watermark_demo.py. Start med generering:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
    SynthIDTextWatermarkLogitsProcessor,
    set_seed,
)

MODEL_ID = "distilbert/distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, use_safetensors=True
).to("cpu").eval()

# Public demonstration keys. Never use these as a private production mark.
watermark = SynthIDTextWatermarkingConfig(
    keys=[104729 + 7919 * i for i in range(30)],
    ngram_len=5,
    sampling_table_size=65536,
    sampling_table_seed=42,
    context_history_size=1024,
    skip_first_ngram_calls=True,
)

inputs = tokenizer(
    "A community garden can change a neighborhood in several ways. ",
    return_tensors="pt",
)

def generate(config):
    set_seed(17)
    with torch.inference_mode():
        output = model.generate(
            **inputs,
            watermarking_config=config,
            do_sample=True,
            max_new_tokens=384,
            temperature=0.9,
            top_k=50,
            pad_token_id=tokenizer.eos_token_id,
        )
    # Keep the continuation; the supplied prompt was not watermarked.
    return output[:, inputs["input_ids"].shape[1]:]

marked_ids = generate(watermark)
unmarked_ids = generate(None)
print(tokenizer.decode(marked_ids[0], skip_special_tokens=True))
Generering må eksponere en kompatibel samplingspipeline. Å sende et ferdig svar fra en hostet API inn i denne konfigurasjonen kan ikke merke det i ettertid. En separat modell måtte generere en ny versjon.
I produksjon bør du opprette unike tilfeldige nøkler og holde konfigurasjonen privat. Behold tokenizer-revisjonen, modellrevisjonen, konfigurasjonsversjonen og tilhørende detektor. En nøkkelrotasjon skaper en ny konfigurasjon; behold den gamle deteksjonskonfigurasjonen hvis du fortsatt trenger å gjenkjenne eldre output. Googles implementasjonsveiledning
Hvordan vannmerkedeteksjon beregner bevis
Deteksjon starter med å tokenisere kandidatteksten og rekonstruere en skår for hvert kvalifiserte token-vindu og vannmerkelag. I implementasjonen som brukes her, kalles disse binære skårene g-verdier. Vi beregner gjennomsnittet av dem etter å ha ekskludert gjentatte kontekster og posisjoner ved eller etter end-of-sequence-tokenet. De fire første tokenene i en fortsettelse utgjør ikke et fullstendig vindu på fem tokens alene.
Følgende funksjon bruker Transformers’ skårings- og maskeringsmetoder. Den godtar én sekvens uten padding om gangen og returnerer et rågjennomsnitt, ikke en sannsynlighet for forfatterskap.
def score_ids(token_ids, config):
    if token_ids.ndim != 2 or token_ids.shape[0] != 1:
        raise ValueError("Pass one unpadded sequence with shape [1, length].")
    if token_ids.shape[1] < config.ngram_len:
        return {"mean_g": None, "usable_windows": 0}

    processor = SynthIDTextWatermarkLogitsProcessor(
        **config.to_dict(), device=torch.device("cpu")
    )
    with torch.inference_mode():
        values = processor.compute_g_values(token_ids).float()
        unique = processor.compute_context_repetition_mask(token_ids)
        before_eos = processor.compute_eos_token_mask(
            token_ids, tokenizer.eos_token_id
        )[:, config.ngram_len - 1:]
        mask = unique & before_eos.bool()
        usable = int(mask.sum().item())
        if usable == 0:
            return {"mean_g": None, "usable_windows": 0}
        # Boolean indexing retains the layer dimension.
        mean_g = float(values[mask].mean().item())
    return {"mean_g": mean_g, "usable_windows": usable}

print("marked:", score_ids(marked_ids, watermark))
print("unmarked:", score_ids(unmarked_ids, watermark))

def score_text(text, config):
    ids = tokenizer(
        text, add_special_tokens=False, return_tensors="pt"
    )["input_ids"]
    return score_ids(ids, config)

published_text = tokenizer.decode(
    marked_ids[0],
    skip_special_tokens=True,
    clean_up_tokenization_spaces=False,
)
print("published text:", score_text(published_text, watermark))
print("empty text:", score_text("", watermark))
Token-ID-kontrollen direkte isolerer genereringen fra tekstserialisering. Den andre kontrollen øver på den veien en detektor ser etter publisering. Evaluer din faktiske publiserings- og tekstudtrekkspipeline, fordi den kan endre inputen.
En skår på 0,60 betyr ikke en 60 % sannsynlighet for at AI skrev teksten. Denne funksjonen har ingen kalibrert beslutningsterskel. Et kort avsnitt kan få høy skår ved tilfeldighet. Rapporter et uavklart resultat når bevisene er utilstrekkelige.
For en nyttig detektor bør du samle representativ menneskelig tekst, uvannmerket modelloutput og vannmerket output. Hold kalibreringsdata atskilt fra endelige evalueringsdata. Velg en terskel for en akseptabel falsk positiv-rate, evaluer deteksjonsrater på holdt-ut-utvalg, og bryt resultatene ned etter språk, lengde og innholdstype. Et enkelt merket/umerket par kontrollerer bare at eksemplet kjører.
Som et trent alternativ tilbyr Hugging Face en bayesiansk detektor og en arbeidsflyt for detektortrening. En detektor trent for urelaterte nøkler er ikke en drop-in-erstatning for din detektor. Et tilfeldig initialisert eller demonstrasjonsbasert sjekkpunkt fastslår ikke deteksjonsnøyaktighet.
Hold deg oppdatert på trender innen AI-synlighet
Få de nyeste innsiktene om AI-omtaler, merkevareovervåking og optimaliseringsstrategier.
Kan du oppdage ET HVERT SynthID-vannmerke uten nøklene?
Den publiserte deteksjonstilnærmingen krever en matchende konfigurasjon. Du trenger også kompatibel tokenisering. Å vite at en leverandør bruker SynthID-algoritmen gir deg ikke konfigurasjonen, og det offentlige repositoriet er ikke en detektor for enhver leverandørs output.
Google beskriver private detektorer, detektorer som eksponeres via en API, og offentlig distribuerte detektorer. En leverandør kan tilby verifisering uten å avsløre sin private konfigurasjon. Deteksjon og verifiserbarhet
For vårt eget system kan vi sjekke et register over kjente konfigurasjoner. Legg til dette eksemplet for å sammenligne de riktige nøklene med urelaterte demonstrasjonsnøkler:
other_settings = watermark.to_dict()
other_settings["keys"] = [key + 1_000_003 for key in watermark.keys]
other_watermark = SynthIDTextWatermarkingConfig(**other_settings)

known_configs = {
    "demo-original-v1": watermark,
    "demo-other-v1": other_watermark,
}
for name, config in known_configs.items():
    print(name, score_text(published_text, config))
Kjør den sammensatte filen med python watermark_demo.py. Denne sammenligningen produserer bevis for to kjente konfigurasjoner. Den kan ikke oppdage en vilkårlig ukjent nøkkel, og den merker med vilje ikke noen av skårene som en deteksjon.
Å sjekke mange konfigurasjoner betyr også å utføre mange statistiske tester. Hvis hver test tillater falske positiver, kan det å akseptere enhver positiv øke den samlede falsk positiv-raten. Kalibrer hele søkeprosedyren. Der enkelttester gir gyldige p-verdier, er et konservativt alternativ å dele den totale falsk positiv-tillatelsen på antallet tester. Ikke bruk den aritmetikken direkte på den rå mean_g-skåren.
Hvis ingen kjent konfigurasjon matcher, er det riktige resultatet «Ingen støttet vannmerke oppdaget». Mulighetene inkluderer fortsatt menneskelig skriving, uvannmerket AI-output, et ukjent vannmerke og et redigert avsnitt hvis signal er for svakt.
Kan den samme teksten bære flere SynthID-vannmerker?
Det er to forskjellige design å vurdere.
Flere lag i én konfigurasjon
SynthID støtter allerede en liste over nøkler. I eksemplet lager 30 nøkler 30 lag innenfor ett konfigurert vannmerke. Detektoren kombinerer bevisene deres. Disse nøklene representerer ikke automatisk 30 separat tilskrivbare forfattere eller organisasjoner. Vannmerkkonfigurasjon
Uavhengig oppdagbare plattform- og kundemerker
Anta at du vil at en plattformomfattende detektor og en separat kundespesifikk detektor skal gjenkjenne det samme avsnittet. Å tildele grupper av lag til disse formålene er et eksperimentelt designalternativ, ikke en dokumentert garanti fra biblioteket.
Å bare sette sammen to nøkkellister viser ikke at begge de opprinnelige detektorene fortsatt fungerer. Hver detektor måtte evalueres på den kombinerte genereringsprosessen, inkludert dens posisjon i lagsekvensen. Mål hvert merkes deteksjonsrate, kryssmatching mot andre kunder, og atferd etter redigeringer. Dette er et ingeniørforslag som trenger eksperimenter, snarere enn en påstand om at SynthID gir uavhengig attribusjon til flere eiere rett ut av boksen.
Hvis en sentral tjeneste bare trenger å identifisere en kunde, er et enklere design én konfigurasjon per kunde med et internt register. Det designet trenger fortsatt kalibrering på tvers av hele registeret. Det gir ikke et separat plattformomfattende merke som kan sjekkes uten å søke gjennom kundekonfigurasjoner.
Kan du erstatte et eksisterende vannmerke?
SynthID lagrer ikke et felt som watermark_id i teksten. Det finnes ingen metadataverdi å overskrive. Det opprinnelige signalet er distribuert over token-valgene.
Hvis du skriver om et avsnitt ved hjelp av en andre vannmerket generator, introduserer den nye genereringsprosessen sitt eget signal. Effekten på det tidligere signalet avhenger av den resulterende token-sekvensen. Google rapporterer at milde redigeringer kan bevare oppdagbarheten, mens grundig omskriving eller oversettelse kan redusere konfidensen betydelig. Dokumenterte transformasjonsgrenser
Det følger at et andre vannmerke ikke garanterer sletting av det første. Begge signalene kan forbli oppdagbare, eller ett eller begge kan falle under deteksjonstersklene sine. Dette er en slutning om en kombinert arbeidsflyt; den siterte dokumentasjonen fastslår ikke en overlevelsesrate for hvert par av vannmerker.
En ukjent første konfigurasjon skaper en praktisk grense. Vår egen detektor kan evaluere vårt merke, men den kan ikke fastslå at det opprinnelige merket forsvant. Det krever tilgang til den opprinnelige matchende detektoren. Selv et negativt resultat betyr at detektoren ikke fant nok bevis under sine innstillinger, ikke et bevis for at hvert spor ble fjernet.
Hvordan teste overlappende vannmerker
Før du hevder at merker sameksisterer eller at ett erstatter et annet, bruk en testmatrise. Oppføringene nedenfor beskriver eksperimenter som skal kjøres, ikke målte utfall.
| Utvalgsgruppe | Detektor A | Detektor B | Hva sammenligningen kontrollerer |
|---|---|---|---|
| Menneskelig og uvannmerket AI-tekst | Kjør | Kjør | Baselinje for falske positiver |
| Tekst generert med bare A | Kjør | Kjør | A-deteksjon og utilsiktede B-treff |
| Tekst generert med bare B | Kjør | Kjør | B-deteksjon og utilsiktede A-treff |
| Tekst generert med en eksperimentell kombinert konfigurasjon | Kjør | Kjør | Om hvert tiltenkte merke er oppdagbart |
| En A-tekst skrevet om under B | Kjør | Kjør | A-overlevelse og B-deteksjon etter omskriving |
| Korte utdrag og redigerte versjoner av hver gruppe | Kjør | Kjør | Følsomhet for publiseringsarbeidsflyten |
Bruk holdt-ut-promptene og rapporter brukbare tekstlengder, utvalgsstørrelser, detektorversjoner, terskler og falsk positiv-rater. Inkluder usikkerhet rundt de rapporterte ratene. Gjenta evalueringen når du endrer nøkler, tokenisering, modellversjoner eller genereringsinnstillinger. Inntil disse kontrollene finnes, bør sameksistens og erstatning beskrives som uverifisert.
Hva dette betyr for utgivere og AI-synlighet
Vannmerkedeteksjon og AI-siteringsovervåking svarer på forskjellige spørsmål. En vannmerketest spør om et avsnitt bærer bevis for en bestemt genereringskonfigurasjon. Siteringsovervåking kontrollerer hvilke kilder som vises i AI-svar.
Ikke presenter et manglende vannmerke som bevis på menneskelig forfatterskap, eller et oppdaget vannmerke som bevis for at et bestemt nettsted ble sitert. For publiseringsarbeidsflyter bør du beholde genereringslogger og redaksjonell attribusjon sammen med enhver statistisk detektor. Hver av dem gir bevis som de andre ikke gir.
 LinkedIn